

Quando falamos sobre esteganografia, as pessoas imaginam terroristas, pedófilos, espiões, ou, no melhor dos casos, criptoanarquistas e outros cientistas. E de fato, quem mais poderia precisar? ocultar algo de olhares externos? Qual pode ser a utilidade disso para uma pessoa comum?
Aparentemente, há algum propósito. É exatamente por isso que hoje iremos compactar dados utilizando métodos de esteganografia. E no final, o leitor poderá até usar suas preciosas coleções de fotos em JPEG para aumentar a quantidade de gigabytes livres no sistema de arquivos.
O quê?
Se o leitor se lembra, esteganografia são esses estranhos algoritmos que permitem esconder a existência de uma informação dentro de outra. Em outras palavras: imagem + arquivo == aproximadamente a mesma imagem, mas não exatamente (em vez de imagens, pode haver qualquer coisa, mas normalmente isso é mais claro). Não deve haver uma maneira simples de determinar se há algo lá dentro ou não.
Mas se não se pode distinguir uma coisa da outra, há diferença alguma? Do ponto de vista do consumidor, o usuário não se preocupa com a precisão matemática (refletida por um conjunto específico de bits), apenas com o que percebe.
Por exemplo, vejamos três imagens de um lindo cachorro:
Cuidado com o JPEG!
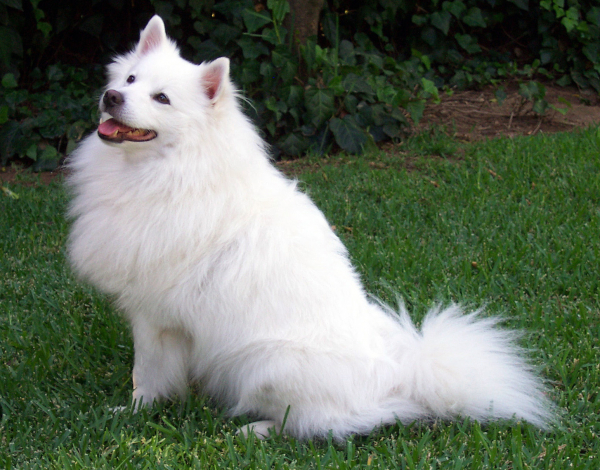
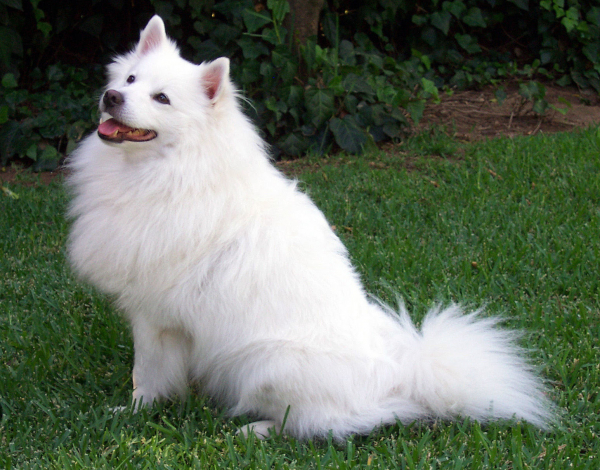
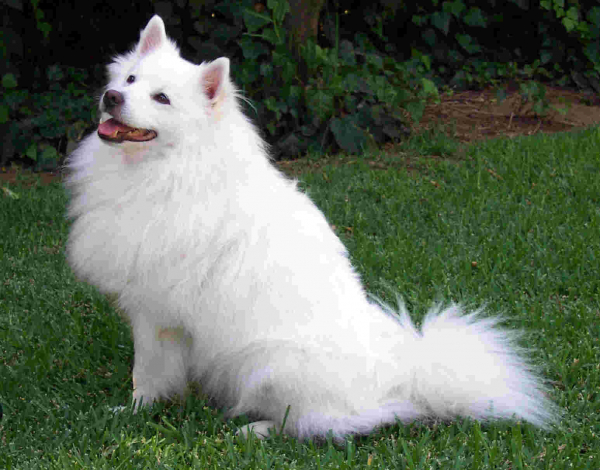
Apesar da enorme diferença de tamanho, poucas pessoas escolheriam a terceira versão. Por outro lado, entre as duas primeiras fotografias, a diferença não é tão perceptível, e a quantidade de informação nelas (na minha opinião) pode ser considerada equivalente.
Esse princípio em si já é antigo e é explorado há anos por métodos de compressão de informações com perda. Mas quebrar não é construir; estamos interessados no lado mais avançado da questão. É possível embutir informações adicionais do tamanho N em um arquivo de modo que seu tamanho aumente em M < N, e as mudanças não sejam perceptíveis para o usuário?
Claro, é possível. Mas vale a pena fazer algumas ressalvas imediatamente:
- Em primeiro lugar, o método deve ser universal e proporcionar resultados positivos em a maioria dos dados de entrada. Ou seja, em média, para uma entrada arbitrária, deve haver uma real diminuição na quantidade de informação armazenada. 'Em média' significa que casos opostos podem ocorrer, mas não devem predominar.
- Em segundo lugar, o tamanho do contêiner comprimido antes de incorporar informações deve ser maior do que o tamanho comprimido de sua modificação de forma semelhante. Apenas inserir uma quantidade de bits em uma imagem BMP usando o método LSB não é compressão esteganográfica, pois, quando passado por algum DEFLATE, a imagem original provavelmente será visivelmente menor.
- Em terceiro lugar, o resultado deve ser conduzido e comparado em relação aos dados já comprimidos por métodos clássicos. Isso permitirá eliminar o efeito probabilístico da diferença em sua redundância e realizar uma compressão mais eficaz em termos gerais.
Onde?
O uso de esteganografia implica que, além das informações a serem comprimidas, precisamos de contêineres nos quais elas serão incorporadas. A quantidade máxima de informações inseríveis depende muito das propriedades específicas, mas escala mais facilmente com o seu número. Portanto, o formato dos contêineres deve ser comum para que o usuário tenha o suficiente deles para obter algum retorno do processo de 'compressão'.
Nesse contexto, arquivos gráficos, de áudio e de vídeo se tornam bons candidatos. No entanto, devido à variedade de formatos, codecs e outros aspectos, na prática, restamos com um número relativamente pequeno de opções.
Considerando tudo isso, minha escolha recaiu sobre JPEG. Praticamente todos têm, é amplamente utilizado tanto para fins pessoais quanto comerciais, sendo quase o formato de fato para a maioria das imagens.
Quando? Como?
A seguir, vêm esquemas e descrições técnicas e aproximadas sem explicações especiais, portanto, interessados podem pular este trecho, avançando para a seção 'Alta tecnologia'.
Características Comuns
Para inserir dados em algum lugar, primeiro é preciso determinar onde. No sistema de arquivos, pode haver várias fotografias diferentes, entre as quais o usuário pode querer usar apenas algumas. Chamaremos de biblioteca o conjunto desejável de contêineres.
Ela é formada em dois casos: antes da compressão e antes da descompressão. No primeiro caso, é possível simplesmente usar um conjunto de nomes (ou melhor, uma expressão regular para eles) de arquivos, mas no segundo, é necessário algo mais confiável: o usuário pode copiar e mover esses arquivos dentro do sistema de arquivos, impossibilitando sua correta identificação. Portanto, é necessário armazenar seus hashes (md5 é suficiente) após todas as modificações.
A princípio, não faz sentido realizar a busca por expressão regular em todo o FS, basta indicar um diretório raiz. É nele que será salvo um arquivo especial de arquivo, que conterá aqueles hashes, juntamente com outras metainformações necessárias para a posterior recuperação das informações comprimidas.
Tudo isso se aplica igualmente a qualquer implementação de qualquer algoritmo de compressão de dados esteganográfica. Os próprios processos de compressão e recuperação de dados podem ser chamados de empacotamento e desempacotamento.
F5
Agora que está claro o que faremos e por quê, resta descrever o próprio algoritmo para alcançar o objetivo. Vamos relembrar o processo de codificação de um arquivo JPEG (obrigado à wikipédia da biblioteca nacional nomeada Bauman):
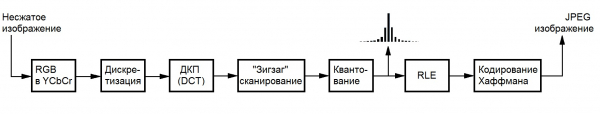
Ao olhar para isso, é melhor fazer algumas observações imediatamente:
- O tamanho do arquivo JPEG pode ser considerado otimizado, mesmo sem tentar comprimí-lo com algum WinRAR;
- Só é possível modificar as informações armazenadas (aquilo que sai da transformação discreta do cosseno, DCT), para garantir um desempenho minimamente aceitável.
- Para não perder dados em escalas industriais perceptíveis ao usuário, é necessário fazer o mínimo de modificações em cada imagem individual;
Para essas condições, cabe um verdadeiro conjunto de algoritmos, com o qual você pode se familiarizar . O mais avançado deles é o algoritmo do autor Andreas Westfeld, que trabalha com os coeficientes DCT do componente de luminosidade (o olho humano é o menos sensível a suas alterações). Seu esquema geral ao trabalhar com um arquivo JPEG existente é representado pelo seguinte diagrama:
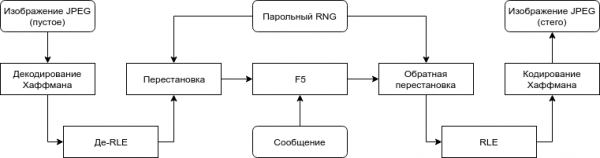
O bloco F5 utiliza uma técnica avançada de inserção, baseada na codificação de matriz. Mais detalhes sobre essa técnica e o próprio algoritmo podem ser encontrados no link acima. O que nos interessa aqui é o fato de que, com sua ajuda, é possível realizar menos alterações ao inserir a mesma quantidade de informação, quanto maior o tamanho do contêiner utilizado. E para executar o próprio algoritmo, são necessárias apenas operações simples de (de)codificação de Huffman e RLE.
As alterações são feitas nos coeficientes inteiros e se resumem à redução do seu valor absoluto por uma unidade, o que, de modo geral, permite usar o F5 para compressão de dados. Isso ocorre porque um coeficiente reduzido em valor absoluto ocupará, provavelmente, um número menor de bits após a codificação de Huffman, devido à distribuição estatística dos valores em JPEG.
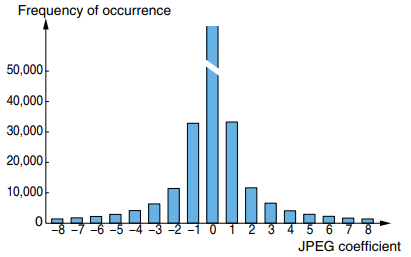
No caso de a formação de zero (ou seja, a chamada redução), o número de informações armazenadas será reduzido pelo seu tamanho, pois o coeficiente que antes era independente se tornará parte da sequência de zeros codificada em RLE:
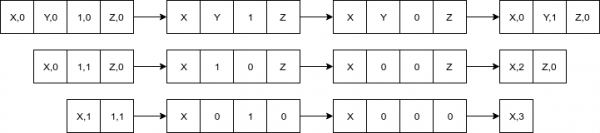
Modificações
A proteção de dados e sua compressão são tarefas ortogonais, portanto, podemos desconsiderar a permutação de senha secreta do algoritmo original. Além disso, precisamos saber exatamente como extrair os dados, portanto, todas as informações necessárias para isso (quais contêineres foram usados, em que ordem etc.) devem ser registradas em um arquivo separado e estar disponíveis para leitura livre pelo descompactador.
O algoritmo original é projetado para transmissão de mensagens secretas, portanto, opera de cada vez apenas com um contêiner, assumindo que o usuário mesmo dividirá em partes conforme necessário, se isso acontecer. Além disso, ao inserir independentemente em cada contêiner, é preciso saber antecipadamente quantos bits de dados serão colocados em cada um. Portanto, os coeficientes de cada elemento da biblioteca devem ser combinados em um único grande abstrato e trabalhados conforme o algoritmo original.
Como o F5 original permite usar até 12% do tamanho do contêiner, essa modificação também aumentará a capacidade máxima: "até 12%" do tamanho de toda a biblioteca é maior ou igual à soma de "até 12%" de cada um de seus elementos.
O esquema codificado geral é o seguinte:
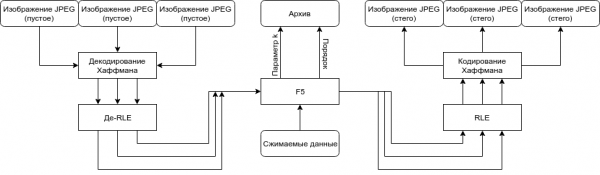
O algoritmo em si
Agora é hora de descrever o próprio algoritmo do início ao fim, para não deixar o leitor no escuro:
- O usuário define os dados binários compactáveis M e a biblioteca L usando uma expressão regular e o diretório raiz de busca;
- Na ordem em que aparece no FS, os elementos da biblioteca formam MC:
- Uma série de coeficientes C é decodificada a partir dos dados do arquivo;
- MC <- MC | C;
- O parâmetro k é determinado com base na terrível desigualdade:
|M| * 8 / (count_full(MC) + count_ones(MC) * k_rate(k)) < k / ((1 << k) - 1); - Em sequência, é retirado
n = (1 << k) - 1os bits menos significativos dos elementos não nulos de MC e gravados ema:- É calculada a função hash mágica
f, que mapeia uma palavra de n bitsaem k bitss; - Se
s == 0, então não há nada a ser alterado e o algoritmo passa para os próximos coeficientes; - Reduzir o valor absoluto do coeficiente que corresponde ao
s-ésimo bit na palavraa; - Se o resultado da redução resultar em um encurtamento (o coeficiente se tornou 0), repita a etapa desde o início;
- É calculada a função hash mágica
- Todos os coeficientes são codificados usando RLE e Huffman e gravados nos arquivos de origem;
- O parâmetro k é gravado no arquivo do arquivo;
- Para cada arquivo L na ordem de sua ocorrência original, o hash MD5 é calculado e gravado no arquivo do arquivo.
Tecnologia avançada
A forma ingênua do algoritmo e implementações em outras linguagens de alto nível (especialmente as que têm coleta de lixo) resultariam em desempenho terrível, portanto, implementei todas essas complexidades em C puro e realizei uma série de otimizações tanto em termos de velocidade de execução quanto de memória (você não imagina quanto essas imagens pesam sem compressão, mesmo até DCT). Mas mesmo assim, no início, a velocidade de execução deixou muito a desejar, então não vou descrever todo o processo e os métodos utilizados.
A compatibilidade entre plataformas foi alcançada usando uma combinação das bibliotecas libjpeg, pcre e tinydir, pelo que sou grato a elas. Por padrão, tudo é compilado com um simples make, portanto, usuários do Windows desejam instalar algum tipo de Cygwin ou se aventurar com o Visual Studio e as bibliotecas por conta própria.
A implementação está disponível como uma ferramenta de console e biblioteca. Os interessados em usar a última podem consultar o README no repositório do GitHub, para o qual deixarei o link ao final do post. Agora, vamos para a descrição e demonstração do funcionamento.
Como usar?
Com precaução. As imagens utilizadas podem ser movidas, renomeadas e copiadas à vontade. No entanto, é importante ter extrema cautela e não alterar seu conteúdo. Alterar um único bit resultará em uma interrupção do hash e impossibilitará a recuperação da informação.
Vamos supor que, após a compilação, obtivemos o arquivo executável f5ar. Podemos analisar o tamanho da biblioteca para calcular suas possíveis utilizações usando a flag -a: .\/f5ar -a [pasta de busca] [expressão regular compatível com Perl]. O empacotamento é feito pelo comando .\/f5ar -p [pasta de busca] [expressão regular compatível com Perl] [arquivo a ser empacotado] [nome do arquivo de arquivo], e a descompactação com .\/f5ar -u [arquivo de arquivo] [nome do arquivo recuperado].
Demonstração do funcionamento
Para mostrar a eficácia do método, carreguei uma coleção de 225 fotografias de cães completamente gratuitas do serviço . Cada uma delas possui uma qualidade ligeiramente melhor do que as fotos comuns de usuários, mas ainda assim. Cada uma delas foi recodificada usando libjpeg, para mitigar a influência das particularidades de codificação da biblioteca sobre o tamanho total. Para indicar o pior exemplo de dados compactáveis, um arquivo aleatório de 36 metros (pouco mais de 5% do tamanho total) uniformemente distribuído foi gerado com dd.
O processo de teste é bastante simples:
$ ls
binary_data dogs f5ar
$ du -sh dogs/
633M dogs/
$ du -h binary_data
36M binary_data

$ .\/f5ar -p dogs/ .*jpg binary_data dogs.f5ar
Lendo o arquivo de compressão... ok
Inicializando o arquivo... ok
Analisando a capacidade da biblioteca... feito em 16.8s
Capacidade garantida detectada de 48439359 bytes
Capacidade possível detectada de até 102618787 bytes
Compactando... feito em 32.6s
Salvando o arquivo... ok

$ .\/f5ar -u dogs/dogs.f5ar unpacked
Inicializando o arquivo... ok
Lendo o arquivo de arquivo... ok
Preenchendo o arquivo com arquivos... feito em 1.2s
Descompactando... feito em 17.5s
Escrevendo dados extraídos... ok

$ sha1sum binary_data unpacked
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 binary_data
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 unpacked
$ du -sh dogs/
563M dogs/
Ou um screenshot para os amantes.
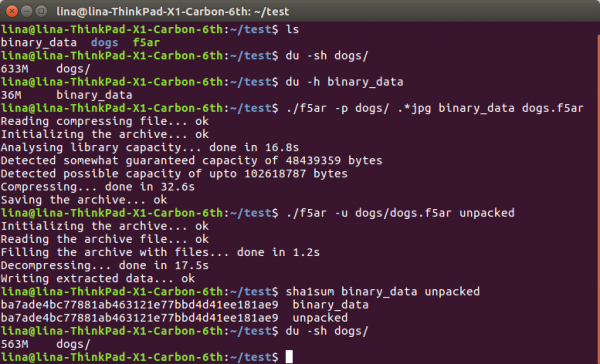
Como podemos ver, dos 633 + 36 == 669 megabytes de dados no disco rígido, chegamos a agradáveis 563, resultando em um coeficiente de compressão de aproximadamente ~1,188. Essa diferença radical se deve a perdas extremamente pequenas, semelhantes às obtidas na otimização de arquivos JPEG por métodos clássicos (como tinyjpg). Naturalmente, ao usar compressão esteganográfica, a informação não é simplesmente "perdida", mas utilizada para codificar outros dados. Além disso, o número de coeficientes "otimizados" ao usar F5 é muito menor do que na otimização tradicional.
Quaisquer que sejam as modificações, para o olho elas não são absolutamente perceptíveis. Abaixo, em um spoiler, o leitor pode avaliar a diferença tanto visualmente quanto subtraindo os valores do componente alterado do original (quanto mais atenuada a cor, menor a diferença):
Links para imagens que não cabem no habrastorage
Original —
Modificado —
Diferença —
Em conclusão
Espero ter conseguido convencer o leitor de que tais métodos são possíveis e têm seu valor. No entanto, comprar um disco rígido ou um canal adicional (para transmissão em rede) pode parecer uma solução muito mais simples do que tentar economizar dessa maneira. Por um lado, isso é verdade, o desenvolvimento extensivo frequentemente é mais simples e confiável. Mas, por outro lado, não devemos esquecer do intensivo. Afinal, não há garantias de que amanhã será possível ir à loja e comprar um disco rígido de mil terabytes, mas utilizar aqueles que já estão em casa sempre é uma opção.
->
Fonte: habr.com
