

A tradução do artigo foi preparada em antecipação ao início do curso .
Como economizar nos custos de nuvem ao trabalhar com Kubernetes? Não existe uma solução única, mas este artigo descreve várias ferramentas que podem ajudá-lo a gerenciar recursos de forma mais eficiente e reduzir os gastos com computação em nuvem.
Escrevi este artigo com foco no Kubernetes para AWS, mas ele se aplica (quase) exatamente da mesma forma a outros provedores de nuvem. Presumo que seu(s) cluster(es) já tenha(m) a escalabilidade automática configurada (). Remover recursos e reduzir o tamanho da implementação só economizará se também reduzir seu parque de nós de trabalho (instâncias EC2).
Neste artigo serão abordados:
- limpeza de recursos não utilizados ()
- redução da escala fora do horário de trabalho ()
- uso de escalabilidade horizontal (HPA),
- redução de reserva excessiva de recursos (, VPA)
- uso de instâncias Spot
Limpeza de recursos não utilizados
Trabalhar em um ambiente em rápida mudança é incrível. Queremos que as organizações técnicas . Uma entrega de software mais rápida também significa um maior número de implantações de PR, ambientes de pré-visualização, protótipos e soluções de análise. Tudo é implantado no Kubernetes. Quem tem tempo para limpar implantações de teste manualmente? É fácil esquecer de remover experimentos antigos de uma semana. A conta da nuvem acabará crescendo porque esquecemos de fechar:
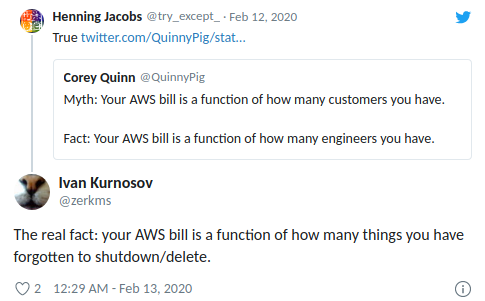
(Henning Jacobs:
Realidade:
(cita) Cory Quinn:
Mito: Sua conta AWS é uma função da quantidade de seus usuários.
Fato: Sua conta AWS é uma função da quantidade de seus engenheiros.
Ivan Kurnosov (em resposta):
Fato real: Sua conta AWS é uma função da quantidade de coisas que você esqueceu de desligar/remover.)
(kube-janitor) ajuda a limpar seu cluster. A configuração do janitor é flexível tanto para uso global quanto local:
- As regras gerais para todo o cluster podem definir o tempo máximo de vida (TTL - time-to-live) para implantações de PR/teste.
- Recursos individuais podem ser anotados com janitor/ttl, por exemplo, para a exclusão automática de spikes/prototipagens após 7 dias.
As regras gerais são definidas em um arquivo YAML. Seu caminho é passado através do parâmetro --rules-file no kube-janitor. Aqui está um exemplo de regra para excluir todos os namespaces com -pr- no nome após dois dias:
- id: cleanup-resources-from-pull-requests
  resources:
    - namespaces
  jmespath: "contains(metadata.name, '-pr-')"
  ttl: 2d
O exemplo a seguir regula o uso do rótulo application em pods Deployment e StatefulSet para todas as novas implantações/StatefulSet em 2020, mas ao mesmo tempo permite a execução de testes sem esse rótulo por uma semana:
- id: require-application-label
  # remover deployments e statefulsets sem o rótulo "application"
  resources:
    - deployments
    - statefulsets
  # veja http://jmespath.org/specification.html
  jmespath: "!(spec.template.metadata.labels.application) && metadata.creationTimestamp > '2020-01-01'"
  ttl: 7d
Execução de uma demonstração temporária por 30 minutos em um cluster onde o kube-janitor está funcionando:
kubectl run nginx-demo --image=nginx
kubectl annotate deploy nginx-demo janitor/ttl=30m
Outra fonte de custos crescentes são os volumes persistentes (AWS EBS). Ao excluir o StatefulSet do Kubernetes, seus volumes persistentes (PVC - PersistentVolumeClaim) não são removidos. Volumes EBS não utilizados podem facilmente resultar em custos de centenas de dólares por mês. O Kubernetes Janitor tem uma função para limpar PVCs não utilizados. Por exemplo, esta regra removerá todos os PVCs que não estão montados por um pod e não são referenciados por um StatefulSet ou CronJob:
# удалить все PVC, которые не смонтированы и на которые не ссылаются StatefulSets
- id: remove-unused-pvcs
  resources:
  - persistentvolumeclaims
  jmespath: "_context.pvc_is_not_mounted && _context.pvc_is_not_referenced"
  ttl: 24h
O Kubernetes Janitor pode ajudá-lo a manter seu cluster "limpo" e evitar custos acumulados lentamente em computação em nuvem. Para obter instruções sobre implantação e configuração, siga em .
Redução de escala fora do horário de trabalho
Sistemas de teste e intermediários normalmente precisam estar operacionais apenas durante o horário comercial. Algumas aplicações de produção, como back-office/herramentas administrativas, também requerem apenas disponibilidade limitada e podem ser desligadas à noite.
(kube-downscaler) permite que usuários e operadores reduzam a escala do sistema durante períodos fora do horário de trabalho. Os Deployments e StatefulSets podem ser escalonados para zero réplicas. CronJobs podem ser suspensos. O Kubernetes Downscaler é configurável para todo o cluster, um ou mais namespaces ou recursos individuais. Pode-se definir um "tempo de inatividade" ou, contrariamente, "tempo de atividade". Por exemplo, para minimizar a escalabilidade durante a noite e nos fins de semana:
image: hjacobs/kube-downscaler:20.4.3
args:
  - --interval=30
  # não desligar componentes de infraestrutura
  - --exclude-namespaces=kube-system,infra
  # não desligar kube-downscaler, além de manter o Postgres Operator, para que os bancos de dados excluídos possam ser gerenciados
  - --exclude-deployments=kube-downscaler,postgres-operator
  - --default-uptime=Mon-Fri 08:00-20:00 Europe/Berlin
  - --include-resources=deployments,statefulsets,stacks,cronjobs
  - --deployment-time-annotation=deployment-time
Aqui está um gráfico de escalabilidade dos nós de trabalho do cluster durante os fins de semana:
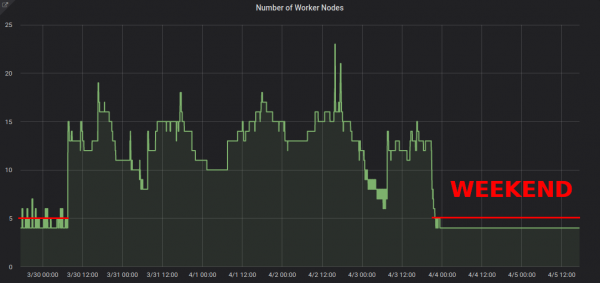
Reduzir a escala de ~13 para 4 nós de trabalho certamente faz uma diferença significativa na conta da AWS.
Mas e se eu precisar operar durante o "tempo de inatividade" do cluster? Certos deployments podem ser permanentemente excluídos da escalabilidade, adicionando a anotação downscaler/exclude: true. Os deployments podem ser temporariamente excluídos com a anotação downscaler/exclude-until com um timestamp absoluto no formato AAAA-MM-DD HH:MM (UTC). Se necessário, todo o cluster pode ser escalonado de volta implantando um pod com a anotação downscaler/force-uptime, por exemplo, executando um placeholder do nginx:
kubectl run scale-up --image=nginx
kubectl annotate deploy scale-up janitor/ttl=1h # remover o deployment após uma hora
kubectl annotate pod $(kubectl get pod -l run=scale-up -o jsonpath="{.items[0].metadata.name}") downscaler/force-uptime=true
Veja , se você estiver interessado em instruções de implantação e opções adicionais.
Use o dimensionamento automático horizontal
Muitos aplicativos/serviços lidam com esquemas de carga dinâmica: às vezes seus módulos estão ociosos e outras vezes operam em plena capacidade. Trabalhar com um parque fixo de pods para lidar com picos de carga não é econômico. Kubernetes suporta dimensionamento automático horizontal através do recurso (HPA). O uso da CPU frequentemente é um bom indicador para escalabilidade:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: my-app
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-app
  minReplicas: 3
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        averageUtilization: 100
        type: Utilization
A Zalando criou um componente para conectar facilmente métricas personalizadas para escalonamento: (kube-metrics-adapter) é um adaptador de métricas universal para Kubernetes, que pode coletar e servir métricas personalizadas e externas para o escalonamento horizontal de pods. Suporta escalonamento com base em métricas do Prometheus, filas SQS e outras configurações. Por exemplo, para escalar um deployment para uma métrica personalizada apresentada pela própria aplicação em formato JSON em /metrics, use:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: myapp-hpa
  annotations:
    # metric-config.<metricType>.<metricName>.<collectorName>/<configKey>
    metric-config.pods.requests-per-second.json-path/json-key: "$.http_server.rps"
    metric-config.pods.requests-per-second.json-path/path: /metrics
    metric-config.pods.requests-per-second.json-path/port: "9090"
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: myapp
  minReplicas: 1
  maxReplicas: 10
  metrics:
  - type: Pods
    pods:
      metric:
        name: requests-per-second
      target:
        averageValue: 1k
        type: AverageValue
Configurar o escalonamento horizontal usando o HPA deve ser uma das ações padrão para aumentar a eficiência para serviços sem estado. O Spotify tem uma apresentação com suas experiências e recomendações para o HPA: .
Reduzindo o superávit de reserva de recursos
As cargas de trabalho do Kubernetes determinam suas necessidades de CPU/memória através de 'pedidos de recursos'. Os recursos de CPU são medidos em núcleos virtuais ou, mais frequentemente, em 'milicoros' (millicores), por exemplo, 500m implica 50% de vCPU. Os recursos de memória são medidos em bytes e podem usar sufixos comuns, por exemplo, 500Mi, que significa 500 megabytes. Os pedidos de recursos 'bloqueiam' a quantidade nos nós de trabalho, ou seja, um módulo com um pedido de CPU de 1000m em um nó com 4 vCPUs deixará apenas 3 vCPUs disponíveis para outros módulos.
Slack (excesso de reserva) — é a diferença entre os recursos solicitados e o uso real. Por exemplo, um pod que solicita 2 GiB de memória, mas usa apenas 200 MiB, tem ~ 1,8 GiB de “memória excessiva”. Excesso custa dinheiro. Pode-se estimar grosseiramente que 1 GiB de memória excessiva custa ~ 10 dólares por mês.
(kube-resource-report) exibe reservas excessivas e pode ajudá-lo a identificar seu potencial de economia:
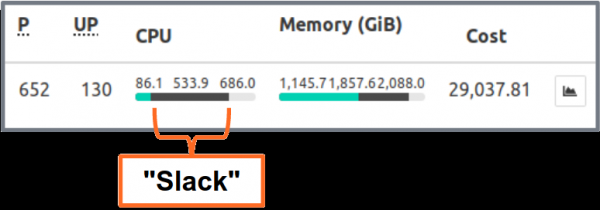
mostra o excesso agregado pelo aplicativo e pela equipe. Isso permite encontrar locais onde os pedidos de recursos podem ser reduzidos. O relatório HTML gerado fornece apenas uma instantânea do uso de recursos. Você deve observar o uso de CPU/memória ao longo do tempo para determinar os pedidos adequados de recursos. Aqui está um gráfico do Grafana para um serviço "típico" com alta carga de CPU: todos os pods usam significativamente menos de 3 núcleos de CPU solicitados:
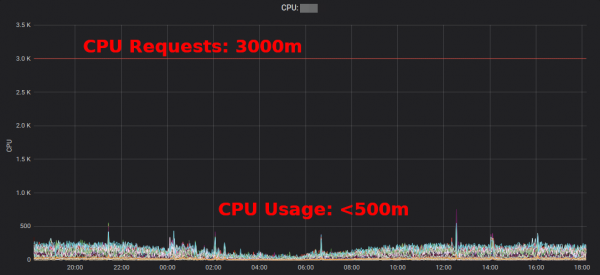
Reduzir o pedido de CPU de 3000m para ~400m libera recursos para outras cargas de trabalho e permite reduzir o cluster.
“O uso médio de CPU das instâncias EC2 muitas vezes oscila na faixa de dígitos únicos”, . Enquanto para EC2 , modificar alguns pedidos de recursos do Kubernetes no arquivo YAML é fácil e pode resultar em grandes economias.
Mas realmente queremos que as pessoas mudem valores em arquivos YAML? Não, as máquinas podem fazer isso muito melhor! Kubernetes (VPA) faz exatamente isso: adapta os pedidos de recursos e limites de acordo com a carga de trabalho. Aqui está um exemplo do gráfico de pedidos de CPU do Prometheus (linha azul fina), adaptados pelo VPA ao longo do tempo:
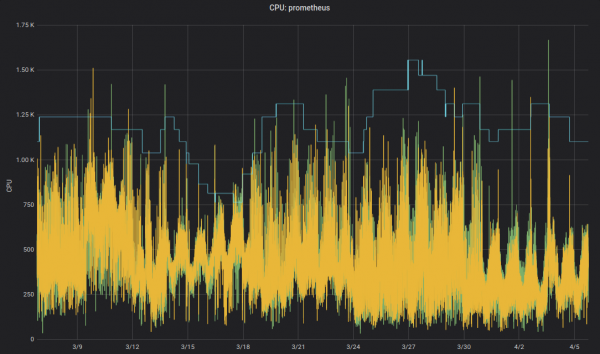
para componentes de infraestrutura. Aplicações não críticas também podem usar o VPA.
da Fairwind — é uma ferramenta que cria VPA para cada implantação no namespace e, em seguida, exibe a recomendação de VPA em seu painel. Pode ajudar os desenvolvedores a definir os pedidos corretos de CPU/memória para suas aplicações:
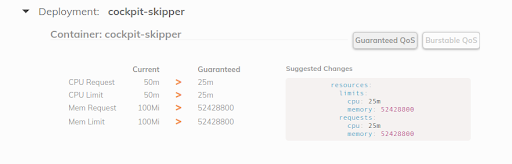
Eu escrevi um pequeno em 2019, e recentemente na .
Uso de instâncias EC2 Spot
Finalmente, não menos importante, os custos da AWS EC2 podem ser reduzidos utilizando instâncias Spot como nós de trabalho do Kubernetes. As instâncias Spot estão disponíveis com até 90% de desconto em relação aos preços sob demanda. Executar Kubernetes na EC2 Spot é uma boa combinação: você precisa especificar diferentes tipos de instâncias para maior disponibilidade, ou seja, você pode obter um nó maior pelo mesmo preço ou até menor, e a capacidade aumentada pode ser utilizada por cargas de trabalho de contêiner do Kubernetes.
Como executar Kubernetes na EC2 Spot? Existem várias opções: usar um serviço de terceiros, como o SpotInst (agora chamado "Spot", não me pergunte por quê), ou simplesmente adicionar um AutoScalingGroup (ASG) Spot ao seu cluster. Por exemplo, aqui está um trecho de CloudFormation para um ASG Spot "otimizado para capacidade" com vários tipos de instâncias:
MySpotAutoScalingGroup:
 Properties:
   HealthCheckGracePeriod: 300
   HealthCheckType: EC2
   MixedInstancesPolicy:
     InstancesDistribution:
       OnDemandPercentageAboveBaseCapacity: 0
       SpotAllocationStrategy: capacity-optimized
     LaunchTemplate:
       LaunchTemplateSpecification:
         LaunchTemplateId: !Ref LaunchTemplate
         Version: !GetAtt LaunchTemplate.LatestVersionNumber
       Overrides:
         - InstanceType: "m4.2xlarge"
         - InstanceType: "m4.4xlarge"
         - InstanceType: "m5.2xlarge"
         - InstanceType: "m5.4xlarge"
         - InstanceType: "r4.2xlarge"
         - InstanceType: "r4.4xlarge"
   LaunchTemplate:
     LaunchTemplateId: !Ref LaunchTemplate
     Version: !GetAtt LaunchTemplate.LatestVersionNumber
   MinSize: 0
   MaxSize: 100
   Tags:
   - Key: k8s.io/cluster-autoscaler/node-template/label/aws.amazon.com/spot
     PropagateAtLaunch: true
     Value: "true"
Algumas observações sobre o uso de Spot com Kubernetes:
- Você precisa lidar com as interrupções das Spot, por exemplo, esvaziando o nó ao parar a instância.
- A Zalando utiliza o autoconfigurador oficial de cluster com prioridades de pool de nós.
- Nós Spot para aceitar "registros" de cargas de trabalho para execução em Spot.
Resumo
Espero que você encontre algumas das ferramentas apresentadas úteis para reduzir sua conta de computação em nuvem. Você também pode encontrar grande parte do conteúdo do artigo na .
Quais são suas melhores práticas para economizar custos em nuvem no Kubernetes? Por favor, avise-me no .
Na prática, menos de 3 CPUs virtuais estarão disponíveis para uso, uma vez que a capacidade do nó diminui devido aos recursos do sistema reservados. O Kubernetes diferencia a capacidade física do nó dos recursos "alocados" ().
Exemplo de cálculo: uma instância m5.large com 8 GiB de memória custa cerca de ~84 dólares por mês (eu-central-1, On-Demand), ou seja, a reserva de 1/8 do nó custa aproximadamente ~10 dólares por mês.
Há muitas outras maneiras de reduzir sua conta do EC2, como instâncias reservadas, planos de economia, etc. — não vou abordar esses tópicos aqui, mas você definitivamente deve investigá-los!
Fonte: habr.com
