

Olá a todos. Estamos desenvolvendo um produto para análise de tráfego offline. O projeto inclui uma tarefa relacionada à análise estatística dos caminhos percorridos pelos visitantes nas áreas.
No âmbito dessa tarefa, os usuários podem fazer consultas à sistema do seguinte tipo:
- quantos visitantes passaram da área "A" para a área "B";
- quantos visitantes passaram da área "A" para a área "B" através da área "C" e, em seguida, pela área "D";
- quanto tempo levou para um visitante de um determinado tipo passar da área "A" para a área "B."
e uma série de consultas analíticas semelhantes.
O movimento dos visitantes pelas áreas representa um gráfico direcionado. Ao pesquisar na internet, descobri que bancos de dados de grafos são usados também para relatórios analíticos. Fiquei curioso para ver como esses bancos de dados de grafos lidariam com tais consultas (Resumo: mal).
Escolhi usar o banco de dados , um proeminente representante de bancos de dados de grafos open-source, que se baseia em um conjunto de tecnologias maduras que, em minha opinião, deveriam garantir um desempenho operacional satisfatório:
- back-end de armazenamento BerkeleyDB, Apache Cassandra, Scylla;
- índices complexos podem ser armazenados em Lucene, Elasticsearch, Solr.
Os autores do JanusGraph afirmam que ele é adequado tanto para OLTP quanto para OLAP.
Trabalhei com BerkeleyDB, Apache Cassandra, Scylla e ES, além disso, esses produtos são frequentemente usados em nossos sistemas, então eu olhei com otimismo para o teste deste banco de dados de grafos. Achei estranha a escolha do BerkeleyDB em vez do RocksDB, mas provavelmente isso se deve a requisitos de transação. De qualquer forma, para uso escalável e produtivo, recomenda-se o uso do back-end com Cassandra ou Scylla.
Não considerei o Neo4j, pois para clustering requer uma versão comercial, ou seja, o produto não é aberto.
Os bancos de dados de grafos dizem: "Se algo parece um gráfico - trate isso como um gráfico!" — lindo!
Primeiro, desenhei um gráfico que foi feito de acordo com os cânones dos bancos de dados de grafos:
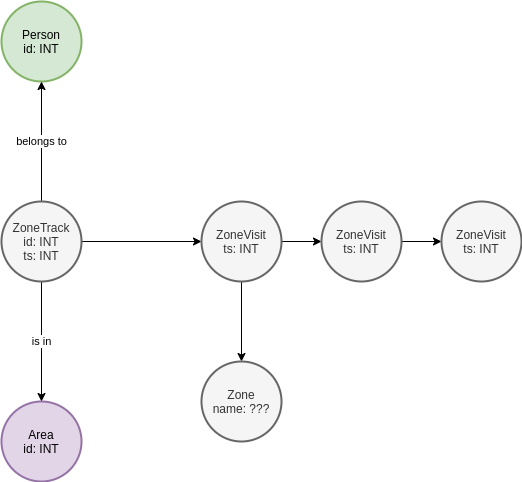
Há uma entidade Zone, que é responsável pela área. Se ZoneStep pertence a esta Zone, então ele a referencia. Quanto às entidades Area, ZoneTrack, Person , não se preocupe com elas, elas pertencem ao domínio e não são consideradas no teste. Portanto, para essa estrutura gráfica, a consulta de busca de cadeias pareceria assim:
g.V().hasLabel('Zone').has('id',0).in_()
       .repeat(__.out()).until(__.out().hasLabel('Zone').has('id',19)).count().next()
O que em russo seria algo como: encontre a Zone com ID=0, pegue todos os vértices dos quais uma aresta (ZoneStep) leva até ela, siga em frente sem voltar até encontrar tais ZoneStep, dos quais uma aresta vai para a Zone com ID=19, conte o número de tais cadeias.
Não pretendo conhecer todos os detalhes da busca em grafos, mas esta consulta foi gerada com base neste livro ().
Eu carreguei 50 mil trilhas que variam de 3 a 20 pontos em um banco de dados orientado a grafos JanusGraph, utilizando o backend BerkeleyDB, criei os índices conforme .
Script para upload em Python:
from random import random
from time import time

from init import g, graph

if __name__ == '__main__':

    points = []
    max_zones = 19
    zcache = dict()
    for i in range(0, max_zones + 1):
        zcache[i] = g.addV('Zone').property('id', i).next()

    startZ = zcache[0]
    endZ = zcache[max_zones]

    for i in range(0, 10000):

        if not i % 100:
            print(i)

        start = g.addV('ZoneStep').property('time', int(time())).next()
        g.V(start).addE('belongs').to(startZ).iterate()

        while True:
            pt = g.addV('ZoneStep').property('time', int(time())).next()
            end_chain = random()
            if end_chain < 0.3:
                g.V(pt).addE('belongs').to(endZ).iterate()
                g.V(start).addE('goes').to(pt).iterate()
                break
            else:
                zone_id = int(random() * max_zones)
                g.V(pt).addE('belongs').to(zcache[zone_id]).iterate()
                g.V(start).addE('goes').to(pt).iterate()

            start = pt

    count = g.V().count().next()
    print(count)
Utilizou-se uma VM com 4 núcleos e 16 GB de RAM em SSD. O JanusGraph foi implantado com o seguinte comando:
docker run --name janusgraph -p8182:8182 janusgraph/janusgraph:latestNeste caso, os dados e índices utilizados para busca por correspondência exata são armazenados no BerkeleyDB. Ao executar a consulta mencionada anteriormente, obtive um tempo igual a várias dezenas de segundos.
Executando os 4 scripts mencionados anteriormente em paralelo, consegui transformar o SGBD em uma abóbora com um fluxo divertido de stack traces Java (e todos nós adoramos ler stack traces Java) nos logs do Docker.
Após refletir, decidi simplificar o esquema do grafo para o seguinte:
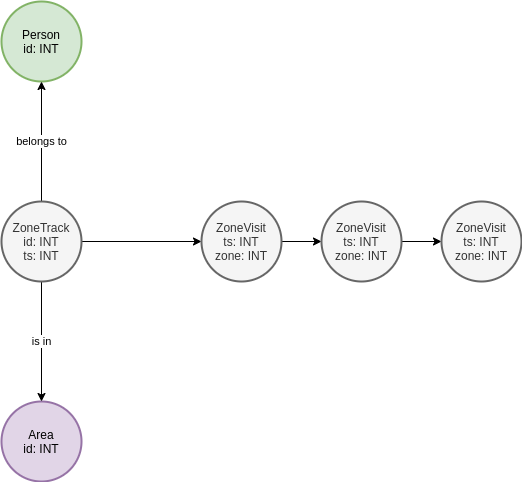
Decidindo que a busca por atributos da entidade seria mais rápida que a busca por arestas. Assim, minha consulta se tornou a seguinte:
g.V().hasLabel('ZoneStep').has('id',0).repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',19)).count().next()O que em russo seria algo como: encontre a ZoneStep com ID=0, siga em frente sem voltar até encontrar a ZoneStep com ID=19, conte o número de tais cadeias.
O script de upload mencionado acima também foi simplificado, de forma a não criar associações desnecessárias, limitando-me aos atributos.
A consulta ainda estava sendo executada por vários segundos, o que era totalmente inaceitável para nossa tarefa, pois para consultas AdHoc de tipo arbitrário isso simplesmente não servia.
Tentei implementar o JanusGraph usando o Scylla, como a implementação mais rápida do Cassandra, mas isso também não trouxe mudanças significativas de performance.
Assim, embora "pareça um grafo", não consegui fazer o SGBD de grafos processar isso rapidamente. Presumo que eu esteja perdendo alguma informação e que seja possível fazer o JanusGraph realizar essa busca em frações de segundo, mas não consegui.
Como ainda precisava resolver a tarefa, comecei a pensar em JOINs e Pivot de tabelas, o que não gerou muito otimismo em termos de elegância, mas poderia ser uma solução prática.
No nosso projeto, já usamos o Apache ClickHouse, então decidi verificar minhas pesquisas nesta base de dados analítica.
Implementei o ClickHouse com uma receita simples:
sudo docker run -d --name clickhouse_1
     --ulimit nofile=262144:262144
     -v /opt/clickhouse/log:/var/log/clickhouse-server
     -v /opt/clickhouse/data:/var/lib/clickhouse
     yandex/clickhouse-server
Criei um banco de dados e uma tabela do tipo:
CREATE TABLE
db.steps (`area` Int64, `when` DateTime64(1, 'Europe/Moscow') DEFAULT now64(), `zone` Int64, `person` Int64)
ENGINE = MergeTree() ORDER BY (area, zone, person) SETTINGS index_granularity = 8192
Preenchi-a com os dados usando o seguinte script:
from time import time

from clickhouse_driver import Client
from random import random

client = Client('vm-12c2c34c-df68-4a98-b1e5-a4d1cef1acff.domain',
                database='db',
                password='secret')

max = 20

for r in range(0, 100000):

    if r % 1000 == 0:
        print("CNT: {}, TS: {}".format(r, time()))

    data = [{
            'area': 0,
            'zone': 0,
            'person': r
        }]

    while True:
        if random() < 0.3:
            break

        data.append({
                'area': 0,
                'zone': int(random() * (max - 2)) + 1,
                'person': r
            })

    data.append({
            'area': 0,
            'zone': max - 1,
            'person': r
        })

    client.execute(
        'INSERT INTO steps (area, zone, person) VALUES',
        data
    )
Como as inserções são feitas em lotes, o preenchimento foi muito mais rápido do que para o JanusGraph.
Construi duas consultas usando JOIN. Para a transição do ponto A para o ponto B:
SELECT s1.person AS person,
       s1.zone,
       s1.when,
       s2.zone,
       s2.when
FROM
  (SELECT *
   FROM steps
   WHERE (area = 0)
     AND (zone = 0)) AS s1 ANY INNER JOIN
  (SELECT *
   FROM steps AS s2
   WHERE (area = 0)
     AND (zone = 19)) AS s2 USING person
WHERE s1.when <= s2.when
Para a transição através de 3 pontos:
SELECIONE s3.person,
       s1z,
       s1w,
       s2z,
       s2w,
       s3.zone,
       s3.when
DE
  (SELECIONE s1.person COMO person,
          s1.zone COMO s1z,
          s1.when COMO s1w,
          s2.zone COMO s2z,
          s2.when COMO s2w
   DE
     (SELECIONE *
      DE steps
      ONDE (area = 0)
        E (zone = 0)) COMO s1 QUALQUER INNER JOIN
     (SELECIONE *
      DE steps COMO s2
      ONDE (area = 0)
        E (zone = 3)) COMO s2 USANDO person
   ONDE s1.when <= s2.when) p QUALQUER INNER JOIN
  (SELECIONE *
   DE steps
   ONDE (area = 0)
     E (zone = 19)) COMO s3 USANDO person
ONDE p.s2w <= s3.when
As consultas, é claro, parecem bastante assustadoras; para uso real, é necessário fazer uma camada de programação-geradora. No entanto, elas funcionam e funcionam rapidamente. Tanto a primeira quanto a segunda consulta são executadas em menos de 0,1 segundo. Aqui está um exemplo do tempo de execução da consulta para count(*) passando por 3 pontos:
SELECIONE count(*)
DE
(
    SELECIONE
        s1.person COMO person,
        s1.zone COMO s1z,
        s1.when COMO s1w,
        s2.zone COMO s2z,
        s2.when COMO s2w
    DE
    (
        SELECIONE *
        DE steps
        ONDE (area = 0) E (zone = 0)
    ) COMO s1
    QUALQUER INNER JOIN
    (
        SELECIONE *
        DE steps COMO s2
        ONDE (area = 0) E (zone = 3)
    ) COMO s2 USANDO (person)
    ONDE s1.when <= s2.when
) COMO p
QUALQUER INNER JOIN
(
    SELECIONE *
    DE steps
    ONDE (area = 0) E (zone = 19)
) COMO s3 USANDO (person)
ONDE p.s2w <= s3.when

┌─count()─┐
│   11592 │
└─────────┘
1 linhas no conjunto. Decorrido: 0,068 seg. Processado 250,03 mil linhas, 8,00 MB (3,69 milhões de linhas/s., 117,98 MB/s.)Nota sobre IOPS. Durante o preenchimento dos dados, o JanusGraph gerou uma quantidade bastante alta de IOPS (1000-1300 para quatro threads de preenchimento de dados), enquanto o IOWAIT era bastante alto. Ao mesmo tempo, o ClickHouse gerou uma carga mínima no subsistema de disco.
Conclusão
Decidimos usar o ClickHouse para atender consultas desse tipo. Sempre podemos otimizar ainda mais as consultas usando visualizações materializadas e paralelização, realizando o pré-processamento da corrente de eventos com o Apache Flink antes de carregá-los no ClickHouse.
O desempenho é tão bom que provavelmente nem precisaremos pensar em pivôs de tabelas por meios programáticos. Anteriormente, precisávamos fazer pivôs de dados extraídos do Vertica através da exportação para o Apache Parquet.
Infelizmente, mais uma tentativa de usar um banco de dados gráfico não teve sucesso. Não encontrei que o JanusGraph tenha um ecossistema amigável que permita que as pessoas se familiarizem rapidamente com o produto. Além disso, a configuração do servidor é feita pelo tradicional método Java, que fará com que aqueles não familiarizados com Java chorem lágrimas de sangue:
host: 0.0.0.0
port: 8182
threadPoolWorker: 1
gremlinPool: 8
scriptEvaluationTimeout: 30000
channelizer: org.janusgraph.channelizers.JanusGraphWsAndHttpChannelizer

graphManager: org.janusgraph.graphdb.management.JanusGraphManager
graphs: {
  ConfigurationManagementGraph: conf/janusgraph-cql-configurationgraph.properties,
  airlines: conf/airlines.properties
}

scriptEngines: {
  gremlin-groovy: {
    plugins: { org.janusgraph.graphdb.tinkerpop.plugin.JanusGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.server.jsr223.GremlinServerGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.tinkergraph.jsr223.TinkerGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.jsr223.ImportGremlinPlugin: {classImports: [java.lang.Math], methodImports: [java.lang.Math#*]},
               org.apache.tinkerpop.gremlin.jsr223.ScriptFileGremlinPlugin: {files: [scripts/airline-sample.groovy]}}}}

serializers:
# GraphBinary é aqui para substituir Gryo e Graphson
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { serializeResultToString: true }}
  # Gryo e Graphson, versões mais recentes
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  # Versões de serialização mais antigas para compatibilidade:
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoLiteMessageSerializerV1d0, config: {ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV2d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}

processors:
  - { className: org.apache.tinkerpop.gremlin.server.op.session.SessionOpProcessor, config: { sessionTimeout: 28800000 }}
  - { className: org.apache.tinkerpop.gremlin.server.op.traversal.TraversalOpProcessor, config: { cacheExpirationTime: 600000, cacheMaxSize: 1000 }}

metrics: {
  consoleReporter: {enabled: false, interval: 180000},
  csvReporter: {enabled: false, interval: 180000, fileName: /tmp/gremlin-server-metrics.csv},
  jmxReporter: {enabled: false},
  slf4jReporter: {enabled: true, interval: 180000},
  gangliaReporter: {enabled: false, interval: 180000, addressingMode: MULTICAST},
  graphiteReporter: {enabled: false, interval: 180000}}
threadPoolBoss: 1
maxInitialLineLength: 4096
maxHeaderSize: 8192
maxChunkSize: 8192
maxContentLength: 65536
maxAccumulationBufferComponents: 1024
resultIterationBatchSize: 64
writeBufferHighWaterMark: 32768
writeBufferHighWaterMark: 65536
ssl: {
  enabled: false}
Consegui acidentalmente "colocar" a versão JanusGraph do BerkeleyDB.
A documentação é bastante confusa em relação aos índices, uma vez que a gestão de índices requer algumas manobras estranhas em Groovy. Por exemplo, criar um índice deve ser feito escrevendo código no console do Gremlin (que, aliás, não funciona imediatamente). Da documentação oficial do JanusGraph:
graph.tx().rollback() \/\/Nunca crie novos índices enquanto uma transação estiver ativa\nmgmt = graph.openManagement()\nname = mgmt.getPropertyKey('name')\nage = mgmt.getPropertyKey('age')\nmgmt.buildIndex('byNameComposite', Vertex.class).addKey(name).buildCompositeIndex()\nmgmt.buildIndex('byNameAndAgeComposite', Vertex.class).addKey(name).addKey(age).buildCompositeIndex()\nmgmt.commit()\n\n\/\/Aguarde até que o índice esteja disponível\nManagementSystem.awaitGraphIndexStatus(graph, 'byNameComposite').call()\nManagementSystem.awaitGraphIndexStatus(graph, 'byNameAndAgeComposite').call()\n\/\/Reindexe os dados existentes\nmgmt = graph.openManagement()\nmgmt.updateIndex(mgmt.getGraphIndex("byNameComposite"), SchemaAction.REINDEX).get()\nmgmt.updateIndex(mgmt.getGraphIndex("byNameAndAgeComposite"), SchemaAction.REINDEX).get()\nmgmt.commit()Epílogo
De certa forma, o experimento acima é uma comparação entre coisas incomparáveis. Se pensarmos bem, um SGBD gráfico executa operações diferentes para obter os mesmos resultados. No entanto, durante os testes, realizei um experimento com uma consulta do tipo:
g.V().hasLabel('ZoneStep').has('id',0)\n .repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',1)).count().next()que reflete a acessibilidade em etapas. No entanto, mesmo com esses dados, o SGBD gráfico mostrava resultados que ultrapassavam alguns segundos... Isso, é claro, está relacionado ao fato de que existiam caminhos do tipo 0 -> X -> Y ... -> 1, que o mecanismo gráfico também verificava.
Mesmo para uma consulta do tipo:
g.V().hasLabel('ZoneStep').has('id',0).out().has('id',1)).count().next()não consegui obter uma resposta satisfatória com um tempo de processamento inferior a um segundo.
A moral da história é que uma ideia bonita e uma modelagem paradigmática não levam ao resultado desejado, que é demonstrado com eficiência muito mais alta no exemplo do ClickHouse. O caso de uso apresentado neste artigo é um claro antipadrão para SGBDs gráficos, embora pareça adequado para modelagem dentro de sua paradigma.
Fonte: habr.com
