

Existem várias soluções de backup, mas o que fazer se os servidores atendidos estão espalhados por diferentes regiões e clientes e precisamos nos basear nos recursos do sistema operacional?
Boa tarde, Habr!
Meu nome é Natalia. Sou líder da equipe de administradores de aplicativos na NPO 'Krista'. Somos a Ops para o grupo de projetos da nossa empresa. Temos uma situação bastante peculiar: instalamos e mantemos nosso software tanto em servidores da nossa empresa quanto em servidores localizados nos clientes. Nesse caso, não é necessário fazer o backup do servidor inteiro. Apenas os 'dados essenciais' são importantes: SGBD e diretórios específicos do sistema de arquivos. Claro que os clientes têm (ou não) seus próprios regulamentos de backup e frequentemente fornecem algum tipo de armazenamento externo para arquivar os backups. Nesse caso, após a criação do backup, garantimos o envio para o armazenamento externo.
Por um tempo, usamos um script em bash para fins de backup, mas à medida que as opções de configuração aumentavam, a complexidade desse script também crescia e, em um certo momento, chegamos à necessidade de 'destruir tudo e reconstruir'.
Soluções prontas não serviram por vários motivos: devido à necessidade de descentralização dos backups, obrigatoriedade de manter os backups localmente com o cliente, dificuldade de configuração, substituição de importação e restrições de acesso.
Achamos que seria mais fácil escrever algo próprio. Ao mesmo tempo, queríamos algo que fosse suficiente para a nossa situação pelos próximos N anos, mas com a possibilidade de expansão de sua aplicação.
As condições do problema eram as seguintes:
- a instância básica do backup é autônoma, funciona localmente
- o armazenamento de backups e logs sempre dentro da rede do cliente
- a instância é composta por módulos - uma espécie de 'construtor'
- necessária compatibilidade com as distribuições Linux utilizadas, incluindo as obsoletas, desejável uma potencial compatibilidade multiplataforma
- para trabalhar com a instância, basta acesso por ssh, não é necessário abrir portas adicionais
- máxima simplicidade de configuração e operação
- pode existir (mas não é obrigatório) uma instância separada, permitindo visualizar centralmente o estado dos backups de diferentes servidores
O que conseguimos fazer pode ser visto aqui:
O software foi escrito em python3; funciona nos sistemas Debian, Ubuntu, CentOS e AstraLinux 1.6.
A documentação está disponível no diretório docs do repositório.
Os conceitos fundamentais utilizados pelo sistema são:
action – uma ação que realiza uma operação atômica (backup de BD, backup de diretório, transferência do diretório A para o diretório B, etc.). As ações existentes estão no diretório core/actions
task – uma tarefa, um conjunto de actions que descreve uma "tarefa de backup" lógica
schedule – um cronograma, um conjunto de tasks com uma opção para indicar o horário de execução da tarefa
A configuração do backup é armazenada em um arquivo yaml; a estrutura geral da configuração é:
- configurações gerais
- seção actions: descrição das ações utilizadas neste servidor
- seção schedule: descrição de todas as tarefas (conjuntos de ações) e o cronograma de execução via cron, se tal execução for necessária
O que o aplicativo pode fazer atualmente:
- são suportadas as principais operações para nós: backup do PostgreSQL através do pg_dump, backup do diretório do sistema de arquivos através do tar; operações com armazenamento externo; rsync entre diretórios; rotação de backups (remoção de cópias antigas)
- chamadas de script externo
- execução manual de uma tarefa específica
/opt/KristaBackup/KristaBackup.py run make_full_dump - pode adicionar (ou remover) uma tarefa específica ou todo o cronograma no crontab
/opt/KristaBackup/KristaBackup.py enable all - geração de um arquivo trigger com base nos resultados do backup. Esta função é útil em conjunto com o Zabbix para monitorar backups
- pode funcionar em segundo plano no modo webapi ou web
/opt/KristaBackup/KristaBackup.py web start [--api]
A diferença entre os modos: no webapi não há interface web propriamente dita, mas o aplicativo responde a solicitações de outra instância. Para o modo web, é necessário instalar o flask e alguns pacotes adicionais, o que pode não ser aceitável em todos os casos, por exemplo, em uma AstraLinux SE certificada.
Através da interface web, é possível verificar o estado e os logs dos backups dos servidores conectados: a "instância web" solicita dados das "instâncias de backup" via API. O acesso ao web requer autenticação, enquanto o acesso ao webapi não.
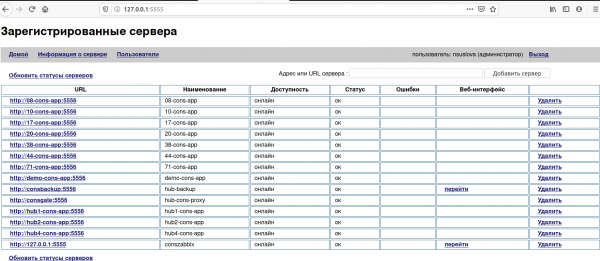
Os logs de backups que falharam são destacados por cores: warning – amarelo, error – vermelho.
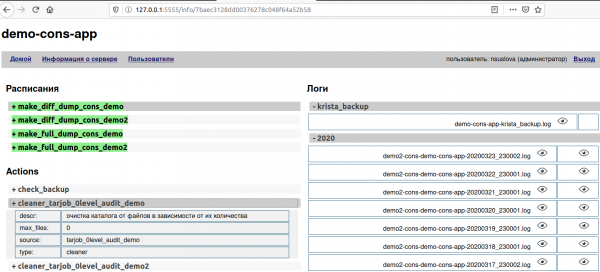
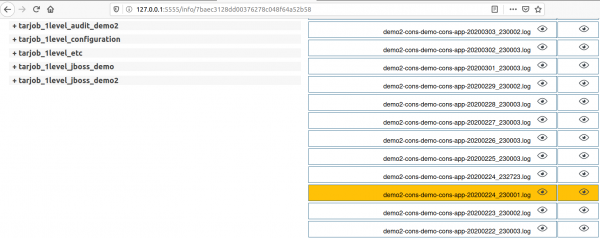
Se o administrador não precisar de um guia sobre os parâmetros e os sistemas operacionais dos servidores forem homogêneos, é possível compilar um arquivo e distribuir um pacote pronto.
Distribuímos esta ferramenta principalmente através do Ansible, inicialmente em uma parte dos servidores menos críticos, e após testes, nos demais.
Como resultado, obtivemos uma ferramenta de cópia compacta e autônoma, passível de automação e adequada para uso mesmo por administradores pouco experientes. É conveniente para nós - talvez seja útil para você também?
Fonte: habr.com
