

Inspirado em uma discussão no chat
Recentemente, verdadeiras batalhas têm se intensificado em torno da definição dos conceitos de DevOps e SRE.
Embora essas discussões já estejam cansativas, decidi apresentar minha perspectiva à comunidade do Habr. A todos os interessados, sintam-se à vontade para continuar. Que tudo comece de novo!
Antecedentes
Assim, em tempos antigos, havia uma equipe separada de desenvolvedores de software e administradores de servidores. Os primeiros escreviam código com sucesso, enquanto os segundos, usando várias palavras carinhosas em relação aos primeiros, configuravam os servidores, visitando os desenvolvedores algumas vezes e recebendo como resposta um enfático "na minha máquina funciona tudo". O negócio esperava pelo software, tudo parava, quebrava de vez em quando, e todos ficavam nervosos. Especialmente quem pagava todo esse caos. A gloriosa era analógica. Mas vocês já sabem de onde vem o DevOps.
O nascimento das práticas de DevOps
Então, vieram os senhores sérios e disseram - isso não é uma indústria, não se pode trabalhar assim. E trouxeram modelos de ciclo de vida. Por exemplo, o modelo em V.
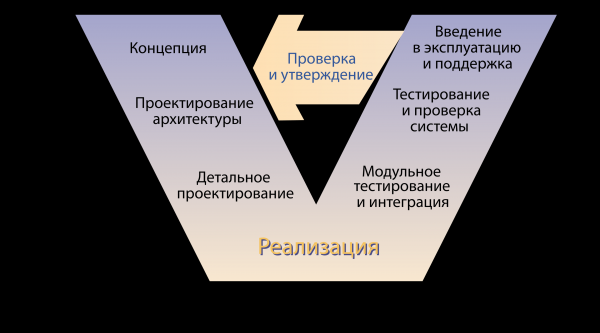
Então, o que vemos? O negócio chega com um conceito, os arquitetos projetam soluções, os desenvolvedores escrevem código, e então - tudo desmorona. Alguém testa o produto de algum jeito, alguém o entrega ao usuário final e em algum ponto dessa maravilha de modelo, um solitário cliente do negócio espera a promessa que está no vento. Chegaram à conclusão de que eram necessários métodos que pudessem organizar esse processo. Decidiram então criar práticas que os implementassem.
Um parêntese lírico sobre o que é prática
Por prática, entendo uma combinação de tecnologia e disciplina. Exemplo - a prática de descrever infraestrutura como código usando terraform. A disciplina é como descrever a infraestrutura como código, está na cabeça do desenvolvedor, e a tecnologia é, de fato, o terraform.
E decidiram chamá-los de práticas DevOps – acho que se referiam a 'do Desenvolvimento à Operação'. Inventaram diversas coisas complicadas – práticas de CI/CD, práticas baseadas no princípio de IaC, milhares delas. E assim começou, os desenvolvedores escrevem código, os engenheiros DevOps transformam a descrição do sistema em código em sistemas funcionais (sim, código é infelizmente apenas uma descrição, mas de forma alguma a manifestação do sistema), a entrega gira, e assim por diante. Administradores de ontem, ao dominar novas práticas, orgulhosamente se requalificaram como engenheiros DevOps, e tudo começou. E foi à noite, e foi de manhã... desculpe, não é disso que se trata.
Tudo de novo não está certo.
Assim que as coisas se acalmaram, diferentes 'metodologistas' astutos começaram a escrever livros volumosos sobre práticas DevOps, debates silenciosos começaram sobre quem realmente é o tão falado engenheiro DevOps e o que é DevOps – uma cultura de produção, a insatisfação voltou a surgir. De repente, ficou claro que a entrega de software é uma tarefa absolutamente não trivial. Cada infraestrutura de desenvolvimento tem sua própria pilha; em alguns lugares, é preciso compilar, em outros, configurar o ambiente, aqui precisamos de tomcat, ali um jeito complicado de inicializar – no geral, a cabeça dói. E a questão, estranhamente, estava primariamente na organização dos processos – essa função de entrega, como um gargalo, começou a bloquear os processos. Além disso, a operação (Operations) não foi cancelada. Não é visível no modelo V, e ainda há todo o ciclo de vida à direita. No final, é preciso manter a infraestrutura, monitorar, resolver incidentes e ainda se preocupar com a entrega. Ou seja, equilibrar tanto o desenvolvimento quanto a operação – e de repente surgiu esse Development & Operations. E ainda houve um frenesi em torno de microsserviços. Com eles, o desenvolvimento começou a migrar das máquinas locais para a nuvem – tente depurar algo localmente se há dezenas e centenas de microsserviços; a entrega contínua torna-se uma questão de sobrevivência. Para uma 'pequena empresa discreta' isso é aceitável, mas e quanto ao Google?
SRE do Google
O Google chegou, comeu os maiores cactos e decidiu — não precisamos disso, precisamos de confiabilidade. E a confiabilidade precisa ser gerenciada. E decidiu — precisamos de especialistas que gerenciem a confiabilidade. Chamou-os de engenheiros de SR e disse, aqui está tudo que vocês precisam, façam o que costumam fazer, bem. Aqui está seu SLI, aqui está seu SLO, aqui está a monitoração. E apontou para as operações. E chamou seu 'DevOps confiável' de SRE. Parece tudo bem, mas há um truque sujo que o Google pôde se permitir — contratar pessoas para a posição de engenheiros de SR que tinham qualificações de desenvolvedores e ainda entendiam um pouco sobre o funcionamento de sistemas em operação. Além disso, o Google também tem problemas para contratar essas pessoas — principalmente porque ele mesmo concorre consigo mesmo — deve haver alguém que descreva a lógica de negócios. A entrega foi delegada aos engenheiros de lançamento, os engenheiros de SR gerenciam a confiabilidade (claro, não diretamente, mas influenciando a infraestrutura, mudando a arquitetura, monitorando mudanças e indicadores, lidando com incidentes). Bonito, pode . E o que fazer se você não é o Google, mas a confiabilidade ainda o preocupa?
Desenvolvimento de ideias de DevOps
Aqui chegou o Docker, que cresceu a partir do lxc, e depois várias sistemas de orquestração como Docker Swarm e Kubernetes, e os engenheiros de DevOps respiraram aliviados — a unificação das práticas simplificou a entrega. Simplificou a tal ponto que se tornou possível até passar a entrega para os desenvolvedores — o que há naquele deployment.yaml? A containerização resolve o problema. E a maturidade dos sistemas de CI/CD já está num nível onde você escreve um arquivo e tudo começa a funcionar — os desenvolvedores conseguem sozinhos. E aqui começamos a falar sobre como criar nosso SRE, com... bem, com qualquer um.
SRE não é só no Google
Bem, entregamos a tarefa, parece que podemos respirar aliviados, voltar aos velhos tempos em que os administradores monitoravam a carga dos processadores, ajustavam sistemas e sorviam algo indefinido de canecas em silêncio e tranquilidade... Espera. Não foi por isso que tudo começou (e que pena!). De repente, percebemos que na abordagem do Google podemos adotar boas práticas — não é a carga dos processadores que importa, nem a frequência com que trocamos os discos, ou a otimização de custos na nuvem, mas sim as métricas de negócios — todos aqueles already notorious SLx. E a gestão da infraestrutura não foi retirada deles, há incidentes a serem resolvidos, é necessário estar de plantão periodicamente e, de modo geral, estar por dentro dos processos de negócios. E pessoal, comecem a programar um pouco melhor, o Google já está esperando por vocês.
Resumindo. De repente, mas você já está cansado de ler e mal pode esperar para comentar sobre o autor do artigo. DevOps, como prática de entrega, existiu, existe e sempre haverá. E não vai a lugar nenhum. O SRE, como um conjunto de práticas de operação, torna essa entrega bem-sucedida.
Fonte: habr.com
