

Não importa o quanto a tecnologia evolua, sempre haverá uma série de abordagens obsoletas que a acompanham. Isso pode ser devido a uma transição gradual, fatores humanos, necessidades tecnológicas ou outras razões. Na área de processamento de dados, as fontes de dados são um exemplo notável disso. Por mais que desejemos nos livrar disso, enquanto parte dos dados ainda for enviada por meio de mensageiros e e-mails, sem mencionar formatos ainda mais arcaicos, será uma realidade. Convido você a explorar, a seguir, uma das opções para o Apache Airflow, que ilustra como é possível extrair dados de e-mails.
Antecedentes
Ainda há muitos dados sendo transmitidos por e-mail, desde comunicações interpessoais até padrões de interação entre empresas. É benéfico quando conseguimos criar uma interface para obter dados ou alocar pessoas no escritório para inserir essas informações em fontes mais convenientes, mas muitas vezes essa possibilidade simplesmente não existe. O desafio específico que enfrentei foi conectar um conhecido sistema de CRM a um repositório de dados e, posteriormente, a um sistema OLAP. Historicamente, o uso desse sistema foi conveniente em uma área específica de negócios para nossa empresa. Portanto, todos tinham grande interesse em poder manipular dados também a partir desse sistema externo. Em primeiro lugar, naturalmente, investigamos a possibilidade de obter dados a partir de uma API aberta. Infelizmente, a API não cobria todos os dados necessários e, para simplificar, apresentava várias falhas, e o suporte técnico não quis ou não pôde nos ajudar a obter funcionalidades mais abrangentes. No entanto, esse sistema oferecia a possibilidade de receber periodicamente dados faltantes por e-mail na forma de um link para baixar o arquivo.
É importante notar que este não foi o único caso em que o negócio desejava coletar dados de e-mails ou mensageiros. No entanto, neste caso, não conseguíamos influenciar a empresa que fornece parte dos dados apenas dessa forma.
Apache Airflow
Para construir processos ETL, geralmente usamos o Apache Airflow. Para que o leitor, que não está familiarizado com esta tecnologia, compreenda melhor como isso funciona no contexto geral, descreverei algumas introduções.
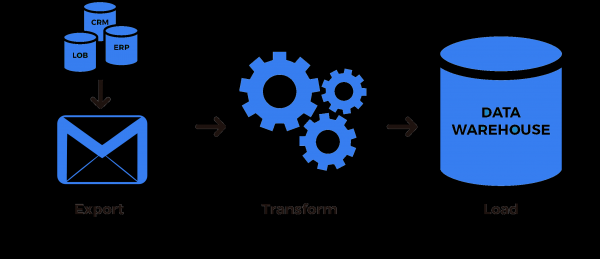
O Apache Airflow é uma plataforma livre usada para construir, executar e monitorar processos ETL (Extract-Transform-Loading) na linguagem Python. O conceito principal no Airflow é o grafo acíclico direcionado, onde os vértices do grafo são processos específicos, e as arestas do grafo representam o fluxo de controle ou de informação. Um processo pode simplesmente chamar qualquer função Python ou pode ter uma lógica mais complexa de chamada sequencial de várias funções dentro de um contexto de classe. Para operações comuns, já existem várias implementações prontas que podem ser usadas como processos. Entre essas implementações, estão:
- operadores — para transferir dados de um lugar para outro, por exemplo, de uma tabela de banco de dados para um armazém de dados;
- sensores — para aguardar a ocorrência de um evento específico e direcionar o fluxo de controle para os próximos vértices do grafo;
- ganchos — para operações de nível mais baixo, por exemplo, para obter dados de uma tabela de banco de dados (usados em operadores);
- etc.
Descrever o Apache Airflow em detalhes neste artigo não seria viável. Introduções resumidas podem ser vistas ou .
Gancho para obter dados
Em primeiro lugar, para resolver a tarefa, precisamos escrever um gancho que nos permita:
- conectar à conta de e-mail;
- encontrar o e-mail necessário;
- extrair dados do e-mail.
from airflow.hooks.base_hook import BaseHook
import imaplib
import logging

class IMAPHook(BaseHook):
    def __init__(self, imap_conn_id):
        """
           IMAP hook para obter dados de e-mail

           :param imap_conn_id:       Identificador de conexão de e-mail
           :type imap_conn_id:        string
        """
        self.connection = self.get_connection(imap_conn_id)
        self.mail = None

    def authenticate(self):
        """
            Conectando-se ao e-mail
        """
        mail = imaplib.IMAP4_SSL(self.connection.host)
        response, detail = mail.login(user=self.connection.login, password=self.connection.password)
        if response != "OK":
            raise AirflowException("Falha ao entrar")
        else:
            self.mail = mail

    def get_last_mail(self, check_seen=True, box="INBOX", condition="(UNSEEN)"):
        """
            Método para obter o identificador do último e-mail,
            atendendo às condições de busca

            :param check_seen:      Marcar o último e-mail como lido
            :type check_seen:       bool
            :param box:             Nome da caixa de entrada
            :type box:              string
            :param condition:       Condições de busca de e-mails
            :type condition:        string
        """
        self.authenticate()
        self.mail.select(mailbox=box)
        response, data = self.mail.search(None, condition)
        mail_ids = data[0].split()
        logging.info("Os seguintes e-mails foram encontrados na caixa: " + str(mail_ids))

        if not mail_ids:
            logging.info("Nenhum e-mail novo encontrado")
            return None

        mail_id = mail_ids[0]

        # se houver vários e-mails
        if len(mail_ids) > 1:
            # marcar os outros como lidos
            for id in mail_ids:
                self.mail.store(id, "+FLAGS", "\Seen")

            # retorna o último
            mail_id = mail_ids[-1]

        # deve marcar o último como lido?
        if not check_seen:
            self.mail.store(mail_id, "-FLAGS", "\Seen")

        return mail_id
A lógica é a seguinte: conectamos, encontramos o último e-mail mais relevante, se houver outros — os ignoramos. Esta função é utilizada especificamente porque e-mails posteriores contêm todos os dados dos anteriores. Se não for o caso, podemos retornar um array de todos os e-mails ou processar o primeiro, e os demais — na próxima passagem. Em geral, tudo depende da tarefa.
Adicionamos ao hook duas funções auxiliares: uma para baixar arquivo e outra para baixar arquivo através de um link no e-mail. Aliás, elas podem ser extraídas para um operador, dependendo da frequência de uso dessa funcionalidade. O que mais adicionar ao hook depende da tarefa: se o e-mail já chegar com arquivos, pode-se baixar os anexos; se os dados vierem no corpo do e-mail, é necessário analisar a mensagem, etc. No meu caso, o e-mail chega com um link para um arquivo zip, que preciso colocar em um local específico e iniciar o processo de processamento.
    def download_from_url(self, url, path, chunk_size=128):
        """
            Método para baixar arquivo

            :param url:              Endereço de download
            :type url:               string
            :param path:             Onde salvar o arquivo
            :type path:              string
            :param chunk_size:       Tamanho do bloco em bytes
            :type chunk_size:        int
        """
        r = requests.get(url, stream=True)
        with open(path, "wb") as fd:
            for chunk in r.iter_content(chunk_size=chunk_size):
                fd.write(chunk)

    def download_mail_href_attachment(self, mail_id, path):
        """
            Método para baixar arquivo através de um link no e-mail

            :param mail_id:         Identificador do e-mail
            :type mail_id:          string
            :param path:            Onde salvar o arquivo
            :type path:             string
        """
        response, data = self.mail.fetch(mail_id, "(RFC822)")
        raw_email = data[0][1]
        raw_soup = raw_email.decode().replace("r", "").replace("n", "")
        parse_soup = BeautifulSoup(raw_soup, "html.parser")
        link_text = ""

        for a in parse_soup.find_all("a", href=True, text=True):
            link_text = a["href"]

        self.download_from_url(link_text, path)
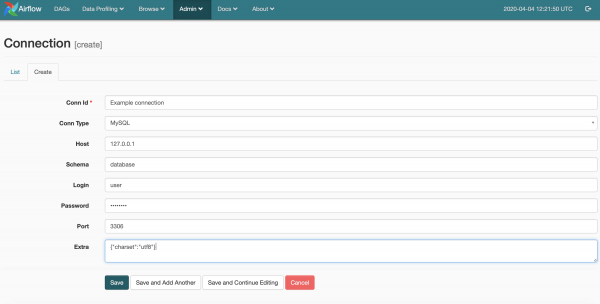
O código é simples, então provavelmente não precisa de explicações adicionais. Vou falar apenas sobre a linha mágica imap_conn_id. O Apache Airflow armazena parâmetros de conexão (login, senha, endereço e outros parâmetros) que podem ser acessados por um identificador em forma de string. Visualmente, o gerenciamento de conexões se parece com isso.
Sensor para aguardar dados
Como já sabemos como nos conectar e receber dados do e-mail, agora podemos escrever um sensor para aguardá-los. Não consegui escrever de imediato um operador que processe os dados, pois, com base nos dados recebidos do e-mail, outros processos também funcionam, incluindo aqueles que obtêm dados relacionados de outras fontes (API, telefonia, web métricas, etc.). Vou dar um exemplo. Na plataforma CRM, um novo usuário surgiu, e ainda não sabemos sobre seu UUID. Então, ao tentar obter dados da telefonia SIP, receberemos chamadas vinculadas ao seu UUID, mas não poderemos armazená-las e usá-las corretamente. Nesses casos, é importante ter em mente a dependência dos dados, especialmente se eles vêm de diferentes fontes. Essas, claro, são medidas insuficientes para garantir a integridade dos dados, mas em alguns casos são necessárias. Além disso, ocupar recursos sem necessidade também não é racional.
Dessa forma, nosso sensor iniciará os vértices subsequentes do gráfico, se houver informações novas no e-mail, e também marcará como não atual as informações anteriores.
from airflow.sensors.base_sensor_operator import BaseSensorOperator
from airflow.utils.decorators import apply_defaults
from my_plugin.hooks.imap_hook import IMAPHook

class MailSensor(BaseSensorOperator):
    @apply_defaults
    def __init__(self, conn_id, check_seen=True, box="Inbox", condition="(UNSEEN)", *args, **kwargs):
        super().__init__(*args, **kwargs)
        self.conn_id = conn_id
        self.check_seen = check_seen
        self.box = box
        self.condition = condition

    def poke(self, context):
        conn = IMAPHook(self.conn_id)
        mail_id = conn.get_last_mail(check_seen=self.check_seen, box=self.box, condition=self.condition)

        if mail_id is None:
            return False
        else:
            return True
Recebemos e utilizamos dados
Para obter e processar dados, você pode escrever um operador separado ou usar um pronto. Como a lógica é trivial — apenas pegar dados do e-mail, sugiro um exemplo com o PythonOperator padrão
from airflow.models import DAG

from airflow.operators.python_operator import PythonOperator
from airflow.sensors.my_plugin import MailSensor
from my_plugin.hooks.imap_hook import IMAPHook

start_date = datetime(2020, 4, 4)

# Configuração padrão do grafo
args = {
    "owner": "example",
    "start_date": start_date,
    "email": ["home@home.ru"],
    "email_on_failure": False,
    "email_on_retry": False,
    "retry_delay": timedelta(minutes=15),
    "provide_context": False,
}

dag = DAG(
    dag_id="test_etl",
    default_args=args,
    schedule_interval="@hourly",
)

# Definindo o sensor
mail_check_sensor = MailSensor(
    task_id="check_new_emails",
    poke_interval=10,
    conn_id="mail_conn_id",
    timeout=10,
    soft_fail=True,
    box="my_box",
    dag=dag,
    mode="poke",
)

# Função para obter dados do email
def prepare_mail():
    imap_hook = IMAPHook("mail_conn_id")
    mail_id = imap_hook.get_last_mail(check_seen=True, box="my_box")
    if mail_id is None:
        raise AirflowException("Caixa de entrada vazia")

    conn.download_mail_href_attachment(mail_id, ".\/path.zip")

prepare_mail_data = PythonOperator(task_id="prepare_mail_data", default_args=args, dag=dag, python_callable= prepare_mail)

# Descrição dos outros nós do grafo
...

# Definindo a conexão no grafo
mail_check_sensor >> prepare_mail_data
prepare_data >> ...
# Descrição dos outros fluxos de controle
Por falar nisso, se o seu email corporativo também estiver no mail.ru, você não terá acesso à pesquisa de emails por assunto, remetente, etc. Eles prometeram isso lá em 2016, mas, aparentemente, mudaram de ideia. Resolvi esse problema criando uma pasta separada para os emails necessários e configurando um filtro no interface web do email. Assim, apenas os emails certos vão para essa pasta, e as condições de busca são simplesmente (UNSEEN).
Resumindo, temos a seguinte sequência: verificamos se há novos emails que atendem às condições; se houver, baixamos o arquivo zip pelo link do último email.
Sob os últimos reticências, não foi mencionado que este arquivo zip será descompactado, os dados do arquivo serão limpos e processados, e, no final, tudo isso seguirá para o processo ETL, mas isso já foge do escopo do artigo. Se você achou interessante e útil, ficarei feliz em continuar descrevendo soluções ETL e suas partes para o Apache Airflow.
Fonte: habr.com
