

No verão, a atividade do consumidor e a intensidade das mudanças na infraestrutura dos projetos da web tradicionalmente diminuem, diz o Capitão Óbvio. Apenas porque até os profissionais de TI, às vezes, tiram férias. E os CTOs também. O que torna mais difícil para aqueles que permanecem no cargo, mas não é sobre isso que estamos falando agora: talvez seja precisamente por isso que o verão seja o melhor período para refletir calmamente sobre o esquema de backup existente e elaborar um plano para sua melhoria. E a experiência de E ogar Andreev será útil nesse sentido. , sobre a qual ele falou na conferência .
Ao construir sites de backup, existem várias armadilhas nas quais podemos cair. E cair nelas é completamente inaceitável. O que nos causa problemas, assim como em muitas outras questões, é o perfeccionismo e... a preguiça. Tentamos fazer tudo absolutamente perfeito, mas não precisamos fazer tudo de forma perfeita! Devemos nos concentrar apenas em certas coisas, mas fazê-las corretamente, finalizá-las para que funcionem adequadamente.
Failover não é algo divertido ou desnecessário; é uma coisa que deve fazer uma única coisa - reduzir o tempo de inatividade para que o serviço ou a empresa perca menos dinheiro. E em todos os métodos de backup, sugiro pensar no seguinte contexto: onde estão os recursos financeiros?
A primeira armadilha: quando construímos sistemas grandes e confiáveis e trabalhamos em backup - diminuímos o número de falhas. Isso é uma ilusão terrível. Quando trabalhamos em backups, provavelmente aumentamos o número de falhas. E se fizermos tudo corretamente, então, no total, reduziremos o tempo de inatividade. Haverá mais falhas, mas elas ocorrerão com menores custos. Afinal, o que é backup? — é a complexificação do sistema. Qualquer complexidade é prejudicial: temos mais parafusos, mais engrenagens, em suma, mais elementos — e, portanto, uma chance maior de falhas. E eles realmente quebrarão. E ocorrerão com mais frequência. Um exemplo simples: digamos que temos um site, com PHP, MySQL. E ele precisa ser urgentemente reservado.
Então (c) Vamos pegar a segunda plataforma, construir um sistema idêntico... A complexidade dobra — temos duas entidades. E ainda por cima, adicionamos uma lógica específica de transferência de dados de uma plataforma para outra — ou seja, replicação de dados, cópia de estáticos e assim por diante. Pois bem, a lógica de replicação — geralmente, é muito complexa, e, portanto, a complexidade total do sistema pode ser não 2, mas 3, 5, 10 vezes maior.
A segunda armadilha: quando construímos sistemas realmente grandes e complexos, fantasizamos sobre o que queremos obter no final. Voilà: queremos um sistema super confiável, que funciona sem downtime, que muda em meio segundo (ou melhor, instantaneamente), e começamos a tornar nossos sonhos realidade. Mas aqui também há um detalhe: quanto menor o tempo desejado de mudança, mais complexa se torna a lógica do sistema. Quanto mais complexa for essa lógica, mais vezes o sistema falhará. E pode-se entrar em uma situação muito desagradável: estamos tentando a todo custo reduzir o tempo de inatividade, mas, na verdade, estamos complicando tudo e, quando algo dá errado, o tempo de inatividade acaba sendo maior. Muitas vezes, nos pegamos pensando: ah... seria melhor não termos feito a reserva. Seria melhor se apenas um funcionasse com um tempo de inatividade compreensível.
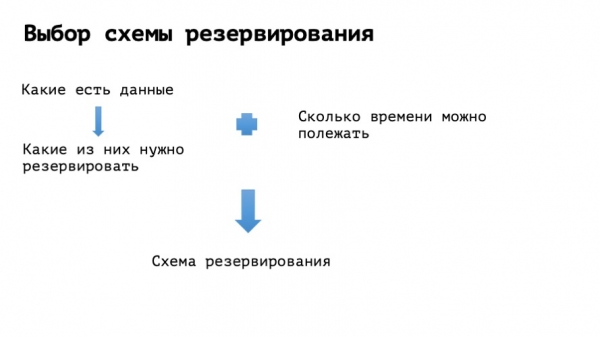
Como podemos lidar com isso? Precisamos parar de mentir para nós mesmos, parar de nos iludir achando que vamos construir uma espaçonave, mas entender adequadamente quanto tempo o projeto pode realmente levar. E, para esse tempo máximo, escolheremos quais métodos realmente usaremos para aumentar a confiabilidade do nosso sistema.
É hora de 'histórias da vida'... da vida, é claro.
Exemplo número um
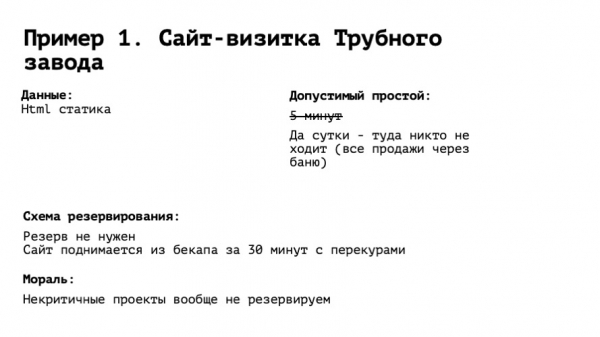
Imagine um site de apresentação da fábrica de tubos nº 1 da cidade de N. Está escrito em letras enormes — FÁBRICA DE TUBOS Nº 1. Um pouco abaixo, o slogan: "Nossos tubos são os tubos mais redondos de N". E embaixo, o número de telefone do diretor-geral e seu nome. Entendemos que é necessário reservar — isso é algo muito importante! Começamos a investigar do que se trata. É uma página HTML estática — ou seja, algumas imagens do diretor, na verdade, à mesa em uma sauna com seu parceiro discutindo algum negócio. Começamos a pensar sobre o tempo de inatividade. Vem à mente a ideia: é preciso ficar lá por cinco minutos, no máximo. E aqui surge a pergunta: quantas vendas foram feitas através desse nosso site? Quantas, quantas? O que significa "zero"? Ou seja: porque todas as quatro vendas do ano passado o diretor fez na mesma mesa, com as mesmas pessoas com quem ele vai à sauna. E entendemos que mesmo se o site ficar fora do ar por um dia — não será nada aterrorizante.
Com base nas informações fornecidas, temos um dia para levantar essa questão. Começamos a pensar sobre o esquema de reserva. E escolhemos o esquema de reserva mais ideal para este exemplo: não usamos reserva. Todo esse processo pode ser realizado por qualquer administrador em meia hora, com intervalos. Colocar um servidor web, colocar os arquivos — tudo. Ele funcionará. Não é necessário monitorar nada, nem prestar atenção especial a nada. Portanto, a conclusão do primeiro exemplo é bastante óbvia: serviços que não precisam de reserva — não precisam ser reservados.
Exemplo número dois
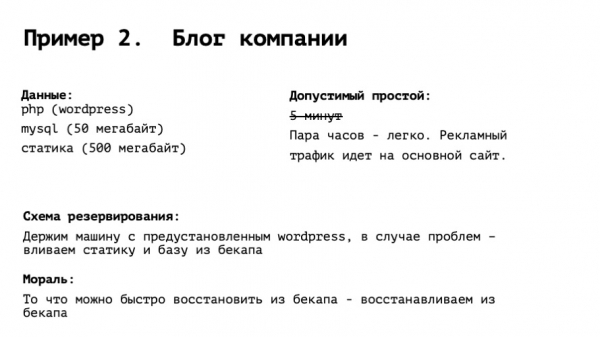
Blog da empresa: pessoas especialmente treinadas escrevem notícias lá, participamos de uma determinada feira, e aqui está o nosso novo produto que lançamos, e assim por diante. Digamos que é um PHP padrão com WordPress, um pequeno banco de dados e um pouco de estática. Claro, novamente vem à mente que não se pode ficar parado — "não mais do que cinco minutos!", tudo isso. Mas vamos refletir mais. O que este blog faz? Ele recebe visitas do Yandex, do Google, por meio de algumas consultas, organicamente. Excelente. E as vendas estão de alguma forma ligadas a isso? Revelação: não muito. O tráfego publicitário vai para o site principal, que está em outra máquina. Começamos a pensar no esquema de reserva do blog. O ideal seria levantá-lo em algumas horas, e seria bom se prepararmos para isso. Seria sensato pegar uma máquina em outro data center, configurar um ambiente, ou seja, um servidor web, PHP, WordPress, MySQL, e deixá-lo em modo off. No momento em que percebemos que tudo quebrou, precisamos fazer duas coisas — restaurar um dump do MySQL de 50 megabytes, que será feito em um minuto, e restaurar algumas imagens do backup. Isso também não vai levar muito tempo. Assim, em meia hora, toda essa estrutura é levantada. Nenhuma replicação, ou, Deus me livre, failover automático. Conclusão: o que podemos rapidamente restaurar de um backup — não precisa ser reservado.
Exemplo número três, um pouco mais complicado
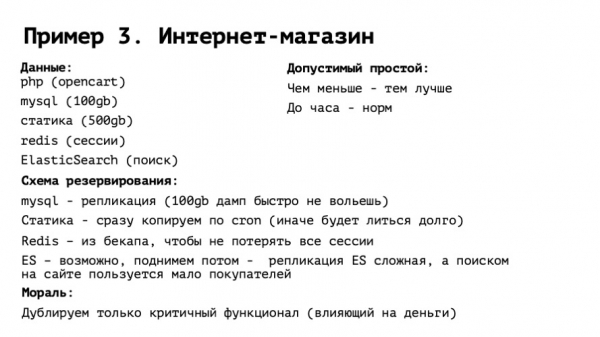
Loja virtual. PHP com open heart um pouco modificado, MySQL com uma base sólida. Bastante estática (afinal, em uma loja virtual há lindas fotos em HD e tudo mais), Redis para sessões e Elasticsearch para busca. Começamos a pensar sobre o tempo de inatividade. E aqui é claro que não podemos deixar a loja virtual fora do ar por um dia sem problemas. Quanto mais tempo ela ficar fora, mais dinheiro perdemos. É hora de acelerar. E quanto? Acredito que se ficarmos uma hora fora, ninguém ficará louco. Sim, perderemos algo, mas se começarmos a nos esforçar — será ainda pior. Definimos o esquema de inatividade aceitável por hora.
Como podemos reservar tudo isso? A máquina é necessária, de qualquer forma: uma hora é bastante pouco. Mysql: aqui já precisamos de replicação, replicação ativa, porque em uma hora 100 GB em um dump, provavelmente, não caberá. Estática, imagens: novamente, em uma hora 500 GB pode não conseguir ser transferido. Sendo assim, é melhor copiar as imagens de imediato. Redis: aqui a situação é mais interessante. As sessões estão no Redis - simplesmente não podemos apagá-lo. Porque isso não seria muito bom: todos os usuários ficariam desconectados, os carrinhos de compras limpos e assim por diante. As pessoas seriam obrigadas a digitar novamente seu login e senha, e muitos poderiam desistir e não finalizar a compra. Novamente, a conversão cairia. Por outro lado, o Redis é exatamente o que precisamos, com os últimos usuários logados, talvez também não seja necessário. E um bom compromisso seria pegar o Redis e restaurá-lo a partir de um backup, do dia anterior, ou, se você o fizer a cada hora, do último backup. Felizmente, restaurá-lo a partir de um backup é a cópia de um único arquivo. E a história mais interessante é o Elasticsearch. Quem já implantou a replicação do MySQL? Quem já implantou a replicação do Elasticsearch? E quem teve seu funcionamento normal depois? Eu quero dizer: vemos em nosso sistema uma certa entidade. Ela parece ser útil - mas é complexa.
É complicado no sentido de que nossos colegas engenheiros não têm experiência com isso. Ou têm uma experiência negativa. Ou entendemos que, por enquanto, é uma tecnologia bastante nova com nuances ou incertezas. Estamos pensando... Poxa, elastic também é grande, leva tempo para restaurá-lo a partir do backup, o que fazer? Sabemos que o elastic, nesse caso, é utilizado para busca. E como nosso e-commerce vende? Vamos até os profissionais de marketing e perguntamos de onde as pessoas estão chegando. Eles respondem: "90% vêm diretamente do Yandex.Market para a página do produto". E compram ou não. Portanto, a busca é necessária para 10% dos usuários. Manter a replicação do elastic, especialmente entre diferentes data centers em diferentes regiões, realmente tem muitas nuances. Qual é a saída? Pegamos o elastic em uma infraestrutura reservada e não fazemos nada com ele. Se a situação se prolongar, talvez um dia o reativemos, mas isso é incerto. Na verdade, a conclusão é mais ou menos a mesma: serviços que não impactam as finanças, novamente, não são reservados. Para que o esquema permaneça mais simples.
Exemplo número quatro, ainda mais complicado.
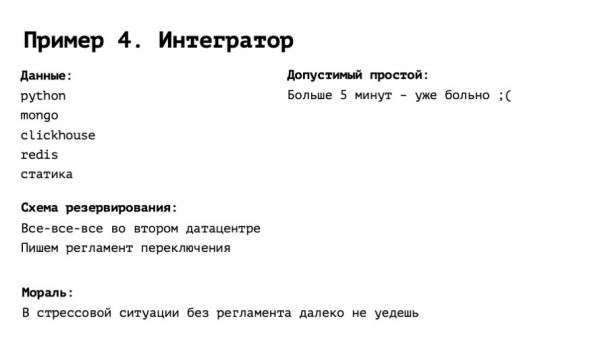
Integrador: venda de flores, chamada de táxi, vendas de produtos, enfim, o que for. Um negócio sério, que funciona 24/7 para um grande número de usuários. Com um stack interessante, onde há bases interessantes, soluções, alta carga e, o mais importante, se ele estiver fora do ar por mais de 5 minutos, isso é doloroso. Não só porque as pessoas não comprarão, mas porque verão que essa coisa não está funcionando, ficarão desapontadas e podem não voltar nunca mais.
Ok. Cinco minutos. O que vamos fazer com isso? Nesse caso, de forma profissional, com todo o investimento, construímos uma verdadeira infraestrutura de backup, com replicação de tudo e todos, e talvez até automatizemos ao máximo a troca para essa infraestrutura. E, além disso, não podemos esquecer de fazer uma coisa importante: efetivamente, escrever um regulamento de troca. O regulamento, mesmo que você tenha tudo automatizado, pode ser bastante simples. Algo do tipo "executar este determinado script ansible", "marcar esta opção no Route 53" e assim por diante — mas deve haver uma lista precisa de ações.
E parece que tudo está claro. Mudar a replicação é uma tarefa trivial, ou ela se ajustará sozinha. Alterar o nome de domínio no DNS é da mesma linha. O problema é que, quando um projeto assim cai, começa o pânico, e até os administradores mais experientes podem se deixar levar por isso. Sem uma instrução clara "abra o terminal, vá para aqui, o endereço do nosso servidor ainda é este", é difícil manter o prazo de 5 minutos destinado à recuperação. E além disso, quando usamos esse regulamento, é fácil registrar algumas mudanças na infraestrutura, por exemplo, e alterar o regulamento de acordo.
Mas, e se o sistema de reserva for muito complexo e, em algum momento, cometemos um erro, podemos acabar com nosso ambiente de backup e ainda transformar os dados em abóbora em ambos os ambientes – isso será realmente triste.
Exemplo número cinco, hardcore completo
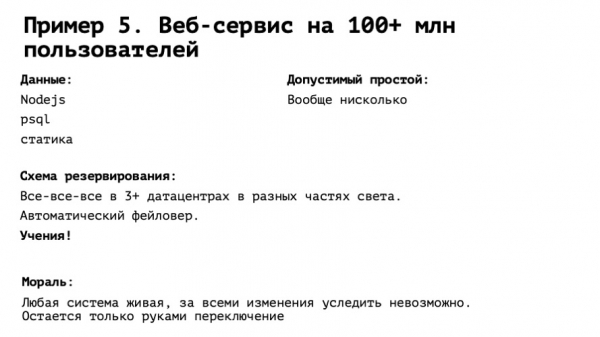
Um serviço internacional com centenas de milhões de usuários em todo o mundo. Todos os fusos horários, o máximo de highload, não pode haver quedas de forma alguma. Um minuto — e a situação fica complicada. O que fazer? Reservar, novamente, da maneira mais completa. Fizemos tudo o que foi mencionado no exemplo anterior, e um pouco mais. Um mundo ideal, e nossa infraestrutura — ela se encaixa em todos os conceitos de DevOps IaaC. Ou seja, tudo está no git, e é só clicar no botão.
O que falta? Uma coisa — treinamentos. Sem eles, não dá. Parece que está tudo perfeito, temos tudo sob controle. Apertamos o botão, tudo acontece. Mesmo que assim seja — e sabemos que não é bem assim — nosso sistema interage com outros sistemas. Por exemplo, o DNS do Route 53, armazenamento S3, integração com alguma API. Não poderemos prever tudo neste experimento teórico. E até que realmente acionemos o interruptor — não saberemos se vai funcionar ou não.
Por aqui, acho que é isso. Não sejam preguiçosos e não exagerem. E que a uptime esteja com vocês!
Fonte: habr.com
