

Hoje vamos falar sobre uma tecnologia interessante implementada no sistema de armazenamento Unity/Unity XT – o FAST VP. Se você está ouvindo sobre o Unity pela primeira vez, pode conferir as especificações do sistema no link no final do artigo. Na equipe de projeto da Dell EMC, trabalhei com o FAST VP por mais de um ano. Hoje, quero explicar essa tecnologia em mais detalhes e revelar alguns aspectos de sua implementação. Claro, apenas aqueles que posso compartilhar. Se você está interessado em questões de armazenamento eficiente de dados ou simplesmente não compreendeu completamente a documentação, este artigo certamente será útil e interessante.
De cara, deixo claro o que não será abordado neste material. Não haverá busca por concorrentes nem comparações com eles. Também não pretendo discutir tecnologias semelhantes de código aberto, pois os leitores curiosos já devem conhecê-las. E, claro, não tenho a intenção de fazer nenhuma promoção.
Camadas de Armazenamento. Objetivos e Tarefas do FAST VP
FAST VP significa Fully Automated Storage Tiering for Virtual Pool. Complicado? Não se preocupe, vamos esclarecer. Tiering é uma maneira de organizar o armazenamento de dados em que existem vários níveis (tiers) onde esses dados são armazenados. Cada um tem suas próprias características. As mais importantes são: desempenho, capacidade e custo de armazenamento por unidade de informação. É claro que existe uma inter-relação entre elas.
Uma característica importante do tiering é que o acesso aos dados é fornecido de forma uniforme, independentemente de qual nível de armazenamento eles estejam no momento, e o tamanho do pool é igual à soma dos tamanhos dos recursos que o compõem. Aqui estão as diferenças em relação ao cache: o tamanho do cache não é adicionado ao volume total do recurso (pool, neste caso), e os dados do cache duplicam algum fragmento de dados do meio principal (ou farão isso se os dados do cache ainda não tiverem sido gravados). Além disso, a distribuição de dados entre os níveis é oculta do usuário. Ou seja, ele não vê quais dados estão localizados em cada nível; embora possa influenciar de forma indireta, definindo políticas (sobre as quais falaremos mais tarde).
Agora, vamos analisar as características da implementação do tiering de armazenamento na Unity. Na Unity, são identificados 3 níveis, ou tiers:
- Desempenho extremo (SSDs)
- Desempenho (SAS HDD 10k/15k RPM)
- Capacidade (NL-SAS HDD 7200 RPM)
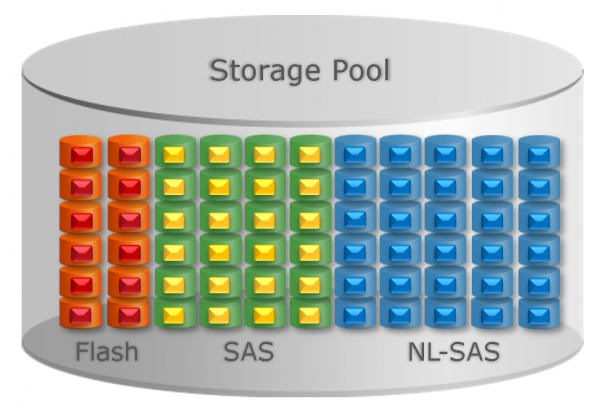
Eles são apresentados em ordem decrescente de desempenho e preço. Em Extreme performance, incluem-se exclusivamente unidades de estado sólido (SSD). Nos outros dois níveis, estão as unidades de disco magnético, que diferem na velocidade de rotação e, consequentemente, no desempenho.
Os dispositivos de um único nível e tamanho são agrupados em um array RAID, formando um grupo RAID (RAID group, abreviado para RG); sobre os níveis de RAID disponíveis e recomendados, você pode ler na documentação oficial. Dos grupos RAID de um ou vários níveis, formam-se pools de armazenamento (Storage pool), a partir dos quais o espaço livre é distribuído. E já do pool, o espaço é alocado para sistemas de arquivos e LUNs.
Por que eu preciso de Tiering?
Se for resumir e de forma abstrata: para alcançar um resultado maior, utilizando o mínimo de recursos. Em termos mais específicos, o resultado geralmente refere-se a um conjunto de características do armazenamento – velocidade e tempo de acesso, custo de armazenamento e outros. O mínimo de recursos significa os menores custos: dinheiro, energia e assim por diante. O FAST VP implementação justamente os mecanismos de redistribuição de dados entre diferentes níveis no armazenamento Unity/Unity XT. Se você me acredita, pode pular o próximo parágrafo. Para os outros, vou explicar um pouco mais.
A correta distribuição de dados entre os níveis de armazenamento permite economizar no custo total do armazenamento, sacrificando a velocidade de acesso a algumas informações raramente usadas, e aumenta o desempenho, movendo dados frequentemente utilizados para dispositivos mais rápidos. Aqui, alguém pode argumentar que mesmo sem tiering um bom administrador sabe onde colocar os dados, quais características de armazenamento são desejáveis para sua tarefa, etc. Sem dúvida, isso é verdade, mas a distribuição de dados 'manualmente' tem suas desvantagens:
- requer tempo e atenção do administrador;
- nem sempre é possível 'reconfigurar' os recursos do armazenamento para as condições mudadas;
- perde-se uma vantagem importante: acesso unificado aos recursos, que estão em diferentes níveis de armazenamento.
Para que os administradores de armazenamento se preocupem menos com a segurança no trabalho, acrescento que um planejamento adequado de recursos é necessário também aqui. Agora que as tarefas de tiering foram brevemente delineadas, vamos ver o que se pode esperar do FAST VP. É hora de voltar à definição. As duas primeiras palavras - Fully Automated - traduzem-se literalmente como "totalmente automatizado" e significam que a distribuição entre os níveis ocorre automaticamente. E o Virtual Pool é um pool de dados que inclui recursos de diferentes níveis de armazenamento. Veja como isso funciona:
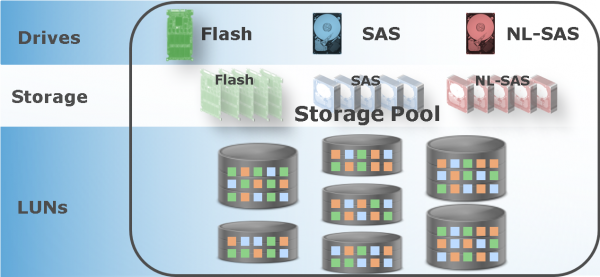
Antecipando-me, digo que o FAST VP move dados apenas dentro de um único pool, e não entre vários pools.
Tarefas abordadas pelo FAST VP
Primeiro, vamos falar de forma abstrata. Temos um pool e um mecanismo que pode redistribuir dados dentro desse pool. Lembrando que nossa tarefa é alcançar o máximo de desempenho, vamos nos questionar: de que maneiras isso pode ser alcançado? Podem existir várias, e o FAST VP tem muito a oferecer ao usuário, pois a tecnologia representa algo mais do que apenas tiering de armazenamento. Veja como o FAST VP pode aumentar o desempenho do pool:
- Distribuição de dados entre diferentes tipos de discos e níveis
- Distribuição de dados entre discos do mesmo tipo
- Distribuição de dados durante a expansão do pool
Antes de analisarmos como essas tarefas são resolvidas, precisamos conhecer alguns fatos necessários sobre o funcionamento do FAST VP. O FAST VP opera com blocos de um tamanho específico - 256 megabytes. Esse é o "pedaço" contínuo mínimo de dados que pode ser movido. Na documentação, ele é chamado assim: slice. Do ponto de vista do FAST VP, todos os grupos RAID consistem em um conjunto desses "pedaços". Assim, toda a estatística de entrada e saída é acumulada para esses blocos de dados. Por que esse tamanho de bloco foi escolhido e ele será reduzido? O bloco é grande o suficiente, mas é um compromisso entre a granularidade dos dados (tamanho menor do bloco - distribuição mais precisa) e os recursos computacionais disponíveis: com as atuais limitações rígidas de memória e um grande número de blocos, os dados estatísticos podem ocupar muito espaço, e o número de cálculos crescerá proporcionalmente.
Como o FAST VP aloca dados no pool. Políticas
Para gerenciar a alocação de dados em um pool com FAST VP habilitado, existem as seguintes políticas:
- Camada Mais Alta Disponível
- Auto-Camadas
- Começar Alto e depois Auto-Camadas (padrão)
- Camada Mais Baixa Disponível
Elas influenciam tanto a alocação inicial de um bloco (quando os dados são gravados pela primeira vez) quanto o realocação subsequente. Quando os dados já estão alocados nos discos, a realocação será iniciada de acordo com um cronograma ou manualmente.
A Camada Mais Alta Disponível tenta alocar um novo bloco no nível de desempenho mais alto. Se não houver espaço suficiente, será alocado no próximo nível de desempenho, mas depois os dados podem ser movidos para um nível de desempenho mais alto (se houver espaço ou deslocando outros dados). O Auto-Camadas aloca novos dados em diferentes níveis dependendo do tamanho do espaço disponível, e eles são realocados com base na demanda e espaço livre. Começar Alto e depois Auto-Camadas é a política padrão e também recomendada. Durante a alocação inicial, funciona como a Camada Mais Alta Disponível, e depois os dados são movidos com base em suas estatísticas de uso. A política da Camada Mais Baixa Disponível busca alocar dados no nível de desempenho mais baixo.
A realocação de dados ocorre com prioridade baixa para não interferir no funcionamento útil do armazenamento, no entanto, existe uma configuração chamada 'Taxa de realocação de dados' que altera essa prioridade. Há uma particularidade: nem todos os blocos de dados têm a mesma prioridade de realocação. Por exemplo, blocos marcados como metadados serão movidos para um nível mais rápido em primeiro lugar. Metadados são, por assim dizer, 'dados sobre dados', uma informação adicional que não são dados do usuário, mas que armazenam sua descrição. Por exemplo, informações em um sistema de arquivos sobre qual bloco contém um arquivo específico. Assim, a velocidade de acesso aos dados depende da velocidade de acesso aos metadados. Como os metadados geralmente são muito menores, espera-se um ganho maior ao movê-los para discos mais rápidos.
Critérios que o Fast VP utiliza em seu funcionamento
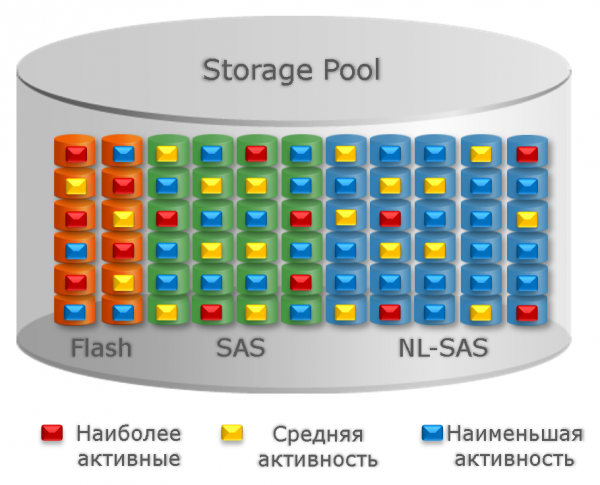
O critério principal para cada bloco, de forma muito simplificada, é a característica de "demanda" dos dados, que depende da quantidade de operações de leitura e gravação do fragmento de dados. Essa característica é chamada de "Temperatura". Existem dados quentes (hot) que são "mais quentes" do que dados não solicitados. É calculada periodicamente, por padrão a cada hora.
A função de cálculo da temperatura possui as seguintes propriedades:
- Na ausência de entrada e saída, os dados "esfriam" com o tempo.
- Sob uma carga mais ou menos constante ao longo do tempo, a temperatura aumenta inicialmente e depois se estabiliza em uma certa faixa.
Em seguida, são consideradas as políticas descritas acima e o espaço livre em cada tier. Para ilustrar, apresento uma imagem da documentação. Aqui, as áreas em vermelho, amarelo e azul representam blocos de alta, média e baixa temperatura, respectivamente.
Mas voltemos às tarefas. Assim, podemos começar a analisar o que é feito para resolver as tarefas do FAST VP.
A. Distribuição de dados entre diferentes tipos de discos, níveis
De fato, esta é a principal tarefa do FAST VP. As outras, de certa forma, são derivadas dela. Dependendo da política escolhida, os dados serão distribuídos em diferentes níveis de armazenamento. Primeiro, considera-se a política de alocação, em seguida a temperatura dos blocos e o tamanho/velocidade dos grupos RAID.
Para as políticas Highest/Lowest Available Tier, tudo é bastante simples. Para os outros dois, a situação é a seguinte. Os dados são distribuídos entre os diferentes níveis levando em conta o tamanho e o desempenho dos grupos RAID: de modo que a relação entre a "temperatura" total dos blocos e a "desempenho máximo condicional" de cada grupo RAID seja aproximadamente igual. Com isso, a carga é distribuída de forma mais ou menos uniforme. Dados mais solicitados são movidos para suportes mais rápidos, enquanto os menos utilizados vão para mídias mais lentas. Idealmente, a distribuição deve ser aproximadamente a seguinte:
B. Distribuição de dados entre discos do mesmo tipo
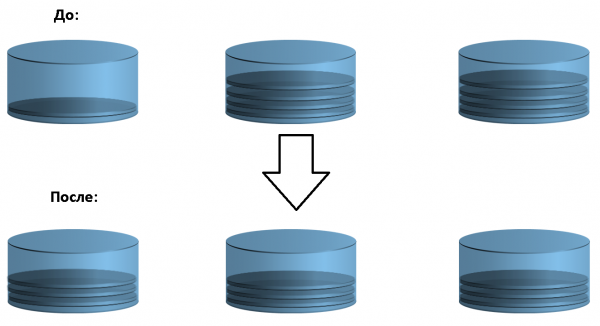
Lembre-se, no início eu mencionei que os dispositivos de armazenamento de um ou mais Os níveis se juntam em um único pool? No caso de um único nível para FAST VP, também há trabalho. Para que o desempenho de qualquer nível seja máximo, é desejável distribuir os dados uniformemente entre os discos. Isso permitirá (em teoria) obter o máximo de IOPS. Os dados dentro do grupo RAID podem ser considerados distribuídos uniformemente entre os discos, mas entre os grupos RAID isso nem sempre é o caso. Em caso de desequilíbrio, o FAST VP moverá os dados entre os grupos RAID proporcionalmente ao seu volume e 'desempenho condicional' (em expressão numérica). Para ilustrar, mostrará um esquema de reequilíbrio entre três grupos RAID:
B. Distribuição de dados ao expandir o pool
Essa tarefa é um caso específico da anterior e é realizada quando um grupo RAID é adicionado ao pool. Para que o novo grupo RAID não fique ocioso, parte dos dados será transferida para ele, e assim a carga sobre todos os grupos RAID será redistribuída.
Equalização de desgaste de SSD
Com a equalização de desgaste, o FAST VP pode prolongar a vida útil dos SSDs, embora essa função não esteja diretamente relacionada ao Storage Tiering. Como já existem dados sobre a temperatura, o número de operações de gravação também é levado em consideração, e conseguimos mover blocos de dados, então seria lógico para o FAST VP resolver também essa tarefa.
Caso o número de gravações em um grupo RAID supere significativamente o número de gravações em outro, o FAST VP redistribuirá os dados de acordo com o número de operações de gravação. Por um lado, isso alivia a carga e preserva o recurso de alguns discos, por outro lado, adiciona 'trabalho' para os menos carregados, aumentando o desempenho geral.
Assim, o FAST VP assume as tarefas tradicionais do Storage Tiering e ainda faz um pouco mais do que isso. Tudo isso permite armazenar dados de forma bastante eficiente nos sistemas de armazenamento da família Unity.
Algumas dicas
- Não negligencie a leitura da documentação. Existem boas práticas, e elas funcionam muito bem. Se seguidas, geralmente não surgem problemas sérios. Os demais conselhos geralmente repetem ou complementam esses.
- Se você configurou e ativou o FAST VP, é melhor mantê-lo ligado. Deixe-o distribuir os dados ao longo do tempo designado, aos poucos, em vez de uma vez por ano, impactando seriamente o desempenho de outras tarefas. Nesses casos, a redistribuição de dados pode se prolongar por muito tempo.
- Preste atenção na escolha da janela de realocação. Embora isso seja óbvio, tente escolher um momento com a menor carga possível no Unity e reserve um intervalo de tempo adequado.
- Planeje a expansão do armazenamento, faça isso a tempo. Essa é uma recomendação geral, que também é importante para o FAST VP. Se o volume de espaço livre for muito pequeno, o movimento dos dados será mais lento ou até impossível. Especialmente se você ignorou o item 2.
- Ao expandir o pool com o FAST VP ativado, não comece pelos discos mais lentos. Ou seja, adicione todos os grupos RAID planejados de uma vez ou comece pelos discos mais rápidos. Nesse caso, a redistribuição dos dados para os novos discos "rápidos" aumentará a velocidade geral do pool. Caso contrário, ao começar com discos "lentos", você pode acabar em uma situação muito desagradável. Primeiro, os dados serão transferidos para novos discos, relativamente lentos, e depois, ao adicionar discos mais rápidos, será feita uma nova transferência no sentido inverso. Existem nuances relacionadas às diferentes políticas do FAST VP, mas, em geral, essa situação é possível.
Se você está considerando este produto, pode experimentar o Unity em funcionamento gratuitamente, baixando o Unity VSA virtual appliance.
Para finalizar o material, compartilho algumas links úteis:
- Página
- – descrição resumida da função
- , formato pdf
Conclusão
Quero escrever sobre muitas coisas, mas entendo que nem todos os detalhes serão interessantes para o leitor. Por exemplo, poderia falar mais sobre os critérios que o FAST VP utiliza para decidir a transferência de dados, sobre os processos de análise de estatísticas de entrada e saída. Além disso, o tema da interação com , e isso poderia render um artigo separado. Podemos até especular sobre o futuro desta tecnologia. Espero que não tenha sido maçante e que não o tenha cansado. Até a próxima!
Fonte: habr.com
