

Hoje em dia, é impossível imaginar um projeto baseado em Kubernetes sem a pilha ELK, que armazena os logs de aplicações e componentes do sistema do cluster. Em nossa prática, usamos a pilha EFK com o Fluentd em vez do Logstash.
Fluentd é um coletor de logs moderno e universal, que está ganhando cada vez mais popularidade e se juntou à Cloud Native Computing Foundation, o que direciona seu desenvolvimento para uso em conjunto com o Kubernetes.
O fato de usar o Fluentd em vez do Logstash não altera a essência geral do sistema; no entanto, o Fluentd tem suas peculiaridades específicas, decorrentes de sua multifuncionalidade.
Por exemplo, ao começar a usar o EFK em um projeto carregado com alta intensidade de gravação de logs, enfrentamos a situação em que algumas mensagens no Kibana eram exibidas várias vezes. Neste artigo, explicaremos por que isso acontece e como resolver o problema.
Problema de duplicação de documentos
Em nossos projetos, o Fluentd é implementado como DaemonSet (iniciado automaticamente em uma instância em cada nó do cluster Kubernetes) e monitora os logs stdout dos contêineres em /var/log/containers. Após a coleta e processamento, os logs no formato de documentos JSON são enviados para o ElasticSearch, que pode ser implantado de forma clusterizada ou standalone, dependendo da escala do projeto e dos requisitos de desempenho e resiliência. O Kibana é usado como interface gráfica.
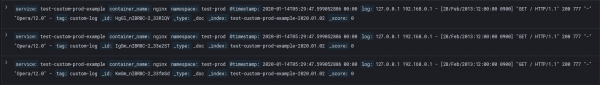
Ao usar o Fluentd com o plugin de buffer na saída, nos deparamos com a situação em que alguns documentos no ElasticSearch têm conteúdo idêntico e diferem apenas pelo identificador. Podemos verificar que se trata de uma repetição de mensagem usando como exemplo um log do Nginx. No arquivo de log, essa mensagem existe em uma única instância:
127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00 +0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -No entanto, no ElasticSearch existem vários documentos contendo essa mensagem:
{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "HgGl_nIBR8C-2_33RlQV",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00  0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -",
    "tag": "custom-log"
  }
}

{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "IgGm_nIBR8C-2_33e2ST",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00  0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -",
    "tag": "custom-log"
  }
}
Além disso, pode haver mais de duas repetições.
Durante a fixação deste problema nos logs do Fluentd, é possível observar um grande número de avisos com o seguinte conteúdo:
2020-01-16 01:46:46 +0000 [warn]: [test-prod] falha ao limpar o buffer. retry_time=4 next_retry_seconds=2020-01-16 01:46:53 +0000 chunk="59c37fc3fb320608692c352802b973ce" error_class=Fluent::Plugin::ElasticsearchOutput::RecoverableRequestFailure error="não foi possível enviar logs para o cluster Elasticsearch ({:host=>"elasticsearch", :port=>9200, :scheme=>"http", :user=>"elastic", :password=>"obfuscated"}): tempo limite de leitura atingido"Esses avisos ocorrem quando o ElasticSearch não consegue retornar uma resposta para a solicitação dentro do tempo especificado pelo parâmetro request_timeout, o que impede que o fragmento do buffer seja limpo. Após isso, o Fluentd tenta enviar o fragmento do buffer para o ElasticSearch novamente e, após várias tentativas, a operação é bem-sucedida:
2020-01-16 01:47:05 +0000 [warn]: [test-prod] tentativa bem-sucedida. chunk_id="59c37fc3fb320608692c352802b973ce"
2020-01-16 01:47:05 +0000 [warn]: [test-prod] tentativa bem-sucedida. chunk_id="59c37fad241ab300518b936e27200747"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] tentativa bem-sucedida. chunk_id="59c37fc11f7ab707ca5de72a88321cc2"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] tentativa bem-sucedida. chunk_id="59c37fb5adb70c06e649d8c108318c9b"
2020-01-16 01:47:15 +0000 [warn]: [kube-system] tentativa bem-sucedida. chunk_id="59c37f63a9046e6dff7e9987729be66f"
No entanto, o ElasticSearch interpreta cada um dos fragmentos do buffer retransmitidos como únicos e atribui a eles valores únicos nos campos _id ao serem indexados. Assim, surgem cópias das mensagens.
No Kibana, isso aparece assim:
Solução do problema
Existem várias opções para resolver este problema. Uma delas é o mecanismo embutido no plugin fluent-plugin-elasticsearch que gera um hash único para cada documento. Se esse mecanismo for utilizado, o ElasticSearch reconhecerá repetições durante a transmissão e evitará a duplicação de documentos. No entanto, não podemos ignorar que essa abordagem combate a consequência e não resolve a falha na falta de timeout, por isso decidimos não utilizá-la.
Utilizamos um plugin de buffer na saída do Fluentd para evitar a perda de logs em caso de falhas breves na rede ou aumento na intensidade do registro de logs. Se, por algum motivo, o ElasticSearch não consegue gravar instantaneamente um documento no índice, o documento vai para uma fila que é armazenada no disco. Portanto, no nosso caso, para eliminar a fonte do problema que leva ao erro acima mencionado, é necessário definir valores corretos para os parâmetros de buffering, onde o buffer de saída do Fluentd seja de tamanho suficiente e consiga ser limpo no tempo determinado.
Vale ressaltar que os valores dos parâmetros a serem discutidos a seguir são individuais em cada caso específico de uso de buffering em plugins de saída, pois dependem de vários fatores: intensidade de registro de mensagens de log pelos serviços, desempenho do sistema de disco, carga da rede e sua largura de banda. Portanto, para obter configurações adequadas a cada caso específico, mas sem exageros, evitando uma longa tentativa cega, pode-se usar as informações de depuração que o Fluentd registra em seu log durante a operação e rapidamente alcançar os valores corretos.
No momento da fixação do problema, a configuração era a seguinte:
 @type file
        path /var/log/fluentd-buffers/kubernetes.test.buffer
        flush_mode interval
        retry_type exponential_backoff
        flush_thread_count 2
        flush_interval 5s
        retry_forever
        retry_max_interval 30
        chunk_limit_size 8M
        queue_limit_length 8
        overflow_action block
Durante a resolução do problema, os valores dos seguintes parâmetros foram ajustados manualmente:
chunk_limit_size — o tamanho dos chunks nos quais as mensagens são divididas no buffer.
- flush_interval — intervalo de tempo após o qual o buffer é limpo.
- queue_limit_length — número máximo de chunks na fila.
- request_timeout — tempo para o qual a conexão entre Fluentd e ElasticSearch é estabelecida.
O tamanho total do buffer pode ser calculado multiplicando os parâmetros queue_limit_length e chunk_limit_size, o que pode ser interpretado como "número máximo de chunks na fila, cada um com um tamanho definido". Se o buffer estiver pequeno, o seguinte aviso aparecerá nos logs:
2020-01-21 10:22:57 +0000 [warn]: [test-prod] falha ao escrever dados no buffer devido à ação de estouro de buffer action=:blockIsso significa que o buffer não consegue ser limpo a tempo e os dados que chegam ao buffer cheio são bloqueados, resultando na perda de parte dos logs.
O buffer pode ser aumentado de duas maneiras: aumentando o tamanho de cada chunk na fila ou o número de chunks que podem estar na fila.
Se o tamanho do chunk chunk_limit_size for definido para mais de 32 megabytes, o ElasticSearch não o aceitará, pois o pacote de entrada será muito grande. Portanto, se for necessário aumentar o buffer ainda mais, é melhor aumentar o comprimento máximo da fila queue_limit_length.
Quando o buffer parar de transbordar e restar apenas a mensagem sobre a falta de tempo limite, você pode começar a aumentar o parâmetro request_timeout. No entanto, ao definir um valor maior que 20 segundos, os seguintes avisos começarão a aparecer nos logs do Fluentd:
2020-01-21 09:55:33 +0000 [warn]: [test-dev] a limpeza do buffer levou mais tempo do que slow_flush_log_threshold: elapsed_time=20.85753920301795 slow_flush_log_threshold=20.0 plugin_id="postgresql-dev" Esta mensagem não afeta a operação do sistema e significa que o tempo de limpeza do buffer levou mais do que o definido pelo parâmetro slow_flush_log_threshold. Esta é uma informação de depuração e nós a usamos ao ajustar o valor do parâmetro request_timeout.
O algoritmo geral de ajuste é o seguinte:
- Defina o valor do request_timeout garantidamente maior do que o necessário (centenas de segundos). Durante a configuração, o principal critério para a correção desse parâmetro será a ausência de avisos sobre a falta de tempo limite.
- Aguarde as mensagens sobre a superação do limite slow_flush_log_threshold. No texto do aviso, no campo elapsed_time, o tempo real de limpeza do buffer será indicado.
- Defina o valor de request_timeout maior do que o valor máximo de elapsed_time obtido durante o período de monitoramento. Calculamos o valor de request_timeout como elapsed_time + 50%.
- Para remover avisos de longa limpeza de buffer do log, você pode aumentar o valor de slow_flush_log_threshold. Calculamos este valor como elapsed_time + 25%.
Os valores finais desses parâmetros, como mencionado anteriormente, são individuais para cada caso. Seguindo o algoritmo acima, garantimos a eliminação do erro que causa a repetição de mensagens.
A tabela abaixo mostra como o número de erros por dia que levam à duplicação de mensagens muda durante o ajuste dos valores dos parâmetros acima mencionados:
node-1
node-2
node-3
node-4
Antes/Depois
Antes/Depois
Antes/Depois
Antes/Depois
falha ao limpar o buffer
1749/2
694/2
47/0
1121/2
tentativa bem-sucedida
410/2
205/1
24/0
241/2
Vale ressaltar que as configurações obtidas podem perder sua relevância à medida que o projeto cresce e, consequentemente, o número de logs aumenta. Um sinal primário da falta do timeout configurado é o retorno de mensagens no log do Fluentd sobre limpeza longa de buffer, ou seja, a superação do limite slow_flush_log_threshold. A partir desse momento, ainda há uma pequena margem antes de ultrapassar o parâmetro request_timeout, então é necessário reagir prontamente a essas mensagens e repetir o processo de ajuste das configurações otimizadas, conforme descrito acima.
Conclusão
O ajuste fino do buffer de saída do Fluentd é uma das etapas principais na configuração da pilha EFK, determinando a estabilidade de seu funcionamento e a correção do armazenamento de documentos nos índices. Seguindo o algoritmo de configuração descrito, é possível garantir que todos os logs serão gravados no índice ElasticSearch na ordem correta, sem repetições e perdas.
Leia também outros artigos em nosso blog:
Fonte: habr.com
