

Time oferece do engenheiro Rahul Bhati da empresa Clairvoyant sobre os formatos de arquivos em Big Data, quais são as funções mais comuns dos formatos Hadoop e qual formato é o melhor para usar.
Por que existem diferentes formatos de arquivo
Um gargalo sério no desempenho de aplicativos que suportam HDFS, como MapReduce e Spark — é o tempo de busca, leitura e gravação de dados. Esses problemas são agravados pelas dificuldades em gerenciar grandes conjuntos de dados quando temos um esquema não fixo, mas em evolução, ou quando existem algumas limitações de armazenamento.
O processamento de Big Data aumenta a carga no subsistema de armazenamento — o Hadoop armazena dados de forma redundante para garantir a resiliência. Além dos discos, a CPU, a rede, o sistema de entrada e saída, e assim por diante, também são pressionados. À medida que o volume de dados cresce, também aumenta o custo de seu processamento e armazenamento.
Diferentes formatos de arquivos em foram criados para resolver exatamente esses problemas. A escolha do formato de arquivo adequado pode trazer algumas vantagens significativas:
- Tempo de leitura mais rápido.
- Tempo de gravação mais rápido.
- Arquivos compartilháveis.
- Suporte à evolução de esquemas.
- Suporte avançado para compressão.
Alguns formatos de arquivo são projetados para uso geral, outros para opções mais específicas, e alguns são desenvolvidos com características específicas dos dados em mente. Portanto, a escolha realmente é bastante ampla.
Formato de arquivo Avro
Para de serialização de dados é amplamente utilizado — Avro é um formato de armazenamento de dados baseado em linhas, ou seja, no formato de linhas, no Hadoop. Ele armazena o esquema em formato JSON, facilitando a leitura e interpretação por qualquer programa. Os próprios dados estão em formato binário, compacto e eficiente.
O sistema de serialização Avro é neutro em relação à linguagem. Os arquivos podem ser processados por diferentes linguagens, atualmente C, C++, C#, Java, Python e Ruby.
Uma característica fundamental do Avro é o suporte robusto para esquemas de dados que mudam com o tempo, ou seja, evoluem. O Avro reconhece alterações no esquema — remoção, adição ou modificação de campos.
O Avro suporta uma variedade de estruturas de dados. Por exemplo, é possível criar um registro que contenha um array, um tipo enumerado e uma sub-record.
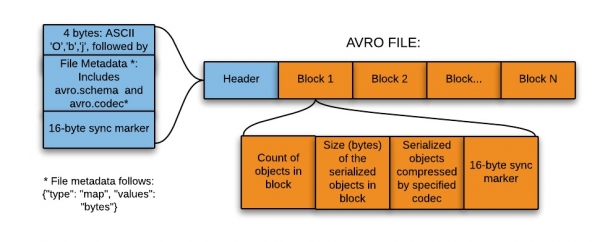
Este formato é ideal para gravação na zona de landing (transição) do lago de dados (, ou data lake — uma coleção de instâncias para armazenar diferentes tipos de dados além das fontes de dados diretas).
Assim, para gravação na zona de landing do lago de dados, esse formato é o mais adequado pelas seguintes razões:
- Os dados dessa zona são geralmente lidos na íntegra para posterior processamento por sistemas inferiores — e o formato baseado em linhas é mais eficiente nesse caso.
- Os sistemas inferiores podem facilmente extrair tabelas de esquema dos arquivos — não é necessário armazenar os esquemas separadamente em um armazenamento meta externo.
- Qualquer alteração na esquematização original é facilmente tratada (evolução do esquema).
O formato de arquivos Parquet
Parquet é um formato de arquivo open-source para Hadoop, que armazena estruturas de dados aninhadas em um formato de coluna plana.
Em comparação com a abordagem tradicional baseada em linhas, o Parquet é mais eficiente em termos de armazenamento e desempenho.
Isso é especialmente útil para consultas que leem colunas específicas de uma tabela ampla (com muitas colunas). Graças ao formato dos arquivos, apenas as colunas necessárias são lidas, minimizando a entrada e saída.
Uma pequena explicação introdutória: para entender melhor o formato de arquivo Parquet no Hadoop, vamos ver o que é um formato baseado em colunas — ou seja, um formato columnar. Nesse tipo de formato, os valores de cada coluna do mesmo tipo são armazenados juntos.
, a gravação inclui os campos ID, Nome e Departamento. Neste caso, todos os valores da coluna ID serão armazenados juntos, assim como os valores da coluna Nome e assim por diante. A tabela ficará aproximadamente assim:
ID
Nome
Departamento
1
emp1
d1
2
emp2
d2
3
emp3
d3
No formato de linha, os dados serão armazenados da seguinte forma:
1
emp1
d1
2
emp2
d2
3
emp3
d3
No formato columnar, os mesmos dados serão armazenados assim:
1
2
3
emp1
emp2
emp3
d1
d2
d3
O formato columnar é mais eficiente quando você precisa consultar várias colunas de uma tabela. Ele lerá apenas as colunas necessárias, pois estão próximas umas das outras. Assim, as operações de entrada e saída são minimizadas.
Por exemplo, você só precisa da coluna NOME. No Cada registro em um conjunto de dados precisa ser carregado, analisado em campos e, em seguida, os dados NAME devem ser extraídos. O formato em colunas permite acessar diretamente a coluna Name, pois todos os valores para essa coluna estão armazenados juntos. Não é necessário escanear todo o registro.
Assim, o formato em colunas melhora o desempenho das consultas, pois leva menos tempo para acessar as colunas desejadas, reduzindo o número de operações de entrada e saída, uma vez que apenas as colunas necessárias são lidas.
Uma das características únicas é que nesse formato ele pode armazenar dados com estruturas aninhadas. Isso significa que em um arquivo Parquet até campos aninhados podem ser lidos separadamente, sem a necessidade de ler todos os campos na estrutura aninhada. Para armazenar estruturas aninhadas, o Parquet utiliza o algoritmo de fragmentação e montagem (shredding and assembly).
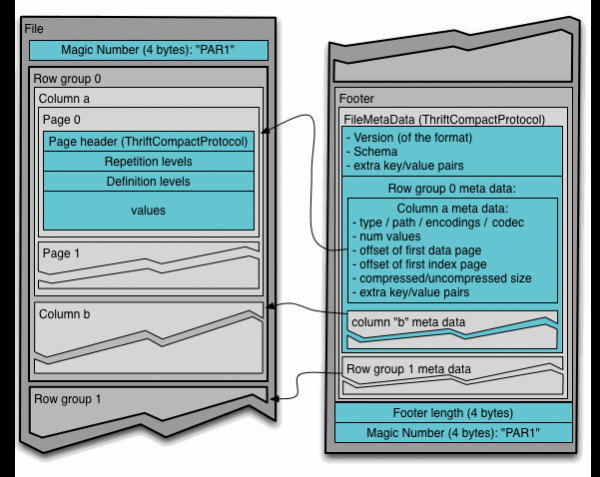
Para entender o formato de arquivo Parquet no Hadoop, é necessário conhecer os seguintes termos:
- Grupo de linhas (row group): uma divisão lógica horizontal dos dados em linhas. Um grupo de linhas consiste em um fragmento de cada coluna no conjunto de dados.
- Fragmento de coluna (column chunk): um fragmento de uma coluna específica. Esses fragmentos de colunas vivem em um determinado grupo de linhas e serão adjacentes no arquivo.
- Página (page): fragmentos de colunas são divididos em páginas, gravadas uma após a outra. As páginas têm um cabeçalho comum, então ao ler, páginas desnecessárias podem ser puladas.
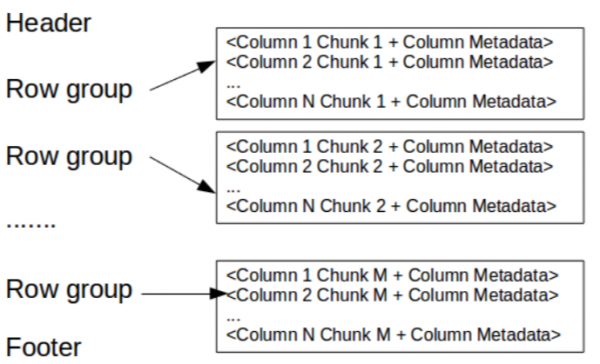
Aqui, o cabeçalho simplesmente contém um número mágico PAR1 (4 bytes), que identifica o arquivo como um arquivo no formato Parquet.
No rodapé está escrito o seguinte:
- Metadados do arquivo, que contêm as coordenadas iniciais dos metadados de cada coluna. Ao ler, primeiro é necessário ler os metadados do arquivo para encontrar todos os fragmentos de colunas de interesse. Em seguida, os fragmentos de colunas devem ser lidos sequencialmente. Além disso, os metadados incluem a versão do formato, o esquema e quaisquer pares adicionais de chave-valor.
- Comprimento dos metadados (4 bytes).
- Número mágico PAR1 (4 bytes).
Formato de arquivos ORC
Formato de arquivos otimizados em linha e coluna (Optimized Row Columnar, ) oferece um modo muito eficiente de armazenamento de dados e foi desenvolvido para superar as limitações de outros formatos. Armazena dados de forma perfeitamente compacta, permitindo pular detalhes desnecessários — enquanto não requer a construção de índices grandes, complexos ou de manutenção manual.
Vantagens do formato ORC:
- Um arquivo de saída para cada tarefa, reduzindo a carga no NameNode (nó de nomes).
- Suporte a tipos de dados do Hive, incluindo DateTime, tipos decimais e tipos complexos (struct, list, map e union).
- Leitura simultânea do mesmo arquivo por diferentes processos RecordReader.
- Possibilidade de dividir arquivos sem escanear em busca de marcadores.
- Avaliação do máximo possível de alocação de memória heap para processos de leitura/gravação com base nas informações no rodapé do arquivo.
- Metadados são armazenados em um formato binário de serialização Protocol Buffers, que permite adicionar e remover campos.
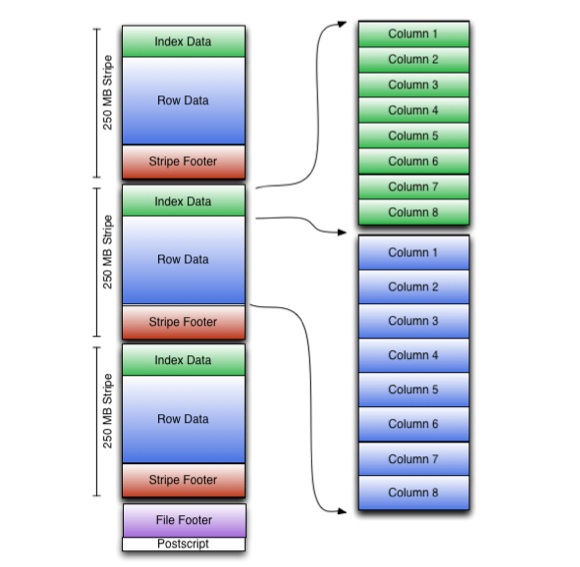
ORC armazena coleções de strings em um único arquivo, enquanto os dados de string dentro da coleção são armazenados em formato colunar.
O arquivo ORC armazena grupos de strings, chamados de stripes, e informações auxiliares no rodapé do arquivo. O postscript no final do arquivo contém parâmetros de compressão e o tamanho do rodapé comprimido.
Por padrão, o tamanho da stripe é de 250 MB. Graças a stripes desse tamanho, a leitura do HDFS é realizada de forma mais eficiente: em blocos grandes e contínuos.
No rodapé do arquivo, é gravada uma lista de stripes no arquivo, o número de linhas por stripe e o tipo de dados de cada coluna. Também estão gravados os valores resultantes de count, min, max e sum para cada coluna.
O rodapé da stripe contém um diretório de localizações de fluxo.
Os dados de string são usados durante a varredura de tabelas.
Os dados de índice incluem valores mínimos e máximos para cada coluna e as posições das linhas em cada coluna. Os índices ORC são utilizados apenas para selecionar stripes e grupos de strings, não para responder a consultas.
Comparação entre diferentes formatos de arquivos
Avro versus Parquet
- Avro é um formato de armazenamento por linhas, enquanto o Parquet armazena dados por colunas.
- Parquet é mais adequado para consultas analíticas, isto é, operações de leitura e consulta de dados são muito mais eficientes do que gravação.
- Operações de gravação em Avro são realizadas de forma mais eficiente do que em Parquet.
- Avro trabalha de forma mais madura com a evolução de esquemas. O Parquet suporta apenas a adição de esquemas, enquanto o Avro implementa uma evolução multifuncional, ou seja, a adição ou modificação de colunas.
- Parquet é ideal para consultar subconjuntos de colunas em uma tabela de múltiplas colunas. Avro é adequado para operações ETL, onde consultamos todas as colunas.
ORC em comparação com Parquet
- Parquet armazena melhor dados aninhados.
- ORC é mais adequado para empurrão de prediados (predicate pushdown).
- ORC suporta propriedades ACID.
- ORC comprime melhor os dados.
O que mais ler sobre o assunto:
- .
- .
- .
Fonte: habr.com
