

Olá, leitores do Habr. Com este artigo, iniciamos um ciclo que contará sobre o sistema hiperconvergente que desenvolvemos, o AERODISK vAIR. Inicialmente, queríamos que o primeiro artigo cobrisse tudo, mas o sistema é bastante complexo, então vamos devagar, peça por peça.
Vamos começar contando a história da criação do sistema, nos aprofundar no sistema de arquivos ARDFS, que é a base do vAIR, e também discutir um pouco sobre o posicionamento dessa solução no mercado russo.
Nos próximos artigos, falaremos mais detalhadamente sobre diferentes componentes arquitetônicos (cluster, hipervisor, balanceador de carga, sistema de monitoramento, etc.), o processo de configuração, abordaremos questões de licenciamento, destacaremos testes de estresse e, claro, escreveremos sobre testes de carga e dimensionamento. Também dedicaremos um artigo à versão community do vAIR.
A Aerodisk é como uma história sobre armazenamento em rede? Ou por que começamos a nos envolver com hiperconvergência?
A ideia de criar nosso próprio sistema hiperconvergente surgiu por volta de 2010. Naquela época, ainda não existia nem o Aerodisk, nem soluções semelhantes (sistemas hiperconvergentes comerciais) no mercado. Nossa tarefa era a seguinte: a partir de um conjunto de servidores com discos locais, interconectados por meio de Ethernet, era necessário criar um armazenamento distribuído e também executar máquinas virtuais e redes de software. Tudo isso precisava ser feito sem um sistema de armazenamento em rede, já que não havia dinheiro para um e na época ainda não havíamos desenvolvido o nosso próprio.
Testamos muitas soluções open source e, de fato, resolvemos essa questão, mas a solução era muito complexa e difícil de replicar. Além disso, era do tipo "Funciona? Então não mexa!". Portanto, após resolver a questão, decidimos não continuar desenvolvendo a ideia de transformar o resultado do nosso trabalho em um produto completo.
Depois disso, nos afastamos da ideia, mas a sensação de que essa tarefa era totalmente viável e que os benefícios de tal solução eram mais que óbvios não nos deixaram. Os produtos HCI lançados por empresas estrangeiras posteriormente apenas confirmaram essa sensação.
Portanto, em meados de 2016, retornamos a essa tarefa já no contexto da criação de um produto completo. Naquela época, ainda não tínhamos qualquer relacionamento com investidores, por isso tivemos que comprar o stand de desenvolvimento com nosso dinheiro, que não era muito. Ao procurar no Avito servidores e switches usados, começamos a trabalhar.
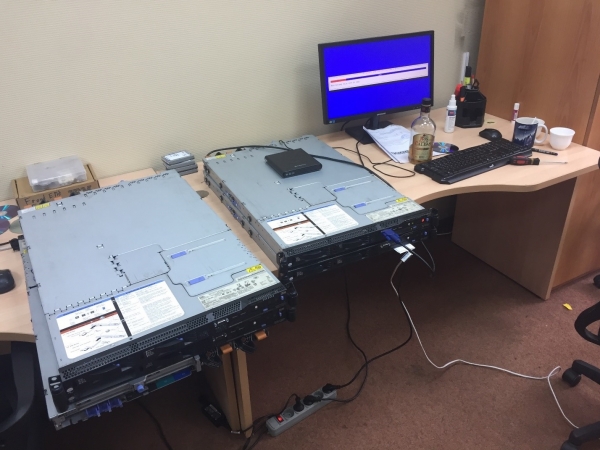
A principal tarefa inicial era criar nosso próprio sistema de arquivos, que, mesmo que simples, fosse capaz de distribuir automaticamente e de maneira uniforme os dados em forma de blocos virtuais em um número n de nós de um cluster interconectados via Ethernet. Além disso, o sistema de arquivos deveria escalar bem e facilmente, sendo independente de sistemas adjacentes, ou seja, deveria ser desvinculado do vAIR na forma de um "simples armazenamento".
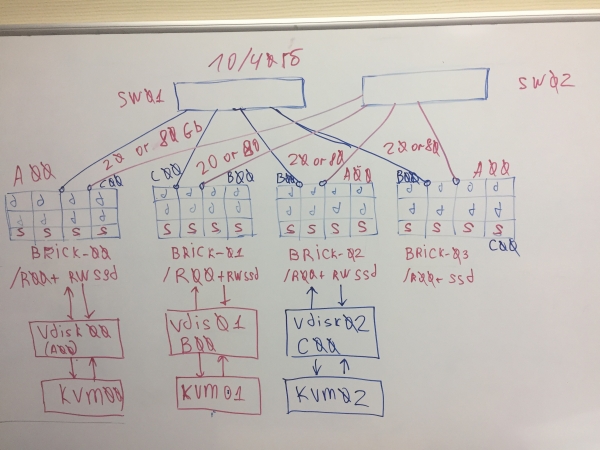
O primeiro conceito do vAIR
Decidimos deliberadamente não usar soluções open source prontas para organizar um armazenamento distribuído (ceph, gluster, lustre e similares) em favor do nosso próprio desenvolvimento, pois já tínhamos muita experiência de projeto com eles. Sem dúvida, essas soluções são excelentes por si mesmas, e até trabalhamos em vários projetos de integração com elas antes de desenvolver o Aerodisk. Mas uma coisa é realizar uma tarefa específica para um cliente, treinar a equipe e, possivelmente, comprar suporte de um grande fornecedor, e outra bem diferente é criar um produto facilmente replicável que será utilizado para diferentes tarefas que, como fornecedor, talvez nem saibamos. Para esse segundo objetivo, os produtos open source existentes não serviam, então decidimos desenvolver um sistema de arquivos distribuído nós mesmos.
Após dois anos, com a ajuda de alguns desenvolvedores (que conciliavam o trabalho no vAIR com o trabalho em um sistema de armazenamento clássico Engine), conseguimos alcançar um resultado determinado.
Até 2018, escrevemos um sistema de arquivos simples e o complementamos com a infraestrutura necessária. O sistema unificava, através de uma interconexão interna, discos físicos (locais) de diferentes servidores em um único pool plano e 'cortava-os' em blocos virtuais; depois, desses blocos virtuais, eram criados dispositivos em bloco com diferentes níveis de tolerância a falhas, nos quais, com a ajuda do hipervisor KVM, eram criadas e executadas máquinas virtuais.
Não nos aprofundamos muito no nome do sistema de arquivos e o chamamos de ARDFS (adivinhe como isso é abreviado))
Esse protótipo parecia bom (não visualmente, claro, pois não havia formatação visual na época) e mostrava bons resultados em termos de desempenho e escalabilidade. Após o primeiro resultado real, decidimos prosseguir com o projeto, organizando um ambiente de desenvolvimento completo e uma equipe separada que se dedicava apenas ao vAIR.
Naquele momento, a arquitetura geral da solução estava madura, e desde então não sofreu mudanças significativas.
Explorando o sistema de arquivos ARDFS
ARDFS é a base do vAIR, que proporciona armazenamento de dados distribuído e tolerante a falhas para todo o cluster. Uma das (mas não a única) características distintas do ARDFS é que ele não utiliza nenhum servidores dedicados subterfúgio e gerenciamento. Isso foi planejado desde o início para simplificar a configuração da solução e garantir sua confiabilidade.
Estrutura de armazenamento
Dentro de todos os nós do cluster, o ARDFS organiza um pool lógico de todo o espaço em disco disponível. É importante entender que o pool não é ainda dados e nem espaço formatado, mas simplesmente uma demarcação, ou seja, quaisquer nós com vAIR instalados, ao serem adicionados ao cluster, são automaticamente incorporados ao pool ARDFS, e os recursos de disco tornam-se automaticamente compartilhados por todo o cluster (e disponíveis para futuros armazenamentos de dados). Essa abordagem permite adicionar e remover nós em tempo real sem qualquer impacto significativo no sistema já em funcionamento. Ou seja, o sistema é muito fácil de escalar 'tijolo a tijolo', adicionando ou removendo nós no cluster conforme necessário.
Sobre o pool ARDFS, discos virtuais (objetos de armazenamento para máquinas virtuais) são adicionados, construídos a partir de blocos virtuais de 4 megabytes. Os dados são armazenados diretamente nesses discos virtuais. No nível dos discos virtuais, também é definido um esquema de tolerância a falhas.
Como já se podia imaginar, para a tolerância a falhas do subsistema de disco, não utilizamos o conceito de RAID (Conjunto Redundante de Discos Independentes), mas sim RAIN (Conjunto Redundante de Nós Independentes). Ou seja, a tolerância a falhas é medida, automatizada e gerenciada com base nos nós, e não nos discos. Os discos, sem dúvida, também são objetos de armazenamento, eles são, como tudo mais, monitorados e permitem todas as operações padrão, incluindo a criação de um RAID de hardware local, mas o cluster opera especificamente com os nós.
Em uma situação em que se deseja muito o RAID (por exemplo, um cenário que suporte múltiplas falhas em pequenos clusters), nada impede o uso de controladores RAID locais, e sobre isso pode-se criar um armazenamento distribuído e uma arquitetura RAIN. Esse cenário é totalmente viável e suportado por nós, portanto, falaremos sobre ele no artigo sobre cenários típicos de aplicação do vAIR.
Esquemas de tolerância a falhas de armazenamento
Pode haver dois esquemas de tolerância a falhas para discos virtuais no vAIR:
1) Fator de replicação ou simplesmente replicação – esse método de tolerância a falhas é simples "como uma vara e uma corda". Realiza replicação síncrona entre nós com fator 2 (2 cópias por cluster) ou 3 (3 cópias, respectivamente). O RF-2 permite que o disco virtual suporte a falha de um nó no cluster, mas "consome" metade do espaço útil, enquanto o RF-3 suportará a falha de 2 nós no cluster, mas reservará 2/3 do espaço útil para suas necessidades. Esse esquema se assemelha bastante ao RAID-1, ou seja, um disco virtual configurado em RF-2 é resistente à falha de qualquer um dos nós do cluster. Nesse caso, os dados estarão seguros e até as operações de entrada e saída não serão interrompidas. Quando o nó falho voltar ao funcionamento, começará a recuperação automática/sincronização dos dados.
Abaixo estão exemplos de distribuição de dados RF-2 e RF-3 em condições normais e em situações de falhas.
Temos uma máquina virtual com 8 MB de dados únicos (úteis) que opera em 4 nós vAIR. É claro que, na realidade, um volume tão pequeno é improvável, mas este exemplo é o mais compreensível para ilustrar a lógica de operação do ARDFS. AB – são os blocos virtuais de 4 MB contendo dados únicos da máquina virtual. Com RF-2, são criadas duas cópias desses blocos A1+A2 e B1+B2, respectivamente. Esses blocos são distribuídos entre os nós, evitando a interseção dos mesmos dados em um único nó, ou seja, a cópia A1 não estará no mesmo nó que a cópia A2. O mesmo se aplica a B1 e B2.
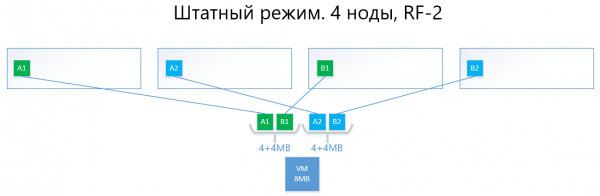
No caso de falha de um dos nós (por exemplo, o nó nº 3, onde está a cópia B1), essa cópia é automaticamente ativada em um nó onde não há a cópia de sua cópia (ou seja, a cópia B2).
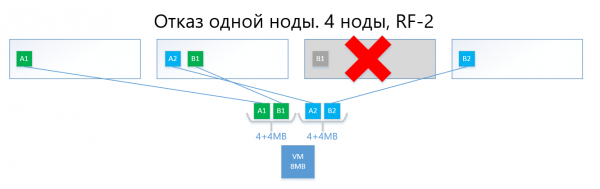
Assim, o disco virtual (e, consequentemente, a VM) suportará facilmente a falha de um nó no esquema RF-2.
O esquema de replicação, apesar de sua simplicidade e confiabilidade, sofre do mesmo problema que o RAID1 – pouco espaço útil.
2) O código de eliminação ou codificação de eliminação (também conhecido como "codificação redundante", "codificação de eliminação" ou "código de redundância") existe precisamente para resolver o problema acima. EC – é um esquema de redundância que garante alta disponibilidade de dados com menores custos de espaço em disco em comparação com a replicação. O princípio de funcionamento desse mecanismo é semelhante ao RAID 5, 6, 6P.
Na codificação, o processo EC divide o bloco virtual (por padrão 4 MB) em vários "pedacinhos de dados" de acordo com o esquema EC (por exemplo, o esquema 2+1 divide cada bloco de 4 MB em 2 pedaços de 2 MB). Em seguida, esse processo gera para os "pedacinhos de dados" "pedaços de paridade" com tamanho não superior a uma das partes anteriormente divididas. Na decodificação, o EC gera os pedaços faltantes, lendo os dados "sobreviventes" por todo o cluster.
Por exemplo, um disco virtual com o esquema EC 2 + 1, implementado em 4 nós do cluster, suportará tranquilamente a falha de um nó no cluster, assim como o RF-2. Neste caso, os custos indiretos serão menores; especificamente, a taxa de utilização útil em RF-2 é igual a 2, enquanto em EC 2+1 será de 1,5.
Em termos mais simples, a essência é que o bloco virtual é dividido em 2-8 (por que de 2 a 8, veja abaixo) "pedaços", e para esses pedaços são calculados "pedaços" de paridade de volume semelhante.
No final, os dados e a paridade são distribuídos uniformemente por todos os nós do cluster. Assim como na replicação, o ARDFS distribui automaticamente os dados pelos nós de forma a evitar o armazenamento de dados idênticos (cópias dos dados e sua paridade) em um único nó, para eliminar a chance de perder dados caso os dados e sua paridade estejam repentinamente no mesmo nó de armazenamento que falhe.
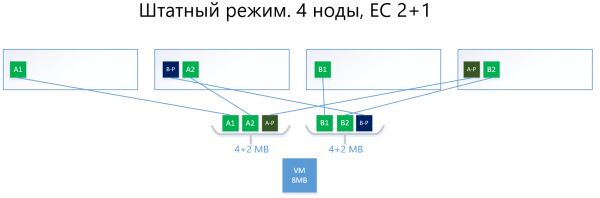
Abaixo um exemplo, com a mesma máquina virtual de 8 MB e 4 nós, mas com o esquema EC 2+1.
Os blocos A e B são divididos em duas partes de 2 MB cada (dividido em duas partes porque 2+1), ou seja, A1+A2 e B1+B2. Diferente de uma réplica, A1 não é uma cópia de A2, este é um bloco virtual A, dividido em duas partes, assim como o bloco B. No total, obtemos dois conjuntos de 4 MB, em cada um dos quais existem duas partes de dois megabytes. Em seguida, para cada um desses conjuntos calcula-se a paridade com um volume não superior a uma parte (ou seja, 2 MB), obtendo-se mais 2 partes de paridade (A-P e B-P). Portanto, temos 4×2 dados + 2×2 paridade.
Os pedaços são então "distribuídos" pelos nós de modo que os dados não se confundam com sua paridade. Ou seja, A1 e A2 não estarão no mesmo nó que A-P.
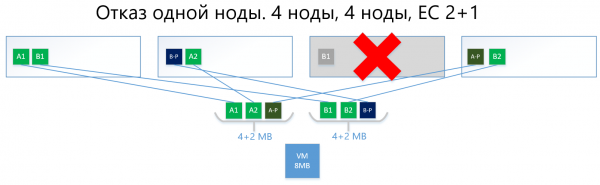
No caso de falha de um nó (digamos, o terceiro), o bloco B1 que falhou será automaticamente recuperado da paridade B-P, que está armazenada no nó nº 2, e será ativado em um nó onde não há paridade B, ou seja, do pedaço B-P. Neste exemplo, isso é o nó nº 1.
Estou certo de que o leitor deve estar se perguntando:
"Tudo o que você descreveu já foi implementado tanto por concorrentes quanto em soluções de código aberto, qual é a diferença da sua implementação de EC no ARDFS?"
E a seguir virão as características interessantes do funcionamento do ARDFS.
Codificação por eliminação com foco na flexibilidade
Inicialmente, planejamos um esquema EC X+Y bastante flexível, onde X varia de 2 a 8 e Y de 1 a 8, mas sempre menor ou igual a X. Este esquema é previsto para garantir flexibilidade. O aumento do número de pedaços de dados (X), sobre os quais um bloco virtual é dividido, permite reduzir as sobrecargas, ou seja, aumentar o espaço útil.
O aumento do número de pedaços de paridade (Y) aumenta a confiabilidade do disco virtual. Quanto maior o valor de Y, mais nós no cluster podem falhar. É claro que, ao aumentar o volume de paridade, reduz-se a capacidade útil, mas esse é o preço a se pagar pela confiabilidade.
A dependência de desempenho das esquemas EC é quase direta: quanto mais "partes", menor o desempenho; aqui, claramente, é necessária uma visão equilibrada.
Essa abordagem permite que os administradores configurem o armazenamento distribuído de forma bastante flexível. Dentro do pool ARDFS, é possível utilizar qualquer combinação de esquemas de alta disponibilidade, o que também consideramos muito útil.
Abaixo está uma tabela de comparação de vários (não todos) esquemas RF e EC.
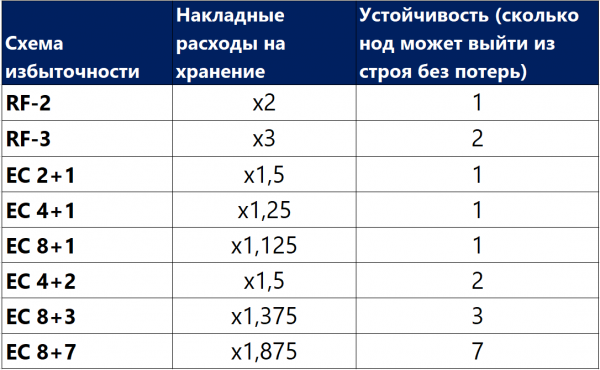
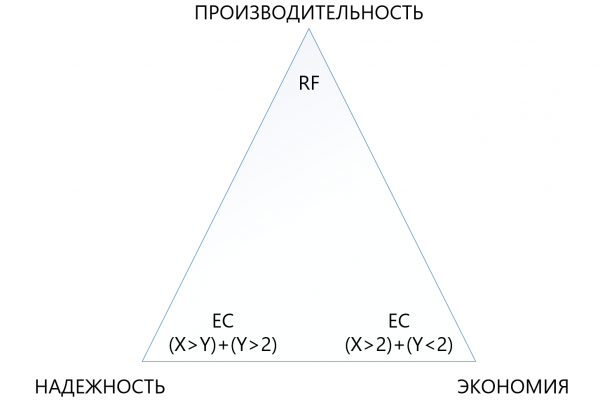
Da tabela, pode-se ver que mesmo a combinação EC 8+7, que permite a perda de até 7 nós no cluster, consome menos espaço útil (1,875 contra 2) do que a replicação padrão, enquanto protege 7 vezes melhor, tornando esse mecanismo de proteção, embora mais complexo, significativamente mais atraente em situações onde é necessário garantir a máxima confiabilidade em condições de escassez de espaço em disco. É preciso entender que cada "mais" em X ou Y implicará em uma sobrecarga adicional no desempenho, portanto, é crucial escolher cuidadosamente entre a confiabilidade, a economia e o desempenho. Por essa razão, dedicaremos um artigo ao dimensionamento da codificação de eliminação.
Confiabilidade e autonomia do sistema de arquivos
O ARDFS é executado localmente em todos os nós do cluster e sincroniza seus próprios meios através de interfaces Ethernet dedicadas. Um ponto importante é que o ARDFS sincroniza não apenas dados, mas também metadados relacionados ao armazenamento. Durante o desenvolvimento do ARDFS, estudamos paralelamente várias soluções existentes e descobrimos que muitas realizam a sincronização dos metadados do sistema de arquivos usando um SGBD distribuído externo, que também usamos para sincronização, mas apenas para configurações, e não para os metadados do sistema de arquivos (sobre isso e outras subsistemas relacionadas falaremos no próximo artigo).
A sincronização dos metadados do sistema de arquivos com um SGBD externo é, sem dúvida, uma solução funcional, mas, neste caso, a consistência dos dados armazenados no ARDFS dependeria do SGBD externo e do seu comportamento (o que, convenhamos, pode ser bastante caprichoso), o que, em nossa opinião, é problemático. Por quê? Se os metadados do sistema de arquivos forem corrompidos, os próprios dados do sistema de arquivos também poderão dizer "adeus", portanto, decidimos seguir um caminho mais complexo, mas confiável.
Desenvolvemos o subsistema de sincronização de metadados para o ARDFS de forma independente, e ele opera de maneira absolutamente autônoma em relação aos subsistemas adjacentes. Ou seja, nenhum outro subsistema pode corromper os dados do ARDFS. Em nossa visão, esse é o caminho mais seguro e correto, mas se é assim na prática, o tempo dirá. Além disso, essa abordagem oferece uma vantagem extra. O ARDFS pode ser utilizado independentemente do vAIR, simplesmente como um armazenamento expandido, o que certamente utilizaremos em futuros produtos.
Como resultado do desenvolvimento do ARDFS, criamos um sistema de arquivos flexível e confiável, que permite escolher onde economizar em capacidade ou priorizar o desempenho, ou ainda tornar o armazenamento superconfiável a um custo razoável, mas reduzindo as exigências de desempenho.
Juntamente com uma política de licenciamento simples e um modelo de fornecimento flexível (adiantando, o licenciamento do vAIR é por nó, e a entrega pode ser feita tanto por software quanto como um pacote), isso permite ajustar muito precisamente a solução às mais diversas exigências dos clientes e, no futuro, manter facilmente esse equilíbrio.
Quem precisa dessa maravilha?
Por um lado, pode-se dizer que já existem players no mercado com soluções robustas na área de hiperconvergência, e questionar nossa entrada nesse campo. Parece que essa afirmação é verdadeira, MAS...
Por outro lado, ao sair "a campo" e conversar com os clientes, nós e nossos parceiros percebemos que não é bem assim. Há muitas demandas para hiperconvergência, e, em alguns casos, as pessoas simplesmente não sabiam que essas soluções existiam, em outros, parecia caro, houveram testes malsucedidos de soluções alternativas, e em outros lugares, a compra é proibida, devido a sanções. De modo geral, o campo se revelou inexplorado, portanto, decidimos desbravá-lo))).
Quando um armazenamento de dados é melhor que uma solução de armazenamento em nuvem?
Durante nosso trabalho com o mercado, muitas vezes somos questionados sobre quando é melhor aplicar o esquema clássico com armazenamento definido por software (SDS) e quando utilizar a solução hiperconvergente. Muitas empresas fabricantes de SDS (especialmente aquelas que não têm SDS em seu portfólio) afirmam: 'O SDS está obsoleto, apenas soluções hiperconvergentes!'. Essa é uma afirmação ousada, mas não reflete completamente a realidade.
Na verdade, o mercado de SDS realmente está se movendo em direção a soluções hiperconvergentes, mas sempre há um 'mas'.
Primeiramente, os data centers e as infraestruturas de TI construídos segundo o esquema clássico com SDS não podem ser facilmente reformulados, portanto, a modernização e a expansão dessas infraestruturas ainda são um legado de 5 a 7 anos.
Em segundo lugar, as infraestruturas que estão sendo construídas atualmente em massa (referindo-se à Rússia) ainda são feitas segundo o esquema clássico utilizando SDS, não porque as pessoas não conheçam as soluções hiperconvergentes, mas porque o mercado de soluções hiperconvergentes é recente, os padrões e soluções ainda não se estabeleceram, os profissionais de TI ainda não estão treinados, e a experiência é pouca. Além disso, é necessário construir data centers aqui e agora. Essa tendência deverá persistir por mais 3 a 5 anos (e depois será mais um legado, veja ponto 1).
Em terceiro lugar, há uma limitação técnica pura nas pequenas latências adicionais de 2 milissegundos na gravação (sem considerar o cache local, claro), que são o preço a pagar pelo armazenamento distribuído.
E não vamos esquecer do uso de grandes servidores físicos, que favorecem a escalabilidade vertical dos subsistemas de armazenamento.
Existem muitas tarefas necessárias e populares nas quais o SDS se comporta melhor do que as soluções hiperconvergentes. Claro que os fabricantes que não têm SDS em seu portfólio não concordarão com isso, mas estamos prontos para argumentar de forma fundamentada. Como desenvolvedores de ambos os produtos, em uma de nossas futuras publicações, realizaremos uma comparação entre SDS e soluções hiperconvergentes, onde demonstraremos claramente em quais condições cada um é melhor.
E onde as soluções hiperconvergentes funcionarão melhor que o SDS?
Com base nos enunciados acima, podemos tirar três conclusões óbvias:
- Onde os adicionais 2 milissegundos de latência na gravação, que ocorrem de forma consistente em qualquer ambiente produtivo (agora não estamos falando de testes sintéticos, em que pode-se demonstrar nanosegundos), não são críticas, a solução hiperconvergente será adequada.
- Onde a carga dos grandes servidores físicos pode ser transformada em muitas pequenas máquinas virtuais e distribuída por nós, a hyperconvergência também se encaixa bem.
- Onde a escalabilidade horizontal é mais prioritária do que a vertical, a HCI também se adapta perfeitamente.
Quais são essas soluções?
- Todos os serviços de infraestrutura padrão (serviço de diretórios, e-mail, GED, servidores de arquivos, pequenos ou médios sistemas ERP e BI, etc.). Chamamos isso de 'computação comum'.
- Infraestrutura de provedores de nuvem, onde é necessário expandir horizontalmente de forma rápida e padronizada e facilmente 'fatiar' um grande número de máquinas virtuais para os clientes.
- Infraestrutura para áreas de trabalho virtuais (VDI), onde muitas pequenas máquinas virtuais de usuários são iniciadas e flutuam tranquilamente dentro de um cluster uniforme.
- Redes filiais, onde em cada filial é necessário obter uma infraestrutura padrão, resiliente e, ao mesmo tempo, econômica, composta por 15-20 máquinas virtuais.
- Qualquer computação distribuída (serviços de big data, por exemplo). Onde a carga não vai 'em profundidade', mas 'em largura'.
- Ambientes de teste, onde pequenas latências adicionais são aceitáveis, mas existem limitações orçamentárias, pois são testes.
Neste momento, especialmente para essas tarefas, desenvolvemos o AERODISK vAIR e é sobre isso que estamos focando (até agora com sucesso). Isso pode mudar em breve, pois o mundo não para.
Então…
Com isso, a primeira parte de um grande ciclo de artigos chega ao fim, no próximo artigo falaremos sobre a arquitetura da solução e os componentes utilizados.
Ficaremos felizes em receber perguntas, sugestões e discussões construtivas.
Fonte: habr.com
