

3. Estruturas alternativas ao usar globais
Uma estrutura como uma árvore ordenada tem diferentes casos particulares. Vamos considerar aqueles que têm valor prático ao trabalhar com globais.
3.1 Caso Particular 1. Um nó sem ramificações
 Os globais podem ser usados não apenas como um array, mas também como variáveis normais. Por exemplo, como contador:
Set ^counter = 0  ; inicializa o contador
Set id=$Increment(^counter) ;  incremento atômico
Neste caso, um global, além do valor, pode também ter ramificações. Uma coisa não exclui a outra.
3.2 Caso Particular 2. Um vértice e várias ramificações
Na verdade — isso é uma base clássica de key-value. E se como valor, armazenarmos uma tupla de valores, obteremos uma tabela comum com uma chave primária.
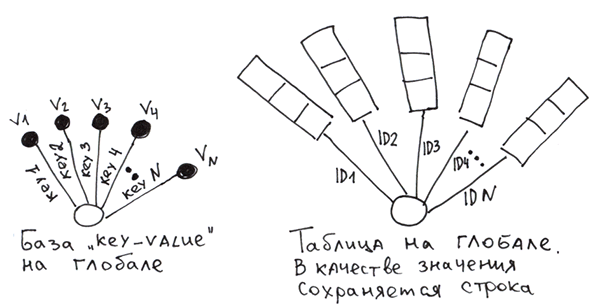
Para implementar uma tabela em globais, precisamos formar nós mesmos as linhas a partir dos valores das colunas e depois salvá-las no global pela chave primária. Para que ao ler seja possível dividir a linha novamente em colunas, podemos usar:
- símbolos delimitadores.
Set ^t(id1) = "col11/col21/col31" Set ^t(id2) = "col12/col22/col32" - um esquema rígido, onde cada campo ocupa um número previamente definido de bytes. Como o que é feito em bancos de dados relacionais.
- uma função especial $LB (disponível no Cache), que compõe uma string a partir dos valores.
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^t(id2) = $LB("col12", "col22", "col32")
Curiosamente, não é difícil nos globais criar algo semelhante aos índices secundários em bancos de dados relacionais. Chamaremos essas estruturas de globais de índice. Um global de índice é uma árvore auxiliar para busca rápida por campos que não fazem parte da chave primária do global principal. Para preenchê-la e usá-la, precisamos escrever código adicional.
Vamos criar um global de índice pela primeira coluna.
Set ^i("col11", id1) = 1
Set ^i("col12", id2) = 1
Agora, para uma busca rápida de informações pela primeira coluna, devemos consultar o global ^i e encontrar as chaves primárias (id) correspondentes ao valor desejado na primeira coluna.
Ao inserir um valor, podemos imediatamente criar tanto o valor quanto os globais de índice para os campos necessários. E, para maior segurança, envolveremos tudo isso em uma transação.
TSTART
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^i("col11", id1) = 1
TCOMMIT
Detalhes sobre como criar em M , .
As tabelas funcionarão tão rapidamente quanto em bancos de dados tradicionais (ou até mais rápido), se as funções de inserção/atualização/exclusão de linhas forem escritas em COS/M e compiladas.Verifiquei essa afirmação com testes de INSERT e SELECT em uma tabela de duas colunas, incluindo o uso dos comandos TSTART e TCOMMIT (transações).
Não testei cenários mais complexos com acesso concorrente e transações paralelas.
Sem o uso de transações, a velocidade de inserções foi de 778.361 inserções/segundo em um milhão de valores.
Com 300 milhões de valores – 422.141 inserções/segundo.
Ao usar transações – 572.082 inserções/segundo em 50M de inserções. Todas as operações foram realizadas a partir de código M compilado.
Os discos rígidos são comuns, não SSD. RAID5 com Write-back. Processador Phenom II 1100T.
Para testes similares em um banco de dados SQL, é necessário escrever um procedimento armazenado que faça inserções em um loop. Ao testar o MySQL 5.5 (armazenamento InnoDB), obtive números não superiores a 11K inserções por segundo com essa metodologia.
Sim, a implementação de tabelas em globais parece mais complexa do que em bancos de dados relacionais. Por isso, bancos de dados industriais em globais têm acesso SQL para simplificar o trabalho com dados tabulares.
 De fato, se o esquema de dados não mudar com frequência, a velocidade de inserção não é crítica e todo o banco pode ser facilmente representado como tabelas normalizadas, então é mais fácil trabalhar com SQL, pois ele oferece um nível de abstração mais alto.
 Neste caso específico, eu queria mostrar que os globais podem servir como uma plataforma para a criação de outros bancos de dados. Como um assembler, no qual é possível escrever outras linguagens. E aqui estão exemplos de como criar, em globais, análogos
Se precisar criar um banco de dados não padrão com o mínimo de esforço, vale a pena considerar os globais.
3.3 Caso específico 3. Árvore de dois níveis, onde cada nó de segundo nível tem um número fixo de ramos.
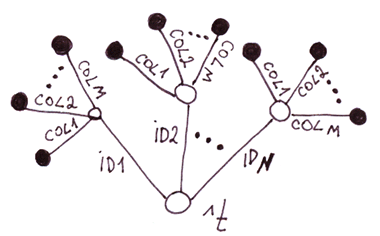 Você provavelmente adivinhou: esta é uma implementação alternativa de tabelas em globais. Vamos comparar essa implementação com a anterior.
Tabelas em árvore de dois níveis vs. em árvore de um nível.
Desvantagens
Prós
- Mais lenta na inserção, pois é necessário estabelecer o número de nós igual ao número de colunas.
- Maior consumo de espaço em disco. Os índices globais (no entendimento de índices de arrays) com os nomes das colunas ocupam espaço em disco e são duplicados para cada linha.
- Acesso mais rápido aos valores de colunas individuais, pois não é necessário analisar a linha. Segundo meus testes, é 11,5% mais rápido com 2 colunas e ainda mais com um maior número de colunas.
- Mais fácil mudar o esquema de dados.
- Código mais claro.
Conclusão: é uma questão de gosto. Como a velocidade é uma das principais vantagens do uso de globais, não faz muito sentido usar essa implementação, já que ela provavelmente não funcionará mais rápido que tabelas em bancos de dados relacionais.
3.4 Caso geral. Árvores e árvores ordenadas.
Qualquer estrutura de dados que pode ser representada como uma árvore se encaixa bem em globais.
3.4.1 Objetos com subobjetos.
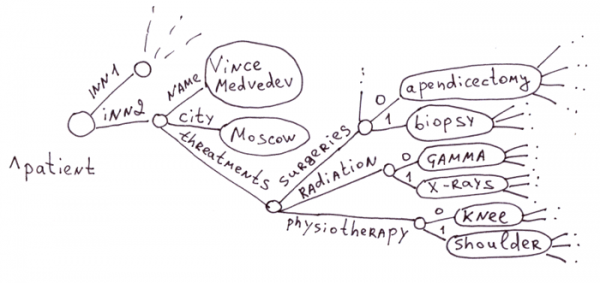
Esta é a área de aplicação tradicional de globais. Na área médica, há um número enorme de doenças, medicamentos, sintomas e métodos de tratamento. Criar uma tabela para cada paciente com um milhão de campos é irracional. Além disso, 99% dos campos estariam vazios.
Imagine um banco de dados SQL a partir de tabelas: "paciente" ~ 100.000 campos, "medicamento" — 100.000 campos, "terapia" — 100.000 campos, "complicações" — 100.000 campos, e assim por diante. Ou pode-se criar um banco de dados com milhares de tabelas, cada uma para um tipo específico de paciente (e eles podem se sobrepor!), tratamento, medicamento, além de milhares de tabelas para relações entre essas tabelas.
Globais são perfeitamente adequados para a medicina, pois permitem criar uma descrição exata do histórico médico de cada paciente, diversas terapias, ações de medicamentos, em forma de árvore, sem desperdiçar espaço em disco em colunas vazias, como aconteceria no caso relacional.
 Em globais, é conveniente criar um banco de dados com dados sobre pessoas., quando é importante acumular e sistematizar o máximo de informações variadas sobre o cliente. Isso é demandado na medicina, setor bancário, marketing, arquivística e outras áreas.
.
Sem dúvida, também é possível emular uma árvore no SQL usando apenas algumas tabelas (, ,,,,,,,,,), no entanto, isso é substancialmente mais difícil e funcionará mais lentamente. Na verdade, seria necessário escrever um global que funcione em tabelas e esconder todo o trabalho com tabelas sob uma camada de abstração. Não é correto emular uma tecnologia de nível mais baixo (globais) com ferramentas de nível mais alto (SQL). Não é viável.
Não é segredo que alterar o esquema de dados em tabelas gigantes (ALTER TABLE) pode levar um tempo considerável. O MySQL, por exemplo, realiza ALTER TABLE ADD|DROP COLUMN copidindo completamente as informações da tabela antiga para a nova (teste feito com os motores MyISAM, InnoDB). Isso pode travar um banco de dados em funcionamento com bilhões de registros por dias, se não semanas.
 Modificar a estrutura de dados, se estamos utilizando globais, não nos custa nada. A qualquer momento podemos adicionar quaisquer novas propriedades necessárias a qualquer objeto, em qualquer nível da hierarquia. Alterações relacionadas à renomeação de nós podem ser executadas em segundo plano em um banco de dados em funcionamento.
Portanto, quando se trata de armazenar objetos com uma quantidade enorme de propriedades opcionais, globais são uma excelente escolha.
Além disso, lembro que o acesso a qualquer uma das propriedades é instantâneo, pois todos os caminhos em um global representam uma árvore B.
Bancos de dados que utilizam globais, em geral, são uma variante de bancos de dados orientados a documentos, com a capacidade de armazenar informações hierárquicas. Portanto, no âmbito do armazenamento de prontuários médicos, globais podem competir com bancos de dados orientados a documentos. Mas ainda assim, isso não é exatamente o mesmo.Para comparação, vamos considerar o MongoDB. Neste campo, ele perde para os globais pelas seguintes razões:
- Tamanho do documento. A unidade de armazenamento é o texto no formato JSON (mais precisamente BSON) com um tamanho máximo de cerca de 16MB. Essa limitação foi feita especificamente para que o banco de dados JSON não fique lento ao fazer a análise, caso armazene um enorme documento JSON e depois precise acessá-lo por campos. Neste documento deve estar concentrada toda a informação sobre o paciente. Todos sabemos quão volumosos podem ser os prontuários dos pacientes. O tamanho máximo de 16MB de um prontuário imediatamente inviabiliza pacientes cujos arquivos contêm exames de ressonância magnética, radiografias e outros estudos. Em um único nó do global, por outro lado, é possível ter informações de gigabytes e terabytes. Em princípio, isso poderia encerrar a discussão, mas eu continuarei.
- Tempo de consciência/mudança/exclusão de novas propriedades no cartão do paciente. Tal banco de dados deve carregar toda a estrutura na memória (o que é um grande volume!), analisar BSON, inserir/modificar/excluir um novo nó, atualizar os índices, empacotar em BSON e salvar no disco. Para o global, é suficiente acessar uma propriedade específica e realizar as manipulações necessárias.
- Velocidade de acesso a propriedades individuais. Com múltiplas propriedades em um documento e sua estrutura em vários níveis, o acesso a propriedades individuais será mais rápido pois cada caminho no global é uma B-tree. No BSON, será necessário analisar o documento linearmente para encontrar a propriedade desejada.
3.3.2 Arrays associativos
Os arrays associativos (mesmo com arrays aninhados) se encaixam perfeitamente nos globais. Por exemplo, esse array do PHP se refletirá na primeira imagem 3.3.1.
$a = array(
  "name" => "Vince Medvedev",
  "city" => "Moscovo",
  "threatments" => array(
    "surgeries" => array("apendicectomia", "biópsia"),
    "radiation" => array("gamma", "raios-x"),
    "physiotherapy" => array("joelho", "ombro")
  )
);
3.3.3 Documentos hierárquicos: XML, JSON
Também são facilmente armazenados em globais. Para o armazenamento, pode-se dispor de várias maneiras.
XML
A maneira mais simples de mapear XML em globais é armazenar atributos de tags nos nós. E se precisar de acesso rápido aos atributos das tags, podemos movê-los para ramos separados.
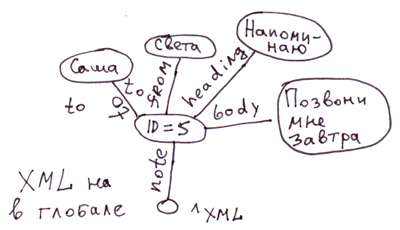
<note id="5">
<to>Vasya</to>
<from>Svetlana</from>
<heading>Lembrete</heading>
<body>Me liga amanhã!</body>
</note>
No COS, isso corresponderá ao código:
Set ^xml("note")="id=5"
Set ^xml("note","to")="Sasha"
Set ^xml("note","from")="Sveta"
Set ^xml("note","heading")="Lembrete"
Set ^xml("note","body")="Ligue para mim amanhã!"
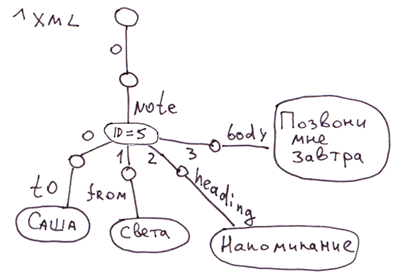
Observação: Para XML, JSON, arrays associativos, podem ser pensadas várias maneiras diferentes de representação em globais. Neste caso, não refletimos a ordem dos tags aninhados no tag note. No global ^xml tags aninhados serão exibidos em ordem alfabética. Para refletir rigorosamente a ordem, pode-se usar, por exemplo, tal representação:
JSON.
Na primeira imagem da seção 3.3.1, é mostrado o reflexo deste documento JSON:
var document = {
  "name": "Vince Medvedev",
  "city": "Moscovo",
  "threatments": {
    "surgeries": ["apendicectomia", "biópsia"],
    "radiation": ["gamma", "raios-x"],
    "physiotherapy": ["joelho", "ombro"]
  },
};
3.3.4 Estruturas idênticas relacionadas por relações hierárquicas
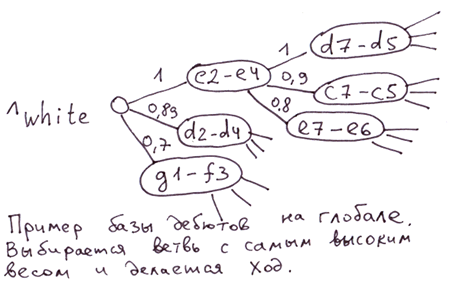
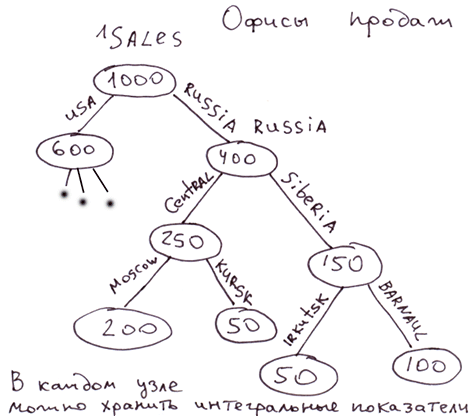
Exemplos: estrutura de escritórios de vendas, localização de pessoas em uma estrutura de MLM, banco de aberturas em xadrez.
Banco de aberturas. Podemos usar a avaliação da força de movimento como valor do índice do global. Assim, para escolher o movimento mais forte, basta selecionar o ramo com o maior peso. No global, todos os ramos em cada nível serão classificados pela força do movimento.
Estrutura dos escritórios de vendas, estrutura de pessoas em MLM. Nos nós, é possível armazenar certos valores em cache que refletem as características de toda a subárvore. Por exemplo, o volume de vendas dessa subárvore. Em qualquer momento, podemos obter um número que reflete o desempenho de qualquer ramo.
4. Em quais casos é mais vantajoso usar globals.
Na primeira coluna, estão apresentados os casos em que você terá um ganho significativo de velocidade ao usar globals, e na segunda, quando a desenvolvimento ou o modelo de dados será simplificado.
Velocidade
Facilidade de processamento/presentação de dados.
- Inserção [com ordenação automática em cada nível], [indexação pela chave principal].
- Remoção de subárvores.
- Objetos com uma massa de propriedades aninhadas que requerem acesso individual.
- Estrutura hierárquica com a possibilidade de percorrer ramos filhos a partir de qualquer um, mesmo que não existente.
- Percurso de subárvores em profundidade.
- Objetos/entidades com um enorme número de propriedades/entidades opcionais [e/ou] aninhadas.
- Dados sem esquema (schema-less). Quando novas propriedades podem frequentemente aparecer e antigas desaparecerem.
- É necessário criar um banco de dados não convencional.
- Bases de caminhos e árvores de decisões. Quando os caminhos são convenientes para serem apresentados como uma árvore.
- Remoção de estruturas hierárquicas sem o uso de recursão.
Continuação .
Aviso Legal: este artigo e meus comentários a ele são minha opinião e não têm relação com a posição oficial da corporação InterSystems.
Fonte: habr.com
