

Convido você a conhecer a transcrição da apresentação de 2019 de Alexander Valyalkin "Otimizações do Go no VictoriaMetrics"
— um SGBD rápido e escalável para armazenar e processar dados na forma de séries temporais (um registro forma o tempo e um conjunto de valores correspondentes a esse tempo, por exemplo, obtidos através de sondagem periódica do estado de sensores ou coleta de métricas).
Aqui está o link para o vídeo desta apresentação —
Vou falar um pouco sobre mim. Eu sou Alexander Valyalkin. Aqui está . Sou fascinado por Go e otimização de desempenho. Escrevi muitas bibliotecas úteis e algumas não tão úteis. Elas começam com fast, ou com quick o prefixo.
Atualmente, estou trabalhando na VictoriaMetrics. O que é isso e o que eu faço lá? Vou falar sobre isso nesta apresentação.
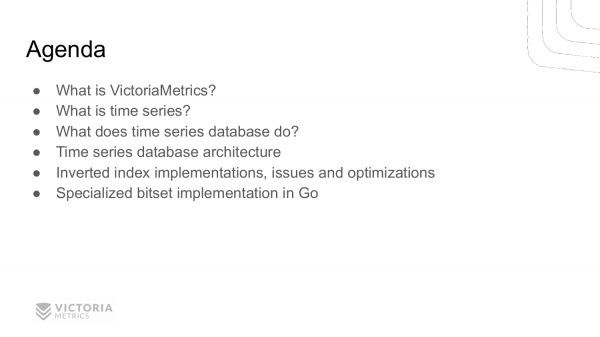
O plano da apresentação é o seguinte:
- Primeiro, vou explicar o que é a VictoriaMetrics.
- Depois, falarei sobre o que são séries temporais.
- Em seguida, explicarei como funciona um banco de dados de séries temporais.
- Depois falarei sobre a arquitetura do banco de dados: do que ela é composta.
- E depois passaremos para as otimizações que existem na VictoriaMetrics. Isso inclui a otimização do índice invertido e a otimização para a implementação de bitset em Go.
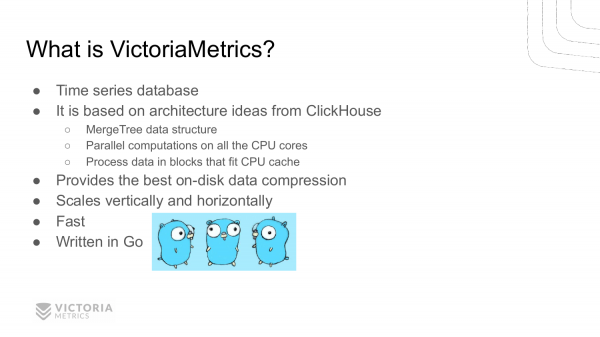
Alguém na audiência sabe o que é VictoriaMetrics? Que bom, muitas pessoas já sabem. Essa é uma boa notícia. Para aqueles que não sabem – é um banco de dados para séries temporais. Ele é baseado na arquitetura ClickHouse, com alguns detalhes da implementação do ClickHouse. Por exemplo: MergeTree, processamento paralelo em todos os núcleos de CPU disponíveis e otimização de desempenho através do trabalho com blocos de dados que são colocados no cache do processador.
A VictoriaMetrics oferece melhor compressão de dados em comparação com outros bancos de dados para séries temporais.
Ela escala verticalmente — ou seja, você pode adicionar mais processadores, mais memória RAM em um único computador. A VictoriaMetrics aproveitará com sucesso esses recursos disponíveis e aumentará o desempenho linearmente.
Além disso, a VictoriaMetrics escala horizontalmente — ou seja, você pode adicionar nós adicionais no cluster da VictoriaMetrics, e seu desempenho aumentará quase linearmente.
Como você deve ter adivinhado, a VictoriaMetrics é um banco de dados rápido, porque não posso escrever sobre outros. E é escrita em Go, por isso estou falando sobre ela neste meetup.
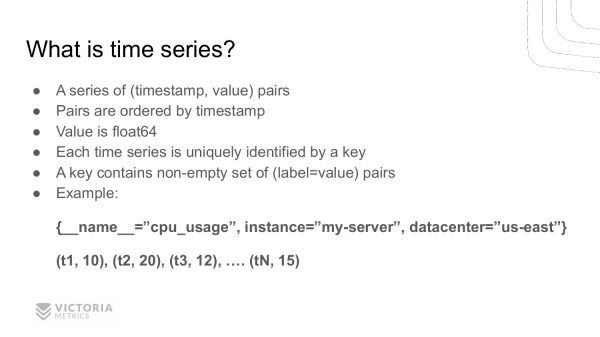
Quem sabe o que é uma série temporal? Muitas pessoas também sabem. Uma série temporal é uma sequência de pares (timestamp, valor), onde esses pares estão ordenados no tempo. O valor é representado como um número de ponto flutuante – float64.
Cada série temporal é identificada de maneira única por uma chave. Do que consiste essa chave? Ela consiste em um conjunto não vazio de pares chave-valor.
Aqui está um exemplo de série temporal. A chave desta série é uma lista de pares: __name__="cpu_usage" – este é o nome da métrica, instance="my-server" – é o computador no qual essa métrica foi coletada, datacenter="us-east" – é o data center onde esse computador está localizado.
Obtivemos o nome da série temporal, consistindo em três pares chave-valor. Esta chave corresponde a uma lista de pares (timestamp, value). t1, t3, t3, ..., tN – esses são os timestamps, 10, 20, 12, ..., 15 – com os valores correspondentes. Este é o uso de CPU no momento para esta série.
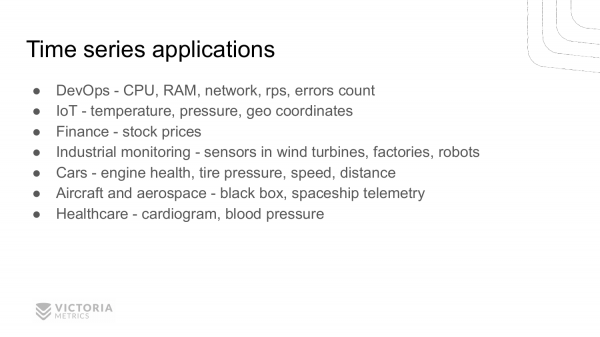
Onde as séries temporais podem ser usadas? Alguém tem ideias?
- No DevOps, pode-se medir as leituras de carga da CPU, RAM, rede, rps, número de erros, etc.
- IoT – podemos medir temperatura, pressão, coordenadas geográficas e mais.
- Além disso, nas finanças – podemos monitorar preços de ações e moedas.
- Além disso, as séries temporais podem ser usadas para monitorar processos de produção em fábricas. Temos usuários que utilizam a VictoriaMetrics para monitoramento de turbinas eólicas, para robôs.
- As séries temporais também são úteis para coletar informações de sensores de vários dispositivos. Por exemplo, para motores; para medir pressão em pneus; para medir velocidade, distância; para medir consumo de combustível, etc.
- As séries temporais também podem ser usadas para monitorar aviões. Cada avião possui uma caixa preta que coleta séries temporais de vários parâmetros de saúde da aeronave. As séries temporais também são utilizadas na indústria aeroespacial.
- Saúde – isso inclui pressão arterial, pulso, etc.
Pode haver outras aplicações que eu esqueci, mas espero que você tenha entendido que as séries temporais são amplamente utilizadas no mundo moderno. E seu uso continua a crescer a cada ano.
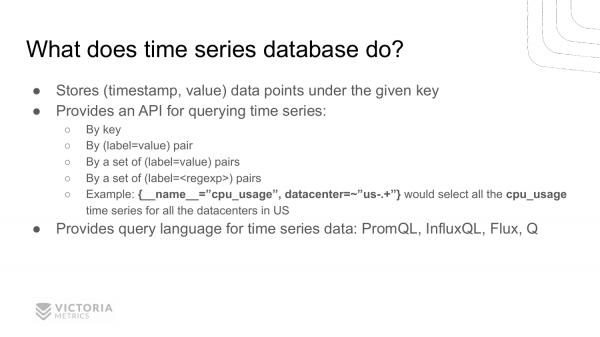
Para que uma base de dados para séries temporais é necessária? Por que não se pode usar um banco de dados relacional comum para armazenar séries temporais?
Porque em séries temporais geralmente há um grande volume de informações que é difícil de armazenar e processar em bancos de dados comuns. Por isso, surgiram bancos de dados especializados para séries temporais. Esses bancos armazenam eficientemente os pontos (timestamp, value) com a chave especificada. Eles fornecem uma API para ler os dados armazenados pela chave, por um par chave-valor, ou por vários desses pares, ou por regexp. Por exemplo, se você quiser encontrar a carga do processador de todos os seus serviços no data center na América, você deve usar esta pseudo consulta.
Normalmente, os bancos de dados para séries temporais apresentam linguagens de consulta especializadas, porque SQL não se adapta muito bem a séries temporais. Embora existam bancos de dados que suportam SQL, ele não é muito adequado. Linguagens de consulta como , , , são mais apropriadas. Espero que alguém tenha ouvido pelo menos uma dessas linguagens. Sobre PromQL, provavelmente muitos já ouviram. Esta é a linguagem de consultas do Prometheus.
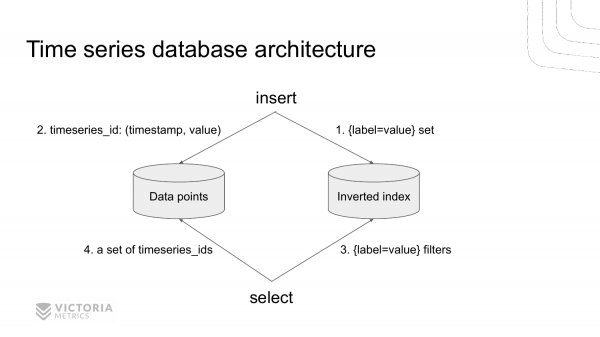
Aqui está como é a arquitetura de um banco de dados moderno para séries temporais usando o exemplo do VictoriaMetrics.
Ele consiste em duas partes. É um armazenamento para índice invertido e um armazenamento para valores de séries temporais. Esses armazenamentos são separados.
Quando uma nova gravação chega ao banco de dados, primeiro consultamos o índice invertido para encontrar o identificador da série temporal para o conjunto especificado de label=value para essa métrica. Encontramos esse identificador e armazenamos o valor no armazenamento de dados.
Quando chega algum pedido de recuperação de dados do TSDB, primeiro vamos ao índice invertido. Recuperamos todos os timeseries_ids as gravações que correspondem ao conjunto dado. label=valueE então recuperamos todos os dados necessários do armazenamento de dados, indexados por timeseries_ids.
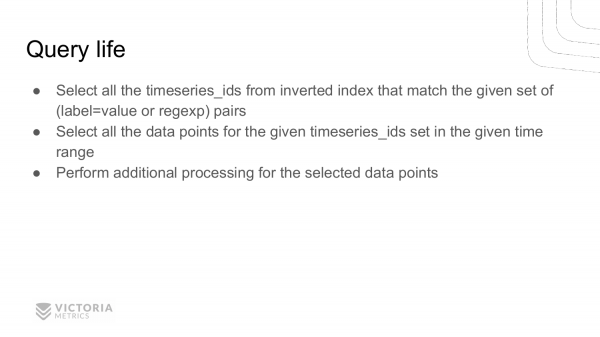
Vamos considerar um exemplo de como um banco de dados para séries temporais processa uma solicitação 'select' de entrada.
- Primeiro, ele obtém todos os
timeseries_idsdo índice invertido, que contêm os pares exigidoslabel=value, ou que satisfazem a uma expressão regular especificada. - Em seguida, ele recupera todos os data points do armazenamento de dados em um intervalo de tempo definido para os encontrados.
timeseries_ids. - Depois disso, o banco de dados realiza alguns cálculos sobre esses data points, de acordo com a solicitação do usuário. E, em seguida, retorna a resposta.
Nesta apresentação, vou falar sobre a primeira parte. Esta é a busca timeseries_ids pelo índice invertido. Você pode verificar a segunda e a terceira parte depois , ou esperar até que eu prepare outras palestras 🙂
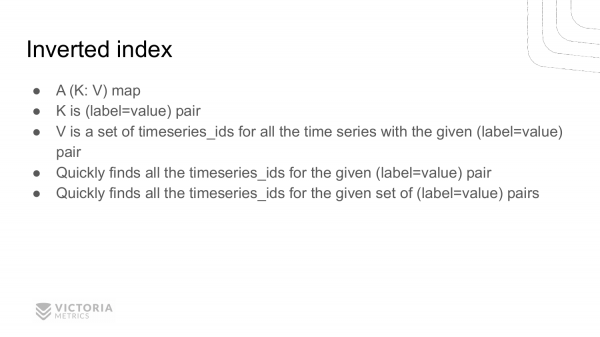
Vamos começar com o índice invertido. Muitos podem achar que é simples. Quem sabe o que é um índice invertido e como ele funciona? Oh, já não são tantas pessoas assim. Vamos tentar entender o que é isso.
Na verdade, é tudo simples. É apenas um dicionário que mapeia uma chave a um valor. O que é uma chave? Este par label=value, onde label e valor — são strings. E os valores são um conjunto timeseries_ids, que inclui o par dado label=value.
O índice invertido permite encontrar rapidamente todos timeseries_ids, que têm as especificações dadas label=value.
E também permite encontrar rapidamente timeseries_ids séries temporais para vários pares label=value, ou para pares label=regexp. Como isso acontece? Através da interseção de conjuntos timeseries_ids para cada par label=value.
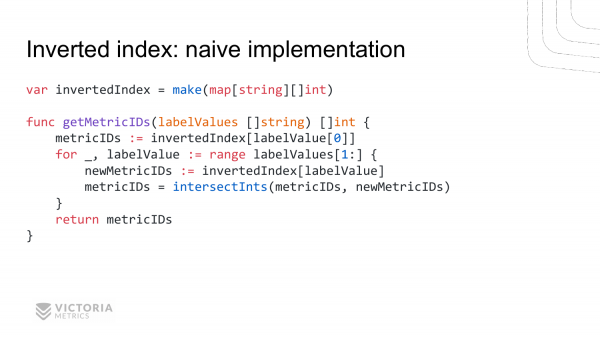
Vamos considerar diferentes implementações de um índice invertido. Começaremos pela implementação ingênua mais simples. Ela se parece assim.
Função getMetricIDs obtém uma lista de strings. Cada string contém label=value. Esta função retorna uma lista metricIDs.
Como isso funciona? Aqui temos uma variável global chamada invertedIndex. Este é um dicionário comum (mapa), que mapeia uma string para um slice de inteiros. A string contém label=value.
Implementação da função: pegamos metricIDs para o primeiro label=value, depois percorremos todos os outros label=value, pegamos metricIDs para eles. E chamamos a função intersectInts, que será discutida a seguir. E essa função retorna a interseção dessas listas.
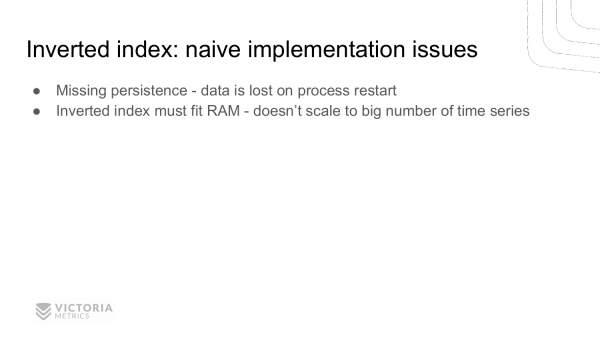
Como você pode ver, a implementação do índice invertido não é muito complicada. Mas esta é uma implementação ingênua. Quais são suas desvantagens? A principal desvantagem da implementação ingênua é que esse índice invertido é armazenado na memória RAM. Após o reinício do aplicativo, perdemos esse índice. Não há salvamento deste índice no disco. Para um banco de dados, é improvável que esse índice invertido sirva.
A segunda desvantagem também está relacionada à memória. O índice invertido deve caber na memória RAM. Se ele exceder o tamanho da memória RAM, claramente teremos – erro de falta de memória. E o programa não funcionará.
Esse problema pode ser resolvido com soluções prontas como , ou .
Resumindo, precisamos de um banco de dados que permita realizar rapidamente três operações.
- A primeira operação é a gravação
chave-valornesta base. Ela faz isso muito rapidamente, ondechave-valorsão linhas arbitrárias. - A segunda operação é a busca rápida de um valor por uma chave especificada.
- E a terceira operação é a busca rápida de todos os valores por um prefixo dado.
LevelDB e RocksDB são bancos de dados desenvolvidos no Google e no Facebook. Primeiro, veio o LevelDB. Depois, o pessoal do Facebook pegou o LevelDB e começou a melhorá-lo, criando o RocksDB. Atualmente, quase todos os bancos de dados internos do Facebook operam em RocksDB, incluindo a migração do MySQL para RocksDB. Eles o chamaram de .
Um índice invertido pode ser implementado com o LevelDB. Como fazer isso? Nós salvamos como chave label=value. E como valor, o identificador da série temporal onde a dupla está presente label=value.
Se temos muitas séries temporais com essa dupla label=value, haverá muitas linhas nesta base de dados com a mesma chave e diferentes timeseries_ids. Para obter uma lista de todos os timeseries_ids, que começam com o dado label=prefix, fazemos uma varredura de intervalo, para a qual esta base de dados é otimizada. Ou seja, selecionamos todas as linhas que começam com label=prefix e obtemos os necessários timeseries_ids.
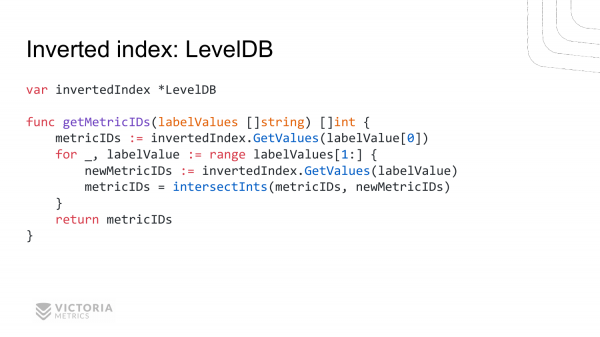
Aqui está uma implementação aproximada de como ela seria em Go. Temos um índice invertido. Este é o LevelDB.
A função é a mesma que para a implementação ingênua. Ela quase se repete linha a linha da implementação ingênua. A única diferença é que, em vez de chamar mapa , chamamos o índice invertido. Recuperamos todos os valores para o primeiro label=value. Em seguida, percorremos todos os pares restantes label=value e recuperamos os conjuntos correspondentes de metricIDs para eles. Então encontramos a interseção.
Parece que tudo está bem, mas essa solução tem desvantagens. A VictoriaMetrics inicialmente implementou um índice invertido baseado no LevelDB. Mas no final, teve que abandoná-lo.
Por quê? Porque o LevelDB é mais lento do que a implementação ingênua. Na implementação ingênua, por uma chave especificada, obtemos imediatamente todo o slice metricIDs. Esta é uma operação muito rápida - todo o slice está pronto para uso.
No LevelDB, no entanto, a cada chamada da função GetValues é necessário percorrer todas as linhas que começam com label=value. E para cada linha, recuperar o valor timeseries_ids. A partir dessas timeseries_ids construir um slice desses timeseries_ids. É evidente que isto é muito mais lento do que simplesmente acessar um mapa comum pela chave.
A segunda desvantagem é que o LevelDB é escrito em C. A chamada de funções C a partir do Go não é muito rápida. Isso leva centenas de nanossegundos. Não é muito rápido, porque em comparação com uma chamada de função escrita em Go, que leva de 1 a 5 nanossegundos, a diferença de desempenho é de dezenas de vezes. Para o VictoriaMetrics, isso foi uma desvantagem fatal 🙂
Portanto, eu escrevi minha própria implementação de índice invertido. E o nomeei .
O mergeset é baseado na estrutura de dados MergeTree. Essa estrutura de dados foi emprestada do ClickHouse. É evidente que o mergeset deve ser otimizado para busca rápida timeseries_ids por uma chave específica. O mergeset é completamente escrito em Go. Você pode conferir . A implementação do mergeset está na pasta . Você pode tentar entender o que está acontecendo lá.
A API do mergeset é muito parecida com a do LevelDB e RocksDB. Ou seja, ela permite salvar rapidamente novos registros e selecionar registros rapidamente por um prefixo específico.
Vamos falar sobre as desvantagens do mergeset mais tarde. Agora, vamos discutir os problemas que surgiram com o VictoriaMetrics em produção durante a implementação do índice invertido.
Por que eles ocorreram?
A primeira razão é a alta taxa de churn. Em português, isso significa uma troca frequente de séries temporais. Isso ocorre quando uma série temporal termina e uma nova começa, ou quando muitas novas séries temporais começam. E isso acontece com frequência.
A segunda razão é a grande quantidade de séries temporais. No início, quando a monitoria começou a ganhar popularidade, havia poucas séries temporais. Por exemplo, para cada computador, era necessário monitorar o uso da CPU, memória, rede e disco. Quatro séries temporais para cada computador. Se você tiver, digamos, 100 computadores, terá 400 séries temporais. Isso é muito pouco.
Com o tempo, as pessoas descobriram que poderiam medir informações mais detalhadas. Por exemplo, medir a carga não de toda a CPU, mas individualmente de cada núcleo do processador. Se você tiver 40 núcleos de processador, então você terá 40 vezes mais séries temporais para medir a carga da CPU.
Mas isso ainda não é tudo. Cada núcleo de processador pode ter vários estados, como o idle, quando fica ocioso. Também existem estados como operação em user space, operação em kernel space e outros. E cada um desses estados também pode ser medido como uma série temporal separada. Isso aumenta ainda mais a quantidade de séries em 7-8 vezes.
A partir de uma métrica, obtivemos 40 x 8 = 320 métricas apenas para um computador. Multiplicamos por 100 e obtemos 32.000 em vez de 400.
Depois, apareceu o Kubernetes. E isso complicou ainda mais, pois no Kubernetes podem ser hospedados muitos serviços diferentes. Cada serviço no Kubernetes consiste em vários pods. E tudo isso precisa ser monitorado. Além disso, temos um deployment constante de novas versões dos seus serviços. Para cada nova versão, é necessário criar novas séries temporais. No final, o número de séries temporais cresce exponencialmente e nos deparamos com o problema de um grande número de séries temporais, conhecido como high-cardinality. O VictoriaMetrics lida com isso com sucesso em comparação com outros bancos de dados para séries temporais.
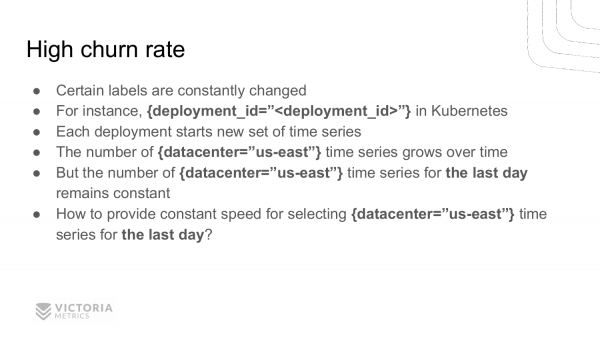
Vamos explorar mais detalhadamente o high churn rate. O que causa um high churn rate em produção? Porque alguns valores de labels e tags mudam constantemente.
Por exemplo, vamos considerar o Kubernetes, onde existe o conceito deployment, ou seja, quando uma nova versão do seu aplicativo é implantada. Os desenvolvedores do Kubernetes decidiram, por algum motivo, adicionar o id do deployment ao label.
Qual foi a consequência disso? Que em cada novo deployment, todas as séries temporais antigas são interrompidas, e no lugar delas, novas séries temporais começam com um novo valor de label deployment_id. Essas séries podem ser centenas de milhares e até milhões.
Uma característica importante disso tudo é que o número total de séries temporais cresce, mas a quantidade de séries temporais que estão ativas no momento, para as quais os dados estão chegando, permanece constante. Esse estado é chamado de high churn rate.
O principal problema do high churn rate é garantir uma taxa constante de busca em todas as séries temporais de acordo com um conjunto determinado de labels em um determinado intervalo de tempo. Normalmente, esse intervalo de tempo é a última hora ou o último dia.
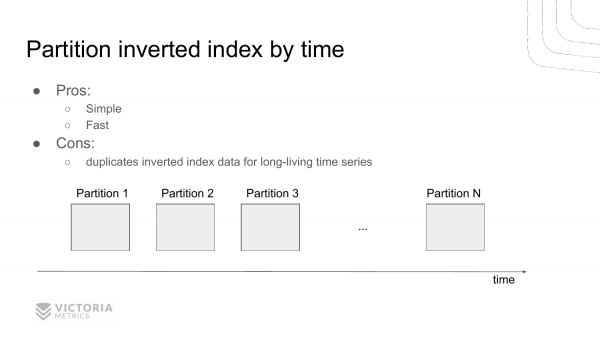
Como resolver esse problema? Aqui está a primeira opção. Dividir o índice invertido em partes independentes de acordo com o tempo. Ou seja, após um determinado intervalo de tempo, finalizamos o trabalho com o índice invertido atual e criamos um novo índice invertido. Após mais um intervalo de tempo, criamos outro e assim sucessivamente.
E ao consultar esses índices invertidos, encontramos um conjunto de índices invertidos que cai dentro do intervalo especificado. E, consequentemente, selecionamos a partir deles os IDs das séries temporais.
Isso permite economizar recursos, pois não precisamos examinar partes que não caem dentro do intervalo especificado. Ou seja, normalmente, se estamos selecionando dados da última hora, ignoramos as consultas para intervalos de tempo anteriores.
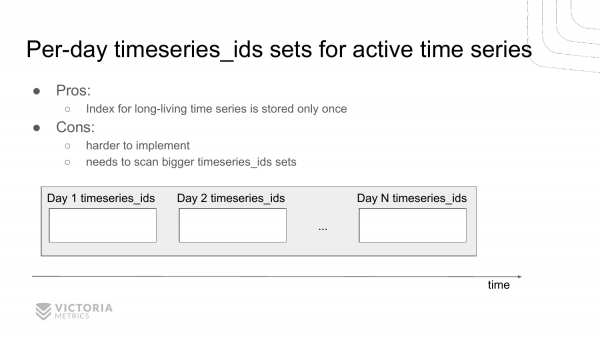
Há outra opção para resolver esse problema. Armazenar uma lista separada de IDs de séries temporais para cada dia, que apareceram naquele dia.
A vantagem dessa solução em relação à anterior é que não duplicamos informações sobre séries temporais que não desaparecem com o tempo. Elas estão sempre presentes e não mudam.
O desvantagem é que essa solução é mais complexa de implementar e mais difícil de debugar. E a VictoriaMetrics escolheu essa solução. Isso aconteceu historicamente. Essa solução também se mostra razoavelmente boa em comparação com a anterior. Porque essa solução não foi implementada devido à necessidade de duplicar dados em cada partição para séries temporais que não mudam, ou seja, que não desaparecem com o tempo. A VictoriaMetrics foi otimizada principalmente para o consumo de espaço em disco, e a implementação anterior piorava esse consumo. Já essa implementação é mais adequada para minimizar o consumo de espaço em disco, portanto, foi escolhida.
Tivemos que lidar com isso. A luta consistia em que, nesta implementação, ainda precisamos selecionar uma quantidade muito maior timeseries_ids de dados do que quando o índice invertido é dividido por tempo.
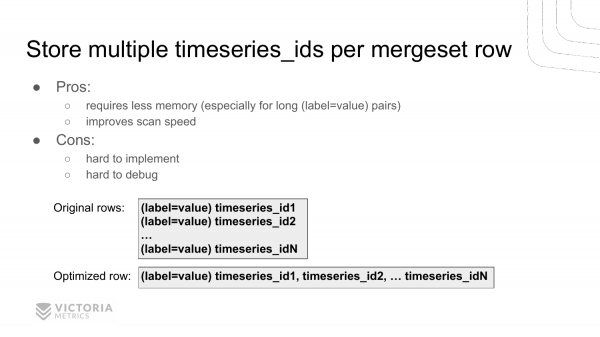
Como resolvemos esse problema? Nós o resolvemos de maneira original – salvando vários identificadores de séries temporais em cada registro do índice invertido em vez de um único identificador. Ou seja, temos uma chave label=value, que aparece em cada série temporal. E agora estamos salvando vários timeseries_ids em um único registro.
Aqui está um exemplo. Antes tínhamos N registros, agora temos um registro, cujo prefixo é o mesmo de todos os outros. O registro anterior continha todos os IDs das séries temporais.
Isso aumentou a velocidade de varredura desse índice invertido em até 10 vezes. E reduziu o consumo de memória para o cache, porque agora armazenamos a string label=value apenas uma vez no cache junto com N vezes. E essa string pode ser grande, se você tiver longas linhas armazenadas em tags e rótulos, que o Kubernetes gosta de introduzir.
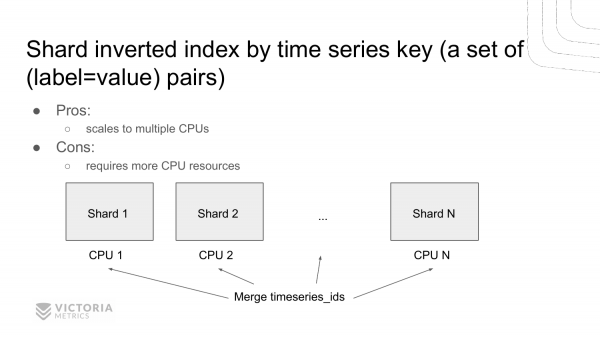
Outra opção para acelerar a busca em um índice invertido é o particionamento. Criar vários índices invertidos em vez de um único e particionar os dados entre eles por chave. Isso é um conjunto chave=valor de pares. Ou seja, obtemos vários índices invertidos independentes, que podemos consultar em paralelo em vários processadores. Implementações anteriores permitiam o funcionamento apenas em modo de um único processador, ou seja, só podíamos escanear dados em um núcleo. Esta solução permite escanear dados em vários núcleos, como o ClickHouse gosta de fazer. Isso nós planejamos implementar.
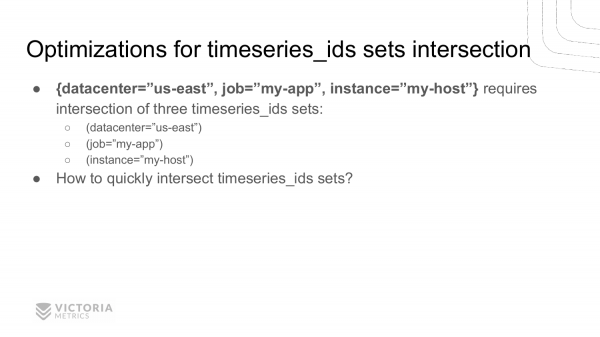
Agora voltemos ao que interessa – à função de interseção timeseries_ids. Vejamos quais podem ser as implementações. Essa função permite encontrar timeseries_ids para um conjunto dado label=value.
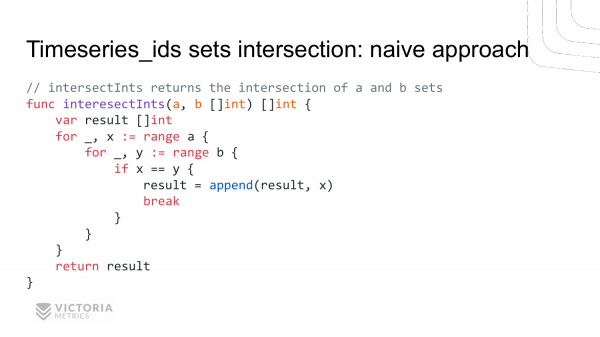
A primeira alternativa é a implementação ingênua. Dois laços aninhados. Recebemos como entrada da função intersectInts duas fatias — a e b. Como saída, ela deve retornar a interseção dessas fatias.
A implementação ingênua parece assim. Percorremos todos os valores da fatia a, dentro desse laço, percorremos todos os valores da fatia b. E os comparamos. Se coincidirem, significa que encontramos a interseção. E a armazenamos em result.
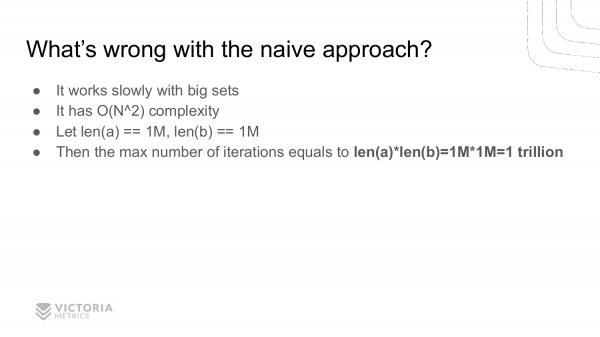
Quais são as desvantagens? A complexidade quadrática — essa é sua principal desvantagem. Por exemplo, se suas fatias a e b têm um milhão de elementos, essa função nunca retornará uma resposta. Porque precisaria fazer um trilhão de iterações, o que é muito mesmo para computadores modernos.
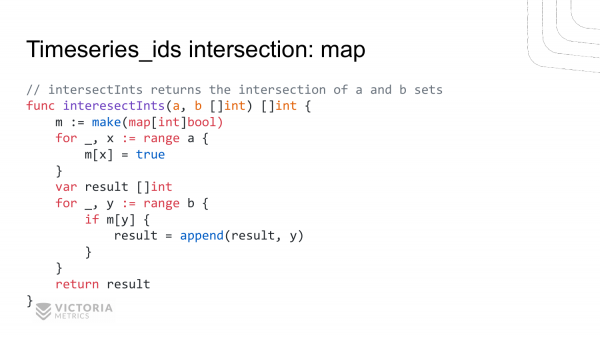
A segunda implementação é baseada em map. Criamos um map. Colocamos todos os valores da fatia anesse map. Em seguida, percorremos com um laço separado pela fatia b. E verificamos — existe esse valor na fatia b no mapa. Se existir, o adicionamos ao resultado.
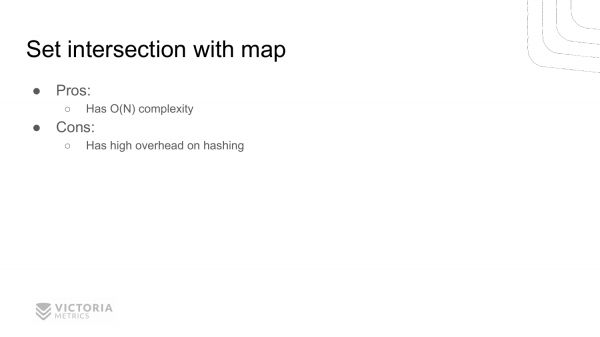
Quais são as vantagens? A vantagem é que aqui temos apenas complexidade linear. Ou seja, a função será executada muito mais rapidamente para tamanhos grandes de slices. Para um slice de um milhão de elementos, essa função será executada em 2 milhões de iterações, em vez de um trilhão de iterações, como na função anterior.
E o desvantagem é que essa função requer mais memória para criar esse mapa.
A segunda desvantagem é o grande overhead de hashing. Essa desvantagem não é muito óbvia. E para nós também não era muito clara, então, inicialmente, na implementação do intersection no VictoriaMetrics foi usado um mapa. Mas, depois da profilagem, ficou claro que a maior parte do tempo do processador estava sendo gasto na gravação no mapa e na verificação da presença de um valor nesse mapa.
Por que o tempo do processador é gasto nesses pontos? Porque, nessas linhas, o Go realiza a operação de hashing. Ou seja, ele calcula o hash da chave para então acessar o índice correspondente no HashMap. A operação de cálculo do hash leva dezenas de nanossegundos. Isso é lento para o VictoriaMetrics.
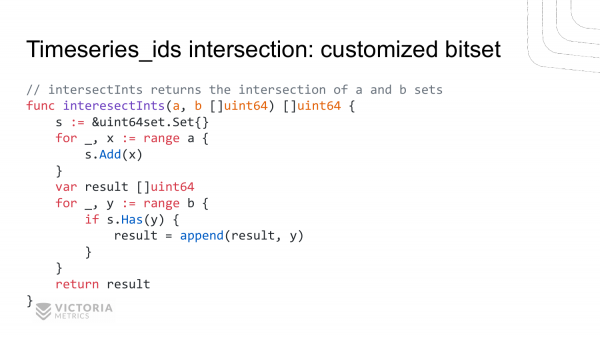
Decidi implementar um bitset, otimizado especificamente para este caso. Veja como agora é feita a interseção de dois slices. Aqui, criamos um bitset. Adicionamos os elementos do primeiro slice. Em seguida, verificamos a presença desses elementos no segundo slice e os adicionamos ao resultado. Ou seja, é praticamente idêntico ao exemplo anterior. A única diferença é que substituímos o acesso ao mapa por funções personalizadas. add e has.
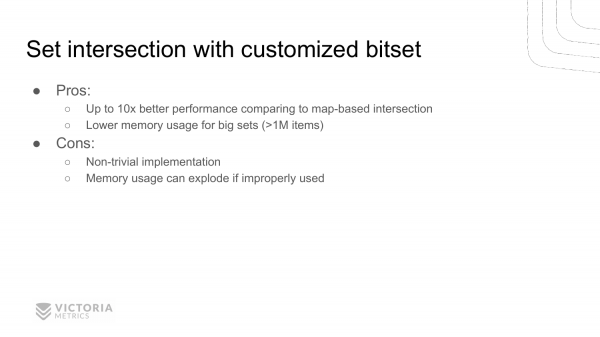
À primeira vista, parece que isso deveria funcionar mais devagar, se anteriormente foi usada uma mapa padrão e agora estamos chamando algumas funções, mas a profilagem mostra que essa abordagem funciona 10 vezes mais rápido do que o mapa padrão para o caso do VictoriaMetrics.
Além disso, usa muito menos memória em comparação com a implementação no mapa. Porque estamos armazenando bits em vez de valores de oito bytes.
A desvantagem dessa implementação é que ela não é tão evidente, não trivial.
Outra desvantagem que muitos podem não perceber é que essa implementação pode falhar em alguns casos. Ou seja, ela é otimizada para um caso específico, para este caso de interseção de IDs de séries temporais do VictoriaMetrics. Isso não significa que ela sirva para todos os casos. Se usada incorretamente, em vez de um aumento de desempenho, teremos um erro de 'out of memory' e uma diminuição do desempenho.
Vamos considerar a implementação dessa estrutura. Se você quiser conferir, ela está nos fontes do VictoriaMetrics, na pasta . Ela é otimizada especificamente para o caso do VictoriaMetrics, onde timeseries_id é um valor de 64 bits, onde os primeiros 32 bits são constantes e apenas os últimos 32 bits mudam.
Essa estrutura de dados não é armazenada em disco; ela funciona apenas na memória.
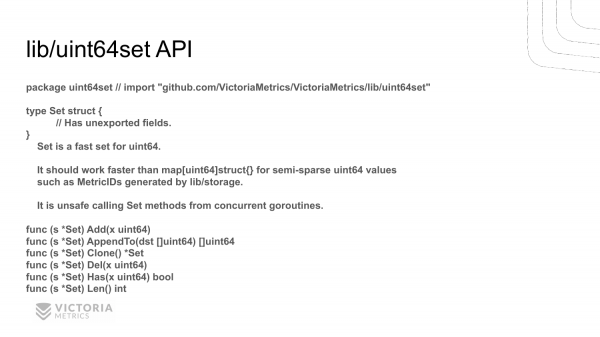
Aqui está sua API. Não é muito complexa. A API foi ajustada especificamente para o exemplo de uso do VictoriaMetrics. Ou seja, não há funções desnecessárias. Aqui estão as funções claramente utilizadas pelo VictoriaMetrics.
Há uma função add, que adiciona novos valores. Há uma função has, que verifica novos valores. E há uma função del, que remove valores. Há uma função auxiliar len, que retorna o tamanho do conjunto. A função clone clona o conjunto. E a função appendto transforma esse conjunto em slice. timeseries_ids.
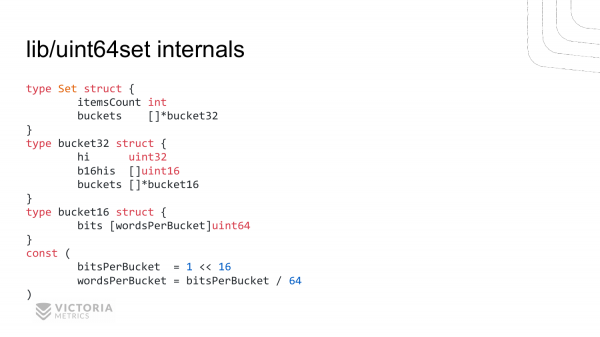
Aqui está como a implementação dessa estrutura de dados se apresenta. No conjunto, há dois elementos:
ItemsCount– este é um campo auxiliar para retornar rapidamente a quantidade de elementos no conjunto. Poderíamos ter dispensado esse campo auxiliar, mas foi preciso adicioná-lo aqui porque o VictoriaMetrics frequentemente consulta em seus algoritmos o comprimento do bitset.O segundo campo é
buckets. Este é um slice da estruturabucket32. Em cada estrutura, há um campo. Estes são os 32 bits mais altos. E dois slices —hib16hisbucket16ebucketsdoestruturas.Aqui são armazenados os 16 bits mais altos da segunda parte da estrutura de 64 bits. E aqui estão os bitsets para os 16 bits mais baixos de cada byte.
Bucket64
consiste em um array de uint64. O comprimento é calculado usando essas constantes. Em umpode armazenar no máximo estruturas. bits. Se dividirmos isso por 8, teremos 8 kilobytes. Se dividirmos mais uma vez por 8, teremos 1000 2^16=65536 valores. Ou seja, O comprimento é calculado usando essas constantes. Em um Bucket16 é a nossa estrutura de 8 kilobytes. Vamos considerar como um dos métodos dessa estrutura de adição de um novo valor é implementado.
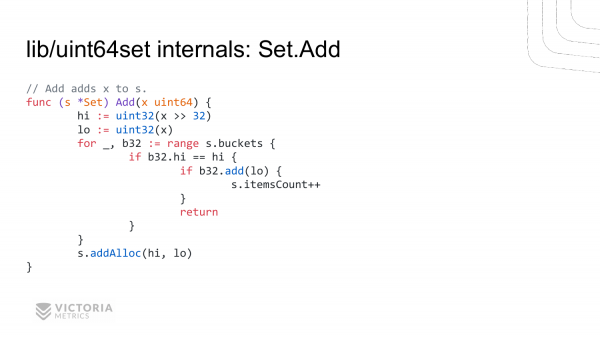
Tudo começa com
Tudo começa com O comprimento é calculado usando essas constantes. Em um valores. Calculamos os 32 bits superiores, calculamos os 32 bits inferiores. Passamos por todos buckets. Comparamos os 32 bits superiores em cada bucket com o valor adicionado. E se eles coincidirem, chamamos a função add na estrutura b32 buckets. E adicionamos os 32 bits inferiores. E se isso retornar verdadeiro, significa que adicionamos esse valor e não tínhamos esse valor antes. Se retornar falso, significa que esse valor já estava presente. Em seguida, aumentamos a contagem de elementos na estrutura.
Se não encontramos o necessário bucket com o valor hi correspondente, chamamos a função addAlloc, que aloca um novo bucket, adicionando-o à estrutura do bucket.
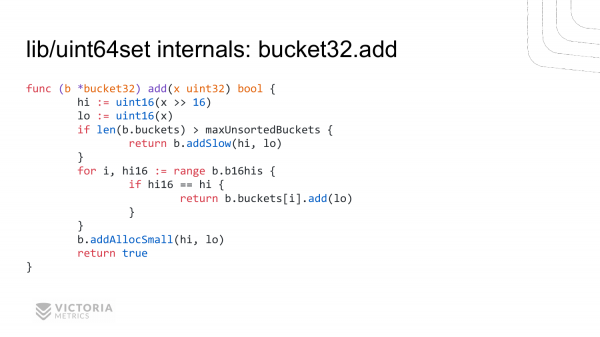
Esta é a implementação da função b32.add. Ela é semelhante à implementação anterior. Calculamos os 16 bits superiores e os 16 bits inferiores.
Depois, passamos por todos os 16 bits superiores. Encontramos coincidências. E ao encontrar uma coincidência, chamamos o método add, que veremos na próxima página para estruturas..
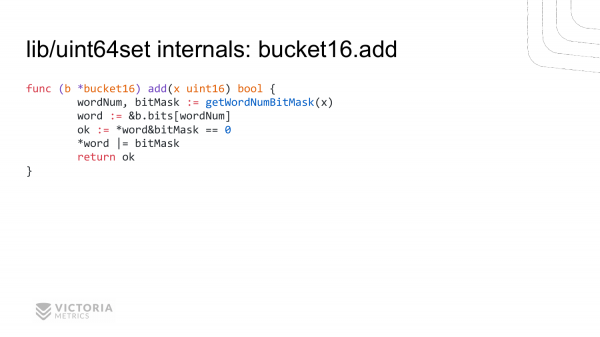
E aqui está o nível mais baixo, que deve ser otimizado ao máximo. Calculamos para O comprimento é calculado usando essas constantes. Em um o valor id no slice bit, assim como bitmask. Esta é uma máscara para esse valor de 64 bits, pela qual podemos verificar a presença desse bit ou defini-lo. Verificamos a presença desse bit, o definimos, e retornamos a presença. Esta é a implementação que conseguimos, que permitiu acelerar a operação de interseção de IDs de séries temporais em 10 vezes em comparação com maps normais.
No VictoriaMetrics, além dessa otimização, existem muitas outras otimizações. A maioria dessas otimizações foi adicionada não por acaso, mas após o profiling do código em produção.
Esta é a principal regra de otimização - não adicionar otimizações com base na suposição de que haverá um gargalo, porque pode resultar que lá não haja um gargalo. A otimização geralmente degrada a qualidade do código. Portanto, é prudente otimizar apenas após o profiling e, de preferência, em produção, para que se baseie em dados reais. Para quem estiver interessado, você pode analisar o código-fonte do VictoriaMetrics e estudar outras otimizações que lá estão.
Eu tenho uma pergunta sobre o bitset. Parece muito com a implementação do vetor bool do C++, um bitset otimizado. Vocês pegaram a implementação de lá?
Não, não é daí. Ao implementar este bitset, baseei-me no conhecimento da estrutura desses ids de séries temporais que são utilizados no VictoriaMetrics. E a estrutura deles é tal que os 32 bits superiores são principalmente constantes. Os 32 bits inferiores podem mudar. Quanto mais baixo o bit, mais frequentemente ele pode mudar. Portanto, esta implementação é otimizada especificamente para essa estrutura de dados. A implementação em C++, até onde sei, é otimizada para o caso geral. Se a otimização for feita para o caso geral, isso significa que ela não será a mais otimizada para um caso específico.
Recomendo que você também assista à palestra de Alexey Milovid. Ele falou sobre otimizações no ClickHouse para especializações específicas há cerca de um mês. Ele menciona que, em geral, a implementação em C++ ou qualquer outra implementação é ajustada para funcionar bem em média. Ela pode funcionar pior do que uma implementação especializada, como a nossa, quando sabemos que os 32 bits superiores são em grande parte constantes.
Eu tenho uma segunda pergunta. Qual é a diferença fundamental em relação ao InfluxDB?
Existem muitas diferenças fundamentais. Em termos de desempenho e consumo de memória, o InfluxDB em testes mostra 10 vezes mais consumo de memória para séries temporais de alta cardinalidade, quando você tem muitas, por exemplo, milhões. Por exemplo, o VictoriaMetrics consome 1 GB para um milhão de séries ativas, enquanto o InfluxDB consome 10 GB. E essa é uma grande diferença.
A segunda diferença fundamental é que o InfluxDB tem linguagens de consulta estranhas – Flux e InfluxQL. Elas não são muito convenientes para trabalhar com séries temporais em comparação com , que é suportado no VictoriaMetrics. PromQL é a linguagem de consultas do Prometheus.
E mais uma diferença é que o InfluxDB tem um modelo de dados um pouco peculiar, onde cada linha pode armazenar vários campos com conjuntos diferentes de tags. Essas linhas são ainda divididas em várias tabelas. Essas complicações adicionais dificultam o trabalho subsequente com esse banco de dados. Ele é difícil de manter e entender.
No VictoriaMetrics, tudo é muito mais simples. Cada série temporal representa uma chave-valor. O valor é um conjunto de pontos – (timestamp, value), e a chave é um conjunto label=value. Não há separação entre campos e medições. Isso permite que você escolha qualquer dado e, em seguida, combine, some, subtraia, multiplique e divida, ao contrário do InfluxDB, onde cálculos entre diferentes séries ainda não estão implementados, até onde sei. Mesmo que estivessem implementados, seriam complicados, exigindo muitos códigos.
Eu tenho uma pergunta para esclarecer. Entendi corretamente que houve algum problema, do qual você falou, que esse índice invertido não cabe na memória, então o particionamento ocorre?
No início, eu mostrei uma implementação ingênua de um índice invertido em um map padrão do Go. Essa implementação não é adequada para bancos de dados, porque esse índice invertido não é salvo no disco, e um banco de dados deve salvar no disco para que esses dados permaneçam disponíveis após uma reinicialização. Com essa implementação, após a reinicialização do aplicativo, o índice invertido desaparecerá. E você perderá o acesso a todos os dados, porque não conseguirá encontrá-los.
Olá! Obrigado pela apresentação! Meu nome é Pavel. Sou da empresa Wildberries. Tenho algumas perguntas para você. Primeira pergunta. O que você acha, se você tivesse escolhido outro princípio ao construir a arquitetura do seu aplicativo e particionado os dados por tempo, seria possível cruzar dados durante a pesquisa, baseando-se apenas no fato de que em uma partição estão os dados de um único intervalo de tempo? Ou seja, de um único intervalo de tempo, e você não teria que se preocupar com os fragmentos estarem espalhados de forma diferente? Segunda pergunta — uma vez que você está implementando um algoritmo semelhante com bitset e tudo mais, talvez você tenha tentado usar instruções do processador? Talvez você tenha experimentado essas otimizações?
Vou responder a segunda imediatamente. Ainda não chegamos nisso. Mas se for necessário, chegaremos. E a primeira, qual era a pergunta?
Você discutiu dois cenários. E disse que escolheu o segundo com uma implementação mais complexa. E não preferiu o primeiro, onde os dados são particionados por tempo.
Sim. No primeiro caso, o volume total do índice seria maior, porque em cada partição teríamos que armazenar dados duplicados para as séries temporais que se estendem por todas essas partições. E se a taxa de churn das séries temporais for baixa, ou seja, se as mesmas séries forem constantemente utilizadas, no primeiro caso perderíamos muito mais em volume de espaço em disco em comparação com o segundo caso.
Nesse caso, sim, a partição por tempo é uma boa opção. O Prometheus utiliza isso. Mas o Prometheus tem outra desvantagem. Ao mesclar esses blocos de dados, ele precisa manter na memória as meta-informações de todos os rótulos e séries temporais. Portanto, se os blocos de dados que ele mescla forem grandes, o consumo de memória aumenta consideravelmente durante a mesclagem, diferentemente do VictoriaMetrics. Na mesclagem, o VictoriaMetrics não consome memória; consome apenas alguns kilobytes, independentemente do tamanho dos blocos de dados que estão sendo combinados.
O algoritmo que você usa consome memória. Nele, são registradas as etiquetas das séries temporais nas quais há valores. E assim, você verifica a presença correspondente em um conjunto de dados e em outro. E entende se houve interseção ou não. Normalmente, os bancos de dados implementam cursores, iteradores, que armazenam seu estado atual e percorrem os dados ordenados, o que resulta em uma complexidade simples para essas operações.
Por que não usamos cursores para a interseção de dados?
Sim.
Temos no LevelDB ou no mergeset as linhas devidamente ordenadas. Podemos usar um cursor para encontrar a interseção. Mas por que não usamos? Porque isso é lento. Porque os cursores pressupõem que para cada linha precisamos chamar uma função. A chamada da função é de 5 nanosegundos. E se você tiver 100.000.000 de linhas, você acaba gastando meio segundo apenas com as chamadas de função.
Isso existe, sim. E a minha última pergunta. A pergunta pode parecer um pouco estranha. Por que no momento da chegada dos dados não podemos calcular todos os agregados necessários e salvá-los em um formato desejado? Por que armazenar enormes volumes em sistemas como VictoriaMetrics, ClickHouse, etc., para depois gastar muito tempo com eles?
Vou dar um exemplo para ficar mais claro. Suponha que você tenha um pequeno velocímetro de brinquedo. Ele registra a distância que você percorreu, sempre somando em uma medida, e em outra – o tempo. E divide. E obtém a velocidade média. Você pode fazer algo semelhante. Juntar todos os fatos necessários à medida que avança.
Certo, entendi a pergunta. Seu exemplo é válido. Se você sabe quais agregados precisa, essa é a melhor abordagem. Mas o problema é que as pessoas armazenam essas métricas, alguns dados no ClickHouse e não sabem ainda como vão agregá-los, filtrá-los no futuro, então acabam salvando todos os dados brutos. Mas se você sabe que precisa calcular algo médio, por que não calcular, em vez de guardar um monte de valores brutos? Mas isso só se você souber exatamente o que precisa.
Aliás, bancos para armazenar séries temporais suportam o cálculo de agregados. Por exemplo, o Prometheus suporta . Ou seja, é possível fazer isso se você souber quais agregados vão ser necessários. No VictoriaMetrics isso ainda não existe, mas geralmente coloca-se o Prometheus na frente, onde isso pode ser feito nas regras de gravação.
Por exemplo, no trabalho anterior eu precisava contar o número de eventos em uma janela deslizante no último hora. O problema é que tive que fazer uma implementação personalizada em Go, ou seja, um serviço para contar isso. Esse serviço acabou sendo não trivial, porque é complicado de calcular. A implementação pode ser simples se você precisa calcular alguns agregados em intervalos de tempo fixos. Mas se você quer contar eventos em uma janela deslizante, não é tão simples quanto parece. Eu acho que isso ainda não está implementado no ClickHouse ou em bancos de dados de séries temporais, porque é complicado de realizar.
E mais uma pergunta. Estávamos falando sobre médias, e me lembrei que havia algo chamado Graphite com backend Carbon. E ele conseguia filtrar dados antigos, ou seja, deixar um ponto por minuto, um ponto por hora, etc. Isso é bastante útil, se precisamos de dados brutos, digamos, de um mês, e tudo o mais pode ser filtrado. Mas o Prometheus e o VictoriaMetrics não suportam essa funcionalidade. Está previsto implementar? Se não, por quê?
Obrigado pela pergunta. Nossos usuários a fazem de vez em quando. Eles perguntam quando iremos adicionar suporte para downsampling. Aqui existem alguns problemas. Primeiro, cada usuário entende por downsampling algo diferente: alguns querem obter qualquer ponto arbitrário em um intervalo especificado, enquanto outros desejam valores máximos, mínimos ou médios. Se muitos sistemas estão escrevendo dados em sua base, não se pode tratar todos da mesma forma. Pode ser que para cada sistema seja necessário usar um downsampling diferente. E isso é complicado de implementar.
E segundo – o VictoriaMetrics, assim como o ClickHouse, é otimizado para trabalhar com grandes volumes de dados brutos, portanto, pode processar um bilhão de linhas em menos de um segundo, se você tiver muitos núcleos em seu sistema. A varredura de pontos de séries temporais no VictoriaMetrics é de 50.000.000 pontos por segundo por núcleo. E esse desempenho escalona-se nos núcleos disponíveis. Ou seja, se você tiver, por exemplo, 20 núcleos, poderá varrer um bilhão de pontos por segundo. E essa característica do VictoriaMetrics e do ClickHouse reduz a necessidade de downsampling.
Outra característica é que o VictoriaMetrics comprime esses dados de forma eficaz. A compressão média na produção é de 0,4 a 0,8 bytes por ponto. Cada ponto consiste em um timestamp + valor. E ele é comprimido a menos de um byte, em média.
Serguei. Eu tenho uma pergunta. Qual é o menor intervalo de tempo de gravação?
Uma milissegundo. Recentemente, tivemos uma conversa com outros desenvolvedores de bancos de dados para séries temporais. O intervalor mínimo deles é de um segundo. No Graphite, por exemplo, também é um segundo. No OpenTSDB também é um segundo. No InfluxDB – precisão em nanossegundos. No VictoriaMetrics – um milissegundo, porque no Prometheus é um milissegundo. E o VictoriaMetrics foi inicialmente desenvolvido como um armazenamento remoto para o Prometheus. Mas agora ele pode armazenar dados de outros sistemas também.
A pessoa com quem eu conversei diz que eles têm precisão em segundos — isso é suficiente para eles, pois depende do tipo de dados que estão sendo salvo na base de séries temporais. Se forem dados de DevOps ou dados da infraestrutura, onde você os coleta com um intervalo de 30 segundos a um minuto, então a precisão em segundos é suficiente, menos que isso não é necessário. Mas se você estiver coletando esses dados de sistemas de trading de alta frequência, então uma precisão em nanossegundos é necessária.
A precisão em milissegundos no VictoriaMetrics é adequada tanto para casos de DevOps quanto para a maioria dos casos que mencionei no início da apresentação. A única situação em que pode não ser adequada é para sistemas de negociação de alta frequência.
Obrigado! E mais uma pergunta. Qual é a compatibilidade com o PromQL?
Compatibilidade total. VictoriaMetrics suporta completamente o PromQL. Além disso, adiciona funcionalidades avançadas ao PromQL, chamadas de . Quanto a essas funcionalidades avançadas, há uma apresentação no YouTube. Eu falei sobre isso no Monitoring Meetup na primavera em São Petersburgo.
Canal do Telegram .
Apenas usuários registrados podem participar da pesquisa. , por favor.
O que impede você de migrar para o VictoriaMetrics como armazenamento de longo prazo para o Prometheus? (Deixe um comentário, eu adicionarei na enquete))
71,4%Não uso Prometheus5
28,6%Não conhecia o VictoriaMetrics2
7 usuários votaram. 12 usuários se abstiveram.
Fonte: habr.com
