

Olá, comunidade Habr. Tradicionalmente, continuamos a compartilhar material interessante antes do início de novos cursos. Hoje, especialmente para vocês, traduzimos um artigo sobre o Google Cloud Spanner, em comemoração ao lançamento do curso. .
Publicada originalmente em .
Como uma empresa que oferece diversas soluções de POS em nuvem para varejistas, restauradores e vendedores online em todo o mundo, a Lightspeed utiliza vários tipos diferentes de plataformas de bancos de dados para uma variedade de casos de uso transacionais, analíticos e de pesquisa. Cada uma dessas plataformas de bancos de dados tem seus pontos fortes e fracos. Portanto, quando o Google lançou o Cloud Spanner no mercado — com recursos promissores nunca vistos no mundo dos bancos de dados relacionais, como escalabilidade horizontal praticamente ilimitada e um SLA de 99,999% — não poderíamos deixar passar a oportunidade de colocá-lo em nossas mãos!
Para fornecer uma visão abrangente da nossa experiência com o Cloud Spanner, bem como dos critérios de avaliação que utilizamos, abordaremos os seguintes tópicos:
- Nossos critérios de avaliação
- Cloud Spanner em poucas palavras
- Nossa avaliação
- Nossas conclusões
1. Nossos critérios de avaliação
Antes de entrarmos nas características do Cloud Spanner, suas semelhanças e diferenças com outras soluções no mercado, vamos primeiro falar sobre os principais casos de uso que consideramos ao pensar onde implementar o Cloud Spanner em nossa infraestrutura:
- Como substituto da solução tradicional de banco de dados SQL
- Como uma solução OLTP com suporte a OLAP
Nota: Para simplicidade e conveniência de comparação, este artigo compara o Cloud Spanner com as opções MySQL das famílias de soluções GCP Cloud SQL e Amazon AWS RDS.
Usando o Cloud Spanner como substituto da solução tradicional de banco de dados SQL
Em um ambiente tradicional de bancos de dados, quando o tempo de resposta a uma consulta de banco de dados se aproxima ou até mesmo excede os limites pré-definidos do aplicativo (principalmente devido ao aumento no número de usuários e/ou consultas), existem várias maneiras de reduzir o tempo de resposta a níveis aceitáveis. No entanto, a maioria dessas soluções envolve intervenção manual.
Por exemplo, o primeiro passo a ser feito é analisar os diferentes parâmetros do banco de dados relacionados ao desempenho e ajustá-los para que se adequem melhor aos padrões de uso dos aplicativos. Se isso não for suficiente, pode-se optar por escalar o banco de dados vertical ou horizontalmente.
A escalabilidade vertical de um aplicativo envolve a atualização da instância do servidor, geralmente adicionando mais processadores/núcleos, mais memória RAM, armazenamento mais rápido, etc. A adição de mais recursos de hardware resulta em um aumento do desempenho do banco de dados, medido principalmente em transações por segundo e na latência das transações para sistemas OLTP. Sistemas de bancos de dados relacionais (que utilizam uma abordagem multithreading), como o MySQL, escalam bem verticalmente.
Essa abordagem tem algumas desvantagens, mas a mais óbvia é o limite máximo do tamanho do servidor no mercado. Uma vez alcançado o limite da maior instância do servidor, só resta um caminho: a escalabilidade horizontal.
A escalabilidade horizontal é uma abordagem em que mais servidores são adicionados ao cluster, idealmente aumentando a performance linearmente com o aumento do número de servidores. A maioria tradicional dos sistemas de bancos de dados escalonam mal horizontalmente ou não escalonam de forma alguma. Por exemplo, o MySQL pode escalar horizontalmente para operações de leitura, adicionando leitores escravo, mas não consegue escalar horizontalmente para operações de gravação.
Por outro lado, devido à sua natureza, o Cloud Spanner pode escalar facilmente horizontalmente com mínima intervenção.
Banco de dados completo como serviço deve ser avaliado sob diferentes perspectivas. Como base, utilizamos o banco de dados em nuvem mais popular — para o Google, GCP Cloud SQL e para a Amazon, AWS RDS. Em nossa avaliação, focamos nas seguintes categorias:
- Comparação de funcionalidades: extensão SQL, DDL, DML; bibliotecas de conexão/conectores, suporte a transações e assim por diante.
- Suporte ao desenvolvimento: facilidade de desenvolvimento e testes.
- Suporte para administração: gerenciamento de instâncias — por exemplo, escalonamento para cima/para baixo e atualização de instâncias; SLA, backup e recuperação; segurança/controle de acesso.
Uso do Cloud Spanner como solução OLTP com suporte a OLAP
Embora o Google não afirme explicitamente que o Cloud Spanner é destinado ao processamento analítico, ele compartilha alguns atributos com outros mecanismos, como Apache Impala & Kudu e YugaByte, que são projetados para cargas de trabalho OLAP.
Mesmo que houvesse apenas uma pequena chance de que o Cloud Spanner incorporasse um mecanismo HTAP escalável horizontalmente consistente (processamento híbrido transacional/analítico) com um conjunto de funções OLAP mais ou menos utilizável, acreditamos que isso mereceria nossa atenção.
Tendo isso em mente, consideramos as seguintes categorias:
- Carregamento de dados, índices e suporte a particionamento
- Desempenho de consultas e DML
2. Cloud Spanner em poucas palavras
Google Spanner é um sistema de gerenciamento de banco de dados relacional em cluster (SGBDR) que o Google usa para vários de seus próprios serviços. O Google o tornou público para os usuários da Google Cloud Platform no início de 2017.
Aqui estão alguns dos atributos do Cloud Spanner:
- Cluster SGBDR escalonável altamente consistente: utiliza sincronização de hardware de tempo para garantir a consistência dos dados.
- Suporte a transações entre tabelas: transações podem abranger várias tabelas — não se limitando a uma única tabela (diferente do Apache HBase ou Apache Kudu).
- Tabelas baseadas em chave primária: todas as tabelas devem ter uma chave primária (PK) declarada, que pode consistir em várias colunas da tabela. Os dados da tabela são armazenados na ordem da PK, o que os torna muito eficientes e rápidos para pesquisa por PK. Assim como outros sistemas baseados em PK, a implementação deve ser modelada levando em consideração casos de uso previamente definidos para alcançar .
- Tabelas intercaladas: as tabelas podem ter dependências físicas entre si. As linhas da tabela filha podem ser correspondidas com as linhas da tabela pai. Essa abordagem acelera a busca por relacionamentos que podem ser definidos na fase de modelagem de dados, como no caso de co-localização de clientes e suas faturas.
- Índices: o Cloud Spanner suporta índices secundários. Um índice consiste em colunas indexadas e todas as colunas da chave primária. Opcionalmente, o índice também pode conter outras colunas não indexadas. O índice pode se intercalar com a tabela pai para acelerar as consultas. Existem várias restrições aplicáveis aos índices, como o número máximo de colunas adicionais armazenadas no índice. Além disso, as consultas por meio de índices podem não ser tão diretas quanto em outros SGBDs.
O Cloud Spanner escolhe o índice automaticamente apenas em casos raros. Em particular, o Cloud Spanner não escolhe um índice secundário automaticamente se a consulta solicitar quaisquer colunas que não estejam salvas no ».
- Acordo de Nível de Serviço (SLA): implantação em uma única região com SLA de 99,99%; implantações multirregionais com SLA de 99,999%. Embora o próprio acordo de nível de serviço seja apenas um acordo, e não uma garantia, acredito que os funcionários do Google realmente tenham dados precisos para fazer uma afirmação tão séria. (Para referência, 99,999% significa 26,3 segundos de indisponibilidade do serviço por mês.)
- Mais:
Nota: O projeto Apache Tephra adiciona suporte avançado a transações no Apache HBase (agora também implementado no Apache Phoenix como beta).
3. Nossa avaliação
Então, todos nós lemos as alegações do Google sobre as vantagens do Cloud Spanner — escalabilidade horizontal praticamente ilimitada mantendo alta consistência e um SLA muito alto. Embora esses requisitos sejam de fato extremamente difíceis de alcançar, nosso objetivo não é refutá-los. Em vez disso, vamos nos concentrar em outras questões que preocupam a maioria dos usuários de bancos de dados: paridade e facilidade de uso.
Nós avaliamos o Cloud Spanner como uma substituição do Sharded MySQL
Google Cloud SQL e Amazon AWS RDS, que são os dois sistemas de gerenciamento de banco de dados OLTP mais populares no mercado de nuvem, possuem um conjunto muito abrangente de recursos. No entanto, para escalar esses bancos de dados além do tamanho de um único nó, você precisará implementar a segmentação das aplicações. Essa abordagem cria complexidade adicional tanto para as aplicações quanto para a administração. Analisamos como o Spanner se encaixa no cenário de unir múltiplos segmentos em uma única instância e quais recursos (se existirem) podem precisar ser sacrificados.
Suporte a SQL, DML e DDL, além de conector e bibliotecas?
Primeiramente, ao iniciar com qualquer banco de dados, é necessário criar um modelo de dados. Se você acha que pode conectar o JDBC Spanner ao seu instrumento SQL favorito, descobrirá que pode consultar seus dados por meio dele, mas não pode utilizá-lo para criar tabelas ou realizar alterações (DDL) ou qualquer operação de inserção/atualização/exclusão (DML). O JDBC oficial do Google não suporta nenhuma das duas.
«Atualmente, os drivers não suportam operadores DML ou DDL».
Documentação do Spanner
Com o console GCP a situação não é melhor — você pode enviar apenas consultas SELECT. Felizmente, existe um driver JDBC com suporte a DML e DDL da comunidade, incluindo transações. . Embora este driver seja extremamente útil, a falta de um driver JDBC próprio do Google é surpreendente. Felizmente, o Google oferece suporte bastante amplo a bibliotecas de clientes (com base em gRPC): C#, Go, Java, node.js, PHP, Python e Ruby.
O uso praticamente obrigatório de APIs personalizadas do Cloud Spanner (devido à falta de DDL e DML no JDBC) resulta em algumas limitações para áreas de código relacionadas, como pools de conexões ou frameworks de vinculação de banco de dados (por exemplo, Spring MVC). Geralmente, ao usar JDBC, você pode escolher livremente seu pool de conexões favorito (por exemplo, HikariCP, DBCP, C3PO, etc.), que é testado e funciona bem. No caso de APIs personalizadas do Spanner, devemos confiar em frameworks/pools de vinculação/sessões que criamos nós mesmos.
A construção orientada a chave primária (PK) permite que o Cloud Spanner seja extremamente rápido ao acessar dados através da PK, mas também traz alguns problemas com consultas.
- Você não pode atualizar o valor da chave primária; você deve primeiro excluir o registro com a PK original e inseri-lo novamente com o novo valor. (Isso é semelhante a outros bancos de dados/mecanismos de armazenamento orientados a PK.)
- Qualquer comando UPDATE e DELETE deve especificar a PK na cláusula WHERE, portanto, não pode haver comandos DELETE vazios — sempre deve haver uma subconsulta, por exemplo: UPDATE xxx WHERE id IN (SELECT id FROM table1)
- A ausência de uma opção de auto-incremento ou algo similar que defina a sequência para o campo PK. Para que isso funcione, o valor correspondente deve ser gerado no lado do aplicativo.
Índices secundários?
O Google Cloud Spanner tem suporte integrado a índices secundários. Esta é uma funcionalidade muito interessante, que nem sempre está presente em outras tecnologias. Apache Kudu atualmente não suporta índices secundários, enquanto o Apache HBase não suporta índices diretamente, mas pode adicioná-los através do Apache Phoenix.
Os índices em Kudu e HBase podem ser modelados como uma tabela separada com um conjunto diferente de chaves primárias, mas a atomicidade das operações realizadas com a tabela pai e as tabelas de índice associadas deve ser tratada no nível do aplicativo e não é trivial em uma implementação correta.
Como mencionado na revisão do Cloud Spanner, seus índices podem ser diferentes dos índices do MySQL. Portanto, deve-se ter especial cuidado ao construir consultas e profilá-las, para garantir o uso do índice adequado onde necessário.
Visões?
Um objeto muito popular e útil em bancos de dados são as visões. Elas podem ser úteis para uma grande variedade de casos de uso; meus dois favoritos são o nível de abstração lógica e o nível de segurança. Infelizmente, o Cloud Spanner NÃO suporta visões. No entanto, isso nos limita apenas em parte, pois não há detalhamento de permissões de acesso no nível de coluna, onde visões podem ser uma solução aceitável.
Na documentação do Cloud Spanner, na seção que descreve quotas e limitações (), há uma, em particular, que pode ser problemática para algumas aplicações: o Cloud Spanner, por padrão, tem um limite de no máximo 100 bancos de dados por instância. É evidente que isso pode se tornar um sério obstáculo para um banco de dados projetado para escalar para mais de 100 bancos de dados. Felizmente, após conversar com nosso representante técnico da Google, descobrimos que esse limite pode ser aumentado praticamente para qualquer valor por meio do suporte da Google.
Suporte ao desenvolvimento?
O Cloud Spanner oferece um suporte bastante decente para linguagens de programação que trabalham com sua API. As bibliotecas oficialmente suportadas estão nas áreas de C#, Go, Java, node.js, PHP, Python e Ruby. A documentação é suficientemente detalhada, mas, assim como em outras tecnologias de ponta, a comunidade é bastante pequena em comparação com as tecnologias de banco de dados mais populares, o que pode levar a um aumento no tempo gasto em resolver casos de uso ou problemas menos comuns.
E quanto ao suporte ao desenvolvimento local?
Não encontramos uma maneira de criar uma instância do Cloud Spanner em um ambiente local. O mais próximo que conseguimos foi uma imagem Docker. , que, em princípio, é semelhante, mas na prática é bastante diferente. Por exemplo, o CockroachDB pode utilizar o PostgreSQL JDBC. Visto que o ambiente de desenvolvimento deve ser o mais próximo possível do ambiente de produção, o Cloud Spanner não é ideal, pois é necessário depender de uma instância completa do Spanner. Para economizar custos, você pode optar por uma instância para uma única região.
Suporte à administração?
Criar uma instância do Cloud Spanner é muito simples. Basta escolher entre criar uma instância multirregional ou para uma única região, especificar a(s) região(ões) e o número de nós. Em menos de um minuto, a instância estará em funcionamento e pronta para uso.
Várias métricas básicas estão disponíveis diretamente na página do Spanner no console da Google. Visualizações mais detalhadas estão disponíveis através do Stackdriver, onde você também pode estabelecer limites para métricas e políticas de alerta.
Acesso aos recursos?
MySQL oferece configurações de permissões e papéis de usuários profundas e detalhadas. É fácil configurar o acesso a uma tabela específica ou até mesmo a um subconjunto de suas colunas. O Cloud Spanner utiliza a ferramenta Google Identity & Access Management (IAM), que permite estabelecer políticas e permissões apenas em um nível muito alto. A opção mais detalhada é a permissão no nível do banco de dados, que não se encaixa na maioria dos casos de produção. Essa limitação obriga você a adicionar medidas de segurança adicionais ao seu código, infraestrutura ou a ambos para evitar o uso não autorizado dos recursos do Spanner.
Backups?
Falando de forma simples, não existem backups no Cloud Spanner. Embora as rigorosas exigências do SLA do Google possam garantir que você não perca nenhum dado devido a falhas de hardware ou do banco de dados, erros humanos, defeitos de aplicativos, etc. Todos nós conhecemos a regra: alta disponibilidade não substitui uma estratégia de backup sensata. Até agora, a única maneira de fazer backup dos dados é transmiti-los programaticamente do banco de dados para um ambiente de armazenamento separado.
Desempenho de consultas?
Para carregar dados e testar consultas, usamos o Yahoo! Cloud Serving Benchmark. A tabela abaixo apresenta a carga de trabalho B do YCSB com uma proporção de leitura de 95% e escrita de 5%.
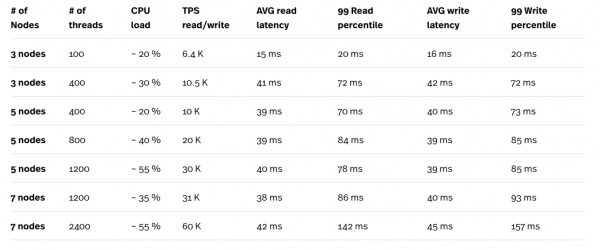
* O teste de carga foi realizado em um Google Compute Engine (CE) n1-standard-32 (32 vCPUs, 120 GB de memória), e a instância de teste nunca foi um gargalo nos testes.
** O número máximo de threads em uma instância do YCSB é de 400. Foi necessário executar seis instâncias paralelas dos testes do YCSB para obter um total de 2400 threads.
Observando os resultados dos testes, especialmente a combinação de carga na CPU e TPS, vemos claramente que o Cloud Spanner se escala muito bem. A alta carga gerada por um grande número de threads é compensada por um maior número de nós no cluster do Cloud Spanner. Embora a latência pareça bastante alta, especialmente ao trabalhar com 2400 threads, testes adicionais com 6 instâncias menores do mecanismo computacional podem ser necessários para obter números mais precisos. Cada instância executará um teste YCSB em vez de uma única grande instância CE com 6 testes em paralelo. Dessa forma, será mais fácil distinguir entre as latências de solicitação do Cloud Spanner e as latências introduzidas pela conexão de rede entre o Cloud Spanner e a instância CE onde o teste é executado.
Como o Cloud Spanner se sai como OLAP?
Particionamento?
Dividir dados em segmentos físicos e/ou logicamente independentes, chamados de partições, é um conceito muito popular presente na maioria dos mecanismos OLAP. As partições podem melhorar significativamente o desempenho das consultas e a manutenção do banco de dados. Um aprofundamento adicional nas partições exigiria um artigo (ou artigos) separado(s), por isso vamos apenas mencionar a importância de ter um esquema de particionamento e subparticionamento. A capacidade de dividir dados em partições e até mesmo em subpartições é fundamental para o desempenho das consultas analíticas.
O Cloud Spanner não suporta partições como tais. Ele divide os dados internamente em chamadas split-s com base em intervalos de chave primária. A divisão é feita automaticamente para balancear a carga no cluster do Cloud Spanner. Uma função muito conveniente do Cloud Spanner é a divisão da carga base da tabela pai (a tabela que não é alternada por outra). O Spanner identifica automaticamente se split os dados são lidos com mais frequência do que os dados em outras split-s e pode decidir sobre uma nova divisão. Assim, mais nós podem ser envolvidos na consulta, aumentando efetivamente a largura de banda.
Carga de dados?
O método Cloud Spanner para grandes volumes de dados é o mesmo que para um carregamento normal. Para alcançar o máximo desempenho, você deve seguir algumas recomendações, incluindo:
- Classifique seus dados pela chave primária.
- Divida-os em 10*nós distintos. seções separadas.
- Crie um conjunto de tarefas de trabalho que carreguem dados em paralelo.
Com esse tipo de carregamento de dados, todos os nós do Cloud Spanner são utilizados.
Utilizamos a carga de trabalho A YCSB para gerar um conjunto de dados de 10M de linhas.
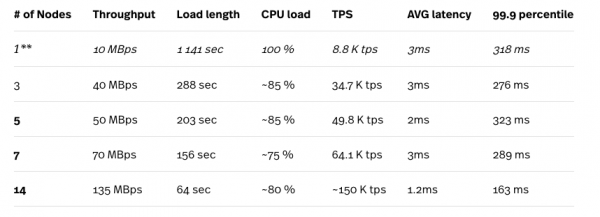
* O teste de carga foi realizado em uma instância n1-standard-32 (32 vCPUs, 120 GB de RAM), e a instância de teste nunca foi um gargalo nos testes.
** A configuração de 1 nó não é recomendada para qualquer carga de produção.
Como mencionado anteriormente, o Cloud Spanner lida automaticamente com divisões com base em sua carga, portanto, os resultados melhoram após várias execuções consecutivas do teste. Os resultados apresentados aqui são os melhores que obtivemos. Observando os números acima, podemos ver como o Cloud Spanner (bem) escala com o aumento do número de nós no cluster. Os números que se destacam representam médias de latência extremamente baixas, que contrastam com os resultados de cargas de trabalho mistas (95% leitura e 5% gravação), conforme descrito na seção acima.
Escalonamento?
Aumentar e diminuir o número de nós do Cloud Spanner é uma tarefa realizada com um clique. Se você deseja carregar dados rapidamente, pode considerar aumentar a instância ao máximo (no nosso caso, foram 25 nós na região US-EAST), e depois reduzir o número de nós adequado para sua carga normal, após todos os dados estarem no banco de dados, considerando o limite de 2 TB/nó.
Fomos lembrados desse limite mesmo com um banco de dados muito menor. Após várias execuções de testes de carga, nosso banco de dados tinha cerca de 155 GB, e ao reduzir para uma instância de 1 nó, recebemos o seguinte erro:
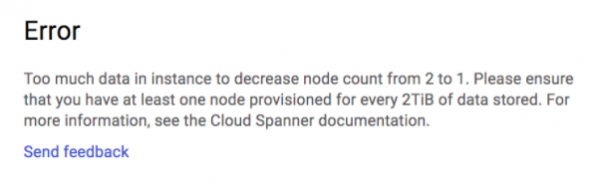
Conseguimos diminuir o scale de 25 para 2 instâncias, mas ficamos presos em dois nós.
Aumentar e diminuir o número de nós no cluster Cloud Spanner pode ser automatizado através da REST API. Isso pode ser especialmente útil para aliviar a carga elevada no sistema durante horários de pico.
Desempenho de consultas OLAP?
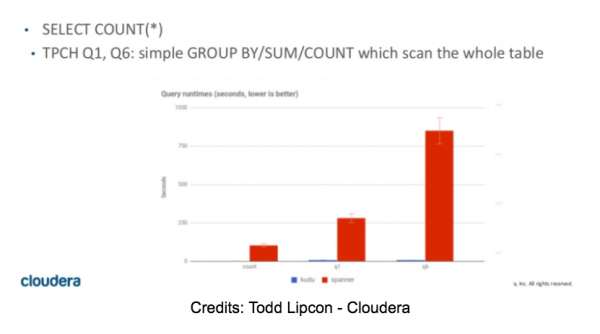
Inicialmente, planejamos dedicar um tempo considerável à nossa avaliação do Spanner nessa parte. Após algumas consultas SELECT COUNT, percebemos imediatamente que o teste seria breve e que o Spanner NÃO seria adequado como motor OLAP. Independentemente do número de nós no cluster, a simples consulta da contagem de linhas em uma tabela de 10M de linhas levou de 55 a 60 segundos. Além disso, qualquer consulta que exigisse mais memória para armazenar resultados intermediários falhou com erro OOM.
SELECT COUNT(DISTINCT(field0)) FROM usertable; — (10M valores distintos) -> SpoolingHashAggregateIterator ficou sem memória durante nova linha.
Alguns números para consultas TPC-H podem ser encontrados no artigo de Todd Lipkon , slides 42 e 43. Esses números estão em conformidade com nossos próprios resultados (infelizmente).
4. Nossas conclusões
Dada a condição atual dos recursos do Cloud Spanner, é difícil imaginar sua simples substituição por uma solução OLTP existente, especialmente quando suas necessidades superarem as dele. Seria necessário gastar um tempo considerável para construir uma solução que levasse em conta as deficiências do Cloud Spanner.
Quando começamos a avaliar o Cloud Spanner, esperávamos que suas funcionalidades de gerenciamento estivessem à altura ou, pelo menos, não muito distantes de outras soluções Google SQL. Mas ficamos surpresos com a total falta de backups e controle de acesso muito limitado aos recursos. Sem falar na ausência de visualizações, falta de ambiente de desenvolvimento local, sequências não suportadas, JDBC sem suporte a DML e DDL e assim por diante.
Então, para onde ir para quem precisa escalar um banco de dados transacional? Parece que, no mercado, ainda não há uma única solução que sirva para todos os casos de uso. Existem várias soluções de código fechado e aberto (algumas das quais são mencionadas neste artigo), cada uma com seus pontos fortes e fracos, mas nenhuma delas oferece um SaaS com SLA de 99,999% e alta consistência. Se um alto nível de SLA é seu principal objetivo, e você não está inclinado a construir sua própria solução para múltiplos ambientes de nuvem, o Cloud Spanner pode ser a solução que você procura. Mas você deve estar ciente de todas as suas limitações.
Para ser justo, deve-se notar que o Cloud Spanner foi lançado para acesso público apenas na primavera de 2017, então é razoável esperar que algumas de suas atuais desvantagens possam eventualmente desaparecer (tomara), e quando isso acontecer, isso pode mudar o jogo. Afinal, o Cloud Spanner não é apenas um projeto de terceiro para o Google. O Google o utiliza como base para outros produtos do Google. E quando o Google recentemente substituiu o Megastore no Google Cloud Storage pelo Cloud Spanner, isso permitiu que o Google Cloud Storage se tornasse estritamente consistente para listagens de objetos em escala global (o que ainda não se aplica ao ).
Então, ainda há esperança... nós também esperamos.
E é tudo por agora. Assim como o autor do artigo, nós também continuamos a ter esperanças, e o que você pensa sobre isso? Deixe um comentário
Todos estão convidados a visitar nosso onde detalharemos o curso da OTUS.
Fonte: habr.com
