

Prefácio ou como surgiu a ideia de particionamento
O início da história aqui: Depois que quase todos os recursos para otimização da consulta, naquele momento, foram esgotados, surgiu a pergunta – e agora, o que fazer? Assim surgiu a ideia do particionamento.
Uma digressão lírica:
Exatamente 'naquele momento', porque . Obrigado e Habr!
Então, como mais podemos deixar o cliente aparentemente feliz, enquanto aprimoramos nossas próprias habilidades?
Se quisermos simplificar ao máximo, então, as maneiras de melhorar algo radicalmente na performance do banco de dados são apenas duas:
1) Caminho extensivo — aumentamos recursos, modificamos a configuração;
2) Caminho intensivo — otimizamos as consultas
Como já mencionei, naquele momento não estava claro o que mais mudar na consulta para acelerar, foi escolhido o caminho — mudanças no design das tabelas.
Então — surge a questão principal — o que e como vamos mudar?
Condições iniciais
Primeiro, temos este ERD (mostrado de forma simplificada):
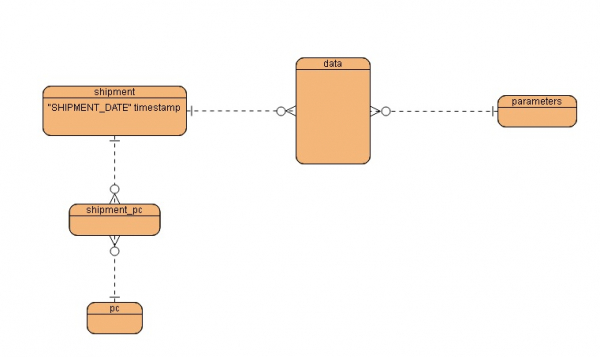
Principais características:
- relações 'muitos para muitos'
- a tabela já tem uma chave potencial de particionamento
Consulta original:
SELECT
            p."PARAMETER_ID" as parameter_id,
            pc."PC_NAME" AS pc_name,
            pc."CUSTOMER_PARTNUMBER" AS customer_partnumber,
            w."LASERMARK" AS lasermark,
            w."LOTID" AS lotid,
            w."REPORTED_VALUE" AS reported_value,
            w."LOWER_SPEC_LIMIT" AS lower_spec_limit,
            w."UPPER_SPEC_LIMIT" AS upper_spec_limit,
            p."TYPE_CALCUL" AS type_calcul,
            s."SHIPMENT_NAME" AS shipment_name,
            s."SHIPMENT_DATE" AS shipment_date,
            extract(year from s."SHIPMENT_DATE") AS year,
            extract(month from s."SHIPMENT_DATE") as month,
            s."REPORT_NAME" AS report_name,
            p."SPARAM_NAME" AS SPARAM_name,
            p."CUSTOMERPARAM_NAME" AS customerparam_name
        FROM data w INNER JOIN shipment s ON s."SHIPMENT_ID" = w."SHIPMENT_ID"
             INNER JOIN parameters p ON p."PARAMETER_ID" = w."PARAMETER_ID"
             INNER JOIN shipment_pc sp ON s."SHIPMENT_ID" = sp."SHIPMENT_ID"
             INNER JOIN pc pc ON pc."PC_ID" = sp."PC_ID"
             INNER JOIN ( SELECT w2."LASERMARK" , MAX(s2."SHIPMENT_DATE") AS "SHIPMENT_DATE"
                          FROM shipment s2 INNER JOIN data w2 ON s2."SHIPMENT_ID" = w2."SHIPMENT_ID"
                          GROUP BY w2."LASERMARK"
                         ) md ON md."SHIPMENT_DATE" = s."SHIPMENT_DATE" AND md."LASERMARK" = w."LASERMARK"
        WHERE
             s."SHIPMENT_DATE" >= '2018-07-01' AND s."SHIPMENT_DATE" <= '2018-09-30' ;
Resultados da execução na base de dados de teste:
Custo : 502 997.55
Tempo de execução: 505 segundos.
O que vemos? Uma consulta comum, por recorte temporal.
Fazemos uma suposição lógica simples: se há uma amostra de um intervalo de tempo, isso nos ajuda? Certo — partição.
O que particionar?
À primeira vista, a escolha é óbvia — partição declarativa da tabela "shipment" pela chave "SHIPMENT_DATE" (adiantando um pouco — no final, em produção, não deu bem assim).
Como particionar?
Essa pergunta também não é muito difícil. Felizmente, no PostgreSQL 10, agora há um mecanismo de partição acessível.
Então:
- Salvamos o dump da tabela original — pg_dump source_table
- Deletamos a tabela original — drop table source_table
- Criamos a tabela pai com partição por intervalo — create table source_table
- Criamos as seções — create table source_table, create index
- Importamos o dump criado na etapa 1 — pg_restore
Scripts para partição
Para simplificar e facilitar, as etapas 2, 3 e 4 foram unidas em um único script.
Então:
Salvamos o dump da tabela original
pg_dump postgres --file=\/dump\/shipment.dmp --format=c --table=shipment --verbose > \/dump\/shipment.log 2>&1Deletamos a tabela original + Criamos a tabela pai com partição por intervalo + Criamos as seções
--create_partition_shipment.sql
do language plpgsql $$
declare
rec_shipment_date RECORD ;
partition_name varchar;
index_name varchar;
current_year varchar ;
current_month varchar ;
begin_year varchar ;
begin_month varchar ;
next_year varchar ;
next_month varchar ;
first_flag boolean ;
i integer ;
begin
  RAISE NOTICE 'CRIAR TABELA TEMPORÁRIA PARA DATA_DE_ENVIO';
  CREATE TEMP TABLE tmp_shipment_date as select distinct "SHIPMENT_DATE" from shipment order by "SHIPMENT_DATE" ;

  RAISE NOTICE 'DROPAR TABELA shipment';
  drop table shipment cascade ;

  CREATE TABLE public.shipment
  (
    "SHIPMENT_ID" integer NOT NULL DEFAULT nextval('shipment_shipment_id_seq'::regclass),
    "SHIPMENT_NAME" character varying(30) COLLATE pg_catalog."default",
    "SHIPMENT_DATE" timestamp without time zone,
    "REPORT_NAME" character varying(40) COLLATE pg_catalog."default"
  )
  PARTITION BY RANGE ("SHIPMENT_DATE")
  WITH (
      OIDS = FALSE
  )
  TABLESPACE pg_default;

  RAISE NOTICE 'CRIAR PARTIÇÕES PARA A TABELA shipment';

  current_year:='0';
  current_month:='0';

  begin_year := '0' ;
  begin_month := '0'  ;
  next_year := '0' ;
  next_month := '0'  ;

  FOR rec_shipment_date IN SELECT * FROM tmp_shipment_date LOOP

      RAISE NOTICE 'SHIPMENT_DATE=%',rec_shipment_date."SHIPMENT_DATE";

      current_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE");
      current_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE") ;

      IF to_number(current_month,'99') = to_date( begin_year||'.'||begin_month, 'YYYY.MM') AND
         to_date( current_year||'.'||current_month, 'YYYY.MM') < to_date( next_year||'.'||next_month, 'YYYY.MM') AND
         NOT first_flag
      THEN
         CONTINUE ;
      ELSE
       --NOVOS limites apenas para a segunda vez e depois
       begin_year := current_year ;
       begin_month := current_month ;

        IF current_month = '12' THEN
          next_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 year') ;
        ELSE
          next_year := current_year ;
        END IF;

       next_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 month') ;

      END IF;

      partition_name := 'shipment_shipment_date_'||begin_year||'-'||begin_month||'-01-'|| next_year||'-'||next_month||'-01'  ;

     EXECUTE format('CREATE TABLE ' || quote_ident(partition_name) || ' PARTITION OF shipment FOR VALUES FROM ( %L ) TO ( %L )  ' , current_year||'-'||current_month||'-01' , next_year||'-'||next_month||'-01'  ) ;

      index_name := partition_name||'_shipment_id_idx';
      RAISE NOTICE 'NOME DO ÍNDICE =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID") TABLESPACE pg_default ' ) ;

      --Remove a marca da primeira vez
      first_flag := false ;

  END LOOP;

end
$$;
Importando dump
pg_restore -d postgres --data-only --format=c --table=shipment --verbose shipment.dmp > /tmp/data_dump/shipment_restore.log 2>&1Verificando os resultados da partição
O que temos, então, como resultado? O texto completo do plano é extenso e maçante, portanto, é possível se limitar aos números finais.
Foi
Custo: 502 997.55
Tempo de execução: 505 segundos.
Tornou-se
Custo: 77 872.36
Tempo de execução: 79 segundos.
Um bom resultado. Reduzimos o custo e o tempo de execução. Assim, o uso de particionamento traz o efeito esperado e, de modo geral, sem surpresas.
Alegrar o cliente
Os resultados dos testes foram apresentados ao cliente para consideração. E após a revisão, ele deu um veredicto um tanto inesperado: "Ótimo, particione a tabela 'data'."
Sim, mas nós pesquisamos uma tabela completamente diferente, 'shipment', a tabela 'data' não possui o campo 'SHIPMENT_DATE'.
Sem problemas, adicione e altere. O principal é que o cliente esteja satisfeito com o que resultará, os detalhes da implementação não são tão importantes.
Particionamos a tabela principal 'data'
Na verdade, não houve dificuldades especiais. Embora, o algoritmo de particionamento tenha mudado um pouco.
Adicionando a coluna 'SHIPMENT_DATA' à tabela 'data'
psql -h host -U banco -d usuário
=> ALTER TABLE data ADD COLUMN "SHIPMENT_DATE" timestamp without time zone ;
Preenchendo os valores da coluna 'SHIPMENT_DATA' na tabela 'data' com os valores da coluna homônima da tabela 'shipment'
-----------------------------
--update_data.sql
--atualizando a tabela "data" alterada para os valores de "shipment_data" da tabela "shipment"
--versão 1.0
do language plpgsql $$
declare
rec_shipment_data RECORD ;
shipment_date timestamp without time zone ;
row_count integer ;
total_rows integer ;
begin

  select count(*) into total_rows from shipment ;
  RAISE NOTICE 'Total %',total_rows;
  row_count:= 0 ;

  FOR rec_shipment_data IN SELECT * FROM shipment LOOP

   update data set "SHIPMENT_DATE" = rec_shipment_data."SHIPMENT_DATE" where "SHIPMENT_ID" = rec_shipment_data."SHIPMENT_ID";

   row_count:=  row_count +1 ;
   RAISE NOTICE 'contagem de linhas = % , de %',row_count,total_rows;
  END LOOP;

end
$$;
Salvando o dump da tabela 'data'
pg_dump postgres --file=\/dump\/data.dmp --format=c --table=data --verbose > \/dump\/data.log 2>&1<\/sourceReconstruindo a tabela particionada 'data'
--create_partition_data.sql
--criar partições para a tabela "wafer data" pela coluna de intervalo "shipment_data" com duração de um mês
--versão 1.0
do language plpgsql $$
declare
rec_shipment_date RECORD ;
partition_name varchar;
index_name varchar;
current_year varchar ;
current_month varchar ;
begin_year varchar ;
begin_month varchar ;
next_year varchar ;
next_month varchar ;
first_flag boolean ;
i integer ;

begin

  RAISE NOTICE 'CRIAR TABELA TEMPORÁRIA PARA SHIPMENT_DATE';
  CREATE TEMP TABLE tmp_shipment_date as select distinct "SHIPMENT_DATE" from shipment order by "SHIPMENT_DATE" ;


  RAISE NOTICE 'CANCELAR TABELA data';
  drop table data cascade ;


  RAISE NOTICE 'CRIAR TABELA PARTICIONADA data';

  CREATE TABLE public.data
  (
    "RUN_ID" integer,
    "LASERMARK" character varying(20) COLLATE pg_catalog."default" NOT NULL,
    "LOTID" character varying(80) COLLATE pg_catalog."default",
    "SHIPMENT_ID" integer NOT NULL,
    "PARAMETER_ID" integer NOT NULL,
    "INTERNAL_VALUE" character varying(75) COLLATE pg_catalog."default",
    "REPORTED_VALUE" character varying(75) COLLATE pg_catalog."default",
    "LOWER_SPEC_LIMIT" numeric,
    "UPPER_SPEC_LIMIT" numeric ,
    "SHIPMENT_DATE" timestamp without time zone
  )
  PARTITION BY RANGE ("SHIPMENT_DATE")
  WITH (
    OIDS = FALSE
  )
  TABLESPACE pg_default ;


  RAISE NOTICE 'CRIAR PARTIÇÕES PARA A TABELA data';

  current_year:='0';
  current_month:='0';

  begin_year := '0' ;
  begin_month := '0'  ;
  next_year := '0' ;
  next_month := '0'  ;
  i := 1;

  FOR rec_shipment_date IN SELECT * FROM tmp_shipment_date LOOP

      RAISE NOTICE 'SHIPMENT_DATE=%',rec_shipment_date."SHIPMENT_DATE";

      current_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE");
      current_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE") ;

      --Iniciar limites
      IF   begin_year = '0' THEN
       RAISE NOTICE '***Iniciar limites';
       first_flag := true ; --flag da primeira vez
       begin_year := current_year ;
       begin_month := current_month ;

        IF current_month = '12' THEN
          next_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 year') ;
        ELSE
          next_year := current_year ;
        END IF;

       next_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 month') ;

      END IF;

--      RAISE NOTICE 'current_year=% , current_month=% ',current_year,current_month;
--      RAISE NOTICE 'begin_year=% , begin_month=% ',begin_year,begin_month;
--      RAISE NOTICE 'next_year=% , next_month=% ',next_year,next_month;

      -- Verificar a data atual nos limites NÃO para a Primeira vez

      RAISE NOTICE 'Dados atuais = %',to_char( to_date( current_year||'.'||current_month, 'YYYY.MM'), 'YYYY.MM');
      RAISE NOTICE 'Dados Iniciais = %',to_char( to_date( begin_year||'.'||begin_month, 'YYYY.MM'), 'YYYY.MM');
      RAISE NOTICE 'Próximos dados = %',to_char( to_date( next_year||'.'||next_month, 'YYYY.MM'), 'YYYY.MM');

      IF to_date( current_year||'.'||current_month, 'YYYY.MM') >= to_date( begin_year||'.'||begin_month, 'YYYY.MM') AND
         to_date( current_year||'.'||current_month, 'YYYY.MM') < to_date( next_year||'.'||next_month, 'YYYY.MM') AND
         NOT first_flag
      THEN
         RAISE NOTICE '***CONTINUAR';
         CONTINUE ;
      ELSE
       --NOVOS limites apenas para a segunda vez e seguintes
       RAISE NOTICE '***NOVOS LIMITES';
       begin_year := current_year ;
       begin_month := current_month ;

        IF current_month = '12' THEN
          next_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 year') ;
        ELSE
          next_year := current_year ;
        END IF;

       next_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 month') ;


      END IF;

      IF to_number(current_month,'99') < 10 THEN
        current_month := '0'||current_month ;
      END IF ;

      IF to_number(begin_month,'99') < 10 THEN
        begin_month := '0'||begin_month ;
      END IF ;

      IF to_number(next_month,'99') < 10 THEN
        next_month := '0'||next_month ;
      END IF ;

      RAISE NOTICE 'current_year=% , current_month=% ',current_year,current_month;
      RAISE NOTICE 'begin_year=% , begin_month=% ',begin_year,begin_month;
      RAISE NOTICE 'next_year=% , next_month=% ',next_year,next_month;

      partition_name := 'data_'||begin_year||begin_month||'01_'||next_year||next_month||'01'  ;

      RAISE NOTICE 'NÚMERO DA PARTIÇÃO % , NOME DA TABELA =%',i , partition_name;

      EXECUTE format('CREATE TABLE ' || quote_ident(partition_name) || ' PARTITION OF data FOR VALUES FROM ( %L ) TO ( %L )  ' , begin_year||'-'||begin_month||'-01' , next_year||'-'||next_month||'-01'  ) ;

      index_name := partition_name||'_shipment_id_parameter_id_idx';
      RAISE NOTICE 'NOME DO ÍNDICE =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID", "PARAMETER_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_lasermark_idx';
      RAISE NOTICE 'NOME DO ÍNDICE =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("LASERMARK" COLLATE pg_catalog."default") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_shipment_id_idx';
      RAISE NOTICE 'NOME DO ÍNDICE =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_parameter_id_idx';
      RAISE NOTICE 'NOME DO ÍNDICE =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("PARAMETER_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_shipment_date_idx';
      RAISE NOTICE 'NOME DO ÍNDICE =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_DATE") TABLESPACE pg_default ' ) ;

      --Cancelar flag da primeira vez
      first_flag := false ;

  END LOOP;
end
$$;
Estamos carregando o dump criado na etapa 3.
pg_restore -h host -u usuário -d banco --data-only --format=c --table=data --verbose data.dmp > data_restore.log 2>&1Criamos uma seção separada para dados antigos
---------------------------------------------------
--create_partition_for_old_dates.sql
--criar partições para manter dates antigos
--versão 1.0
do language plpgsql $$
declare
rec_shipment_date RECORD;
partition_name varchar;
index_name varchar;

begin

      SELECT min("SHIPMENT_DATE") AS min_date INTO rec_shipment_date from data;

      RAISE NOTICE 'A data antiga é %', rec_shipment_date.min_date;

      partition_name := 'data_old_dates';

      RAISE NOTICE 'NOME DA PARTIÇÃO É %', partition_name;

      EXECUTE format('CREATE TABLE ' || quote_ident(partition_name) || ' PARTITION OF data FOR VALUES FROM (%L) TO (%L)', '1900-01-01',
              to_char(rec_shipment_date.min_date, 'YYYY') || '-' || to_char(rec_shipment_date.min_date, 'MM') || '-01');

      index_name := partition_name || '_shipment_id_parameter_id_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("SHIPMENT_ID", "PARAMETER_ID") TABLESPACE pg_default');

      index_name := partition_name || '_lasermark_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("LASERMARK" COLLATE pg_catalog."default") TABLESPACE pg_default');

      index_name := partition_name || '_shipment_id_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("SHIPMENT_ID") TABLESPACE pg_default');

      index_name := partition_name || '_parameter_id_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("PARAMETER_ID") TABLESPACE pg_default');

      index_name := partition_name || '_shipment_date_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("SHIPMENT_DATE") TABLESPACE pg_default');

end
$$;
Resultados finais:
Foi
Custo: 502 997.55
Tempo de execução: 505 segundos.
Tornou-se
Custo: 68 533.70
Tempo de execução: 69 segundos
Digno, bastante digno. E considerando que ao longo do caminho conseguimos entender razoavelmente o mecanismo de particionamento no PostgreSQL 10 — Um ótimo resultado.
Um desvio lírico
E é possível fazer ainda melhor — SIM, É POSSÍVEL!Para isso, precisamos usar VIEW MATERIALIZADA.
CREATE MATERIALIZED VIEW LASERMARK_VIEW
CREATE MATERIALIZED VIEW LASERMARK_VIEW
AS
SELECT w."LASERMARK", MAX(s."SHIPMENT_DATE") AS "SHIPMENT_DATE"
FROM shipment s INNER JOIN data w ON s."SHIPMENT_ID" = w."SHIPMENT_ID"
GROUP BY w."LASERMARK";

CREATE INDEX lasermark_vw_shipment_date_ind on lasermark_view USING btree ("SHIPMENT_DATE") TABLESPACE pg_default;
analyze lasermark_view;
Mais uma vez, reescrevemos a consulta:
Consulta utilizando view materializada
SELECIONE
            p."PARAMETER_ID" como parameter_id,
            pc."PC_NAME" como pc_name,
            pc."CUSTOMER_PARTNUMBER" como customer_partnumber,
            w."LASERMARK" como lasermark,
            w."LOTID" como lotid,
            w."REPORTED_VALUE" como reported_value,
            w."LOWER_SPEC_LIMIT" como lower_spec_limit,
            w."UPPER_SPEC_LIMIT" como upper_spec_limit,
            p."TYPE_CALCUL" como type_calcul,
            s."SHIPMENT_NAME" como shipment_name,
            s."SHIPMENT_DATE" como shipment_date,
            extrair(ano de s."SHIPMENT_DATE") como year,
            extrair(mês de s."SHIPMENT_DATE") como month,
            s."REPORT_NAME" como report_name,
            p."STC_NAME" como STC_name,
            p."CUSTOMERPARAM_NAME" como customerparam_name
        DA dados w INTERNO JUNTE-se ao embarque s ON s."SHIPMENT_ID" = w."SHIPMENT_ID"
             INTERNO JUNTE-se aos parâmetros p ON p."PARAMETER_ID" = w."PARAMETER_ID"
             INTERNO JUNTE-se ao embarque_pc sp ON s."SHIPMENT_ID" = sp."SHIPMENT_ID"
             INTERNO JUNTE-se ao pc pc ON pc."PC_ID" = sp."PC_ID"
             INTERNO JUNTE-se ao LASERMARK_VIEW md ON md."SHIPMENT_DATE" = s."SHIPMENT_DATE" E md."LASERMARK" = w."LASERMARK"
        ONDE
              s."SHIPMENT_DATE" >= '2018-07-01' E s."SHIPMENT_DATE" <= '2018-09-30';
E obtemos mais um resultado:
Foi
Custo: 502 997.55
Tempo de execução: 505 segundos
Tornou-se
Custo: 42 481.16
Tempo de execução: 43 segundos.
Embora, claro, um resultado tão promissor seja enganoso, é preciso atualizar as representações. Portanto, o tempo final de obtenção de dados não ajudará muito. Mas como experimento, é bastante interessante.
Na verdade, como se revelou, mais uma vez obrigado e ao Habr !-
Epílogo
Então, o cliente está satisfeito. E é necessário aproveitar a situação.
Nova tarefa: O que pode ser pensado para aprofundar e expandir?
E aqui vem à mente — pessoal, não temos monitoramento de nossos bancos de dados PostgreSQL.
Colocando a mão no coração, existe algum monitoramento em forma de Cloud Watch na AWS. Mas qual é a utilidade desse monitoramento para um DBA? Praticamente nenhuma.
Se surgiu a chance de fazer algo útil e interessante também para si, não se pode perder tal oportunidade…
POIS
Assim chegamos ao mais interessante:
3 de Dezembro de 2018.
Decisão de iniciar trabalhos para investigar as possibilidades existentes de monitoramento de desempenho de consultas PostgreSQL.
Mas isso já é uma história totalmente diferente.
Continua, a seguir…
Fonte: habr.com
