

Vamos examinar o funcionamento do Zabbix com o banco de dados TimescaleDB como backend. Vamos mostrar como configurar do zero e como migrar do PostgreSQL. Também apresentaremos testes comparativos de desempenho de duas configurações.
HighLoad++ Sibéria 2019. Sala "Tomsk". 24 de junho, 16:00. Resumos e . A próxima conferência HighLoad++ ocorrerá nos dias 6 e 7 de abril de 2020 em São Petersburgo. Detalhes e ingressos .
Andrei Gushchin (daqui em diante – AG): – Eu sou engenheiro de suporte técnico do ZABBIX (daqui em diante – "Zabbix"), treinador. Trabalho há mais de 6 anos no suporte técnico e já enfrentei questões de desempenho. Hoje, vou falar sobre o desempenho que o TimescaleDB pode oferecer em comparação com o PostgreSQL 10. Também farei uma introdução sobre como isso funciona.
Os principais desafios de desempenho: da coleta à limpeza de dados
Começaremos com o fato de que existem certos desafios de desempenho que cada sistema de monitoramento enfrenta. O primeiro desafio de desempenho é a coleta e processamento rápidos de dados.
Um bom sistema de monitoramento deve receber todos os dados de forma ágil, processá-los de acordo com expressões de gatilho, ou seja, processá-los com base em certos critérios (que variam de sistema para sistema) e armazená-los em um banco de dados, para que esses dados possam ser utilizados posteriormente.
O segundo desafio de desempenho é o armazenamento histórico. É preciso armazenar dados no banco de dados e ter acesso rápido e conveniente a essas métricas que foram coletadas em um determinado período de tempo. O mais importante é que esses dados sejam fáceis de obter e possam ser utilizados em relatórios, gráficos, gatilhos, em certos valores de limite, para notificações, etc.
O terceiro desafio de desempenho é a limpeza do histórico, ou seja, quando chega o dia em que você não precisa mais armazenar certas métricas detalhadas que foram coletadas durante 5 anos (ou até mesmo meses ou dois meses). Alguns nós de rede foram removidos, ou alguns hosts, métricas que já não são mais necessárias porque se tornaram obsoletas e deixaram de ser coletadas. Isso tudo precisa ser limpo para que seu banco de dados não cresça de forma descontrolada. E, geralmente, a limpeza do histórico costuma ser um teste sério para o armazenamento – muitas vezes afeta consideravelmente o desempenho.
Como resolver problemas de cache?
Agora vou falar especificamente sobre o Zabbix. No Zabbix, as primeiras e segundas chamadas são resolvidas por meio de cache.
Coleta e processamento de dados – usamos a memória RAM para armazenar todos esses dados. Agora falaremos mais sobre esses dados.
Além disso, do lado do banco de dados, há um certo cache para as principais consultas – para gráficos e outras coisas.
Cache do lado do próprio servidor Zabbix: temos ConfigurationCache, ValueCache, HistoryCache, TrendsCache. O que é isso?
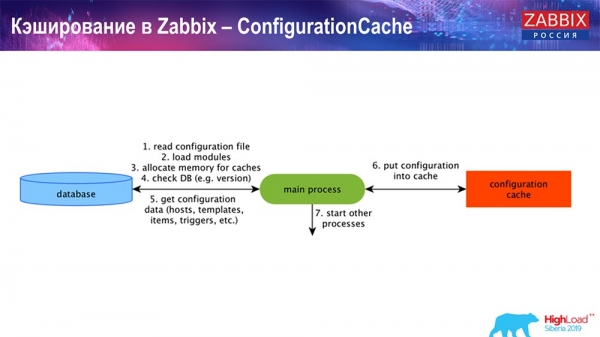
ConfigurationCache – este é o cache principal, onde armazenamos métricas, hosts, itens de dados, gatilhos; tudo o que é necessário para o processamento, coleta de dados, de quais hosts coletar e com que frequência. Tudo isso é mantido no ConfigurationCache para não ter que acessar o banco de dados e evitar consultas desnecessárias. Após a inicialização do servidor, atualizamos esse cache (criamos) e o atualizamos periodicamente (dependendo das configurações).
Cache no Zabbix. Coleta de dados
Aqui o esquema é bastante extenso:
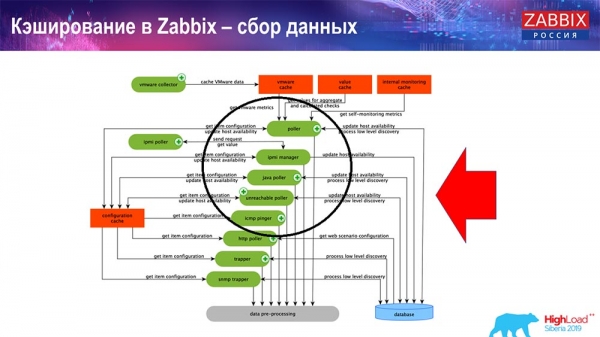
Os principais no esquema são os seguintes coletores:
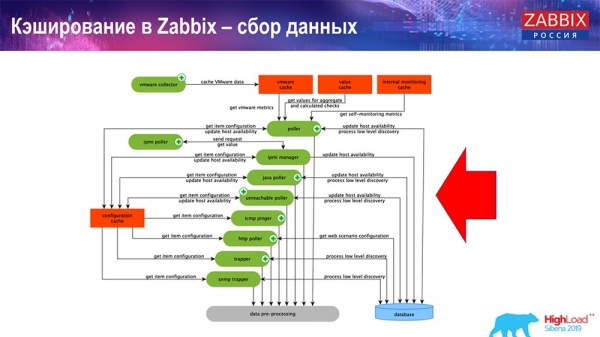
Esses são os próprios processos de coleta, diferentes 'pollers', que são responsáveis por diferentes tipos de coleta. Eles reúnem dados via ICMP, IPMI, por diferentes protocolos e transmitem tudo para o pré-processamento.
PreProcessing HistoryCache
Além disso, se tivermos itens de dados calculados (quem conhece o Zabbix sabe), ou seja, itens de dados agregados, coletamos diretamente do ValueCache. Vou falar sobre como ele é preenchido mais tarde. Todos esses coletores utilizam o ConfigurationCache para obter suas tarefas e depois passam para o pré-processamento.
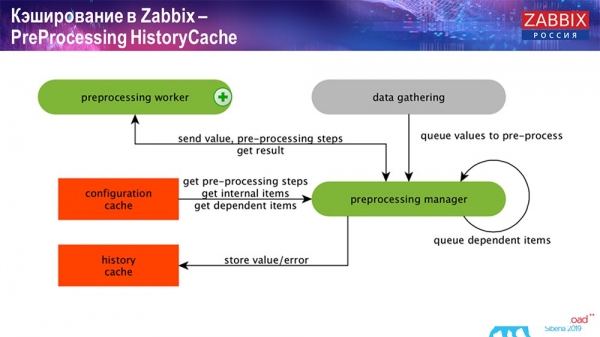
O pré-processamento também usa o ConfigurationCache para obter as etapas de pré-processamento, processando esses dados de várias maneiras. A partir da versão 4.2, isso foi transferido para o proxy. Isso é muito conveniente, pois o próprio pré-processamento é uma operação bastante pesada. E se você tiver um Zabbix muito grande, com muitos itens de dados e alta frequência de coleta, isso facilita bastante o trabalho.
Consequentemente, depois de processarmos esses dados de alguma forma por meio do pré-processamento, salvamos no HistoryCache para que possam ser processados posteriormente. Aqui termina a coleta de dados. Passamos para o processo principal.
Operação do History syncer
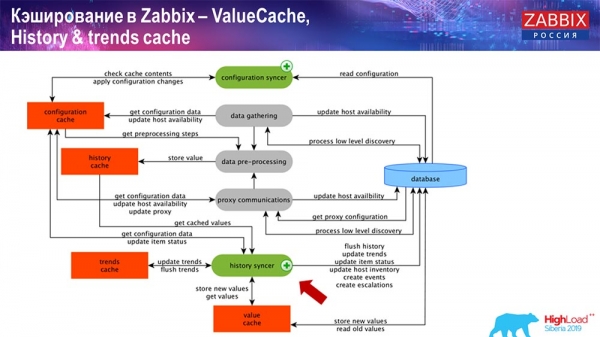
O processo principal no «Zabbix» (já que é uma arquitetura monolítica) é o History syncer. Este é o processo principal que cuida do processamento atômico de cada elemento de dados, ou seja, de cada valor:
- recebe um valor (ele o obtém do HistoryCache);
- verifica no Configuration syncer: se há algum gatilho para cálculo – o calcula;
se houver – cria eventos, cria uma escalonamento para emitir um alerta, se necessário, conforme a configuração; - grava os gatilhos para processamento e agregação posterior; se você agrega pelos últimos horários e assim por diante, esse valor é armazenado no ValueCache, para não consultar a tabela de histórico; dessa forma, o ValueCache é preenchido com os dados necessários para cálculo dos gatilhos, elementos calculáveis etc.;
- em seguida, o History syncer grava todos os dados no banco de dados;
- o banco de dados os grava no disco – neste ponto, o processo de processamento termina.
Bancos de dados. Cache
No lado do banco de dados, quando você quer visualizar gráficos ou relatórios sobre eventos, há vários caches. Mas neste relatório não falarei sobre eles.
Para o MySQL, existe o Innodb_buffer_pool, além de uma série de outros caches que também podem ser configurados.
Mas estes são os principais:
- shared_buffers;
- effective_cache_size;
- shared_pool.
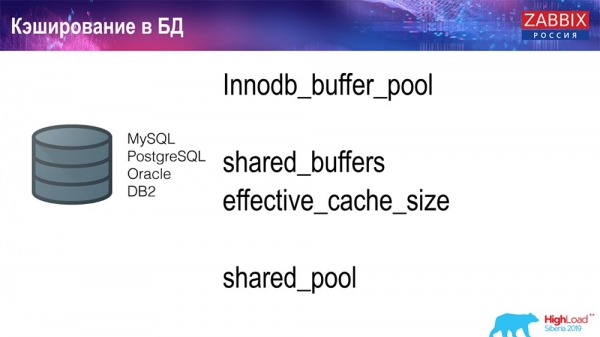
Para todos os bancos de dados, eu mencionei que existem certos caches que permitem manter na memória aqueles dados que são frequentemente necessários para consultas. Eles têm suas próprias tecnologias para isso.
Sobre o desempenho do banco de dados
Consequentemente, existe um ambiente competitivo, ou seja, o servidor «Zabbix» coleta dados e os grava. Ao reiniciar, ele também lê do histórico para preencher o ValueCache e assim por diante. Aqui você pode ter scripts e relatórios que usam a API «Zabbix», que é construída sobre a interface web. A API «Zabbix» entra no BD e obtém os dados necessários para gerar gráficos, relatórios ou algum tipo de lista de eventos, os problemas mais recentes.
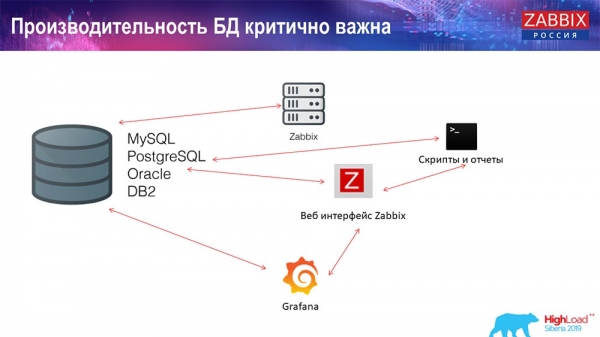
Outra solução muito popular para visualização é o Grafana, que nossos usuários utilizam. Ele pode se conectar diretamente tanto através da API «Zabbix» quanto através do banco de dados. Isso também cria uma certa concorrência para obtenção de dados: é necessária uma configuração mais aprofundada e precisa do banco de dados para garantir uma resposta rápida e testes.
Limpeza de histórico. No Zabbix, existe o Housekeeper
A terceira chamada que é utilizada no 'Zabbix' é a limpeza de histórico através do Housekeeper. O 'Housekeeper' respeita todas as configurações, ou seja, nos itens de dados está especificado quanto deve ser mantido (em dias), quanto manter os dados de tendências e a dinâmica das mudanças.
Eu não falei sobre o TrendCache, que calculamos em tempo real: os dados chegam, os agregamos por uma hora (principalmente são números da última hora), a quantidade média / mínima e gravamos isso uma vez por hora na tabela de dinâmica de mudanças ('Trends'). O 'Housekeeper' é acionado e apaga os dados da DB através de selects comuns, o que nem sempre é eficaz.
Como entender que isso não é eficiente? Você pode ver essa situação nos gráficos de desempenho dos processos internos:
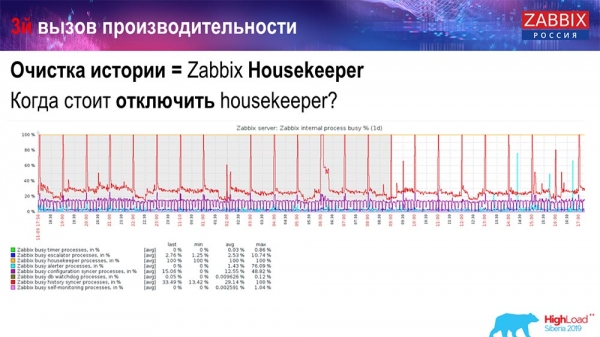
O seu History syncer está constantemente ocupado (gráfico vermelho). E o gráfico 'alaranjado', que vai por cima. Esse é o 'Housekeeper', que é acionado e espera da DB quando ela apagará todas as linhas que ele definiu.
Vamos pegar algum Item ID: precisa apagar os últimos 5 mil; claro, pelos índices. Mas normalmente o dataset é grande o suficiente – o banco de dados ainda lê isso do disco e carrega para o cache, e isso é uma operação muito cara para a DB. Dependendo do seu tamanho, isso pode causar certos problemas de desempenho.
Desativar o 'Housekeeper' pode ser feito de uma maneira simples – temos a interface web familiar. A configuração em Administration general (configurações para o 'Housekeeper') desabilita a manutenção interna para o histórico e tendências. Consequentemente, o 'Housekeeper' não gerencia mais isso:
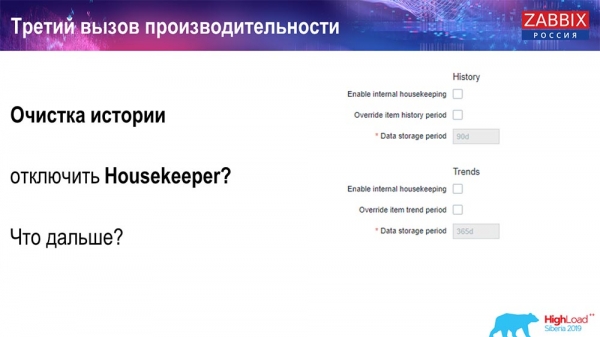
O que se pode fazer a seguir? Você desativou, os seus gráficos se alinharam... Quais podem ser os problemas a partir de agora? O que pode ajudar?
Particionamento
Geralmente isso é configurado em cada banco de dados relacional que mencionei, de várias maneiras. No MySQL há sua própria tecnologia. Mas, em geral, são muito semelhantes ao falar sobre PostgreSQL 10 e MySQL. Claro, existem muitas diferenças internas em como tudo isso é implementado e como isso afeta o desempenho. Mas, de modo geral, a criação de uma nova partição também leva frequentemente a certos problemas.
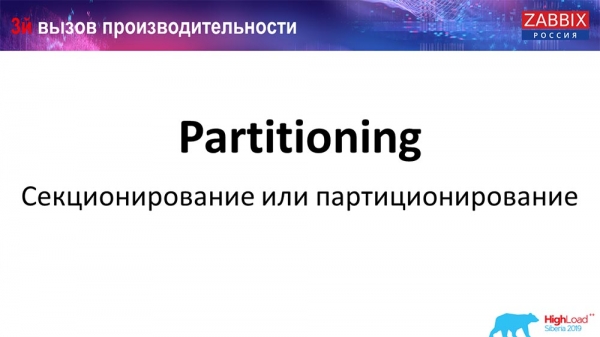
Dependendo da sua configuração (quanto dado é gerado por dia), geralmente estabelece-se o mínimo – que é 1 dia/partição, e para "tendências", dinâmicas de mudanças – 1 mês/nova partição. Isso pode mudar se você tiver uma configuração muito grande.
Deixe-me dizer sobre o tamanho da configuração: até 5 mil novos valores por segundo (nvps) é considerado uma "pequena configuração". Médio – de 5 a 25 mil valores por segundo. Qualquer coisa acima disso já é considerada uma instalação grande ou muito grande, que requer uma configuração muito cuidadosa do banco de dados.
Em instalações muito grandes, 1 dia pode não ser ideal. Eu já vi partições no MySQL de 40 gigabytes por dia (e maiores podem existir). Esse é um volume de dados muito grande, que pode causar alguns problemas. É preciso reduzi-lo.
Por que particionamento é necessário?
O que o particionamento oferece, creio que todos sabem – é a segmentação de tabelas. Muitas vezes, são arquivos separados no disco e consultas span. Ele seleciona mais otimamente uma partição, se isso faz parte do particionamento usual.
Para o ‘Zabbix’, em particular, usa-se por faixa, ou seja, utilizamos timestamp (um número comum, tempo desde o início da época). Você define o início do dia/fim do dia, e isso se torna uma partição. Assim, se você está requisitando dados de dois dias atrás, tudo isso é recuperado do banco de dados mais rapidamente, pois apenas um arquivo precisa ser carregado na cache e entregue (em vez de uma tabela grande).
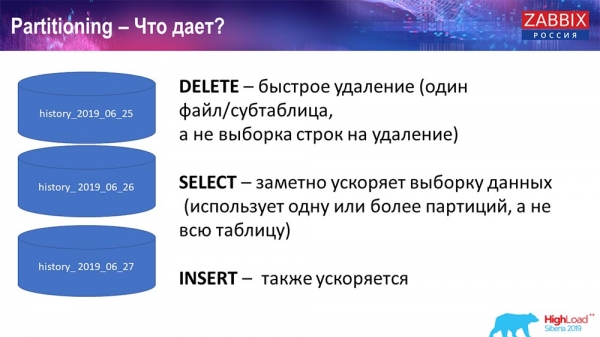
Muitos bancos de dados também aceleram inserções (inserções em uma child-table). Enquanto estou falando de maneira abstrata, isso também é possível. O particionamento muitas vezes ajuda.
Elasticsearch para NoSQL
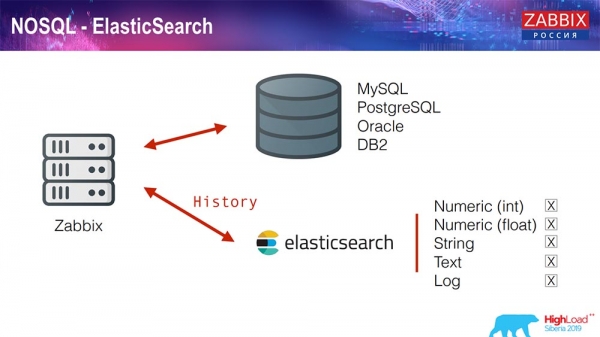
Recentemente, na versão 3.4, implementamos uma solução para NoSQL. Adicionamos a capacidade de escrever no Elasticsearch. Você pode escrever tipos específicos: escolher – ou escrever números ou alguns caracteres; temos string-texto, logs que você pode escrever no Elasticsearch… Assim, a interface da web também se comunicará com o Elasticsearch. Isso funciona muito bem em alguns casos, mas no momento, pode ser utilizado.
TimescaleDB. Hiper-tabelas
Para a versão 4.4.2, notamos uma coisa sobre o TimescaleDB. O que é isso? É uma extensão para o PostgreSQL, ou seja, possui uma interface nativa do PostgreSQL. Além disso, essa extensão permite trabalhar de forma muito mais eficiente com dados de séries temporais e tem particionamento automático. Como isso se parece:
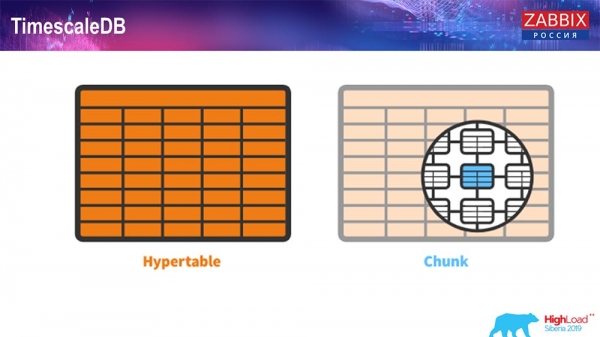
Este é um hypertable – existe esse conceito no Timescale. É uma hipertabela que você cria, e nela existem chunks. Chunks são partições, são tabelas filhas, se não me engano. Isso realmente é eficiente.
TimescaleDB e PostgreSQL
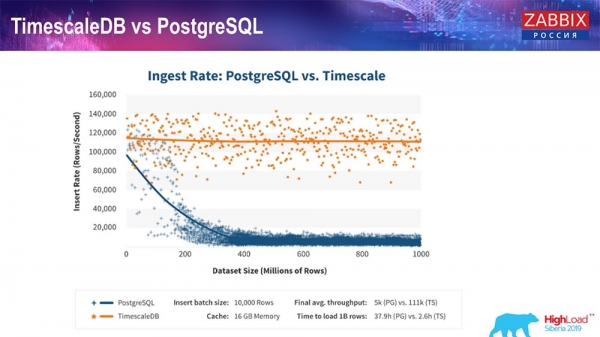
Como afirmam os desenvolvedores do TimescaleDB, eles utilizam um algoritmo mais correto para processamento de consultas, especialmente para inserts, que permite ter um desempenho aproximadamente constante à medida que o tamanho do conjunto de dados aumenta. Ou seja, após 200 milhões de linhas, o PostgreSQL normal começa a cair muito e perde desempenho praticamente a zero, enquanto o Timescale permite que inserts sejam feitos de forma mais eficiente independentemente da quantidade de dados.
Como instalar o TimescaleDB? É simples!
Tem na documentação deles, está descrito – você pode instalar a partir de pacotes para qualquer… Ele depende dos pacotes oficiais do PostgreSQL. Você pode compilar manualmente. Aconteceu que tive que compilar para o banco de dados.
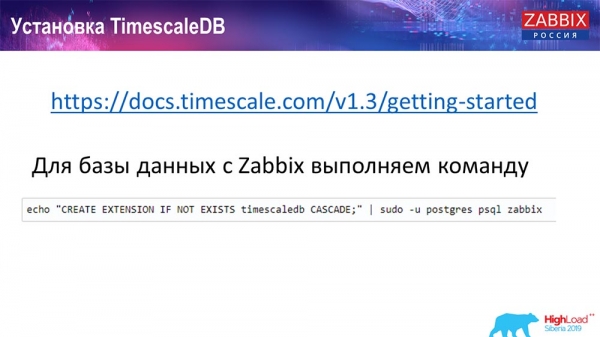
No Zabbix, nós simplesmente ativamos a Extensão. Eu acho que aqueles que usaram a Extensão no PostgreSQL... Você simplesmente a ativa, cria-a para o banco de dados Zabbix que você usa.
E o último passo...
TimescaleDB. Migração de tabelas de histórico
Você precisa criar um hypertable. Para isso, há uma função especial – Create hypertable. Nela, o primeiro parâmetro é a tabela que precisa ser criada nesta base de dados (para a qual o hypertable deve ser criado).
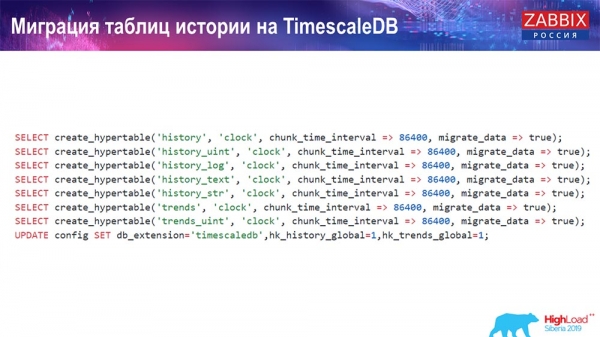
O campo pelo qual deve ser criado e chunk_time_interval (que é o intervalo dos chunks (partições que devem ser utilizadas). 86 400 – é um dia.
O parâmetro migrate_data: se você definir como true, isso move todos os dados atuais para os chunks criados anteriormente.
Eu mesmo usei migrate_data – isso leva um bom tempo, dependendo do tamanho do seu banco de dados. Eu tinha mais de um terabyte – a criação levou mais de uma hora. Em alguns casos, durante os testes, eu excluí dados históricos para texto (history_text) e string (history_str), para não os transferir – eles realmente não me interessavam.
E a última atualização que fazemos em nossa db_extention: instalamos o timescaledb para que o banco de dados e, em particular, nosso "Zabbix", entendesse que há uma db_extention. Ele a ativa e utiliza corretamente a sintaxe e as consultas ao banco de dados, usando já os "recursos" necessários para o TimescaleDB.
Configuração do servidor
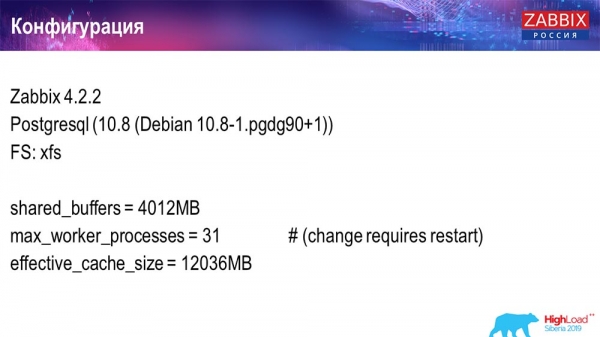
Utilizei dois servidores. O primeiro servidor é uma máquina virtual bastante pequena, com 20 processadores e 16 gigabytes de memória RAM. Configurei nele o "PostgreSQL" 10.8:
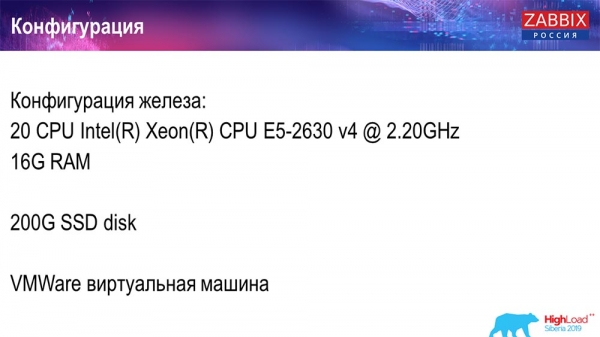
O sistema operacional era Debian, e o sistema de arquivos – xfs. Fiz configurações mínimas para usar exatamente este banco de dados, além do que será utilizado pelo próprio "Zabbix". Neste mesmo computador, estavam o servidor "Zabbix", o PostgreSQL e os agentes de carga.
Usei 50 agentes ativos, que utilizam o LoadableModule para gerar rapidamente vários resultados. Eles geraram linhas, números e assim por diante. Eu preenchia o banco de dados com uma grande quantidade de dados. Inicialmente, a configuração continha 5 mil elementos de dados por host, e aproximadamente cada elemento de dados continha um gatilho – para que isso fosse uma configuração real. Às vezes, para uso, é necessário mais de um gatilho.
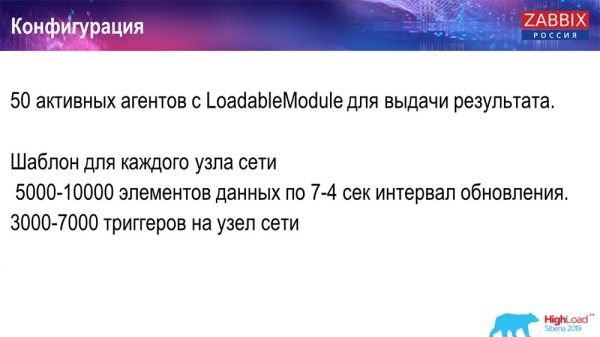
Regulava o intervalo de atualização e a carga, não apenas usando os 50 agentes (acrescentava mais), mas também com a ajuda de elementos de dados dinâmicos e reduzia o intervalo de atualização para 4 segundos.
Teste de desempenho. PostgreSQL: 36 mil NVPs
A primeira execução, a primeira configuração foi feita em um PostgreSQL 10 limpo neste hardware (35 mil valores por segundo). No geral, como pode ser visto na tela, a inserção de dados leva frações de segundo – tudo bem e rápido, discos SSD (200 gigabytes). A única coisa é que 20 GB se preenchem rapidamente.
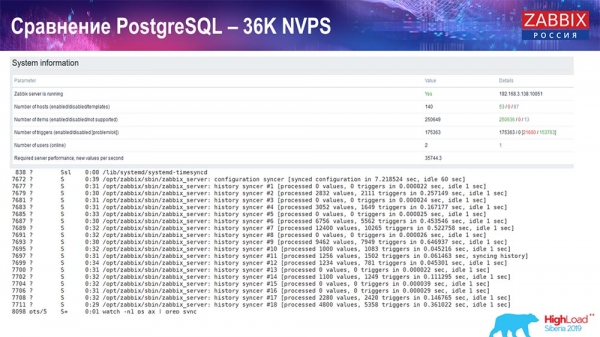
Haverá muitos desses gráficos. Este é o dashboard padrão de desempenho do servidor "Zabbix".
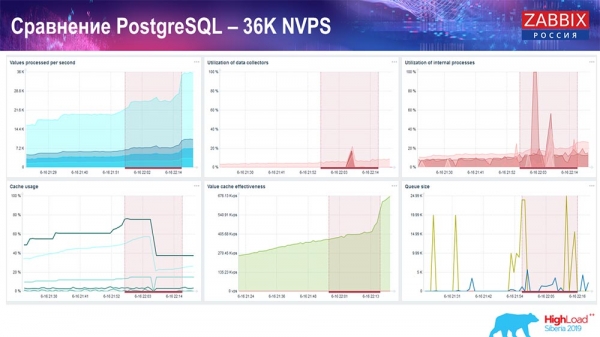
O primeiro gráfico – número de valores por segundo (azul, na parte superior esquerda), 35 mil valores neste caso. Este (na parte superior central) é a carga dos processos de coleta, e este (na parte superior direita) – a carga dos processos internos: history syncers e housekeeper, que aqui (na parte inferior central) foi executado por bastante tempo.
Este gráfico (na parte inferior central) mostra o uso do ValueCache - quantas consultas do ValueCache para gatilhos (vários milhares de valores por segundo). Um gráfico importante também é o quarto (na parte inferior esquerda), que mostra o uso do HistoryCache, sobre o qual falei, que é um buffer antes da inserção no BD.
Teste de desempenho. PostgreSQL: 50 mil NVPs
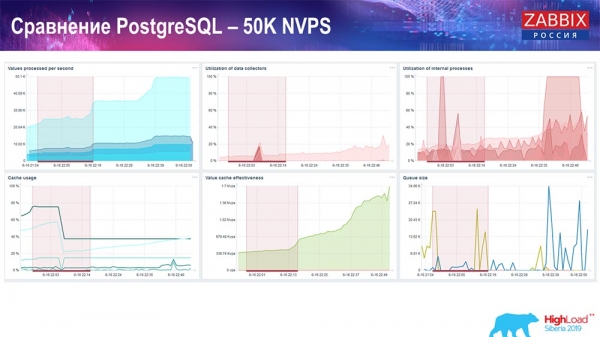
Em seguida, aumentei a carga para 50 mil valores por segundo neste mesmo hardware. Ao carregar pelo 'Housekeeper', 10 mil valores eram gravados em 2-3 segundos com o processamento. Isso está, na verdade, mostrado na próxima captura de tela:
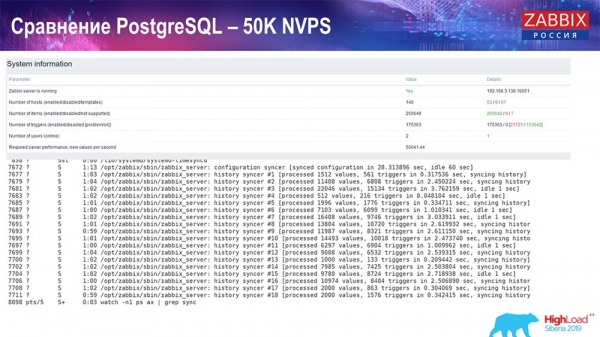
O 'Housekeeper' já começa a interferir no trabalho, mas, no geral, a carga dos trapper history-syncers ainda está em torno de 60% (terceiro gráfico, no canto superior direito). O HistoryCache começou a ser preenchido ativamente mesmo durante a operação do 'Housekeeper' (na parte inferior esquerda). Ele estava em cerca de meio gigabyte, preenchendo-se em 20%.
Teste de desempenho. PostgreSQL: 80 mil NVPs
Depois, aumentei para 80 mil valores por segundo:
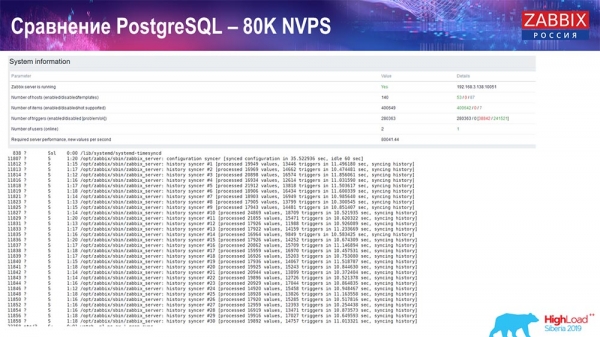
Eram cerca de 400 mil elementos de dados, 280 mil gatilhos. A inserção, como você pode ver, pela carga dos history-syncers (eram 30) já estava bastante alta. Em seguida, aumentei vários parâmetros: history-syncers, cache… Neste hardware, a carga dos history-syncers começou a aumentar até o máximo, praticamente 'estagnando' - consequentemente, o HistoryCache entrou em uma carga muito alta:
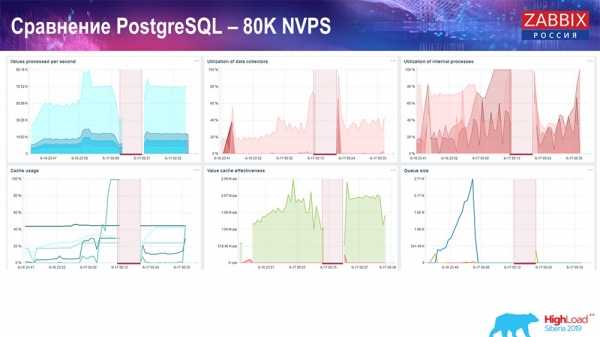
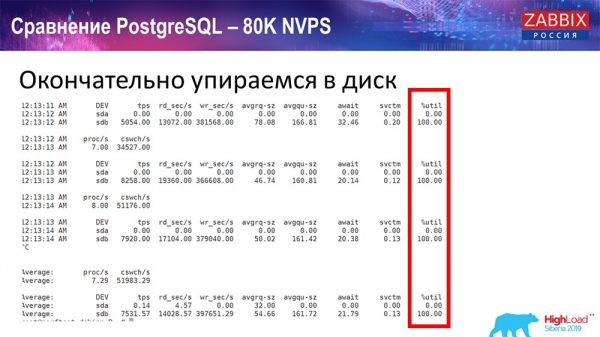
Todo esse tempo, observei todos os parâmetros do sistema (como o processador é utilizado, a memória RAM) e descobri que a utilização dos discos estava no máximo - alcancei a capacidade máxima desse disco neste hardware, nesta máquina virtual. O 'Postgres' começou, com tal intensidade, a descartar dados de forma bastante ativa, e o disco já não conseguia acompanhar a gravação, leitura…
Peguei outro servidor, que já tinha 48 processadores e 128 gigabytes de memória RAM:
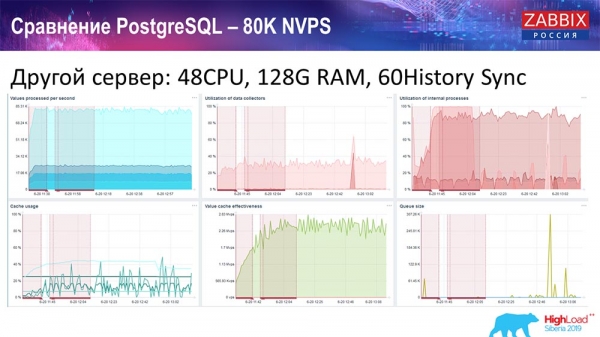
Além disso, eu o 'tunei' – instalei 60 history syncers e alcancei um desempenho aceitável. De fato, não estamos 'estagnados', mas esse já deve ser o limite de desempenho, onde é necessário tomar alguma atitude.
Teste de desempenho. TimescaleDB: 80 mil NVPs
Meu principal objetivo era usar TimescaleDB. Em cada gráfico, é visível uma queda:
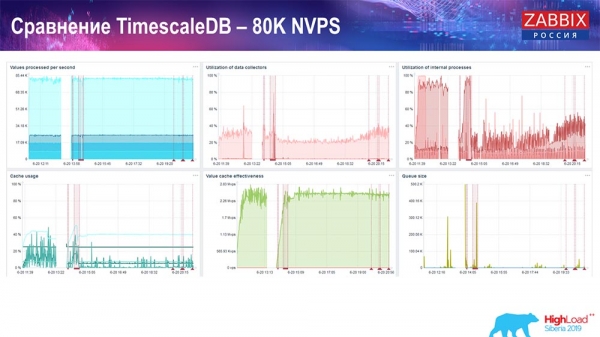
Esses desvios são exatamente a migração de dados. Após isso, no servidor 'Zabbix', o perfil de carregamento dos history syncers, como você pode ver, mudou bastante. Ele permite inserir dados quase três vezes mais rápido e usar menos HistoryCache – portanto, você receberá os dados em tempo hábil. Novamente, 80 mil valores por segundo – é uma taxa bastante alta (claro, não para o 'Yandex'). No geral, é uma configuração bastante robusta, com um servidor.
Teste de desempenho PostgreSQL: 120 mil NVPs
Em seguida, aumentei o número de elementos de dados para meio milhão e obtive um valor estimado de 125 mil por segundo:
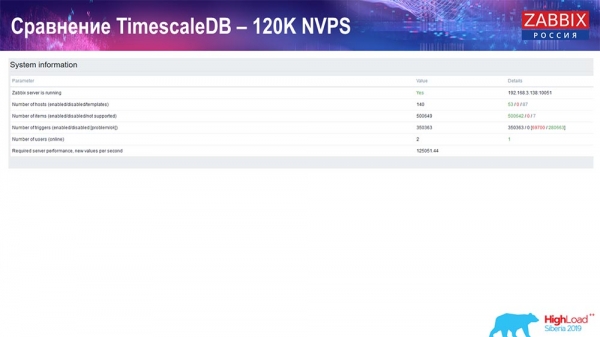
E obtive gráficos assim:
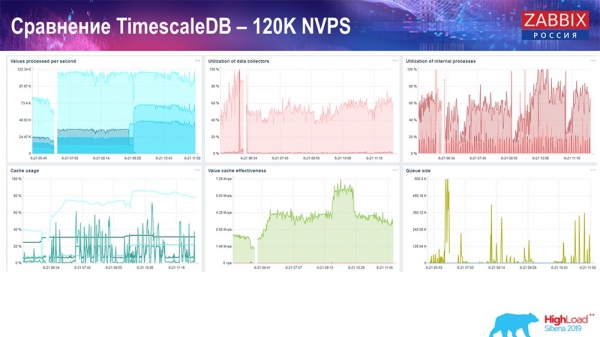
De forma geral, esta é uma configuração funcional, que pode operar por um período considerável. Mas como eu tinha um disco de apenas 1,5 terabyte, eu o consumi em poucos dias. O mais importante é que, ao mesmo tempo, novas partições estavam sendo criadas no TimescaleDB, e isso ocorria de forma completamente invisível para o desempenho, o que não se pode dizer sobre o MySQL.
Normalmente, as partições são criadas durante a noite, pois isso bloqueia completamente a inserção e o trabalho com as tabelas, podendo levar à degradação do serviço. Neste caso, isso não ocorreu! A principal tarefa era verificar as capacidades do TimescaleDB. O resultado foi: 120 mil valores por segundo.
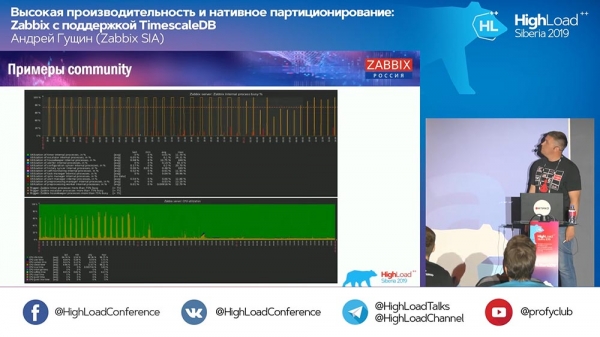
Também há exemplos na 'comunidade':
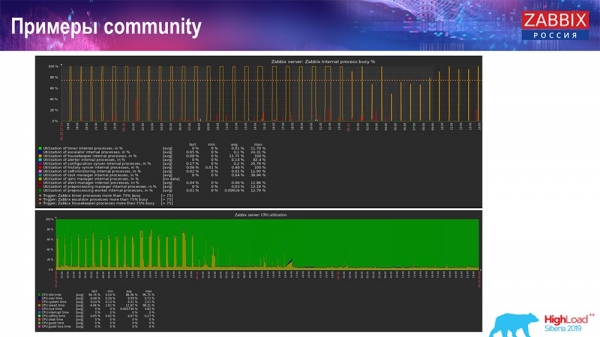
Uma pessoa também ativou o TimescaleDB e a carga pelo uso de io.weight caiu no processador; e o uso de elementos de processos internos também diminuiu graças à ativação do TimescaleDB. E isso em discos normais, ou seja, em uma máquina virtual comum com discos normais (não SSD)!
Para algumas pequenas configurações que estão limitadas pelo desempenho do disco, o TimescaleDB, na minha opinião, é uma solução muito boa. Ele permitirá continuar a operar bem antes de migrar para um hardware mais rápido para o banco de dados.
Convido todos vocês para os nossos eventos: Conferência – em Moscovo, Cúpula – em Riga. Use nossos canais – 'Telegram', fórum, IRC. Se você tiver alguma dúvida – venha até nós no balcão, podemos conversar sobre tudo.
Perguntas da audiência
Pergunta da audiência (daqui em diante – A): – Se o TimescaleDB é tão simples de configurar e oferece um aumento de desempenho tão significativo, talvez deva ser utilizado como uma melhor prática para configurar o 'Zabbix' com o 'PostgreSQL'? E existem alguma armadilhas ou desvantagens nessa solução, ou, se eu decidi que vou usar 'Zabbix', posso simplesmente usar o 'PostgreSQL', instalar o 'Timescale' e usar sem me preocupar com problemas?
AG: – Sim, eu diria que é uma boa recomendação: usar o 'PostgreSQL' logo com a extensão TimescaleDB. Como mencionei, há muitos relatos positivos, apesar de essa 'funcionalidade' ser experimental. Mas, de fato, os testes mostram que é uma ótima solução (com TimescaleDB), e eu acredito que ela continuará a evoluir! Estamos acompanhando como essa extensão se desenvolve e faremos ajustes quando necessário.
Durante o desenvolvimento, nos baseamos em uma de suas funcionalidades conhecidas: lá você poderia trabalhar com chunks de forma um pouco diferente. Mas depois, eles removeram isso na próxima versão, e tivemos que deixar de lado aquele código. Eu recomendaria usar essa solução em muitas configurações. Se você está usando MySQL... Para configurações medianas, qualquer solução funciona bem.
A: – Nos últimos gráficos, que são da comunidade, havia um gráfico com o 'Housekeeper':
Ele continuou funcionando. O que o 'Housekeeper' faz no caso do TimescaleDB?
AG: – Não posso afirmar com certeza agora – vou olhar o código e darei mais detalhes. Ele utiliza consultas do TimescaleDB não para remover chunks, mas de alguma forma agrega. Por enquanto, não estou preparado para responder essa questão técnica. No estande, hoje ou amanhã, esclareceremos.
A: – Eu tenho uma pergunta similar – sobre o desempenho da operação de exclusão no 'Timescale'.
A (resposta da audiência): – Quando você exclui dados de uma tabela, se você faz isso através de delete, você precisa percorrer a tabela – excluir, limpar, marcar tudo para o futuro vacuum. No 'Timescale', como você tem chunks, você pode descartá-los. Grosso modo, você simplesmente diz ao arquivo, que está na big data: 'Excluir!'
O «Timescale» simplesmente entende que esse chunk não existe mais. E como ele se integra ao planejador de consultas, ele captura suas condições no select ou em outras operações e imediatamente compreende que esse chunk não existe mais – «Não vou mais lá!» (dados ausentes). E é isso! Ou seja, a verificação da tabela é substituída pela remoção do arquivo binário, portanto é rápido.
A: – Já tocamos no assunto de não SQL. Pelo que entendo, o «Zabbix» não precisa modificar muito os dados, e tudo isso é algo como um log. É possível usar bancos de dados especializados que não podem alterar seus dados, mas que são muito mais rápidos ao salvar, acumular, entregar – Clickhouse, por exemplo, algo semelhante ao Kafka? … Kafka também é um log! Podemos integrá-los de alguma forma?
AG: – A exportação pode ser feita. Temos um certo recurso desde a versão 3.4: você pode escrever em arquivos todos os arquivos históricos, eventos, tudo mais; e depois, com algum processador, enviar para qualquer outro banco de dados. Na verdade, muitos reescrevem e escrevem diretamente no banco de dados. Os history-syncers escrevem tudo isso em arquivos em tempo real, rotacionam esses arquivos e assim por diante, e você pode transferir para o «Clickhouse». Não posso comentar sobre planos, mas talvez o suporte futuro para soluções NoSQL (como «Clickhouse») continue.
A: – Ou seja, é possível se livrar completamente do PostgreSQL?
AG: – Claro, a parte mais difícil no «Zabbix» são as tabelas históricas, que causam mais problemas, e eventos. Nesse caso, se você não armazenar eventos por muito tempo e mantiver a história com tendências em algum outro armazenamento rápido, então, em geral, não deve haver problemas.
A: – Você pode avaliar quão mais rápido tudo funcionará se migrarmos para o «Clickhouse», por exemplo?
AG: – Eu não testei. Acho que, pelo menos, os mesmos números podem ser alcançados bastante facilmente, considerando que o «Clickhouse» tem sua própria interface, mas não posso afirmar com certeza. É melhor fazer testes. Tudo depende da configuração: quantos hosts você tem e assim por diante. A inserção é uma coisa, mas você também precisa recuperar esses dados – Grafana ou outro software.
A: – Ou seja, estamos falando de uma competição justa, e não de uma grande vantagem desses bancos de dados rápidos?
AG: – Acho que, quando integrarmos, teremos testes mais precisos.
A: – E onde foi parar o velho RRD? O que motivou a transição para bancos de dados SQL? Inicialmente, todas as métricas eram coletadas em RRD.
AG: – No «Zabbix», o RRD pode ter existido em uma versão muito antiga. Sempre houve bancos de dados SQL – essa é a abordagem clássica. A abordagem clássica é MySQL, PostgreSQL (já existem há muito tempo). Nosso interface era comum para bancos de dados SQL e raramente usamos RRD.

Um pouco de publicidade 🙂
Obrigado por permanecer conosco. Você gosta dos nossos artigos? Quer ver mais materiais interessantes? Apoie-nos fazendo um pedido ou recomendando para conhecidos. , uma alternativa única aos servidores entry-level, que criamos para você: (disponíveis opções com RAID1 e RAID10, até 24 núcleos e até 40GB DDR4).
Dell R730xd por 2 vezes mais barato no datacenter Equinix Tier IV em Amsterdã? Somente conosco na Holanda! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — a partir de $99! Leia sobre
Fonte: habr.com
