

Todos falam sobre processos de desenvolvimento e teste, treinamento de pessoal, aumento da motivação, mas esses processos são insuficientes quando um minuto de inatividade do serviço custa uma fortuna. O que fazer quando você realiza transações financeiras sob um SLA rigoroso? Como aumentar a confiabilidade e a resiliência dos seus sistemas, negligenciando desenvolvimento e teste?
A próxima conferência HighLoad++ ocorrerá nos dias 6 e 7 de abril de 2020 em São Petersburgo. Detalhes e ingressos em . 9 de novembro, 18:00. HighLoad++ Moscovo 2018, sala "Deli + Calcutá". Resumos e .
Evgeny Kuzovlev (daqui em diante – EK): – Amigos, olá! Meu nome é Kuzovlev Evgeny. Sou da EcommPay, e especificamente da divisão EcommPay IT, a divisão de TI do grupo de empresas. Hoje, vamos conversar sobre os downtimes – como evitá-los e como minimizar suas consequências, caso não seja possível evitá-los. O tema está definido: "O que fazer quando um minuto de inatividade custa 100.000 dólares"? Antecipando, os números são comparáveis.
O que a EcommPay IT faz?
Quem somos? Por que estou aqui diante de vocês? Por que tenho o direito de compartilhar algo com vocês? E sobre o que vamos conversar aqui em mais detalhes?
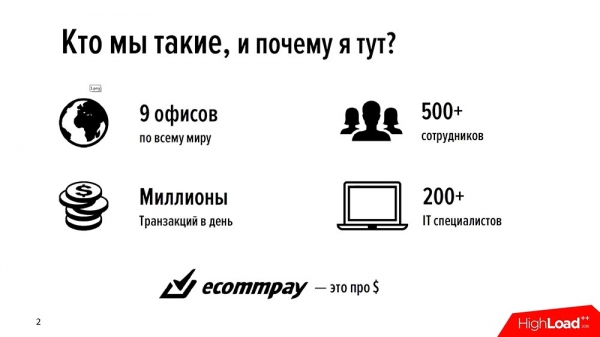
O grupo de empresas EcommPay é um adquirente internacional. Processamos pagamentos em todo o mundo – na Rússia, Europa e no Sudeste Asiático (Em todo o mundo). Temos 9 escritórios, 500 funcionários no total e cerca de metade deles são especialistas em TI. Tudo o que fazemos, tudo o que nos gera lucro, foi desenvolvido por nós mesmos.
Todos os nossos produtos (e temos muitos, na nossa linha de grandes produtos de TI, temos cerca de 16 componentes diferentes) foram criados internamente; nós os desenvolvemos e continuamos a expandi-los. Atualmente, realizamos cerca de um milhão de transações por dia (milhões, provavelmente é o correto dizer). Somos uma empresa relativamente jovem – temos cerca de seis anos.
Seis anos atrás, era um startup, quando um grupo de pessoal se uniu com a ideia de negócio. Não havia nada além de uma ideia, e nós partimos. Como qualquer startup, estávamos correndo mais rápido... Para nós, a velocidade era mais importante do que a qualidade.
Em algum momento, paramos: percebemos que já não conseguíamos viver com a mesma velocidade e qualidade, e que precisávamos priorizar a qualidade. Nesse momento, decidimos desenvolver uma nova plataforma que fosse correta, escalável e confiável. Começamos a escrever (investir, desenvolver, testar) essa plataforma, mas em algum momento entendemos que o desenvolvimento e o teste não nos permitiam alcançar um novo nível de qualidade no serviço.
Você cria um novo produto, o coloca em produção, mas ainda assim alguma coisa não sairá como o planejado. E hoje nós vamos falar sobre como alcançar um novo nível de qualidade (como conseguimos, com base na nossa experiência), deixando de lado o desenvolvimento e o teste; vamos discutir o que é acessível à operação – o que a operação pode fazer sozinha, o que pode oferecer ao teste para impactar a qualidade.
Downtimes. Mandamentos da operação.
Sempre o pilar fundamental, sobre o qual vamos falar hoje – downtime. Uma palavra aterrorizante. Se temos um downtime, tudo está mal. Corremos para resolver, os administradores mantêm o servidor funcionando – que Deus não deixe cair, como diz aquela canção. É sobre isso que falaremos hoje.
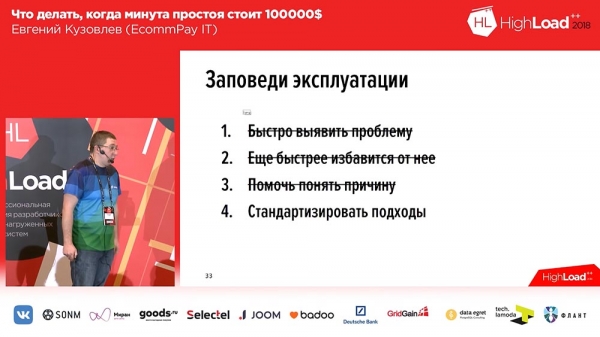
Quando começamos a mudar nossas abordagens, formulamos 4 mandamentos. Eles estão apresentados nos slides:
Esses mandamentos são bastante simples:
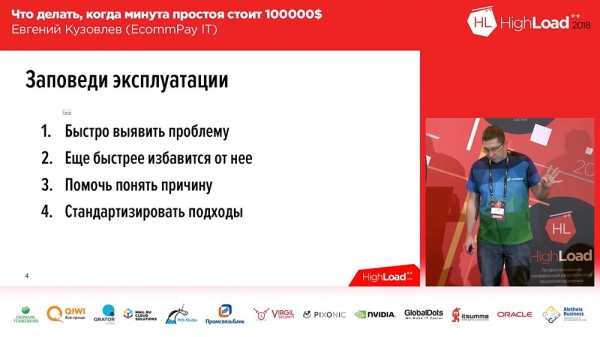
- Identificar rapidamente o problema.
- Eliminar ainda mais rapidamente.
- Ajudar a entender a causa (depois, para os desenvolvedores).
- E padronizar as abordagens.
Chamo a sua atenção para o ponto nº 2. Estamos eliminando o problema, não o resolvendo. Resolver é secundário. Para nós, o primordial é que o usuário esteja protegido desse problema. Ele existirá em um ambiente isolado, mas esse ambiente não terá contato com ele. Na verdade, vamos percorrer esses quatro grupos de problemas (alguns com mais detalhes, outros com menos), e eu contarei o que usamos e qual é nossa experiência em soluções.
Resolução de problemas: quando eles ocorrem e o que fazer com eles?
Mas não vamos começar na ordem, vamos começar pelo item nº 2 - como resolver o problema rapidamente? Há um problema - precisamos resolvê-lo. "O que devemos fazer com isso?" - essa é a pergunta principal. E quando começamos a pensar em como resolver o problema, chegamos a algumas exigências que a resolução de problemas deve seguir.
Para formular essas exigências, decidimos nos perguntar: "Quando enfrentamos problemas?" E, como se revelou, os problemas acontecem em quatro situações:
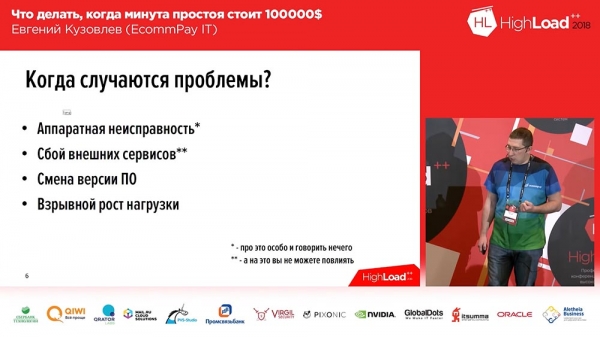
- Falha de hardware.
- Falha de serviços externos.
- Mudança de versão de software (aquele famoso deploy).
- Crescimento explosivo da carga.
Não vamos falar sobre os primeiros dois. A falha de hardware é resolvida de maneira bastante simples: tudo deve ser duplicado. Se forem discos, eles devem estar configurados em RAID; se for um servidor, ele deve ser duplicado; se você tem infraestrutura de rede, deve haver uma segunda cópia da infraestrutura de rede, ou seja, você deve pegar e duplicar. E se algo falhar, você muda para a capacidade reserva. É difícil dizer mais do que isso.
O segundo é a falha de serviços externos. Para a maioria, isso não é um problema, mas não para nós. Como processamos pagamentos, somos um agregador que fica entre o usuário (que insere seus dados do cartão) e os bancos, sistemas de pagamento ("Visa", "MasterCard", "Mir" etc.). Nossos serviços externos (sistemas de pagamento, bancos) frequentemente falham. Nem nós nem você (caso tenha tais serviços) podemos influenciar isso.
O que fazer então? Aqui há duas opções. Primeiro, se puder, você deve duplicar esse serviço de alguma forma. Por exemplo, se podemos, redirecionamos o tráfego de um serviço para outro: processamos, por exemplo, cartões através do "Sberbank"; se o "Sberbank" tiver problemas, redirecionamos o tráfego [condicionalmente] para o "Raiffeisen". A segunda coisa que podemos fazer é perceber rapidamente a falha dos serviços externos, e por isso falaremos sobre a velocidade de resposta na próxima parte da apresentação.
Na realidade, dessas quatro, podemos especificamente influenciar a troca de versões de software – realizar ações que levarão a melhorias na situação em relação a implantações e ao crescimento explosivo da carga. Na verdade, foi isso que fizemos. Aqui, novamente, um pequeno comentário…
Desses quatro problemas, alguns são resolvidos instantaneamente se você possui um ambiente na nuvem. Se você estiver nas nuvens da Microsoft Azure, Ozon, utilizar nossas nuvens da Yandex ou Mail, pelo menos a falha de hardware se torna um problema deles e você automaticamente fica em uma situação melhor em relação à falha de hardware.
Somos uma empresa um pouco não convencional. Aqui, todos falam sobre Kubernetes, sobre nuvens – nós não temos nem Kubernetes, nem nuvens. Mas temos racks com hardware em vários data centers, e precisamos operar com esse hardware, somos responsáveis por tudo isso. Portanto, nesse contexto, vamos falar. Então, sobre os problemas. Os primeiros dois são colocados de lado.
Mudança de versão de software. Fundamentos
Nossos desenvolvedores não têm acesso ao ambiente de produção. Por que isso? Porque somos certificados pelo PCI DSS, e os nossos desenvolvedores simplesmente não têm permissão para acessar a produção. É isso. Ponto final. Portanto, a responsabilidade do desenvolvimento termina exatamente no momento em que o desenvolvimento entrega o build para a liberação.
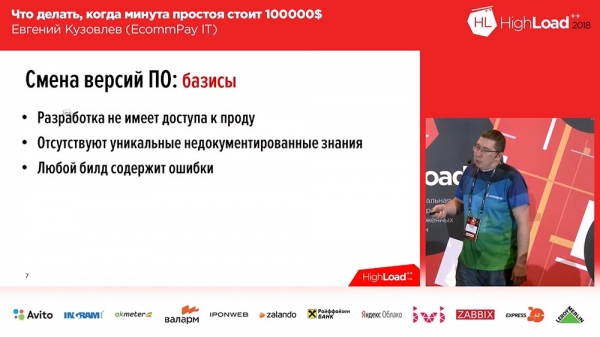
O segundo fundamento que temos, que também nos ajuda muito – é a ausência de conhecimentos únicos não documentados. Espero que você tenha o mesmo. Porque, se não tiver – você terá problemas. Os problemas surgem quando esses conhecimentos únicos não documentados não estão disponíveis no momento e lugar certos. Por exemplo, se apenas uma pessoa sabe como implantar um componente específico – essa pessoa não está disponível, está de férias ou adoeceu – pronto, você terá problemas.
E o terceiro fundamento que chegamos. Chegamos a isso através de dor, sangue e lágrimas – chegamos à conclusão de que qualquer build nosso contém erros, mesmo que não apresente erros. Decidimos que, quando implantamos algo, quando colocamos algo em produção – temos um build com erros. Estabelecemos requisitos aos quais nosso sistema deve atender.
Requisitos para a mudança de versão de software
Existem três requisitos:
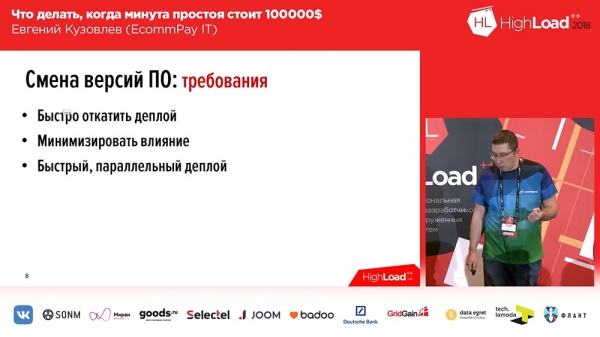
- Devemos ser capazes de reverter rapidamente a implantação.
- Devemos minimizar o impacto de uma implantação malsucedida.
- E devemos ser capazes de implantar rapidamente em paralelo.
Exatamente nessa ordem! Por quê? Porque, em primeiro lugar, ao implantar uma nova versão, a velocidade não é o mais importante, mas se algo der errado, é crucial poder reverter rapidamente e ter um impacto mínimo. Mas se você tiver um conjunto de versões em produção em que foi descoberta uma falha (como um raio do céu, não houve implantação, mas a falha está lá) – você precisará de velocidade na implantação subsequente. O que fizemos para atender a esses requisitos? Adotamos a seguinte metodologia:
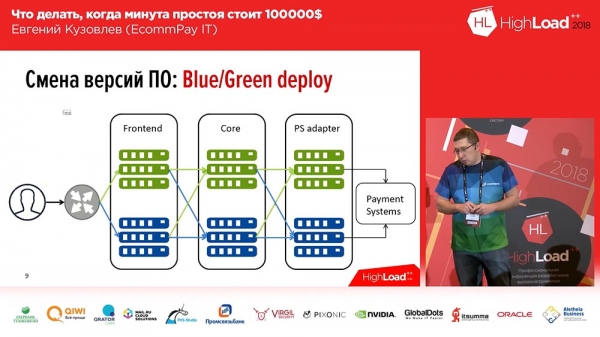
É bastante conhecida, não a inventamos – é o Blue/Green deploy. O que é isso? Para cada grupo de servidores onde suas aplicações estão rodando, deve haver uma cópia. Uma cópia 'quente': ela não recebe tráfego, mas a qualquer momento esse tráfego pode ser direcionado para essa cópia. Essa cópia contém a versão anterior. E no momento da implantação, você despluga o código na cópia inativa. Depois, você altera parte do tráfego (ou todo) para a nova versão. Assim, para mudar o fluxo de tráfego da versão antiga para a nova, você precisa fazer apenas uma ação: mudar o balanceador no upstream, mudar a direção – de um upstream para outro. Isso é muito conveniente e resolve o problema de alternância rápida e reversão rápida.Aqui está a solução da segunda questão – minimização: você pode direcionar para a nova linha, para a linha com o novo código, apenas uma parte do seu tráfego (por exemplo, 2%). E esses 2% não são 100%! Se você perder 100% do tráfego em uma implantação falhada – isso é grave, mas se você perder 2% do tráfego – isso é desagradável, mas não é catastrófico. Além disso, os usuários provavelmente não notarão, porque em alguns casos (não em todos), o mesmo usuário, ao pressionar F5, será direcionado para outra versão funcionando.
Blue/Green deploy. Roteamento
Ao mesmo tempo, não é tão simples fazer um 'deploy Blue/Green'... Todos os nossos componentes podem ser divididos em três grupos:
- este é o frontend (páginas de pagamento que nossos clientes veem);
- o núcleo de processamento;
- um adaptador para trabalhar com sistemas de pagamento (bancos, 'MasterCard', 'Visa'… ).
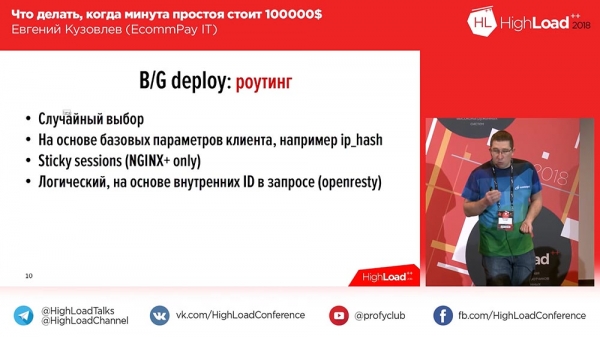
E há um detalhe – o detalhe está no roteamento entre as linhas. Se você simplesmente redirecionar 100% do tráfego, você não terá esses problemas. Mas se você quiser redirecionar 2%, surgem as questões: "Como fazer isso?" O mais simples, de uma forma direta: você pode configurar uma seleção aleatória, Round Robin no Nginx, e terá 2% – para a esquerda, 98% – para a direita. Mas isso nem sempre é adequado.
Por exemplo, o usuário interage com o sistema não através de uma única solicitação. Isso é normal: 2, 3, 4, 5 solicitações – seus sistemas podem ser semelhantes. E se for importante que todas as solicitações do usuário cheguem à mesma linha que a primeira solicitação, ou (ponto dois) que todas as solicitações do usuário cheguem a uma nova linha após a troca (ele pode ter começado a trabalhar antes com o sistema, antes da troca) – então essa distribuição aleatória não é adequada para você. Portanto, existem as seguintes opções:
A primeira opção, a mais simples – com base nos parâmetros básicos do cliente (IP Hash). Você tem um IP, e divide para a direita ou para a esquerda com base nele. Assim, você terá o segundo caso que descrevi, quando houve um deploy, o usuário já pode ter começado a trabalhar com seu sistema, e desde o momento do deploy, todas as solicitações irão para a nova linha (para a mesma, digamos).Se por alguma razão isso não for adequado e você precisa obrigatoriamente direcionar as solicitações para a linha onde chegou a solicitação inicial do usuário, então você tem duas opções...
A primeira opção: você pode optar pelo Nginx pago. Nele, há um mecanismo de sessões persistentes, que na solicitação inicial do usuário estabelece uma sessão e a vincula a um determinado upstream. Todas as solicitações subsequentes do usuário durante o tempo de vida da sessão serão enviadas para o mesmo upstream, onde a sessão foi estabelecida.Isso não funcionou para nós, pois já tínhamos o Nginx comum. Migrar para o Nginx+ – não é que seja caro, mas isso foi um pouco doloroso e não muito correto para nós. Por exemplo, ‘Sticky sessions’ não funcionaram para nós pela simples razão de que ‘Sticky sessions’ não permitem rotear com o critério ‘Ou-ou’. Ali você pode especificar que estamos fazendo ‘Sticky sessions’, por exemplo, por IP ou por IP e cookies ou por post parameters, mas ‘Ou-ou’ – isso já se torna mais complicado.
Por isso, chegamos à quarta opção. Usamos o nginx 'potencializado' (o openresty) – é um nginx que suporta a inclusão de scripts last. Você pode escrever um script last, passá-lo para este 'openresty' e esse script last será executado quando a requisição do usuário chegar.
E nós escrevemos, na verdade, esse script, instalamos o 'openresty' e, neste script, percorremos 6 diferentes parâmetros de concatenação 'Ou'. Dependendo da presença de um determinado parâmetro, sabemos se o usuário chegou a uma página ou outra, a uma linha ou outra.
Implantação Blue/Green. Vantagens e desvantagens.
Claro, poderíamos, talvez, fazer um pouco mais simples (usar as mesmas 'Sticky Sessions'), mas temos mais um detalhe: não só o usuário interage conosco dentro de um processamento de uma transação... Mas também interagem conosco os sistemas de pagamento: depois que processamos a transação (enviando a solicitação ao sistema de pagamento), recebemos um callback.
E, supondo que, dentro do nosso contorno, possamos passar o IP do usuário em todas as requisições e, com base no IP dos usuários, fazer a separação, não vamos dizer à 'Visa': 'Pessoal, somos uma empresa retro, supostamente internacional (no site e na Rússia)... Poderiam, por favor, nos passar o IP do usuário adicionalmente em um campo extra, seu protocolo padronizado'? É claro que eles não concordariam.
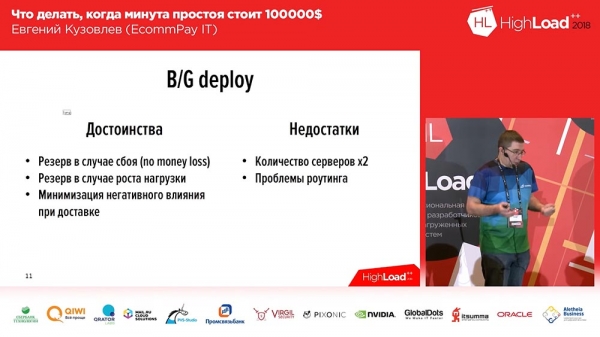
Portanto, para nós isso não funcionou – fizemos o openresty. Assim, obtivemos o roteamento assim:O 'Blue/Green Deployment' tem, portanto, as vantagens que mencionei e as desvantagens.
Duas desvantagens:
- você precisa se preocupar com o roteamento;
- a segunda desvantagem principal – são os custos.
Você precisa de duas vezes mais servidores, precisa de duas vezes mais recursos operacionais, e precisa gastar o dobro de esforço para manter todo esse zoológico.
A propósito, entre os benefícios, há mais uma coisa que não mencionei antes: você tem uma reserva em caso de aumento de carga. Se você enfrentar um crescimento explosivo de usuários, você simplesmente ativa a segunda linha na distribuição 50/50 – e você terá imediatamente o dobro de servidores no seu cluster, até que resolva a questão da quantidade de servidores.
Como fazer um deploy rápido?
Falamos sobre como solucionar o problema da minimização e do rollback rápido, mas a questão persiste: "Como fazer um deploy rapidamente"?
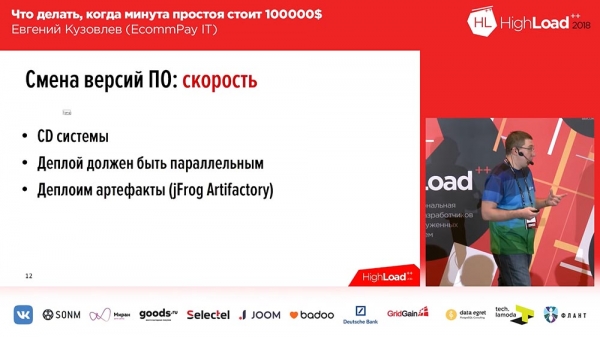
Aqui é breve e tudo simples.- Você deve ter um sistema de CD (Continuous Delivery) – sem isso, não adianta. Se você tem um único servidor, pode fazer o deploy manualmente. Temos cerca de mil e quinhentos servidores, e claramente — não podemos colocar uma equipe do tamanho desta sala apenas para fazer deploys.
- O deploy deve ser paralelo. Se o seu deploy é sequencial, as coisas não vão bem. Um servidor – tudo certo, mil e quinhentos servidores e você passará o dia todo implantando.
- Novamente, para acelerar, isso já não é necessariamente obrigatório. Durante o deploy geralmente ocorre a construção do projeto. Você tem um projeto web, uma parte frontend (onde você usa webpack, npm, algo assim), e esse processo não é longo – cerca de 5 minutos, mas esses 5 minutos podem ser críticos. Portanto, nós, por exemplo, não fazemos assim: nós eliminamos esses 5 minutos, estamos implantando os artefatos.
O que é um artefato? Artefato é uma compilação concluída, na qual toda a parte de construção já foi feita. Esse artefato armazenamos em um repositório de artefatos. No passado, utilizamos dois tipos de repositórios – Nexus e agora jFrog Artifactory. Usamos o "Nexus" inicialmente porque começamos a praticar essa abordagem em aplicações Java (ele se adequava bem a isso). Depois, incluímos parte das aplicações escritas em PHP; e o "Nexus" já não servia, então escolhemos jFrog Artifactory, que pode gerenciar praticamente tudo. Chegamos até a armazenar nesse repositório nossos próprios pacotes binários, que compilamos para os servidores.
Crescimento explosivo da carga
Falamos sobre a troca de versão do software. A próxima questão que temos é o crescimento explosivo da carga. Aqui, provavelmente, entendo por crescimento explosivo algo que não é exatamente correto...
Desenvolvemos um novo sistema – é orientado a serviços, moderno e bonito, com trabalhadores em todos os lugares, filas por toda parte e total assíncronia. E em tais sistemas, os dados podem seguir diferentes fluxos. Para a primeira transação, podem ser utilizados o 1º, 3º e 10º trabalhadores, enquanto para a segunda transação, o 2º, 4º e 5º. E hoje, digamos que pela manhã há um fluxo de dados que envolve os primeiros três trabalhadores, enquanto à noite muda abruptamente, e outros três trabalhadores são ativados.
Assim, surge a necessidade de escalar os trabalhadores, de alguma forma escalar seus serviços, mas sem permitir a inflação dos recursos.
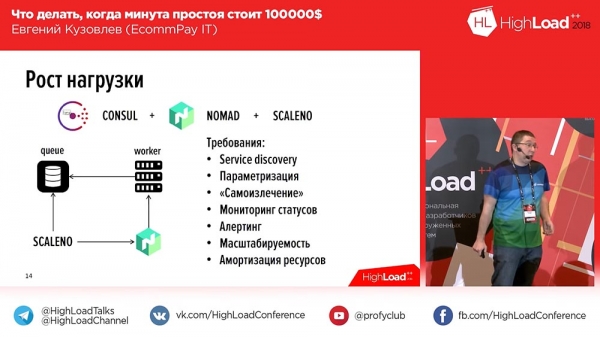
Definimos nossos requisitos. Esses requisitos são bastante simples: deve haver descoberta de serviços, parametrização – tudo padrão para a construção de sistemas escaláveis, exceto por um ponto – a amortização de recursos. Decidimos que não estávamos prontos para amortizar recursos só para fazer os servidores esquentarem ar. Utilizamos o 'Consul' e o 'Nomad', que gerencia nossos trabalhadores.Por que isso é um problema para nós? Vamos dar um passo atrás. Atualmente, temos cerca de 70 sistemas de pagamento. Pela manhã, o tráfego passa pelo 'Sberbank', e depois, por exemplo, o 'Sberbank' cai e mudamos para outro sistema de pagamento. Estávamos usando 100 trabalhadores até o 'Sberbank' e, após isso, precisamos aumentar rapidamente 100 trabalhadores para outro sistema de pagamento. E isso deve ocorrer preferencialmente sem intervenção humana. Porque, se houver intervenção humana, um engenheiro deve estar disponível 24/7 apenas para isso, pois essas falhas, com 70 sistemas envolvidos, acontecem regularmente.
Por isso, olhamos para o 'Nomad', que tem um IP aberto, e desenvolvemos a nossa ferramenta Scale-Nomad – ScaleNo, que basicamente faz o seguinte: monitora o crescimento da fila e aumenta ou diminui o número de trabalhadores dependendo da dinâmica de mudança da fila. Quando terminamos, pensamos: 'Talvez devêssemos torná-la open source?' Depois, analisamos melhor – ela é simples como duas moedas.
Até agora, não a tornamos open source, mas se, após esta apresentação, você perceber que precisa de uma ferramenta assim, meus contatos estão no último slide – por favor, me escreva. Se conseguirmos reunir pelo menos 3-5 pessoas, nós a tornaremos open source.
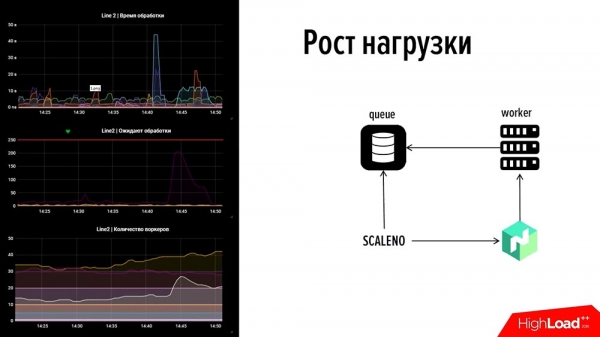
Como isso funciona? Vamos dar uma olhada! Para adiantar: do lado esquerdo há um pedaço da nossa monitorização: é uma linha, na parte superior – o tempo de processamento de eventos, no meio – o número de transações, na parte inferior – o número de trabalhadores.Se olharmos, nesta imagem há uma falha. No gráfico superior, uma das linhas saiu do eixo em 45 segundos – um dos sistemas de pagamento ficou fora do ar. Imediatamente, o tráfego foi mostrado por 2 minutos e houve um aumento na fila em outro sistema de pagamento, onde não havia trabalhadores (não utilizamos recursos – ao contrário, utilizamos o recurso corretamente). Não queríamos sobrecarregar – havia um número mínimo, cerca de 5-10 trabalhadores, mas eles não conseguiam lidar.
No último gráfico, aparece uma "elevação" que indica que a "Escaleno" dobrou esse número. E depois, quando o gráfico caiu um pouco, ele diminuiu um pouco – o número de trabalhadores foi alterado automaticamente. É assim que essa coisa funciona. Falamos sobre o item nº 2 – "Como eliminar rapidamente as causas".
Monitoramento. Como identificar rapidamente um problema?
Agora, o primeiro ponto – "Como identificar rapidamente um problema?" Monitoramento! Precisamos entender rapidamente certas coisas. Quais coisas precisamos entender rapidamente?
Três coisas!- Precisamos entender rapidamente e compreender a operação dos nossos próprios recursos.
- Precisamos rapidamente identificar falhas, monitorar a operação de sistemas que são externos para nós.
- O terceiro ponto – identificação de erros lógicos. Isso acontece quando o sistema está funcionando para você, todas as métricas estão normais, mas algo não está certo.
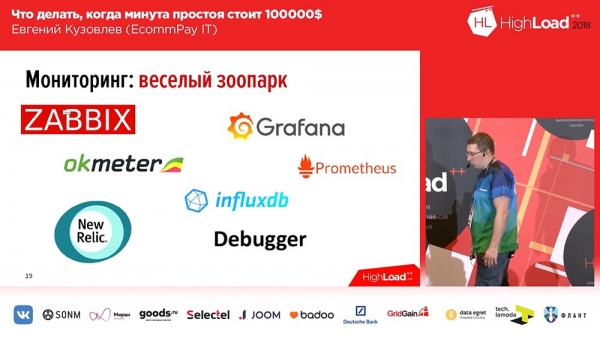
Aqui, provavelmente, não vou contar nada de tão incrível. Serei o Capitão Óbvio. Procuramos o que há no mercado. Formamos um "zoológico divertido". Aqui está o zoológico que temos agora:
Estamos utilizando "Zabbix" para monitorar o "hardware", para monitorar os principais indicadores dos servidores. Usamos "Okmeter" para bancos de dados. Usamos "Grafana" e "Prometheus" para todos os outros indicadores que não se enquadram nos primeiros dois, parte – com "Grafana" e "Prometheus", parte – "Grafana" com "Influx" e Telegraf.Há um ano, queríamos usar o New Relic. É uma ferramenta incrível, faz de tudo. Mas quanto mais ela faz, mais cara ela é. Quando crescemos para um volume de 1.500 servidores, um vendedor veio até nós e disse: 'Vamos assinar um contrato para o próximo ano'. Olhamos para o preço e decidimos que não faríamos isso. Agora estamos abandonando o New Relic, temos cerca de 15 servidores ainda monitorados pelo New Relic. O preço se tornou completamente insano.
E há uma ferramenta que desenvolvemos internamente – é o Debugger. Inicialmente chamamos de 'Bagger', mas depois um professor de inglês que tivemos riu muito e mudamos o nome para 'Debugger'. O que é isso? É uma ferramenta que, de fato, em 15 a 30 segundos em cada componente, como uma 'caixa preta' do sistema, executa testes sobre a funcionalidade geral do componente.
Por exemplo, se for uma página externa (página de pagamento) – ela simplesmente a abre e verifica como deve parecer. Se for um processamento, ela lança uma 'transação' de teste – verifica se essa 'transação' chegou. Se for uma conexão com sistemas de pagamento – nós enviamos um pedido de teste, onde podemos, e verificamos se está tudo bem.
Quais indicadores são importantes para monitoramento?
O que monitoramos principalmente? Quais indicadores são importantes para nós?
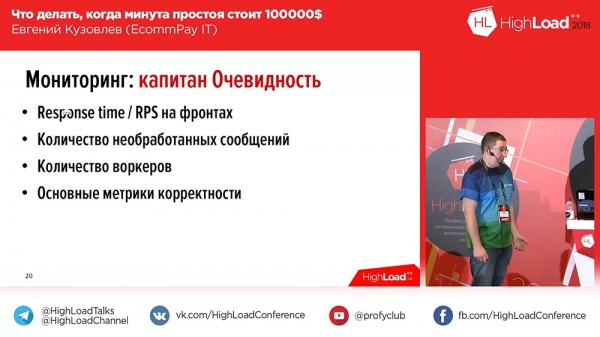
- Tempo de resposta / RPS nos frontends – é um indicador muito importante. Ele responde imediatamente que há algo errado.
- Número de mensagens processadas em todas as filas.
- Número de trabalhadores.
- Principais métricas de correção.
O último item é uma métrica 'de negócios'. Se você quiser monitorar o mesmo, precisa definir uma ou duas métricas que sejam seus principais indicadores. Para nós, essa métrica é a taxa de sucesso (é a relação entre o número de transações bem-sucedidas e o fluxo total de transações). Se algo mudar nesse intervalo de 5-10-15 minutos – significa que temos problemas (se houver uma mudança drástica).
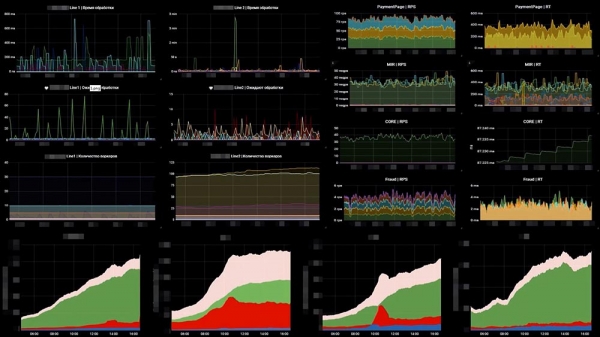
Como isso se apresenta – exemplo de um dos nossos painéis:
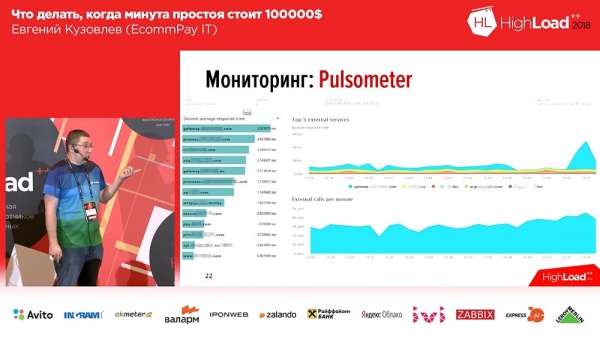
À esquerda, há 6 gráficos, correspondendo às linhas – o número de trabalhadores e o número de mensagens nas filas. À direita – RPS, RTS. Na parte inferior – a métrica 'de negócios'. E nessa métrica 'de negócios', podemos ver imediatamente que algo deu errado em dois gráficos intermediários... Isso ocorreu porque mais um sistema que nos suporta falhou.A segunda coisa que precisávamos fazer era monitorar a falha de sistemas de pagamento externos. Aqui usamos o OpenTracing – um mecanismo, padrão, paradigma que permite rastrear sistemas distribuídos; e fizemos algumas alterações. O paradigma padrão do OpenTracing diz que construímos o rastreamento de cada requisição individual. Não precisávamos disso, então o adaptamos para um rastreamento agregado, coletivo. Criamos uma ferramenta que nos permite monitorar a velocidade dos sistemas que nos apoiam.
O gráfico nos mostra que um dos sistemas de pagamento passou a responder em 3 segundos – surgiram problemas. Além disso, esse sistema reagirá assim que os problemas começarem, em um intervalo de 20 a 30 segundos.E a terceira classe de erros de monitoramento que existem é o monitoramento lógico.
Honestamente, não sabia o que desenhar neste slide, porque procuramos por muito tempo no mercado algo que nos atendesse. Não encontramos nada, então tivemos que criar algo nós mesmos.
O que quero dizer com monitoramento lógico? Bem, imagine: você cria um sistema (por exemplo, um clone do 'Tinder'); você o desenvolveu, lançou. O gestor de sucesso Vasya Pupkin instalou no celular, vê uma garota, dá um like... mas o like não vai para a garota – vai para o segurança Mikhalych desse mesmo centro empresarial. O gestor desce e depois se questiona: 'Por que esse segurança Mikhalych está sorrindo tão agradavelmente para mim?'Em situações como esta… Para nós, essa situação soa um pouco diferente, porque (eu escrevi) é uma perda de reputação que indiretamente leva a perdas financeiras. A nossa situação é inversa: podemos sofrer perdas financeiras diretas – por exemplo, se realizamos uma transação como bem-sucedida, mas ela foi malsucedida (ou vice-versa). Tivemos que desenvolver nossa própria ferramenta que monitora, com base em indicadores de negócios, o número de transações bem-sucedidas ao longo do tempo. Não encontramos nada no mercado! Era exatamente essa ideia que eu queria transmitir. Para resolver esse tipo de tarefa, não há nada no mercado.
Isso foi a respeito de como identificar rapidamente o problema.
Como identificar as causas do deploy
O terceiro grupo de tarefas que resolvemos é após identificarmos o problema, após nos livrarmos dele, seria bom entender a causa para desenvolvimento, para testes e fazer algo a respeito. Portanto, precisamos pesquisar, precisamos levantar os logs.
Se falarmos sobre logs (a principal razão são os logs), a maior parte dos logs está no ELK Stack – praticamente todo mundo está assim. Para alguns, talvez não esteja no ELK, mas se você escreve logs em gigas, cedo ou tarde você vai chegar no ELK. Nós os escrevemos em terabytes.
Aqui há um problema. Corrigimos, ajustamos um erro para o usuário, começamos a investigar o que realmente aconteceu, fomos ao "Kibana", inserimos o ID da transação e obtivemos um rol enorme (mostra muitos dados). E nesse rol, não se entende absolutamente nada. Por quê? Porque não está claro qual parte pertence a qual worker, qual parte pertence a qual componente. E nesse momento percebemos que precisamos de rastreamento – aquele mesmo OpenTracing, do qual eu falei.Pensamos nisso há um ano, olhamos para o mercado, e lá encontramos duas ferramentas – Zipkin e Jaeger. Jaeger é, na verdade, um herdeiro ideológico, um continuador ideológico do Zipkin. No Zipkin, tudo é bom, exceto que ele não consegue agregar, não consegue incluir logs no rastreamento, apenas o rastreamento de tempo. E o Jaeger oferece esse suporte.
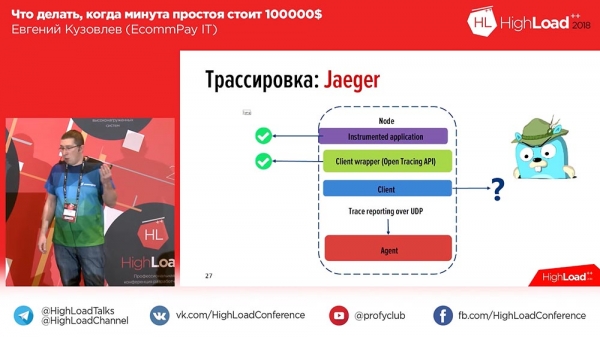
Olhamos para o "Eger"; podemos instrumentar aplicações, podemos escrever em Api (a norma Api para PHP na época, na verdade, não estava aprovada – isso foi há um ano, e agora já está aprovada), e absolutamente não tínhamos um cliente. "Ok," pensamos nós, e escrevemos nosso próprio cliente. O que conseguimos? É mais ou menos assim que isso aparece:
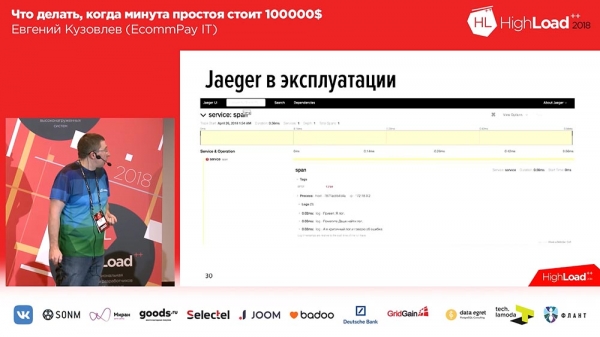
No "Eger", cada mensagem cria spans. Ou seja, quando o usuário abre o sistema, ele vê um ou dois blocos para cada solicitação recebida (1-2-3 – quantas solicitações recebidas houve do usuário, tantos blocos aparecerão). Para facilitar aos usuários, adicionamos tags aos logs e à rastreabilidade temporal. Assim, em caso de erro, nosso aplicativo marcará o log com a tag correspondente de Error. Pode-se filtrar pela tag Error e apenas os spans que contêm esse bloco de erro serão exibidos. Assim é como isso aparece quando expandimos o span:
Dentro do span, há um conjunto de traces. Neste caso, são três traces de teste, e o terceiro trace nos diz que ocorreu um erro. Ao mesmo tempo, aqui também vemos a rastreabilidade temporal: temos no topo uma linha do tempo, e vemos em qual intervalo de tempo cada log foi registrado.Assim, nos saiu muito bem. Escrevemos nossa própria extensão, e a tornamos open source. Se você quiser trabalhar com rastreabilidade, se você quiser trabalhar com "Eger" na linguagem PHP – temos nossa extensão, sinta-se à vontade para usar, como se diz:
Nossa extensão é um cliente para trabalhar com OpenTracing Api, feito como php-extention, ou seja, você precisará compilá-la e integrá-la ao sistema. Um ano atrás não havia nada disso. Agora surgiram outros clientes, que são componentes. Aqui é com você: ou você baixa os componentes pelo composer, ou você usa a extensão, fica à sua escolha.Normas corporativas
Falamos sobre os três mandamentos. O quarto mandamento é padronizar abordagens. Sobre o que é isso? É mais ou menos sobre isso:
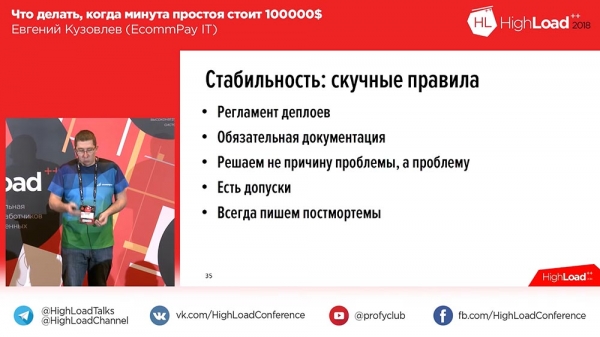
Por que aqui a palavra "corporativa"? Não porque somos uma empresa grande ou burocrática, não! A palavra "corporativa" que eu quis usar aqui é no contexto de que cada empresa, cada produto deve ter suas próprias normas, e você também deve ter as suas. Quais normas temos nós?- Temos um regulamento de implantações. Sem ele, não conseguimos avançar. Realizamos cerca de 60 implantações por semana, ou seja, as implantações ocorrem praticamente de forma contínua. Além disso, temos uma restrição em nosso regulamento que proíbe implantações nas sextas-feiras – na prática, não realizamos implantações nesse dia.
- É obrigatória a documentação. Nenhum novo componente vai para produção sem a devida documentação, mesmo que tenha sido desenvolvido por nossos profissionais de RnD. Exigimos deles uma instrução de implantação, um mapa de monitoramento e uma descrição aproximada (como os programadores podem escrever) de como o componente funciona e como solucioná-lo em caso de problemas.
- Nós lidamos com o problema, não com a causa – como já mencionei anteriormente. Para nós, é crucial proteger o usuário de problemas.
- Temos tolerâncias. Por exemplo, nãoConsideramos um downtime se, por dois minutos, perdemos 2% do tráfego. Isso, de certa forma, não entra em nossa estatística. Se for mais do que isso, seja em termos percentuais ou de tempo, já consideramos.
- E sempre escrevemos postmortems. O que quer que aconteça, qualquer situação que tenha se comportado anormalmente em produção será registrada no postmortem. Um postmortem é um documento onde você relata o que aconteceu, incluindo um cronograma detalhado, o que você fez para corrigir a situação e (esse é um bloco obrigatório!) o que fará para evitar que isso ocorra novamente no futuro. Isso é essencial para a análise posterior.
O que considerar como downtime?
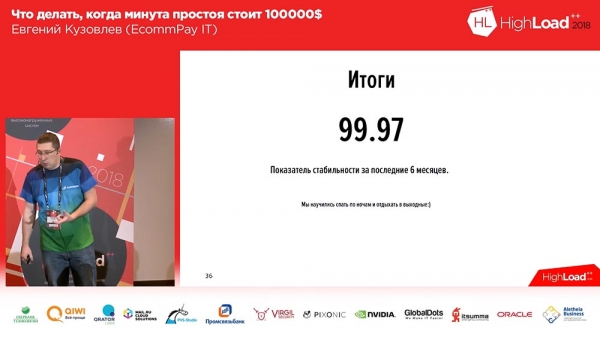
A que tudo isso levou?Isso levou ao fato de que (tivemos certos problemas de estabilidade que não agradavam nem a nós nem aos clientes) nos últimos 6 meses nosso índice de estabilidade foi de 99,97. Pode-se dizer que isso não é muito. Sim, ainda temos muito a conquistar. Dessas estatísticas, cerca da metade se refere à estabilidade que, de certa forma, não é nossa, mas do nosso firewall de aplicação web, que está à nossa frente e é utilizado como um serviço, mas os clientes não se importam com isso.
Aprendemos a dormir à noite. Finalmente! Seis meses atrás, não sabíamos. E com isso em mente, gostaria de fazer uma observação. Ontem à noite, houve uma excelente palestra sobre o sistema de gerenciamento de um reator nuclear. Se há pessoas aqui que desenvolveram esse sistema – por favor, esqueçam o que eu disse sobre '2% não ser downtime'. Para vocês, 2% é downtime, mesmo que por apenas duas minutos!
Isso é tudo! Suas perguntas.
Sobre balanceadores e migrações de banco de dados
Pergunta da audiência (daqui em diante – P): – Boa noite. Muito obrigado pela apresentação técnica! A pergunta é breve, sobre seus balanceadores. Você mencionou que tem um WAF, então, pelo que entendo, como balanceador você utiliza algum externo...
EK: – Não, como balanceador usamos nossos próprios serviços. Neste caso, o WAF é exclusivamente uma ferramenta de proteção contra DDoS.
P: – Pode falar um pouco sobre os balanceadores?
EK: – Como já disse, é um grupo de servidores no openresty. No momento, temos 5 grupos de reserva, que são exclusivamente... ou seja, o servidor em que está o openresty apenas proxy tráfego. Portanto, para entender quanta carga mantemos: atualmente, nosso fluxo de tráfego é de várias centenas de megabits. Eles suportam bem, estão confortáveis, nem se esforçam.
P: – Também uma pergunta simples. Existe o Blue/Green deployment. E o que você faz, por exemplo, com as migrações de banco de dados?
EK: – Boa pergunta! Veja, no Blue/Green deployment temos filas separadas para cada linha. Ou seja, se falamos sobre filas de eventos que são passados de um worker para outro, há filas separadas para a linha blue e para a linha green. Se falamos sobre o próprio banco de dados, nós deliberadamente o restringimos ao máximo, movemos tudo praticamente para filas, no banco de dados temos apenas a pilha de transações armazenada. E a pilha de transações é única para todas as linhas. Em relação ao banco de dados neste contexto: não dividimos em blue e green, porque ambas as versões do código devem saber o que está acontecendo com a transação.
Amigos, tenho também um pequeno prêmio para incentivar vocês – um livro. E preciso entregá-lo pela melhor pergunta.
P: – Olá. Obrigado pela apresentação. A pergunta é a seguinte. Você monitora pagamentos, monitora os serviços com os quais você se comunica... Mas como você monitora se a pessoa de alguma forma chegou à sua página de pagamento, completou o pagamento e o projeto creditou o dinheiro? Como você monitora se o merchant está disponível e aceitou seu callback?
EK: – O ‘merchant’ para nós é um serviço externo, assim como o sistema de pagamentos. Monitoramos a velocidade de resposta do ‘merchant’.
Sobre a criptografia do banco de dados
P: – Olá. Tenho uma pergunta relacionada. Vocês têm dados sensíveis de acordo com PCI DSS. Gostaria de saber como vocês armazenam os PANs nas filas que precisam ser processados? Vocês usam alguma forma de criptografia? E, a partir disso, uma segunda pergunta: de acordo com o PCI DSS, é necessário recriptografar periodicamente a base em caso de mudanças (como demissão de administradores etc.) – como isso afeta a disponibilidade?
EK: – Excelente pergunta! Primeiro de tudo, não armazenamos PANs nas filas. Não temos permissão para armazenar PANs em aberto, portanto, utilizamos um serviço especial (chamamos de 'Keydemon') – é um serviço que faz uma única coisa: recebe uma mensagem, criptografa e devolve a mensagem. E é com essa mensagem criptografada que armazenamos tudo. Assim, o tamanho da chave é de quase um kilobyte, para que seja realmente sério e seguro.P: – Agora precisa ser 2 kilobytes?
EK: – Parece que ontem era 256... Onde mais pode ir?!
Portanto, isso é o primeiro ponto. E em segundo lugar, a solução que temos suporta o procedimento de recriptografia – há dois pares de 'KEKs' (chaves) que fornecem 'DEKs', que são os que fazem a criptografia (KEK é a chave mestre, DEK é uma derivada da chave que realiza a criptografia). E no caso de iniciar o procedimento (isso ocorre regularmente, a cada 3 meses ou algo próximo), carregamos um novo par de 'KEKs', e a recriptografia dos dados acontece. Temos serviços separados que extraem todos os dados e os criptografam novamente; para os dados, um identificador da chave usada para a criptografia é armazenado ao lado. Assim que os dados estão criptografados com as novas chaves, deletamos as chaves antigas.
Às vezes, os pagamentos precisam ser feitos manualmente…
P: – Ou seja, se um retorno ocorrer de alguma operação, você decriptografa com a chave antiga?
EK: – Sim.
P: – Então, mais uma pequena pergunta. Quando ocorre uma falha, queda, incidente, é necessário processar a transação manualmente. Isso acontece.
EK: – Sim, isso acontece.
P: – De onde vocês obtêm esses dados? Ou vocês mesmo acessam manualmente esse armazenamento?
EK: – Não, é claro que temos um sistema de back-office que contém uma interface para nosso suporte. Se não sabemos qual é o status de uma transação (por exemplo, enquanto o sistema de pagamento não responde devido a um timeout), nós simplesmente não sabemos; ou seja, definimos o status final apenas quando temos total certeza. Nesse caso, colocamos a transação em um status especial para processamento manual. Na manhã do dia seguinte, assim que o suporte recebe informações sobre transações pendentes no sistema de pagamento, eles as processam manualmente nessa interface.
P: – Tenho algumas perguntas. Uma delas é sobre a continuidade da zona PCI DSS: como vocês extraem os logs dessa área? Faço essa pergunta porque o desenvolvedor pode ter colocado qualquer coisa nos logs! A segunda pergunta é: como vocês aplicam hotfixes? Fazendo isso manualmente no banco de dados é uma opção, mas podem existir hotfixes gratuitos – qual é o procedimento nesse caso? E a terceira pergunta, provavelmente, está relacionada ao RTO e RPO. Vocês tiveram 99,97% de disponibilidade, quase quatro noves, mas entendo que têm um segundo, terceiro e quinto data center... Como vocês realizam a sincronização, replicação e todo o restante?EK: – Vamos começar pela primeira. A primeira pergunta era sobre logs? Quando os logs são gerados, há uma camada que mascara todos os dados sensíveis. Ela analisa por meio de máscaras e informações adicionais. Portanto, nossos logs já saem com dados mascarados e de acordo com a norma PCI DSS. Essa é uma das tarefas regulares atribuídas ao departamento de testes. Eles devem verificar cada tarefa, incluindo os logs que geram, e isso é parte de uma tarefa rotineira durante a revisão de código, para garantir que o desenvolvedor não registre informações indevidas. A verificação subsequente é realizada regularmente pelo departamento de segurança da informação, cerca de uma vez por semana: logs do último dia são selecionados e analisados por um scanner especial a partir de servidores de teste para verificar todas essas informações.
Sobre hot-fixes. Isso está incluído em nosso regulamento de implantações. Temos um item separado sobre hot-fixes. Acreditamos que realizamos hot-fixes 24 horas por dia, sempre que necessário. Assim que a versão é compilada, assim que ela é testada, assim que temos o artefato – um administrador de sistema de plantão é acionado mediante chamada do suporte, e ele realiza a implantação no momento em que é necessário.Sobre as «quatro noves». O número que temos agora foi realmente alcançado, e estávamos buscando isso também em outro data center. Agora temos um segundo data center e começamos a distribuir o tráfego entre eles, e a questão da replicação entre data centers é realmente não trivial. Tentamos resolver isso de várias maneiras: tentamos usar o mesmo 'Taranto' – e não funcionou, para ser claro. Portanto, chegamos à conclusão de que fazemos um pedido de 'sensa' manualmente. Cada aplicativo, na verdade, executa a sincronização necessária em modo assíncrono, 'change – done', entre os data centers.
P: – Se você tem um segundo, por que não tem um terceiro? Porque Split-brain ninguém ainda…
EK: – Aqui não temos ‘Split-brain’. Como cada aplicativo opera com multimaster, não importa em qual centro o pedido chegou. Estamos prontos para o cenário em que, caso um data center caia (nós planejamos para isso), e no meio do pedido do usuário houvéssemos de alternar para o segundo data center, estamos preparados para perder esse usuário, de fato; mas isso será uma minoria, uma quantidade absoluta.
P: – Boa noite. Obrigado pela apresentação. Você falou sobre seu depurador que executa algumas transações de teste em produção. Mas conte-nos sobre as transações de teste! Quão fundo elas vão?
EK: – Elas passam por todo o ciclo do componente. Para o componente, não há diferença entre uma transação de teste e uma de produção. Do ponto de vista lógico, é apenas um projeto separado no sistema, onde apenas transações de teste são executadas.
P: – E onde você as separa? O Core enviou…
EK: – Nós monitoramos o 'Core' neste caso para transações de teste… Temos um conceito chamado roteamento: o 'Core' sabe para qual sistema de pagamento deve enviar – nós enviamos para um sistema de pagamento fictício, que simplesmente retorna uma resposta http e pronto.
P: – Por favor, vocês têm o aplicativo escrito como um enorme monólito, ou o dividiram em alguns serviços ou até mesmo microserviços?
EK: – Nós definitivamente não temos um monólito, temos um aplicativo orientado a serviços. Temos uma piada de que temos serviços feitos de monólitos – eles são realmente grandes. Não é possível chamá-los de microserviços, mas são serviços dentro dos quais trabalham computadores distribuídos.
Se o serviço no servidor for comprometido…
P: – Então tenho a seguinte pergunta. Mesmo que fosse um monólito, você ainda disse que tem muitos desses servidores instantâneos, todos eles, em princípio, processam dados, e a pergunta é: 'Em caso de comprometimento de um dos servidores instantâneos ou do aplicativo, de um determinado elo, há algum controle de acesso? Quem pode fazer o quê? Quem deve ser contatado por quais dados?
EK: – Sim, sem dúvida. Os requisitos de segurança são bastante sérios. Em primeiro lugar, temos movimentos de dados abertos, e as portas são apenas aquelas pelas quais antecipamos o tráfego. Se um componente se comunica com um banco de dados (digamos, com 'MySQL') pela porta 5-4-3-2, ele terá acesso apenas a 5-4-3-2, e outras portas, outras direções de tráfego não estarão disponíveis. Além disso, deve-se entender que em produção existem cerca de 10 diferentes perímetros de segurança. E mesmo se o aplicativo for de alguma forma comprometido, Deus me livre, o invasor não poderá acessar o console de gerenciamento do servidor, pois essa é uma zona de segurança de rede diferente.P: – No contexto atual, estou mais interessado no fato de que vocês têm certos contratos com os serviços – o que eles podem fazer, por quais 'ações' eles podem se comunicar... E em um fluxo normal, certos serviços solicitam um determinado conjunto de 'ações' de outro. Com outros, eles, de certa forma, não se comunicam em uma situação normal, e têm outras zonas de responsabilidade. Se um deles for comprometido, ele poderá acionar as 'ações' desse serviço?
EK: – Eu entendo. Se em uma situação normal com outro servidor a comunicação fosse permitida, então – sim. Pelo contrato SLA, não monitoramos que você tem permissão apenas para as primeiras 3 'ações', enquanto a 4ª 'ação' não é permitida. Isso, provavelmente, é excessivo para nós, porque já temos um sistema de proteção de 4 níveis basicamente para os contornos. Preferimos nos proteger em contornos, em vez de no nível interno.
Como funcionam Visa, MasterCard e 'Sberbank'
P: – Quero esclarecer um ponto sobre a troca de usuário de um data center para outro. Pelo que sei, 'Visa' e 'MasterCard' funcionam com o protocolo de sincronizaçãoBinária 8583, onde estão os mixes. E gostaria de saber, agora, se a troca se refere diretamente à 'Visa' e 'MasterCard' ou até os sistemas de pagamento, até o processamento?
EK: – Isso é até os mixes. Os mixes estão em um único data center.
P: – Em termos simples, vocês têm um único ponto de conexão?
EK: – Para 'Visa' e 'MasterCard' – sim. Apenas porque 'Visa' e 'MasterCard' requerem investimentos consideráveis em infraestrutura para a conclusão de contratos separados para a obtenção de um segundo conjunto de mixes, por exemplo. Eles estão reservados dentro de um único data center, mas se, Deus me livre, o data center onde os mixes para conexão com 'Visa' e 'MasterCard' falhar, então a comunicação com 'Visa' e 'MasterCard' será perdida...
P: – Como eles podem ser reservados? Eu sei que 'Visa' permite apenas uma conexão em princípio!
EK: – Eles mesmos fornecem o equipamento. De qualquer forma, recebemos um equipamento que está fisicamente reservado.
P: – Ou seja, o rack dos Connects Orange deles?
EK: – Sim.
P: – E quanto a este caso: se o seu data center falhar, como proceder? Ou o tráfego simplesmente para?
EK: – Não. Nesse caso, simplesmente mudaremos o tráfego para outro canal, que, naturalmente, será mais caro para nós, mais caro para os clientes. Mas o tráfego não passará pela nossa conexão direta com 'Visa', 'MasterCard', mas por um 'Sberbank' hipotético (muito exageradamente).
Peço desculpas se ofendi os funcionários do 'Sberbank'. Mas, segundo nossas estatísticas, entre os bancos russos, 'Sberbank' falha com mais frequência. Não passa um mês sem que algo no 'Sberbank' não falhe.

Um pouco de publicidade 🙂
Obrigado por permanecer conosco. Você gosta dos nossos artigos? Quer ver mais materiais interessantes? Apoie-nos fazendo um pedido ou recomendando para conhecidos. , uma alternativa única aos servidores entry-level, que criamos para você: (disponíveis opções com RAID1 e RAID10, até 24 núcleos e até 40GB DDR4).
Dell R730xd por 2 vezes mais barato no datacenter Equinix Tier IV em Amsterdã? Somente conosco na Holanda! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — a partir de $99! Leia sobre
Fonte: habr.com
