

A próxima conferência HighLoad++ acontecerá nos dias 6 e 7 de abril de 2020 em São Petersburgo. Detalhes e ingressos . HighLoad++ Moscovo 2018. Sala "Moscovo". 9 de novembro, 15:00. Resumos e .
* Monitoramento — online e análise.
* Principais limitações da plataforma ZABBIX.
* Solução para escalabilidade do armazenamento de análise.
* Otimização do servidor ZABBIX.
* Otimização da interface do usuário.
* Experiência de operação do sistema sob cargas superiores a 40k NVPS.
* Conclusões resumidas.
Mikhail Makurov (daqui em diante — MM): – Olá a todos!
Maxim Chernetzov (daqui em diante — MC): – Bom dia!
MM: – Permitam-me apresentar Maxim. Max é um engenheiro talentoso, o melhor especialista em redes que conheço. Maxim lida com redes e serviços, seu desenvolvimento e operação.
MC: – E eu gostaria de falar sobre Mikhail. Mikhail é um desenvolvedor em C. Ele escreveu várias soluções de alta carga para processamento de tráfego para nossa empresa. Vivemos e trabalhamos nos Urais, na cidade de homens fortes, Chelyabinsk, na empresa "Intersvyaz". Nossa empresa é um fornecedor de serviços de internet e televisão a cabo para um milhão de pessoas em 16 cidades.
MM: – E é importante dizer que "Intersvyaz" é muito mais do que apenas um provedor, é uma empresa de TI. A maioria de nossas soluções é feita pelo nosso departamento de TI.
A: desde servidores que processam tráfego até o call center e o aplicativo móvel. No departamento de TI, agora há cerca de 80 pessoas com competências muito variadas.
Sobre o Zabbix e sua arquitetura
MC: – E agora tentarei estabelecer um recorde pessoal e explicar em um minuto o que é o Zabbix (daqui em diante – "Zabbix").
"Zabbix" se posiciona como um sistema de monitoramento "pronto para uso" em nível empresarial. Ele possui muitas funções que facilitam a vida: regras de escalonamento avançadas, API para integração, agrupamento e auto-descoberta de hosts e métricas. No "Zabbix", existem o que são chamados de meios de escalabilidade – proxies. O "Zabbix" é um sistema de código aberto.
Resumindo sobre a arquitetura. Pode-se dizer que ela consiste em três componentes:
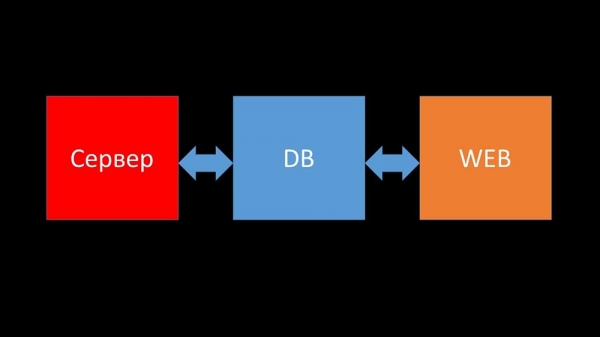
- Servidor. Escrito em C. Com processamento e transmissão de informações entre threads bastante complexos. Todo o processamento ocorre nele: desde a recepção até o armazenamento no banco de dados.
- Todos os dados são armazenados no banco de dados. O "Zabbix" suporta MySQL, PostgreSQL e Oracle.
- A interface web é escrita em PHP. Na maioria dos sistemas, vem com o servidor Apache, mas funciona de forma mais eficiente em combinação com nginx + php.
Hoje gostaríamos de contar uma história da vida da nossa empresa, relacionada ao Zabbix…
Uma história da vida da empresa Intersvyaz. O que temos e o que precisamos?
Cinco ou seis meses atrás. Uma vez, depois do trabalho…
MC: – Misha, olá! Fico feliz que consegui te encontrar – preciso conversar. Tivemos problemas novamente com a monitorização. Durante um grande acidente, tudo travou e não havia nenhuma informação sobre o estado da rede. Infelizmente, isso não é a primeira vez que acontece. Preciso da sua ajuda. Vamos fazer com que nossa monitorização funcione em qualquer circunstância!
MM: – Mas vamos nos sincronizar primeiro. Não olhei para isso há alguns anos. Pelo que me lembro, desistimos do Nagios e migramos para o Zabbix há cerca de 8 anos. E agora temos, parece, 6 servidores poderosos e cerca de uma dezena de proxies. Não estou confundindo nada?
MC: – Quase. Temos 15 servidores, alguns dos quais são máquinas virtuais. O mais importante é que isso não nos salva no momento em que mais precisamos. Sempre que ocorre um acidente – os servidores travam e nada é visível. Tentamos otimizar a configuração, mas isso não traz um aumento significativo de desempenho.
MM: – Entendi. Vocês já analisaram algo, descobriram alguma coisa do diagnóstico?
MC: – A primeira coisa com que estamos lidando é o banco de dados. O MySQL já está constantemente sobrecarregado, registrando novas métricas, e quando o Zabbix começa a gerar uma enxurrada de eventos – o banco fica pra dentro literalmente por algumas horas. Já te falei sobre a otimização da configuração, mas este ano atualizamos o hardware: os servidores têm mais de cem gigas de memória e arrays de disco em SSD RAID – não faz sentido continuar aumentando linearmente. O que vamos fazer?
MM: – Entendi. Afinal, o MySQL é um banco LTP. Parece que ele não é mais adequado para armazenar o arquivo de métricas do nosso tamanho. Vamos resolver isso.
MC: – Vamos lá!
Integração do Zabbix e Clickhouse como resultado do hackathon
Após algum tempo, obtivemos dados interessantes:
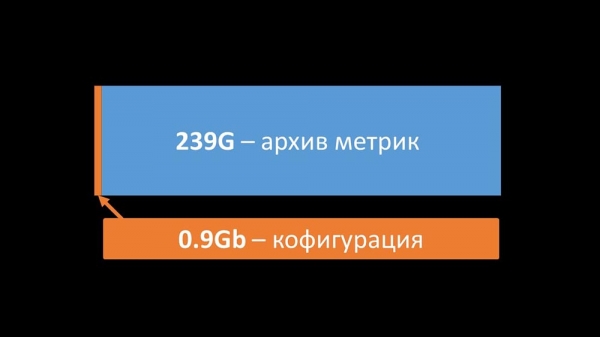
A maior parte do espaço em nosso banco de dados estava ocupada por um arquivo de métricas e menos de 1% era utilizado para configuração, modelos e ajustes. Naquele momento, já estávamos utilizando a solução Big Data baseada em Clickhouse há mais de um ano. A direção do nosso trabalho era clara. Durante nosso "Hackathon" da primavera, escrevi uma integração do "Zabbix" com o "Clickhouse" para o servidor e o frontend. Naquela época, o "Zabbix" já suportava o ElasticSearch, e decidimos comparar os dois.
Comparação entre Clickhouse e Elasticsearch
MM: – Para a comparação, geramos uma carga equivalente àquela que o servidor do "Zabbix" fornece e observamos o comportamento dos sistemas. Escrevemos dados em lotes de 1000 linhas, utilizando CURL. Supúnhamos previamente que o "Clickhouse" seria mais eficiente para o perfil de carga gerado pelo "Zabbix". Os resultados superaram nossas expectativas:
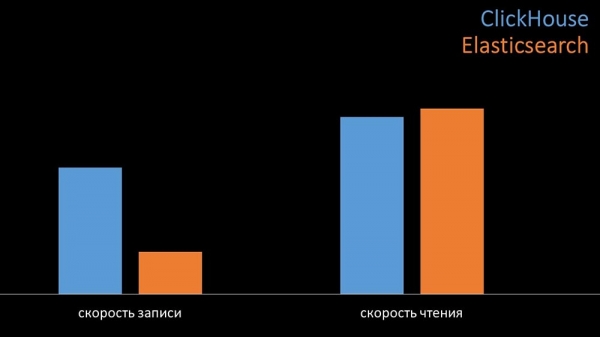
Em condições idênticas, nos testes, o "Clickhouse" escreveu três vezes mais dados. Ao mesmo tempo, ambos os sistemas consumiram recursos de maneira muito eficiente ao ler os dados. No entanto, o "ElasticSearch" exigiu uma quantidade significativa de processamento ao fazer gravações:
No total, o "Clickhouse" superou significativamente o "Elasticsearch" em consumo de CPU e velocidade. Além disso, devido à compressão de dados, o "Clickhouse" usa 11 vezes menos espaço em disco e realiza aproximadamente 30 vezes menos operações de disco:
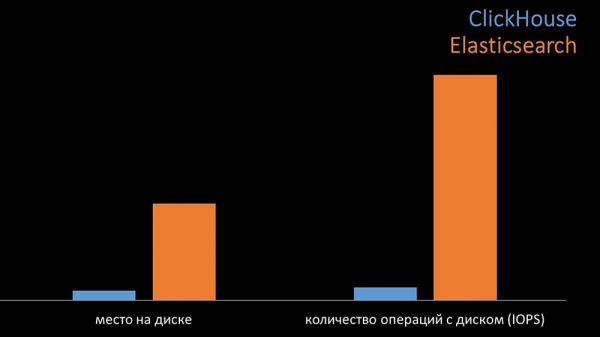
MC: – Sim, o trabalho com o subsistema de disco do "Clickhouse" é realizado de forma muito eficiente. Discos grandes SATA podem ser usados para os bancos e obter uma velocidade de gravação de centenas de milhares de linhas por segundo. O sistema "pronto para uso" suporta sharding, replicação e é bastante simples de configurar. Estamos mais do que satisfeitos com sua operação durante um ano.
Para otimização de recursos, é possível instalar o "Clickhouse" ao lado do banco existente, economizando assim uma enorme quantidade de tempo de CPU e operações de disco. Transferimos o arquivo de métricas para os clusters do "Clickhouse" já existentes:
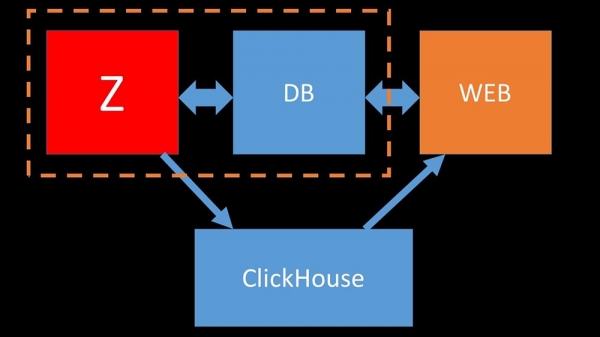
Descarregamos tanto a base principal do MySQL que conseguimos unificá-la em uma única máquina com o servidor do "Zabbix" e dispensar um servidor dedicado para o MySQL.
Como funciona o polling no Zabbix?
4 meses atrás
MM: – Então, podemos esquecer os problemas com o banco de dados?
MC: – Isso é verdade! Outra tarefa que precisamos resolver é a coleta lenta de dados. Agora, todos os nossos 15 servidores proxy estão sobrecarregados com processos SNMP e polling. E não há outra solução a não ser adicionar novos servidores.
MM: – Ótimo. Mas primeiro, conte-me como funciona o polling no 'Zabbix'?
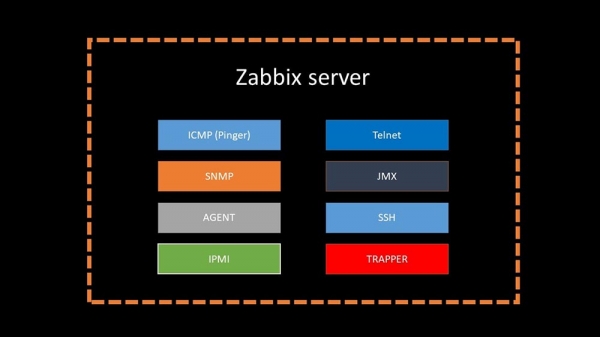
MC: – Em resumo, existem 20 tipos de métricas e uma dúzia de formas de obtê-las. O 'Zabbix' pode coletar dados em modo 'request – response', ou esperar novos dados através da 'Interface Trapper'.
Vale ressaltar que, na versão original do 'Zabbix', esse método (Trapper) é o mais rápido.
Existem servidores proxy para distribuição de carga:
Os proxies podem realizar as mesmas funções de coleta que o servidor 'Zabbix', recebendo tarefas dele e enviando as métricas coletadas através da interface Trapper. Este é o modo de distribuição de carga recomendado oficialmente. Além disso, os proxies são úteis para monitorar uma infraestrutura remota que opera por NAT ou em um canal lento:
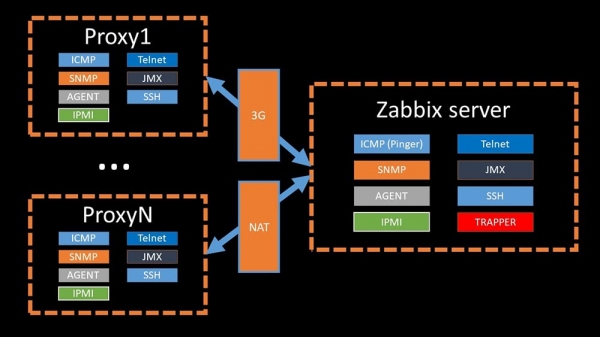
MM: – A arquitetura está clara. Precisamos olhar os códigos-fonte…
Alguns dias depois
A história de como nmap e fping venceram
MM: – Parece que encontrei algo.
MC: – Conte-me!
MM: – Descobri que, nas verificações de disponibilidade, o 'Zabbix' verifica um máximo de 128 hosts simultaneamente. Eu tentei aumentar esse número para 500 e diminui o intervalo entre pacotes no ping – isso aumentou o desempenho em duas vezes. Mas gostaria de números maiores.
MC: – Na minha prática, às vezes preciso verificar a disponibilidade de milhares de hosts, e nada mais rápido que o nmap eu encontrei para isso. Tenho certeza de que é o método mais rápido. Vamos tentar! Precisamos aumentar significativamente o número de hosts por iteração.
MM: – Verificar mais de quinhentos? 600?
MC: – Pelo menos duas mil.
MM: – Ok. A coisa mais importante que queria dizer: descobri que a maioria do polling no 'Zabbix' é feita de forma síncrona. Precisamos mudá-la para o modo assíncrono. Assim, poderemos aumentar drasticamente o número de métricas coletadas pelos pollers, especialmente se aumentarmos o número de métricas por iteração.
MC: – Ótimo! E quando?
MM: – Como sempre, ontem.
MC: – Comparamos ambas as versões fping e nmap:
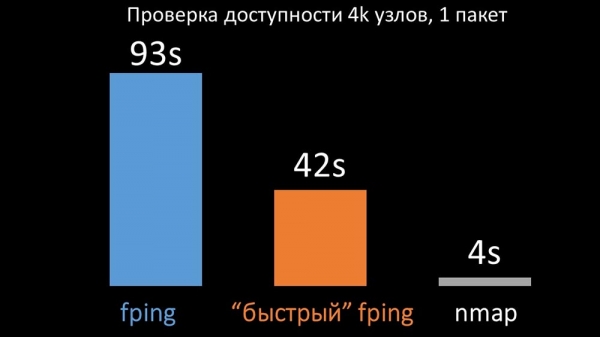
Em um grande número de hosts, o nmap foi, como esperado, até cinco vezes mais eficaz. Como o nmap verifica apenas a acessibilidade e o tempo de resposta, transferimos a contagem de perdas para os gatilhos e reduzimos significativamente os intervalos de verificação de acessibilidade. Descobrimos que a quantidade ideal de hosts para o nmap está em torno de 4 mil por iteração. O nmap nos permitiu reduzir em três vezes o uso da CPU nas verificações de acessibilidade e diminuir o intervalo de 120 segundos para 10.
Otimização do polling
MM: – Em seguida, trabalhamos nos pollers. Nosso principal interesse era a coleta de SNMP e agentes. No 'Zabbix', o polling é feito de forma síncrona e foram tomadas medidas especiais para aumentar a eficiência do sistema. No modo síncrono, a inacessibilidade dos hosts causa uma degradação significativa no polling. Existe um sistema inteiro de estados, existem processos especiais – os chamados pollers inacessíveis, que funcionam apenas com hosts inacessíveis:

Este é um comentário que demonstra a matriz de estados, toda a complexidade do sistema de transições que é necessária para que o sistema permaneça eficiente. Além disso, o próprio polling síncrono é bastante lento:
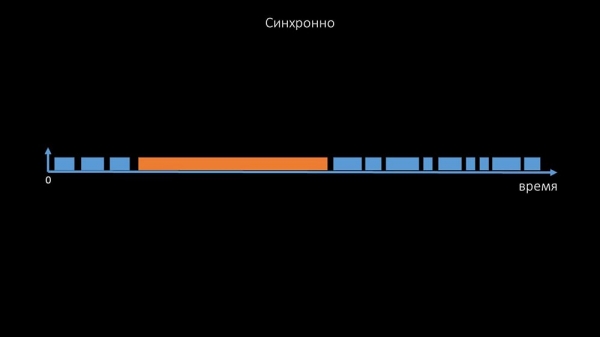
É por isso que milhares de threads de pollers em uma dezena de proxies não conseguiram coletar a quantidade necessária de dados. A implementação assíncrona resolveu não apenas os problemas com a quantidade de threads, mas também simplificou significativamente o sistema de estados dos hosts inacessíveis, porque, independentemente do número de hosts verificados em uma iteração do polling, o tempo máximo de espera era de 1 timeout:
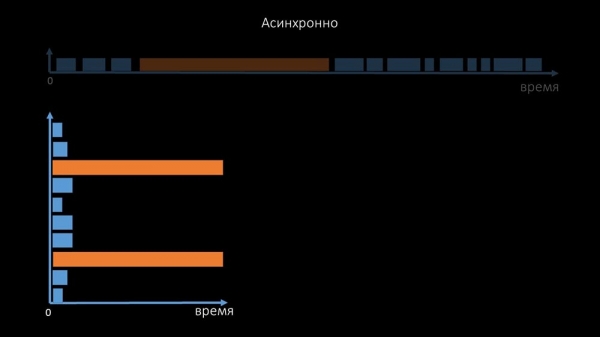
Além disso, modificamos e aprimoramos o sistema de polling para requisições SNMP. O fato é que a maioria não consegue responder a várias requisições SNMP ao mesmo tempo. Portanto, implementamos um modo híbrido, onde o polling SNMP do mesmo host é feito de forma assíncrona:
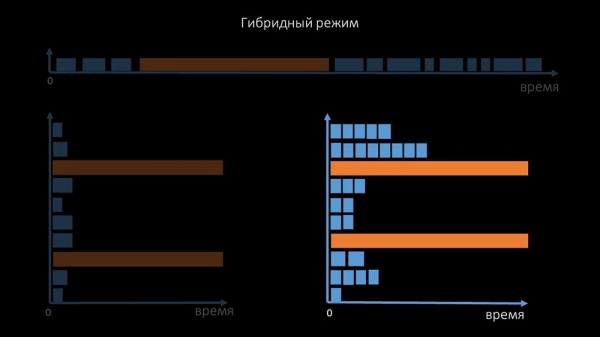
Isso é feito para toda a carga de hosts. Esse modo, no final, não é mais lento do que o totalmente assíncrono, pois a coleta de uma centena e meia de valores SNMP ainda é muito mais rápida do que 1 timeout.
Nossos experimentos mostraram que a quantidade ideal de requisições em uma iteração é de aproximadamente 8 mil durante o polling SNMP. No total, a transição para o modo assíncrono permitiu aumentar a performance do polling em 200 vezes, em várias centenas de vezes.
MC: As otimizações de polling demonstraram que podemos não apenas nos livrar de todos os proxies, mas também reduzir os intervalos em muitas verificações, e os proxies se tornarão desnecessários como forma de distribuição de carga.
Cerca de três meses atrás
Mude a arquitetura – aumente a carga!
MM: Então, Max, está na hora de ir para a produção? Eu preciso de um servidor poderoso e um bom engenheiro.
MC: Certo, vamos planejar. Já está na hora de avançar dos 5 mil metrics por segundo.
Manhã após a atualização
MC: Misha, nós atualizamos, mas até de manhã voltamos atrás... Adivinha qual velocidade conseguimos alcançar?
MM: Cerca de 20 mil no máximo.
MC: Aha, 25! Infelizmente, estamos no mesmo lugar que começamos.
MM: E por que é assim? Alguma diagnóstica foi feita?
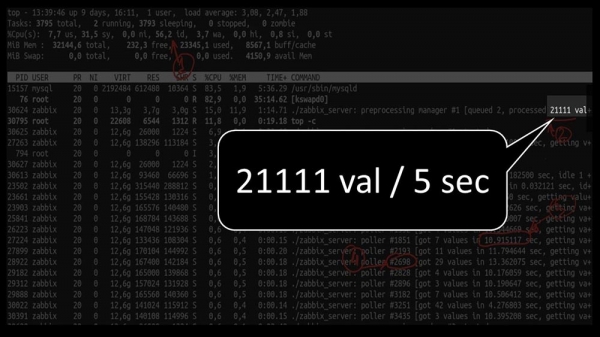
MC: Sim, claro! Aqui, por exemplo, um top interessante:
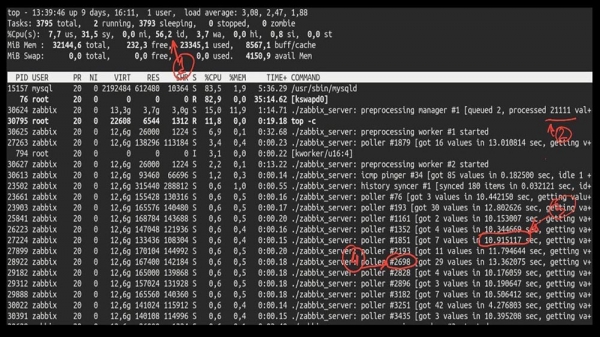
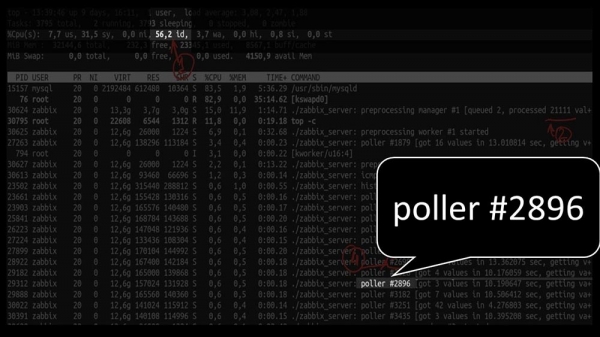
MM: Vamos dar uma olhada. Vejo que tentamos um enorme número de threads de polling:
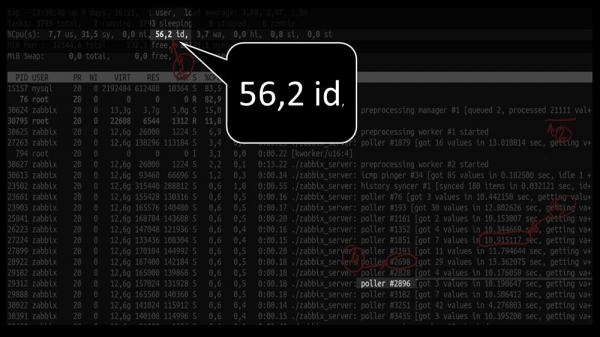
Mas ao mesmo tempo não conseguimos utilizar o sistema nem pela metade:
E a performance geral é bastante baixa, cerca de 4 mil metrics por segundo:
Tem mais alguma coisa?
MC: Sim, strace de um dos pollers:
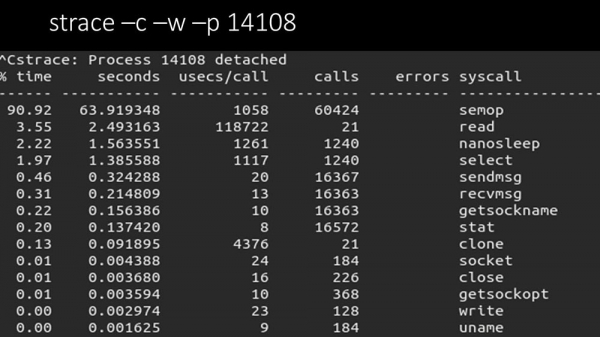
MM: Aqui está claro que o processo de polling está esperando por 'semaforos'. São bloqueios:
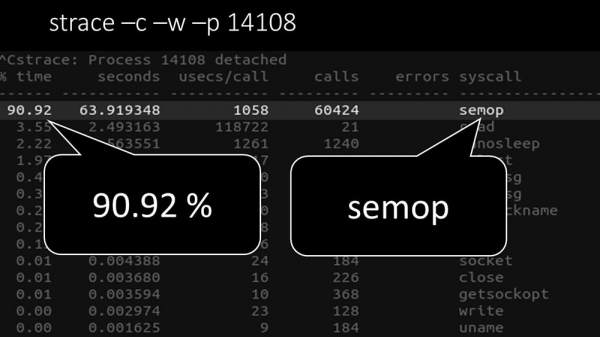
MC: Não está claro.
MM: Olha, isso se parece com uma situação em que um monte de threads está tentando trabalhar com um recurso que pode ser acessado por apenas um de cada vez. Então, tudo o que eles podem fazer é compartilhar esse recurso por tempo:
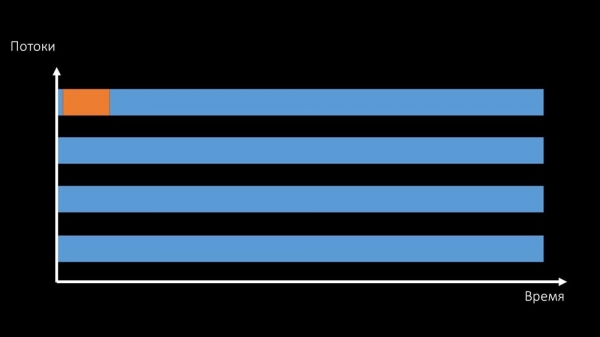
E a produtividade total trabalhando com tal recurso é limitada pela velocidade de um núcleo:
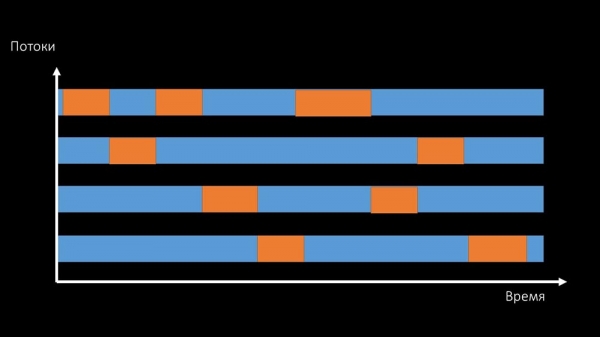
Esse problema pode ser resolvido de duas maneiras.
Aprimorar o hardware da máquina, passando para núcleos mais rápidos:
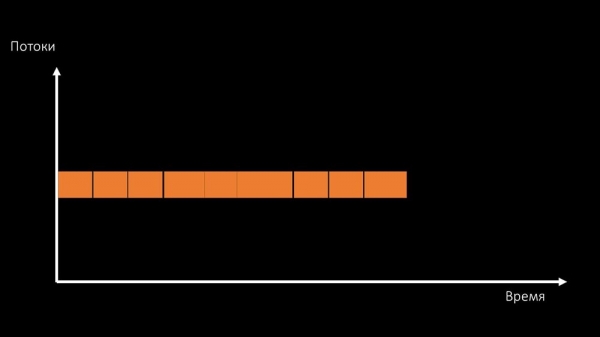
Ou mudar a arquitetura e, ao mesmo tempo – a carga:
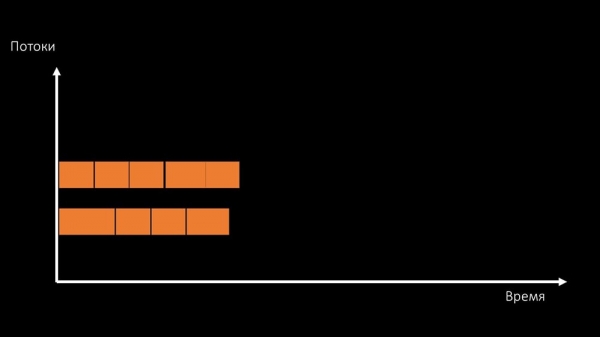
MC: Por falar nisso, na máquina de teste usaremos menos núcleos do que na produção, mas eles são 1,5 vezes mais rápidos em frequência por núcleo!
MM: Entendeu? Precisamos olhar o código do servidor.
O caminho dos dados no servidor Zabbix
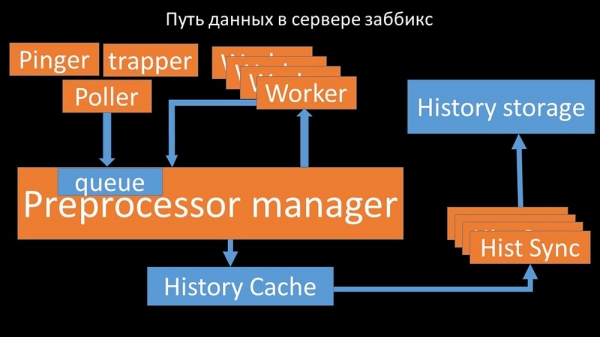
MC: Para entender melhor, começamos a analisar como os dados são transmitidos dentro do servidor 'Zabbix':
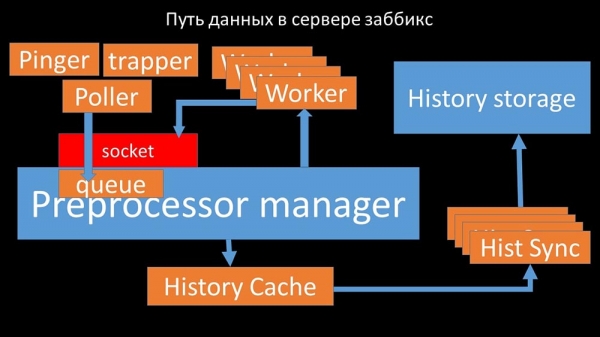
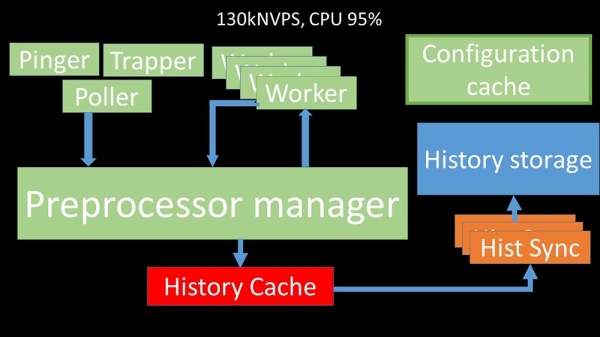
Uma imagem legal, não? Vamos passar por ela passo a passo para esclarecer mais ou menos. Existem threads e serviços responsáveis pela coleta de dados:
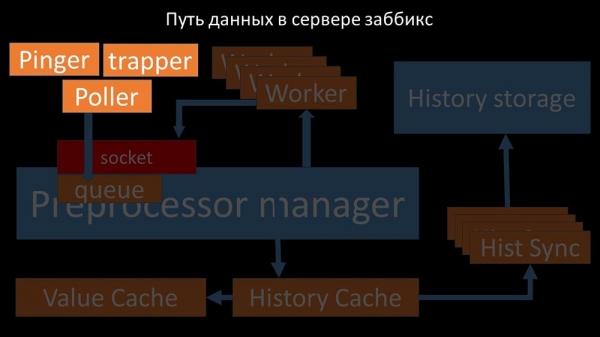
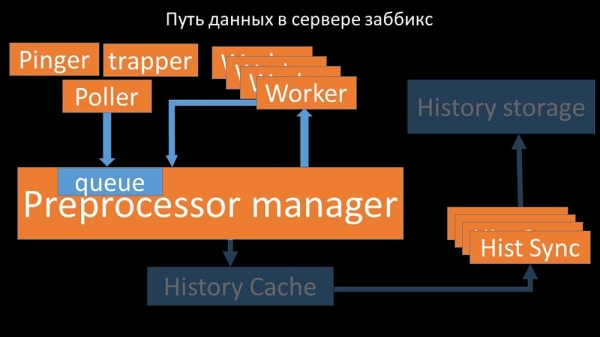
As métricas coletadas são enviadas através de um socket para o Preprocessor manager, onde são armazenadas em uma fila:
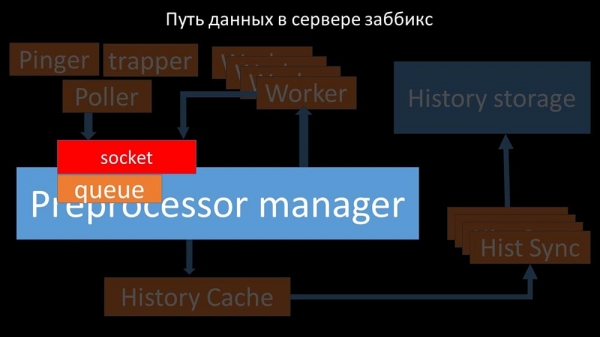
O 'Preprocessor manager' passa os dados para seus trabalhadores, que executam as instruções de pré-processamento e os retornam pelo mesmo socket:
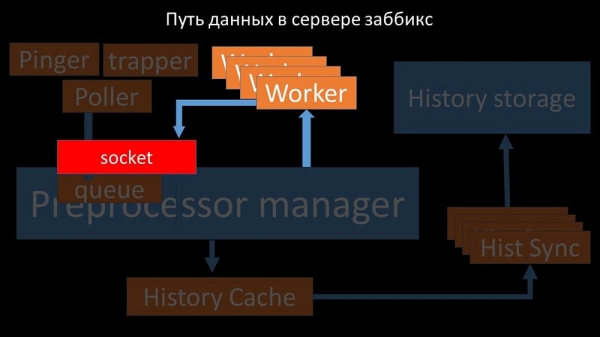
Após isso, o gerenciador de pré-processamento os salva no cache de histórico:
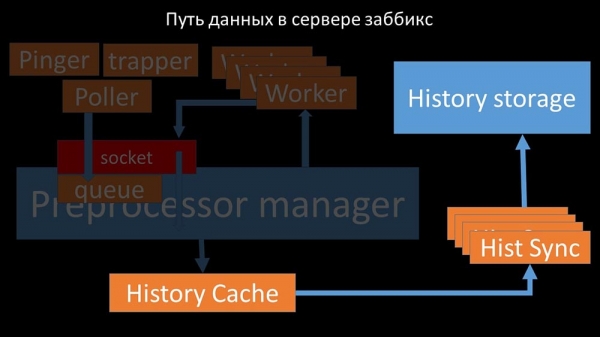
De lá, são retirados pelos sincronizadores de histórico, que desempenham várias funções: por exemplo, cálculo de gatilhos, preenchimento do cache de valores e, o mais importante, salvamento de métricas no armazenamento de histórico. Em geral, o processo é complexo e bastante confuso.
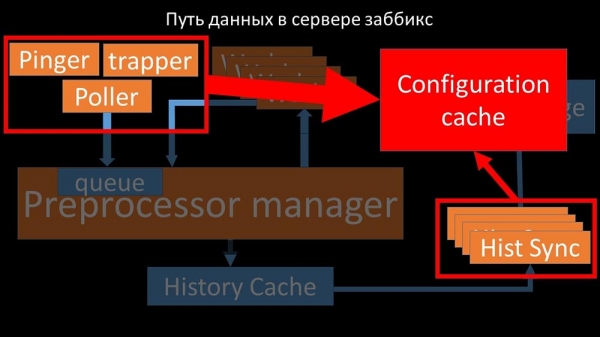
MM: – A primeira coisa que vimos foi que a maioria das threads concorria pelo chamado 'cache de configuração' (área de memória onde estão armazenadas todas as configurações do servidor). Muitos bloqueios eram feitos pelas threads responsáveis pela coleta de dados:
…já que na configuração estão armazenadas não apenas métricas com seus parâmetros, mas também filas, de onde os pollers retiram informações sobre o que fazer a seguir. Quando há muitos pollers, e um bloqueia a configuração, os outros esperam por solicitações:
Os pollers não devem conflitar
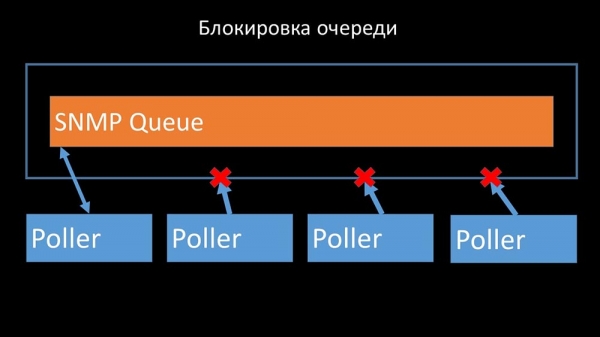
Por isso, a primeira coisa que fizemos foi dividir a fila em 4 partes e permitir que os pollers bloqueassem essas filas, essas partes, simultaneamente em condições seguras:
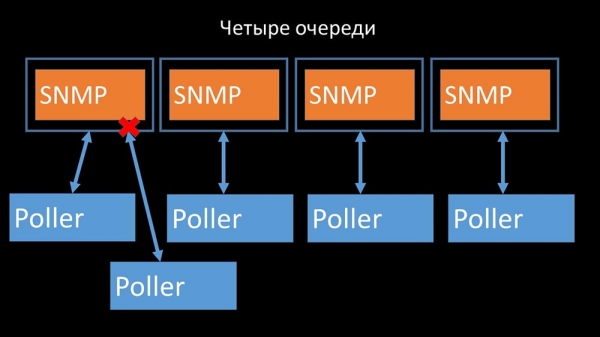
Isso eliminou a concorrência pelo cache de configuração, e a velocidade de operação dos pollers aumentou significativamente. Mas, em seguida, enfrentamos o problema de que o gerenciador de pré-processamento começou a acumular a fila de tarefas:
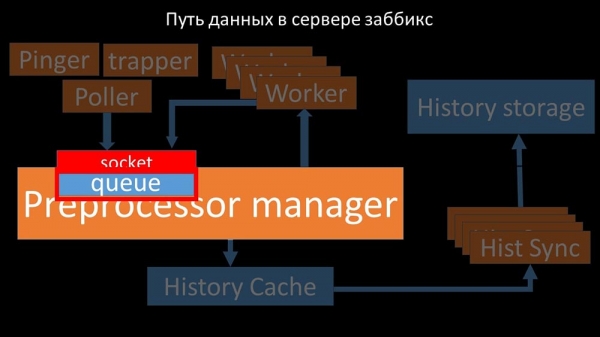
O gerenciador de pré-processamento deve ser capaz de priorizar
Isso acontecia em casos em que ele não tinha desempenho suficiente. Então, tudo o que ele podia fazer era acumular solicitações dos processos de coleta de dados e armazená-las em um buffer até que consumisse toda a memória e falhasse:
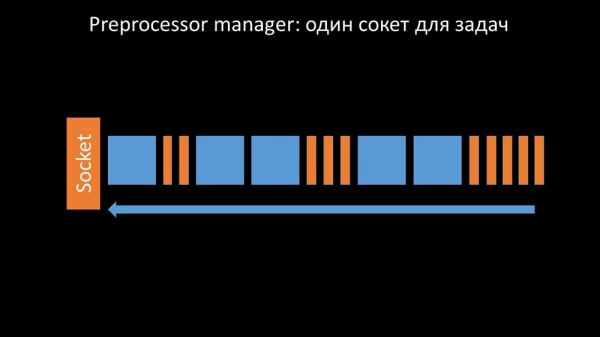
Para resolver esse problema, adicionamos um segundo socket, que foi dedicado especialmente aos workers:
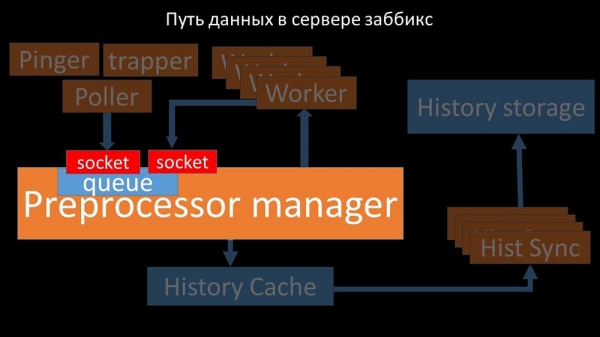
Dessa forma, o gerenciador de pré-processamento obteve a capacidade de priorizar seu trabalho e, em caso de crescimento do buffer, a tarefa era desacelerar a coleta, dando aos workers a oportunidade de pegar esse buffer:
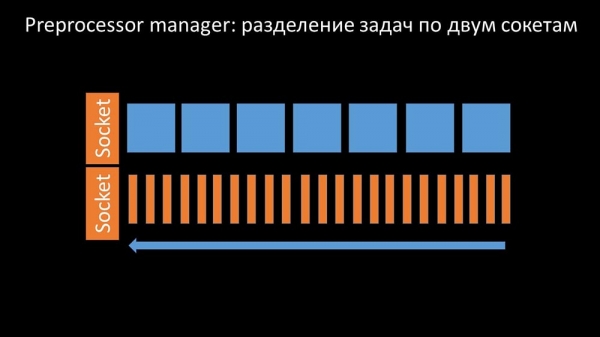
Em seguida, descobrimos que uma das razões para a desaceleração eram os próprios workers, pois competiam por um recurso que não era importante para o seu trabalho. Resolvemos esse problema com um bug-fix, e nas novas versões do 'Zabbix' já está corrigido:
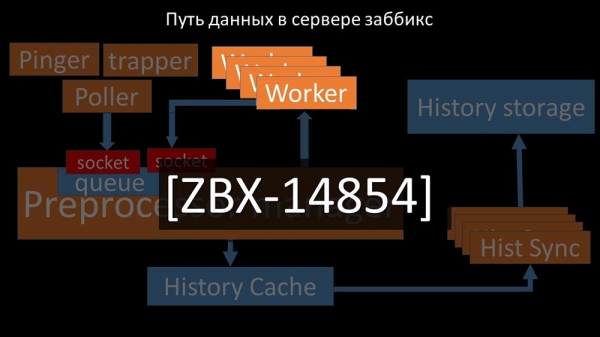
Aumentamos a quantidade de sockets – obtivemos resultados
Depois, o próprio gerenciador de pré-processamento se tornou um gargalo, pois era uma única thread. Ele estava limitado pela velocidade do núcleo, atingindo uma velocidade máxima de cerca de 70 mil métricas por segundo:
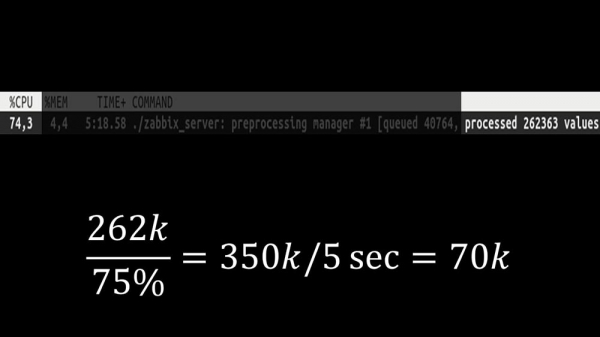
Por isso, fizemos quatro, com quatro conjuntos de sockets, workers:
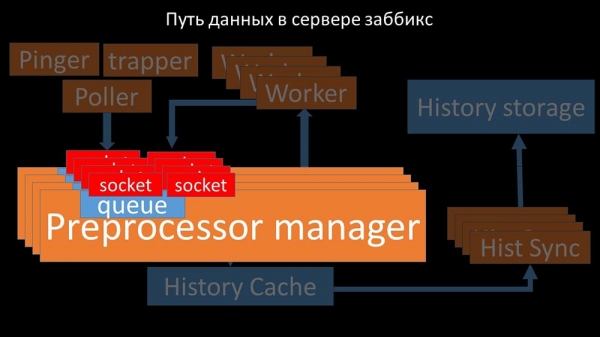
E isso permitiu aumentar a velocidade para cerca de 130 mil métricas:
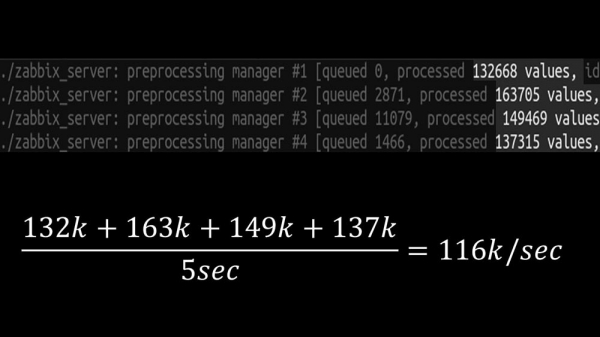
A não linearidade do crescimento se explica pelo fato de que surgiu concorrência pelo cache de histórico. Quatro gerentes de pré-processador e sincronizadores de histórico estavam competindo por isso. Nesse momento, estávamos obtendo cerca de 130 mil métricas por segundo na máquina de teste, utilizando cerca de 95% da CPU:
Cerca de 2,5 meses atrás
A saída do snmp-community aumentou os NVPs em 1,5 vezes
MM: – Max, preciso de uma nova máquina de teste! Não cabemos mais nesta atual.
MC: – E o que temos agora?
MM: – Agora temos 130k NVPs e a CPU "na prateleira".
MC: – Uau! Legal! Espera, eu tenho duas perguntas. Pelas minhas contas, nossa necessidade é em torno de 15-20 mil métricas por segundo. Por que precisamos de mais?
MM: – Quero terminar o trabalho de maneira completa. Quero ver quanto podemos extrair deste sistema.
MC: – Mas...
MM: – Mas para o negócio é inútil.
MC: – Entendi. E a segunda pergunta: o que temos agora, conseguiremos manter sozinhos, sem a ajuda de um desenvolvedor?
MM: – Não acho. Alterar o funcionamento do cache de configuração é um problema. Isso diz respeito a mudanças na maioria dos fluxos e é bastante complicado de manter. Provavelmente, será muito difícil mantê-lo.
MC: – Então precisamos de alguma alternativa.
MM: – Existe essa opção. Podemos mudar para núcleos rápidos, enquanto desistimos do novo sistema de bloqueio. Ainda assim, obteremos um desempenho de 60-80 mil métricas. Podemos manter todo o restante do código. ClickHouse, polling assíncrono funcionarão. E isso será fácil de manter.
MC: – Maravilha! Proponho pararmos por aqui.
Após a otimização da parte do servidor, finalmente conseguimos colocar o novo código em produção. Abandonamos algumas mudanças em favor da mudança para uma máquina com núcleos rápidos e minimização do número de alterações no código. Também simplificamos a configuração e, sempre que possível, desistimos de macros em elementos de dados, pois elas são fontes de bloqueios adicionais.
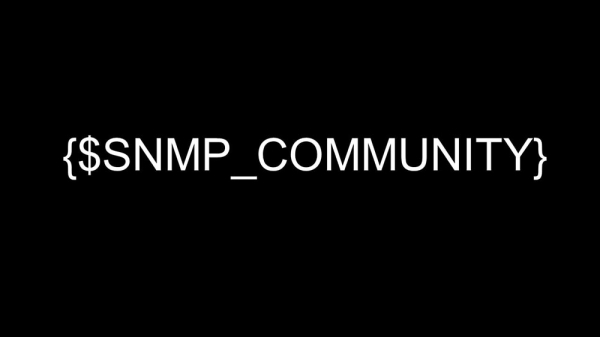
Por exemplo, a saída da macro snmp-community, que é comum na documentação e exemplos, neste caso nos permitiu acelerar ainda mais os NVPs em aproximadamente 1,5 vezes.
Após dois dias em produção
Removemos as janelas pop-up do histórico de incidentes
MC: – Misha, já estamos utilizando o sistema há dois dias e tudo funciona. Mas só quando tudo está funcionando! Tivemos manutenções planejadas com a transferência de um segmento grande da rede, e nós conferimos manualmente o que estava funcionando e o que não estava.
MM: – Não pode ser! Nós conferimos isso 10 vezes. O servidor processa até mesmo a indisponibilidade total da rede instantaneamente.
MC: – Eu entendo tudo: servidor, base, top, austat, logs – tudo rápido… Mas estamos olhando a interface da web, e lá está: o processador 'no espaço' no servidor e isso aqui:
MM: – Entendido. Vamos analisar a web. Descobrimos que, na situação em que havia um grande número de incidentes ativos, a maioria dos widgets de desempenho começava a funcionar muito lentamente:
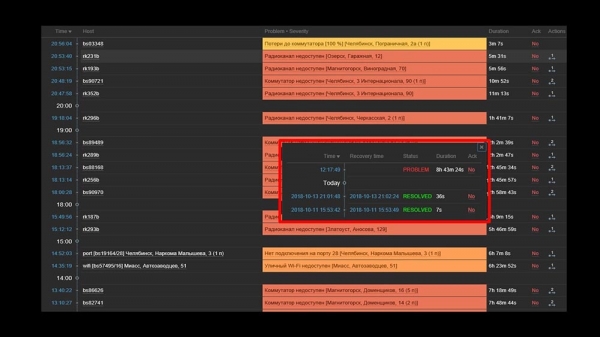
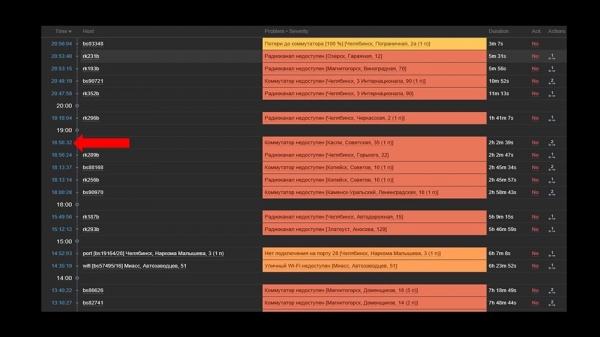
A razão para isso era a geração de janelas pop-up com o histórico de incidentes, que são geradas para cada elemento da lista. Portanto, desistimos de gerar essas janelas (comentamos 5 linhas no código), e isso resolveu nossos problemas.
O tempo de carregamento dos widgets, mesmo em total indisponibilidade, foi reduzido de vários minutos para aceitáveis 10-15 segundos, e o histórico ainda pode ser visualizado ao clicar no tempo:
Após o trabalho. Há 2 meses atrás
MC: – Misha, você está saindo? Precisamos conversar.
MM: – Não estava planejando. Algo de novo com o 'Zabbix'?
MC: – Não, relaxa! Eu só queria dizer: tudo funciona, obrigado! A próxima rodada é por minha conta.
Zabbix é eficiente
O 'Zabbix' é um sistema e ferramenta bastante versátil e rica. Pode ser utilizado para pequenas instalações 'pronto para uso', mas à medida que as necessidades crescem, é necessário otimizá-lo. Para armazenar um grande arquivo de métricas, use um armazenamento apropriado:
- pode-se utilizar os recursos integrados de integração com o 'Elasticsearch' ou exportar o histórico para arquivos de texto (disponível a partir da quarta versão);
- pode-se aproveitar nossa experiência e integração com o 'ClickHouse'.
Para aumentar drasticamente a velocidade de coleta de métricas, colete-as por métodos assíncronos e envie-as através da interface trapper para o servidor 'Zabbix'; ou utilize um patch para a assíncrona dos pollers do próprio 'Zabbix'.
O Zabbix é escrito em C e é bastante eficiente. Algumas soluções arquitetônicas limitadas também permitem aumentar sua performance e, de acordo com nossa experiência, obter mais de 100 mil métricas em uma máquina de um único processador.
Aquele patch do Zabbix
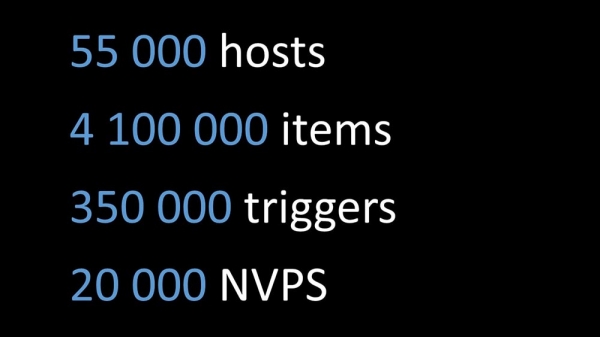
MM: – Eu quero acrescentar alguns pontos. Todo o relatório atual, todos os testes e números apresentados são para a configuração que usamos. Com isso, estamos coletando cerca de 20 mil métricas por segundo. Se você está tentando entender se isso funcionará para você - pode comparar. O que foi discutido hoje está disponível no GitHub como um patch:
O patch inclui:
- integração completa com ClickHouse (tanto no servidor Zabbix quanto no front-end);
- solução de problemas com o pré-processador;
- polling assíncrono.
O patch é compatível com toda a versão 4, incluindo lts. Provavelmente, com alterações mínimas, funcionará na versão 3.4.
Obrigado pela atenção.
Perguntas
Pergunta da audiência (a seguir – A): – Boa tarde! Por favor, você tem planos para uma interação intensa com a equipe do Zabbix ou eles com vocês, de modo que isso não seja um patch, mas um comportamento normal do Zabbix?
MM: – Sim, parte das mudanças certamente será comprometida. Algumas coisas permanecerão no patch.
A: – Muito obrigado pela ótima apresentação! Poderia me informar, por favor, após aplicar o patch, o suporte por parte do Zabbix continuará e como será a atualização para versões mais altas? Haverá a possibilidade de atualizar o Zabbix após seu patch para 4.2, 5.0?
MM: – Sobre o suporte, não posso comentar. Se eu fosse o suporte técnico do Zabbix, provavelmente diria não, porque é código de terceiros. Em relação à base de código 4.2, nossa posição é a seguinte: "Nós iremos acompanhar as atualizações e nos atualizaremos para a próxima versão". Portanto, por algum tempo, publicaremos patches para versões atualizadas. Já mencionei na apresentação que o número de mudanças entre as versões ainda é relativamente pequeno. Acredito que a migração de 3.4 para 4 levou cerca de 15 minutos. Algumas coisas mudaram, mas não de forma significativa.
A: – Ou seja, vocês planejam manter seu patch e é seguro instalá-lo em produção, recebendo atualizações de alguma forma?
MM: – Nós recomendamos categoricamente. Isso resolve muitos problemas para nós.
MC: – Mais uma vez, gostaria de ressaltar que as mudanças que não dizem respeito à arquitetura e não envolvem bloqueios ou filas são modulares, estão em módulos separados. Mesmo alterações menores podem ser mantidas com relativa facilidade.
MM: – Se você está interessado nos detalhes, o Clickhouse utiliza uma chamada biblioteca de histórico. Ela é independente – é uma cópia do suporte do Elasticsearch, ou seja, é configurável. O polling muda apenas os pollers. Acreditamos que isso funcionará por um longo tempo.
A: – Muito obrigado. E você poderia me dizer se há alguma documentação das mudanças feitas?
MM: – A documentação é o patch. Óbvio que, com a introdução do Clickhouse e novos tipos de pollers, surgem novas opções de configuração. No link do último slide, há uma breve descrição de como utilizá-las.
Sobre a substituição do fping pelo nmap
A: – Como você implementou isso no final? Pode dar exemplos específicos: você usa strappers e um script externo? O que verifica tão rapidamente um enorme número de hosts? Como você obtém esses hosts? É preciso alimentar o nmap de alguma forma, conseguir de algum lugar, colocar, executar...?
MM: – Legal. Muito boa pergunta! A essência é a seguinte. Modificamos a biblioteca (ICMP ping, parte do Zabbix) para verificações ICMP, onde o número de pacotes especificados é um (1), e o código tenta usar o nmap. Ou seja, isso se tornou o trabalho interno do Zabbix, agora um trabalho interno do pinger. Portanto, nenhuma sincronização ou uso de trapping é necessário. Isso foi feito intencionalmente para manter o sistema íntegro e evitar a sincronização de duas bases: o que verificar, carregar através do poller, e se a carga não falhou... É muito mais simples.
A: – Isso também funciona para proxies?
MM: – Sim, mas não testamos. O código de polling é o mesmo no Zabbix e no servidor. Deve funcionar. Reitero: a performance do sistema é tal que não precisamos de proxies.
MC: – A resposta correta para a pergunta é: "Por que você precisaria de proxies em um sistema como este?" Apenas por causa do NAT ou para monitorar através de um canal lento…
A: – Vocês usam o Zabbix como um alerta, se eu entendi corretamente. Ou os gráficos (onde o armazenamento de arquivos) foram transferidos para outro sistema, como Grafana? Ou vocês não utilizam essa funcionalidade?
MM: – Eu reitero: fizemos uma integração completa. Estamos despejando o histórico no "ClickHouse", mas ao mesmo tempo, alteramos o frontend em PHP. O frontend em PHP acessa o "ClickHouse" e gera todos os gráficos a partir de lá. Entretanto, para ser sincero, temos uma parte que constrói a partir do mesmo "ClickHouse", com os mesmos dados do "Zabbix" para gerar dados em outros sistemas de visualização gráfica.
MC: – No "Grafana", inclusive.
Como foi tomada a decisão sobre a alocação de recursos?
A: – Compartilhe um pouco da cozinha interna. Como foi tomado a decisão de que era necessário alocar recursos para uma reformulação significativa do produto? Isso, de fato, implica certos riscos. E diga, por favor, no contexto de que você pretende suportar novas versões: como essa decisão se justifica do ponto de vista da gestão?
MM: – Aparentemente, não contamos bem a dramática da história. Nos encontramos em uma situação onde algo precisava ser feito, e seguimos, na verdade, com duas equipes paralelas:
- Uma se ocupava do lançamento de um sistema de monitoramento com novos métodos: monitoramento como serviço, um conjunto padrão de soluções open source que combinamos e em seguida tentamos modificar o processo de negócios para trabalhar com o novo sistema de monitoramento.
- Em paralelo, tínhamos um programador entusiasta que se dedicava a isso (sobre si mesmo). Aconteceu que ele venceu.
A: – E qual é o tamanho da equipe?
MC: – Ela está diante de você.
A: – Ou seja, como sempre, é necessário um passional?
MM: – Não sei o que é passional.
A: – Neste caso, aparentemente, você. Muito obrigado, vocês são incríveis.
MM: – Obrigado.
Sobre patches para Zabbix
A: – Para um sistema que utiliza proxy (por exemplo, em alguns sistemas distribuídos), é possível adaptar e aplicar seu patch, digamos, nos pollers, proxies e parcialmente no pré-processador do próprio "Zabbix"; e sua interação? É possível otimizar as implementações existentes para um sistema com múltiplos proxies?
MM: – Eu sei que o servidor "Zabbix" é montado com a ajuda de proxy (é compilado e resulta em código). Não verificamos isso em produção. Não estou certo, mas, ao que parece, o gerente do pré-processador não é utilizado no proxy. A tarefa do proxy é pegar um conjunto de métricas do "Zabbix", descartá-las (ele também grava a configuração, o banco local) e devolver ao servidor "Zabbix". O pré-processamento será feito depois pelo próprio servidor, quando o receber.
O interesse por proxies é compreensível. Vamos verificar isso. É um assunto interessante.
A: – A ideia era a seguinte: se é possível aplicar patches nos pollers, podemos aplicar patches nos proxies e ajustar a interação com o servidor, e adaptar o pré-processador apenas no servidor para esses fins.
MM: – Acho que tudo é ainda mais simples. Você pega o código, aplica o patch, depois configura conforme necessário – reúne proxies (por exemplo, com ODBC) e distribui o código patchado pelos sistemas. Onde for necessário, reúne proxies, onde for necessário, o servidor.
A: – Provavelmente não será preciso aplicar patches adicionais na transmissão de proxies para o servidor?
MC: – Não, é padrão.
MM: – Na verdade, uma das ideias não foi mencionada. Sempre mantivemos o equilíbrio entre a explosão de ideias e a quantidade de alterações, além da facilidade de manutenção.
Um pouco de publicidade 🙂
Obrigado por permanecer conosco. Você gosta dos nossos artigos? Quer ver mais materiais interessantes? Apoie-nos fazendo um pedido ou recomendando para conhecidos. , uma alternativa única aos servidores entry-level, que criamos para você: (disponíveis opções com RAID1 e RAID10, até 24 núcleos e até 40GB DDR4).
Dell R730xd por 2 vezes mais barato no datacenter Equinix Tier IV em Amsterdã? Somente conosco na Holanda! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — a partir de $99! Leia sobre
Fonte: habr.com
