

A próxima conferência HighLoad++ ocorrerá nos dias 6 e 7 de abril de 2020 em São Petersburgo.
Detalhes e ingressos . HighLoad++ Sibéria 2019. Sala "Krasnoyarsk". 25 de junho, 12:00. Teses e .
Às vezes, as demandas práticas entram em conflito com a teoria, onde aspectos importantes para um produto comercial não são considerados. Nesta apresentação, será apresentado o processo de seleção e combinação de diferentes abordagens para a criação de componentes de consistência causal com base em pesquisas acadêmicas, levando em consideração os requisitos de um produto comercial. Os ouvintes aprenderão sobre as abordagens teóricas existentes em relógios lógicos, rastreamento de dependências, segurança de sistemas, sincronização de relógios e por que o MongoDB optou por determinadas soluções.
Mikhail Tyulenev (daqui em diante – MT): – Vou falar sobre a consistência causal – é um recurso em que trabalhamos no MongoDB. Eu trabalho no grupo de sistemas distribuídos, nós o desenvolvemos há cerca de dois anos.
Durante o processo, tive que me familiarizar com uma grande quantidade de pesquisa acadêmica, porque esse recurso é bastante estudado. Ficou claro que nenhum artigo se encaixa exatamente no que é necessário em produção, considerando os requisitos bastante específicos que existem, provavelmente, em qualquer aplicativo de produção.
Vou falar sobre como nós, enquanto consumidores de pesquisa acadêmica, preparamos algo que podemos apresentar aos nossos usuários como um prato acabado, que seja conveniente e seguro para uso.
Consistência causal (Causal consistency). Vamos definir os conceitos
Para começar, quero falar em termos gerais sobre o que é a consistência causal. Existem dois personagens – Leonard e Penny (da série "The Big Bang Theory"):
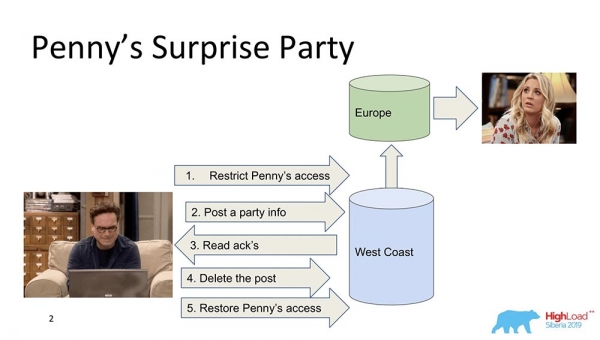
Suponha que Penny esteja na Europa, e Leonard queira fazer uma surpresa para ela, uma festa. E não consegue pensar em nada melhor do que retirá-la da lista de amigos, enviar a todos os amigos uma atualização no feed: "Vamos alegrar a Penny!" (ela está na Europa, enquanto dorme, não vê nada disso e não pode ver, porque não está lá). No final, ele exclui essa postagem, apaga do "Feed" e restaura o acesso, para que ela não perceba nada e não haja escândalo.
Isso tudo é maravilhoso, mas vamos supor que o sistema seja distribuído e os eventos não ocorreram exatamente como planejado. Por exemplo, pode acontecer que a limitação de acesso de Penny tenha ocorrido depois que esta postagem foi publicada, caso os eventos não estejam relacionados por uma causalidade. Na verdade, isso é um exemplo de quando a consistência causal é necessária para que uma função de negócios (neste caso) seja executada.
Na verdade, essas são propriedades bastante não triviais de bancos de dados – muito poucas as suportam. Vamos passar para os modelos.
Modelos de consistência
O que é um modelo de consistência em bancos de dados? São algumas garantias que um sistema distribuído oferece sobre quais dados e em que sequência o cliente pode receber.
Basicamente, todos os modelos de consistência se resumem a quão similar um sistema distribuído é a um sistema que opera, por exemplo, em um único nó em um laptop. E o quanto um sistema que opera em milhares de "nós" geograficamente distribuídos se assemelha ao laptop, onde todas essas propriedades são cumpridas automaticamente.
Portanto, os modelos de consistência se aplicam apenas a sistemas distribuídos. Todos os sistemas existentes anteriormente, que operavam em escalabilidade vertical, não enfrentavam esses problemas. Havia um único Buffer Cache, e tudo era sempre lido dele.
Modelo Forte
Na verdade, o primeiro modelo é o Forte (ou a linha de capacidade, como muitas vezes é chamado). Este é um modelo de consistência que garante que cada alteração, assim que recebe a confirmação de sua realização, se torna visível para todos os usuários do sistema.
Isso cria uma ordem global de todos os eventos no banco de dados. Esta é uma propriedade de consistência muito forte e, na verdade, é bastante cara. No entanto, é muito bem suportada. É apenas muito cara e lenta – e portanto raramente utilizada. Isso é chamado de capacidade.
Há outra propriedade, ainda mais forte, que é suportada no "Spanner" – chamada de Consistência Externa. Vamos falar sobre isso um pouco mais tarde.
Causal
A seguir está o Causal, exatamente do que eu estava falando. Entre Strong e Causal existem vários subníveis, dos quais não vou falar, mas todos eles se referem ao Causal. Este é um modelo importante, pois é o mais forte de todos os modelos, apresentando a mais forte consistência em caso de rede ou partições.
Causals são, propriamente dito, a situação em que os eventos estão relacionados por uma relação de causa e efeito. Muitas vezes, eles são percebidos como Read your on rights do ponto de vista do cliente. Se o cliente observou alguns valores, ele não pode ver os valores que estavam no passado. Ele já começa a ver leituras prefixadas. Tudo isso se resume à mesma questão.
Causals como modelo de consistência – uma ordenação parcial de eventos no servidor, onde eventos de todos os clientes são observados na mesma sequência. Neste caso – Leonard e Penny.
Eventual
O terceiro modelo é a Eventual Consistency. Este é o que todas as sistemas distribuídos absolutamente suportam, sendo o modelo mínimo que faz sentido. Isso significa o seguinte: quando temos algumas alterações nos dados, elas, em algum momento, se tornam consistentes.
Nesse momento, ela não diz nada, caso contrário, se tornaria External Consistency – seria uma história completamente diferente. No entanto, este é um modelo muito popular, o mais amplamente utilizado. Por padrão, todos os usuários de sistemas distribuídos utilizam a Eventual Consistency.
Quero trazer alguns exemplos comparativos:
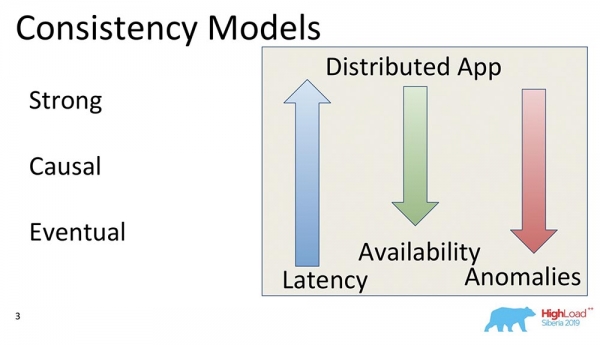
O que essas setas significam?
- Latência. Com o aumento da força da consistência, ela se torna maior por razões compreensíveis: é necessário fazer mais gravações, obter confirmação de todos os hosts e nós que participam do cluster que os dados já estão lá. Assim, na Eventual Consistency, a resposta é a mais rápida, pois, geralmente, pode-se até mesmo fazer o commit em memória e isso será, em princípio, suficiente.
- Disponibilidade. Se compreendermos isso como a capacidade do sistema de responder na presença de falhas na rede, partições ou alguma outra falha – a resiliência aumenta à medida que o modelo de consistência diminui, uma vez que é suficiente que um host esteja ativo e forneça alguns dados. A Eventual Consistency não garante nada em relação aos dados – pode ser qualquer coisa.
- Anomalias. Ao mesmo tempo, é claro que o número de anomalias aumenta. Na consistência forte, elas praticamente não deveriam existir, enquanto na consistência eventual, podem ocorrer de qualquer forma. Surge a pergunta: por que as pessoas escolhem a consistência eventual, se ela contém anomalias? A resposta é que os modelos de consistência eventual são aplicáveis, e as anomalias existem, por exemplo, por um curto período; há a possibilidade de usar uma cópia para leitura e obter dados mais ou menos consistentes; frequentemente há a opção de utilizar modelos de consistência mais robustos. Na prática, isso funciona, e muitas vezes o número de anomalias é limitado no tempo.
Teorema CAP
Quando você vê as palavras consistência, disponibilidade – o que vem à sua mente? Certo – o teorema CAP! Agora quero desmistificar… Não sou eu – é Martin Kleppmann, que escreveu um excelente artigo, um ótimo livro.
O teorema CAP é um princípio formulado nos anos 2000, que diz que Consistência, Disponibilidade, Partições: escolha qualquer dois, e não é possível ter os três. Essa foi uma espécie de princípio. Ele foi provado como um teorema alguns anos depois, feito por Gilbert e Lynch. Depois, passou a ser utilizado como um mantra – os sistemas começaram a se dividir em CA, CP, AP, e assim por diante.
Esse teorema foi realmente provado para os seguintes casos... Primeiro, a Disponibilidade não foi considerada como um valor contínuo de zero a cem (0 – sistema 'morto', 100 – responde rapidamente; é assim que estamos acostumados a ver), mas como uma propriedade do algoritmo, que garante que em todas as suas execuções, ele retorna dados.
Não se fala nada sobre o tempo de resposta! Há um algoritmo que retorna dados em 100 anos – um algoritmo disponível absolutamente maravilhoso, que é parte do teorema CAP.
Em segundo lugar: o teorema foi provado para alterações nos valores de uma mesma chave, sendo essas alterações uma linha redimensionável. Isso significa que na prática, elas são raramente utilizadas, pois existem outros modelos como Consistência Eventual, Consistência Forte (pode ser).
Para que tudo isso? Para mostrar que o teorema CAP, na forma em que foi provado, é praticamente inapplicável, raramente utilizado. Na forma teórica, ele de alguma forma limita tudo. Surge assim um princípio que é intuitivamente verdadeiro, mas não está de fato provado.
Consistência causal – é o modelo mais forte
O que está acontecendo agora é que se pode obter as três coisas: Consistência, Disponibilidade com a ajuda de Partições. Em particular, a consistência causal – é o modelo de consistência mais forte, que mesmo na presença de Partições (interrupções na rede) ainda funciona. Por isso, é de grande interesse, e foi por isso que nos dedicamos a isso.
Isso, em primeiro lugar, simplifica o trabalho dos desenvolvedores de aplicativos. Em particular, a grande quantidade de suporte do servidor: quando todos os registros que ocorrem dentro de um único cliente chegam garantidamente em tal sequência para outro cliente. Em segundo lugar, ela suporta partições.
Os bastidores do MongoDB
Lembrando que é hora do almoço, nós nos dirigimos à cozinha. Eu vou explicar o modelo do sistema, ou seja, o que é o MongoDB para aqueles que estão ouvindo sobre esse banco de dados pela primeira vez.
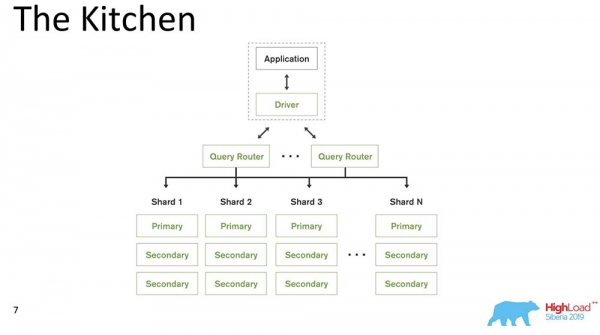
MongoDB (daqui em diante – «MongoDB») é um sistema distribuído que suporta escalabilidade horizontal, ou seja, sharding; e dentro de cada shard, também suporta redundância de dados, ou seja, replicação.
O sharding no «MongoDB» (um banco de dados não relacional) realiza balanceamento automático, ou seja, cada coleção de documentos (ou «tabela» nos termos de dados relacionais) é dividida em pedaços, e o servidor automaticamente os movimenta entre os shards.
O Query Router, que distribui as requisições, é um cliente através do qual o cliente trabalha. Ele já sabe onde e quais dados estão, e direciona todas as requisições para o shard correto.
Outro ponto importante: o MongoDB é um único master. Há um Primary – ele pode receber registros que suportam as chaves que possui. Não é possível fazer a gravação em múltiplos mestres.
Lançamos a versão 4.2 – lá apareceram novas coisas interessantes. Em particular, inserimos o Lucene – busca – exatamente o java executável dentro do «Mongo», e agora é possível fazer buscas através do Lucene, assim como no «Elástico».
E criamos um novo produto – Charts, que também está disponível no «Atlas» (o próprio Cloud do «Mongo»). Eles têm uma Free Tier – pode-se brincar com isso. Eu gostei muito do Charts – visualização de dados muito intuitiva.
Ingredientes da consistência causal
Eu contei cerca de 230 artigos que foram publicados sobre esse tema – de Leslie Lampert. Agora, da minha memória, eu vou compartilhar algumas partes desses materiais com vocês.
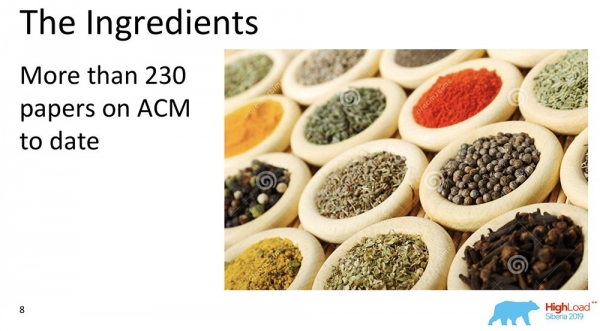
Tudo começou com o artigo de Leslie Lampert, escrito na década de 1970. Como você pode ver, ainda há pesquisas em andamento sobre esse tema. Atualmente, a consistência causal está despertando interesse devido ao desenvolvimento de sistemas distribuídos.
Restrições
Quais são as restrições? Este é realmente um dos principais pontos, pois as limitações impostas por sistemas de produção diferem muito das restrições existentes em artigos acadêmicos. Muitas vezes, elas são bastante artificiais.
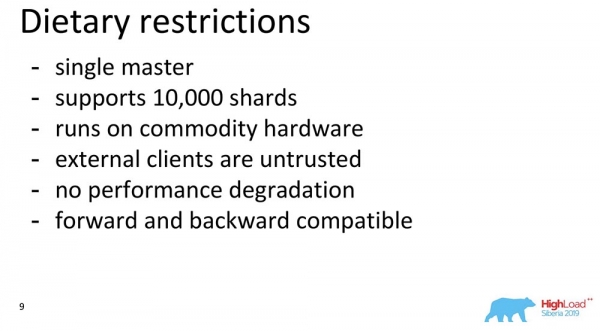
- Primeiro, ‘MongoDB’ é um mestre único, como já mencionei (isso simplifica bastante).
- Acreditamos que o sistema deve suportar cerca de 10 mil shards. Não podemos tomar decisões arquitetônicas que limitem esse valor.
- Temos uma nuvem, mas acreditamos que o usuário deve ter a capacidade de baixar um binário e executá-lo em seu laptop, e tudo deve funcionar perfeitamente.
- Supomos que na pesquisa raramente se use: clientes externos podem fazer o que quiserem. ‘MongoDB’ é open source. Portanto, os clientes podem ser inteligentes ou maliciosos – podem querer quebrar tudo. Supomos que podem ocorrer falhas bizantinas.
- Para clientes externos, que estão fora do perímetro – uma limitação importante: se esse recurso estiver desativado, não deve haver degradação de desempenho.
- Outro ponto – completamente anti-acadêmico: compatibilidade de versões anteriores e futuras. Drivers antigos devem suportar novas atualizações, e o banco de dados deve suportar drivers antigos.
No geral, tudo isso impõe restrições.
Componentes da consistência causal
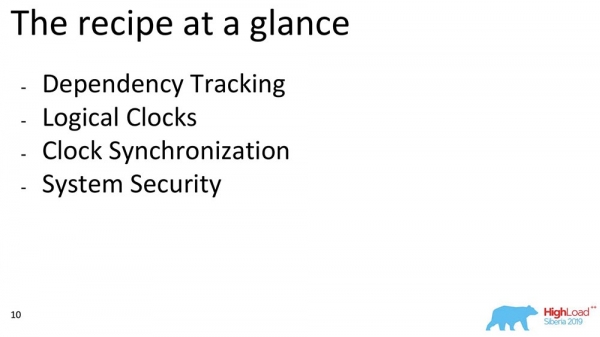
Agora falarei sobre alguns componentes. Se considerarmos a consistência causal em geral, podemos destacar blocos. Escolhemos trabalhos que se relacionam a cada bloco: rastreamento de dependências, escolha de relógios, como sincronizar esses relógios entre si e como garantimos a segurança – este é um plano geral do que discutirei:
Rastreamento completo de dependências (Full Dependency Tracking)
Para que serve isso? Para que, quando os dados são replicados, cada registro e cada alteração contenham informações sobre as mudanças das quais dependem. A primeira e mais ingênua alteração é quando cada mensagem que contém um registro também traz informações sobre mensagens anteriores:
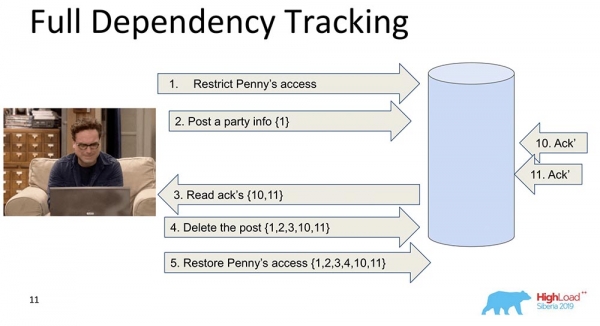
Neste exemplo, o número entre chaves é o número dos registros. Às vezes, esses registros com valores são transmitidos inteiros, às vezes, algumas versões são passadas. A essência é que cada alteração contém informações sobre a anterior (isso está claramente implícito).
Por que decidimos não usar essa abordagem (rastreamento completo)? Obviamente, porque essa abordagem é imprática: qualquer alteração em uma rede social depende de todas as alterações anteriores nessa rede social, transmitindo, por exemplo, "Facebook" ou "Vkontakte" em cada atualização. No entanto, existem muitos estudos sobre o Full Dependency Tracking – isso é pre-rede social, para algumas situações realmente funciona.
Rastreamento de Dependências Explícitas (Explicit Dependency Tracking)
O próximo é mais limitado. Aqui também se analisa a transmissão de informações, mas apenas aquelas que são explicitamente dependentes. O que depende de quê é, geralmente, definido pela Aplicação. Quando os dados são replicados, respostas são fornecidas apenas quando as dependências anteriores foram atendidas, ou seja, exibidas. Essa é a essência de como funciona a consistência causal.
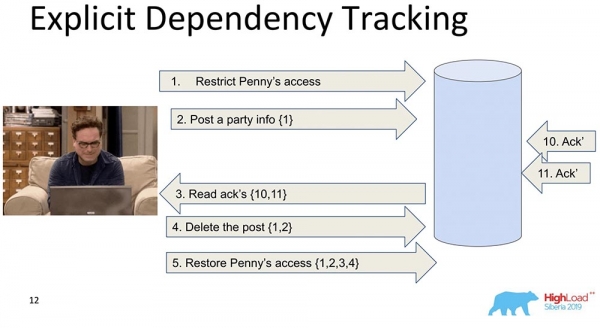
Ela vê que o registro 5 depende dos registros 1, 2, 3, 4 – portanto, ela espera antes que o cliente acesse as mudanças feitas pela decisão de acesso de Penny, quando todas as mudanças anteriores já passaram pelo banco de dados.
Isso também não nos agrada, porque ainda assim há informação demais, e isso acabará tornando tudo mais lento. Existe outra abordagem…
Relógio de Lamport (Lamport Clock)
Eles são muito antigos. O Relógio de Lamport implica que essas dependências se condensam em uma função escalar, que é chamada de Relógio de Lamport.
A função escalar é um número abstrato. Muitas vezes é chamado de tempo lógico. A cada evento, esse contador aumenta. O contador que é conhecido pelo processo atualmente envia cada mensagem. É claro que os processos podem estar dessincronizados e ter tempos completamente diferentes. No entanto, esse tipo de troca de mensagens permite que o sistema balanceie os relógios de alguma forma. O que acontece neste caso?
Eu dividi aquele grande shard em dois para ficar mais claro: os Friends podem viver em um nó que contém uma parte da coleção, enquanto o Feed pode estar em um outro nó que contém uma parte dessa coleção. Como eles podem não ficar na fila? Primeiro o Feed dirá: 'Replicado', e depois os Friends. Se o sistema não oferecer garantias de que o Feed não será mostrado até que as dependências dos Friends na coleção de Friends também sejam entregues, teremos exatamente a situação que mencionei.
Você pode ver como o tempo lógico do contador aumenta no Feed:
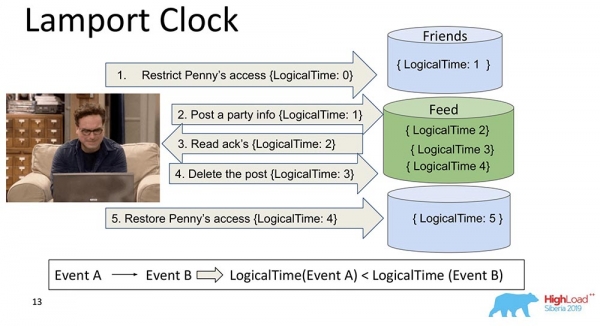
Assim, a propriedade principal desse Relógio de Lamport e Consistência Causal (explicada através do Relógio de Lamport) é a seguinte: se temos os eventos A e B, e o evento B depende do evento A *, então isso implica que o LogicalTime do Evento A é menor que o LogicalTime do Evento B.
* Às vezes, diz-se que A aconteceu antes de B, ou seja, A ocorreu antes de B – esse é um relacionamento que parcialmente ordena todo o conjunto de eventos que realmente aconteceram.
O inverso não é verdade. Esse é, na verdade, um dos principais contras do Relógio de Lamport – a ordem parcial. Há o conceito de eventos simultâneos, ou seja, eventos em que nem (A aconteceu antes de B) nem (A aconteceu depois de B) se aplicam. Um exemplo pode ser a adição paralela de alguém como amigo por Leonard (não por Leonard, mas por Sheldon, por exemplo).
Essa é uma propriedade que é frequentemente utilizada ao trabalhar com relógios de Lamport: observa-se precisamente a função e a partir disso se deduz – pode ser que esses eventos sejam dependentes. Porque em uma direção isso é verdade: se o LogicalTime A é menor que o LogicalTime B, então B não pode ter ocorrido antes de A; mas se for maior, pode ser.
Relógios vetoriais (Vector Clock)
O desenvolvimento lógico do relógio de Lamport – são os Relógios Vetoriais. Eles se diferenciam pelo fato de que cada nó presente aqui contém seus próprios relógios separados, que são transmitidos como um vetor.
Neste caso, você vê que o índice zero do vetor representa o Feed, e o primeiro índice do vetor representa os Amigos (cada um desses nós). E agora eles vão aumentar: o índice zero do 'Feed' aumenta a cada gravação – 1, 2, 3:
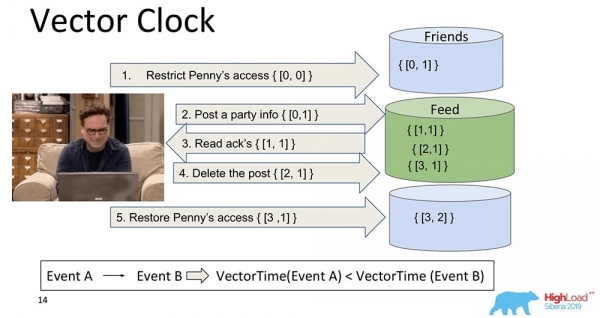
Por que os relógios vetoriais são melhores? Porque eles permitem entender quais eventos são simultâneos e quando ocorrem em diferentes nós. Isso é muito importante para um sistema de sharding, como o 'MongoDB'. Entretanto, não escolhemos isso, embora seja algo incrível, que funciona maravilhosamente bem e que provavelmente seria adequado para nós…
Se temos 10 mil shards, não conseguimos transferir 10 mil componentes, mesmo comprimindo ou pensando em outras soluções – ainda assim, a carga útil será várias vezes menor do que o volume total desse vetor. Portanto, com pesar, desistimos dessa abordagem e partimos para outra.
Spanner TrueTime. Relógios atômicos
Eu disse que falaria sobre o 'Spanner'. É uma coisa incrível, do século XXI: relógios atômicos, sincronização por GPS.
Qual é a ideia? O 'Spanner' é um sistema do Google, que recentemente se tornou disponível para as pessoas (eles adicionaram SQL a ele). Cada transação lá tem um certo carimbo de tempo. Como o tempo é sincronizado*, cada evento pode ser atribuído a determinados tempos – os relógios atômicos têm um tempo de espera, após o qual um outro tempo 'ocorre' garantidamente.
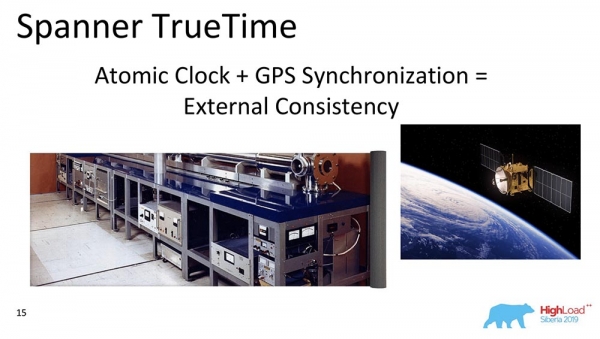
Assim, apenas gravando no banco de dados e aguardando um certo período, a serialização dos eventos é automaticamente garantida. Eles têm o modelo de consistência mais forte que poderia ser imaginado – é a Consistência Externa.
* Este é o problema principal dos relógios de Lamport – eles nunca estão sincronizados em sistemas distribuídos. Eles podem divergir, mesmo com NTP, ainda assim não funcionam muito bem. O 'Spanner' possui relógios atômicos e sincronização, parece que na ordem de microssegundos.
Por que não escolhemos? Não supomos que nossos usuários tenham relógios atômicos integrados. Quando eles estiverem presentes, integrados a cada laptop, haverá uma super incrível sincronização por GPS – aí sim… Mas até lá, o melhor que podemos ter são as 'Estações Base' da 'Amazon' – para os fãs… Portanto, usamos outros relógios.
Relógios híbridos (Hybrid Clock)
Isso é, na verdade, o que faz "MongoDB" funcionar ao garantir a consistência causal. Em que eles são híbridos? Híbrido é um valor escalar, mas consiste em dois componentes:
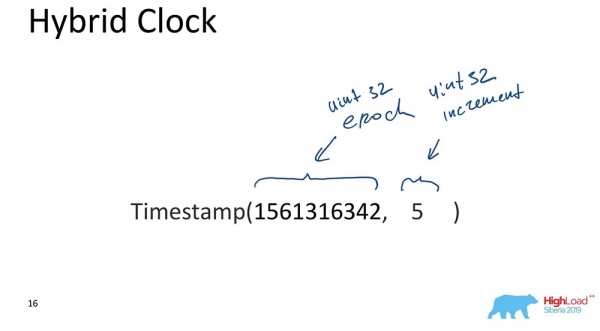
- O primeiro é a época Unix (quantos segundos se passaram desde o "início do mundo computacional").
- O segundo é um incremento, também um inteiro sem sinal de 32 bits.
Isso é tudo. Existe essa abordagem: a parte que responde pelo tempo é sempre sincronizada com os relógios; sempre que uma atualização acontece, essa parte se sincroniza com o relógio, e assim o tempo permanece mais ou menos correto, enquanto o incremento permite diferenciar eventos que ocorreram no mesmo momento.
Por que isso é importante para "MongoDB"? Porque permite realizar backups e restaurações para um determinado momento no tempo, ou seja, o evento é indexado pelo tempo. Isso é crucial quando certos eventos são necessários; para o banco de dados, eventos são alterações no banco que ocorreram em intervalos de tempo específicos.
Vou lhe contar o motivo mais importante (por favor, não conte isso a ninguém)! Fizemos assim porque é assim que os dados ordenados e indexados aparecem no MongoDB OpLog. O OpLog é uma estrutura de dados que contém todas as alterações no banco: elas primeiro vão para o OpLog e depois são aplicadas ao Storage, no caso de serem dados replicados ou shard.
Essa foi a razão principal. Existem também requisitos práticos para o desenvolvimento do banco, o que significa que deve ser simples – pouco código, o mínimo possível de coisas quebradas que precisam ser reescritas e testadas. O fato de termos opLogs indexados com relógios híbridos ajudou muito e permitiu fazer a escolha certa. Isso realmente se mostrou eficaz e funcionou de forma mágica no primeiro protótipo. Foi muito legal!
Sincronização de relógios
Existem várias maneiras de sincronização descritas na literatura científica. Falo de sincronização, quando temos dois shards diferentes. Se houver um conjunto de réplicas – não há necessidade de sincronização: é um «master único»; temos um OpLog, onde todas as alterações são registradas – nesse caso, tudo já está ordenado sequencialmente no próprio «OpLog». Mas se temos dois shards diferentes, aqui a sincronização do tempo é importante. Aqui, os relógios vetoriais ajudaram mais! Mas nós não os temos.
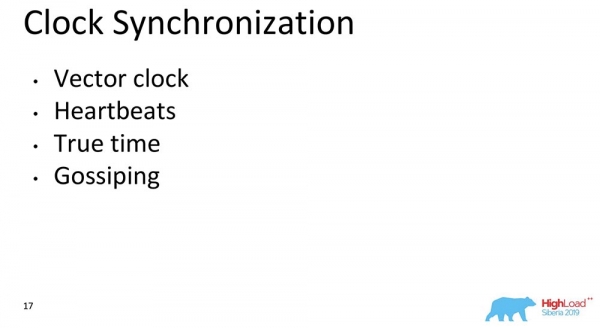
O segundo método é o «Heartbeats». Podemos trocar alguns sinais que ocorrem a cada unidade de tempo. Mas os «Heartbeats» são muito lentos, não conseguimos garantir a latência para nosso cliente.
O tempo verdadeiro – claro, é uma coisa maravilhosa. Mas, novamente, isso é provavelmente o futuro… Embora no «Atlas» já se possa fazer, já existem sincronizadores de tempo «amazonianos» rápidos. Mas isso não estará disponível para todos.
Gossiping é quando todas as mensagens incluem o tempo. É mais ou menos isso que usamos. Cada mensagem entre nós, driver, roteador de nós de dados, absolutamente tudo para «MongoDB» – são alguns elementos, componentes do banco de dados, que contêm relógios que correm. Eles têm um valor de tempo híbrido que é transmitido. 64 bits? Isso é possível.
Como tudo isso funciona junto?
Aqui estou considerando um conjunto de réplica para tornar as coisas um pouco mais simples. Há um Primário e um Secundário. O Secundário faz a replicação e nem sempre está completamente sincronizado com o Primário.
Uma inserção ocorre no «Primário» com algum valor de tempo. Essa inserção aumenta o contador interno em 11, se for o máximo. Ou ele irá verificar os valores dos relógios e se sincronizar pelos relógios, se os valores dos relógios forem maiores. Isso permite que o ordenamento seja feito pelo tempo.
Depois que ele faz a gravação, ocorre um momento importante. Os relógios no «MongoDB» só são incrementados em caso de gravação no «OpLog». Esse é o evento que muda o estado do sistema. Em todos os artigos clássicos, um evento é considerado a chegada de uma mensagem em um nó: a mensagem chegou – isso significa que o sistema mudou seu estado.
Isso acontece porque, ao investigar, não é possível entender completamente como essa mensagem será interpretada. Sabemos com certeza que, se não estiver refletida no 'OpLog', não será interpretada de forma alguma, e a única mudança no estado do sistema é a gravação no 'OpLog'. Isso simplifica tudo para nós: tanto a modelagem quanto a organização dentro de um único conjunto de réplicas, além de muitas outras coisas úteis.
Um valor é retornado, que já está gravado no 'OpLog' – sabemos que esse valor já está contido no 'OpLog' e seu tempo é 12. Agora, digamos que a leitura começa a partir de outro nó (Secundário), e ele já passa afterClusterTime na própria mensagem. Ele diz: 'Eu preciso de tudo o que aconteceu pelo menos após 12 ou no momento do doze' (veja a imagem acima).
Isso é o que chamamos de Causal e consistente (CAT). Existe um conceito na teoria que este é um certo corte de tempo, que é consistente em si mesmo. Neste caso, pode-se dizer que é o estado do sistema observado no momento temporal 12.
Neste momento, não há nada aqui, porque isso simula uma situação em que o Secundário precisa replicar dados do Primário. Ele está esperando… E então os dados chegaram – retornam esses valores.
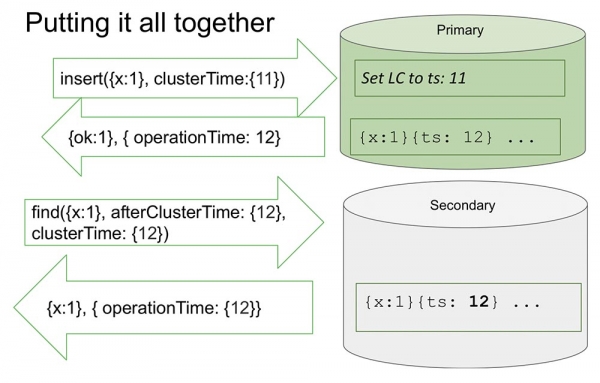
É mais ou menos assim que tudo funciona. Quase isso.
O que significa 'quase isso'? Vamos supor que existe uma pessoa que leu e entendeu como tudo funciona. Entendeu que ocorre uma atualização de ClusterTime a cada vez, que atualiza os relógios lógicos internos, e então o próximo registro aumenta em uma unidade. Essa função ocupa 20 linhas. Suponha que essa pessoa passe o maior número inteiro de 64 bits menos um.
Por que 'menos um'? Porque os relógios internos serão inseridos nesse valor (obviamente, este é o maior possível e maior que o tempo atual), então ocorrerá uma gravação no 'OpLog', e os relógios serão incrementados em mais uma unidade – e já será o valor máximo (são apenas todos uns, não há mais para onde ir, uns inteiros sem sinal).
É claro que, após isso, o sistema se torna absolutamente inacessível para qualquer coisa. Só é possível descarregá-lo, limpá-lo – um trabalho manual extenso. Disponibilidade total:
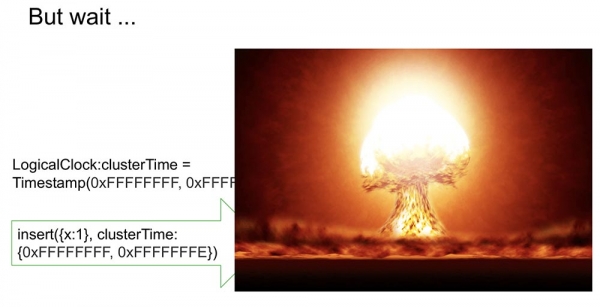
Além disso, se isso se replica em outros lugares, pode derrubar todo o cluster. É uma situação absolutamente inaceitável, que qualquer pessoa pode criar muito rapidamente e facilmente! Por isso, consideramos esse aspecto como um dos mais importantes. Como preveni-la?
Nosso caminho é assinar clusterTime
Assim, ele é transmitido na mensagem (até o texto azul). Mas também começamos a gerar uma assinatura (texto azul):
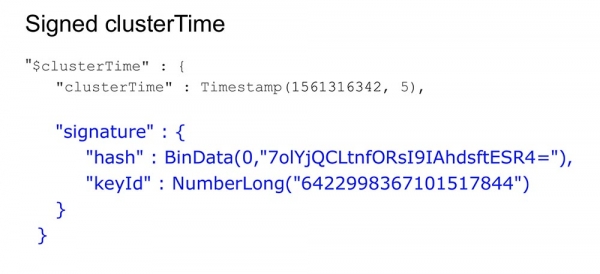
A assinatura é gerada com uma chave que é mantida dentro do banco de dados, dentro de um perímetro seguro; é gerada e atualizada (os usuários não vêem isso). Um hash é gerado, e cada mensagem é assinada ao ser criada e validada ao ser recebida.
Provavelmente, as pessoas se perguntam: "Quão lento isso tudo torna?" Eu disse que deve funcionar rapidamente, especialmente na ausência deste recurso.
O que significa usar a consistência causal neste caso? Isso significa mostrar o parâmetro afterClusterTime. Sem isso, ele simplesmente transmitirá valores independentemente. O Gossiping, a partir da versão 3.6, funciona sempre.
Se deixarmos a geração constante de assinaturas, isso desacelerará o sistema mesmo na ausência do recurso, o que não está de acordo com nossas abordagens e requerimentos. E o que fizemos?
Faça isso rapidamente!
Uma coisa relativamente simples, mas um truque interessante – vou compartilhar, talvez alguém ache interessante.
Temos um hash que armazena os dados assinados. Todos os dados passam pelo cache. O cache não assina um tempo específico, mas um Range. Quando um determinado valor chega, geramos um Range, mascaramos os últimos 16 bits, e esse valor nós assinamos:
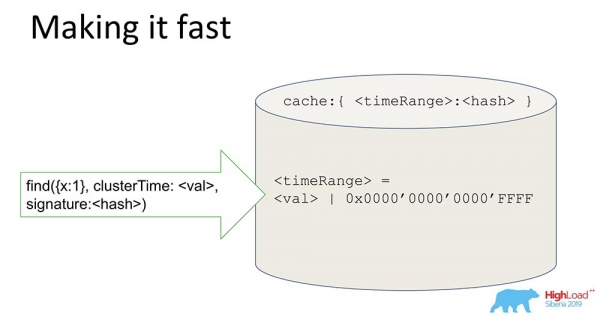
Ao receber tal assinatura, aceleramos o sistema (condicionalmente) em 65 mil vezes. Funciona maravilhosamente: quando realizamos experimentos, o tempo realmente diminuiu em 10 mil vezes quando temos uma atualização sequencial. É claro que quando estão desordenados, isso não acontece. Mas na maioria dos casos práticos, isso funciona. A combinação da assinatura de Range junto com a assinatura ajudou a resolver o problema de segurança.
O que aprendemos?
As lições que extraímos disso:
- É necessário ler materiais, histórias, artigos, porque temos muita coisa interessante. Quando trabalhamos em uma nova funcionalidade (especialmente agora, quando fizemos transações etc.), é preciso ler e compreender. Isso leva tempo, mas é realmente muito útil, porque nos ajuda a entender onde estamos. Na verdade, não inventamos nada novo – apenas reunimos os ingredientes.
Observa-se uma diferença de pensamento quando ocorre uma conferência acadêmica (como a «Sigmon», por exemplo) – lá todos se concentram em novas ideias. Qual é a novidade do nosso algoritmo? Aqui não há muita novidade. A inovação está mais na forma como misturamos diferentes abordagens existentes. Portanto, em primeiro lugar, é preciso ler os clássicos, começando por Lamport.
- Em produção, as exigências são completamente diferentes. Tenho certeza de que muitos de vocês não lidam com bases de dados “esféricas” em um vácuo abstrato, mas com situações normais e reais, que apresentam problemas de disponibilidade, latência e resiliência.
- Por último, tivemos que considerar diferentes ideias e combinar vários artigos diversos em uma única abordagem. A ideia da assinatura, por exemplo, veio de um artigo que analisava o protocolo Paxos, aplicável a falhas não bizantinas dentro do protocolo de autorização, e para falhas bizantinas – fora do protocolo de autorização... Enfim, foi exatamente isso que acabamos fazendo.
Não há nada absolutamente novo aqui! Mas assim que misturamos tudo isso… É como dizer que a receita da salada Olivier é irrelevante, porque os ovos, maionese e pepinos já foram inventados... É mais ou menos a mesma história.
Concluo por aqui. Obrigado!
Perguntas
Pergunta do público (daqui em diante – P): – Obrigado, Mikhail pela apresentação! O tema sobre tempo é interessante. Você utiliza Gossiping. Disse que todos têm seu próprio tempo, todos sabem seu tempo local. Entendi que temos um driver – pode haver muitos clientes com drivers, também muitos planejadores de consulta e shards... A que nosso sistema acaba se reduzindo, se surgir uma discrepância: alguém decide que está um minuto à frente, outro – um minuto atrás? Onde ficaremos?
MT: – É uma ótima pergunta, na verdade! Eu queria falar sobre shards. Se eu entendi corretamente a pergunta, temos a seguinte situação: há o shard 1 e o shard 2, a leitura acontece a partir desses dois shards – eles têm divergências, não interagem entre si, porque o tempo que cada um conhece é diferente, especialmente o tempo que existe em seus oplogs.
Suponhamos que o shard 1 fez um milhão de registros, o shard 2 – absolutamente nada, e a solicitação chegou aos dois shards. E o primeiro tem afterClusterTime superior a um milhão. Nessa situação, como expliquei, o shard 2 nunca responderá.
P: – Eu queria saber como eles se sincronizam e escolhem um único tempo lógico?
MT: – Eles se sincronizam de forma muito simples. O shard, quando recebe afterClusterTime, e não encontra o tempo no 'Oplog' – inicia o no approved. Ou seja, ele manualmente eleva seu tempo para esse valor. Isso significa que ele não tem eventos correspondentes a essa solicitação. Ele cria esse evento artificialmente e assim se torna Causal Consistent.
P: – E se depois disso ainda chegarem alguns eventos que estavam perdidos na rede?
MT: – O shard é projetado de forma que eles não chegarão, pois é um single master. Se ele já registrou, eles não voltarão, mas virão depois. Não pode acontecer que algo tenha ficado preso em algum lugar, então ele faz um no write, e esses eventos chegam depois – e a Causal consistency é quebrada. Quando ele faz um no write, todos devem vir depois (ele os aguardará).
P: – Eu tenho algumas perguntas sobre filas. A Causal consistency pressupõe que há uma certa fila de ações que precisam ser executadas. O que acontece se um pacote se perder? Por exemplo, o 10º, 11º… o 12º se perdeu, enquanto todos os outros estão esperando que ele seja executado. E, de repente, nossa máquina parou, e não podemos fazer nada. Existe um comprimento máximo da fila que se acumula antes de ser executada? Que falha fatal ocorre na perda de algum estado? Além disso, se estamos registrando que há algum estado anterior, deveríamos nos basear nele? Mas não conseguimos nos basear nele!
MT: – Também é uma pergunta excelente! O que fazemos? No MongoDB, existe o conceito de gravações quorum e leitura quorum. Em quais casos uma mensagem pode se perder? Quando o registro não é quorum ou quando a leitura não é quorum (também pode haver algum lixo que sobe).
Realizamos uma ampla verificação experimental sobre a Coerência Causal, cuja conclusão foi que, no caso de gravações e leituras não-quorum, ocorrem violações da Coerência Causal. Exatamente o que você mencionou!
Nossa recomendação: usar pelo menos leitura quorum ao empregar Coerência Causal. Neste caso, nada se perderá, mesmo se uma gravação quorum desaparecer... Esta é uma situação ortogonal: se o usuário não deseja que os dados se percam, deve usar gravação quorum. A Coerência Causal não garante durabilidade. A garantia de durabilidade é fornecida pela replicação e pela maquinaria relacionada à replicação.
P: – Quando criamos uma instância que realiza sharding (não master, mas slave, respectivamente), ela se baseia no tempo Unix da própria máquina ou no tempo do "master"; é sincronizado pela primeira vez ou periodicamente?
MT: – Agora vou esclarecer. Um shard (ou seja, uma partição horizontal) sempre tem um Primário. E dentro do shard pode haver um "master" e podem haver réplicas. Mas o shard sempre mantém gravação, porque precisa suportar algum domínio (no shard está o Primário).
P: – Então tudo depende exclusivamente do "master"? Sempre é usado o tempo do "master"?
MT: – Sim. Pode-se dizer figurativamente: os relógios ticam quando ocorre uma gravação no "master", no "OpLog".
P: – Temos um cliente que se conecta e não precisa saber nada sobre o tempo?
MT: – Ele não precisa saber nada! Se falarmos sobre como isso funciona no cliente: quando o cliente deseja utilizar a Coerência Causal, precisa abrir uma sessão. Agora tudo está lá: transações na sessão e recuperação de direitos... A sessão é uma ordenação de eventos lógicos que ocorrem com o cliente.
Se ele abre essa sessão e diz que quer a Coerência Causal (se por padrão a sessão suporta a Coerência Causal), tudo funciona automaticamente. O driver registra esse tempo e o aumenta quando recebe uma nova mensagem. Ele se lembra de qual resposta foi retornada anteriormente pelo servidor que forneceu os dados. A próxima solicitação conterá afterCluster ("tempo maior que este").
O cliente não precisa saber nada! Isso é completamente opaco para ele. Se as pessoas utilizam esses recursos, o que isso permite? Em primeiro lugar, é possível ler dados secundários de forma segura: pode-se escrever no Primário e ler de secundários replicados geograficamente, tendo certeza de que isso funciona. Além disso, as sessões gravadas no Primário podem ser transferidas para o Secundário, ou seja, é possível usar várias sessões.
P: – O conceito de consistência eventual está muito relacionado a um novo campo da ciência da computação – os tipos de dados CRDT (Tipos de Dados Replicados Sem Conflitos). Você considerou a integração desses tipos de dados no banco e o que pode dizer sobre isso?
MT: – Boa pergunta! CRDT faz sentido para conflitos durante a gravação: no MongoDB, temos um mestre único.
P: – Tenho uma pergunta dos devops. No mundo real, encontramos situações tão intrigantes, onde uma falha bizantina ocorre, e homens mal-intencionados dentro do perímetro protegido começam a interferir no protocolo, enviando pacotes de maneira engenhosa?
MT: – Homens mal-intencionados dentro do perímetro são como um cavalo de Troia! Eles podem causar muitos problemas.
P: – É claro que deixar uma 'fenda' no servidor, por assim dizer, pela qual se pode passar um zoológico de elefantes e derrubar todo o cluster para sempre... Isso exigirá tempo para restauração manual... Isso, para dizer o mínimo, é incorreto. Por outro lado, é interessante saber: na vida real, na prática, você já se deparou com situações onde ataques internos semelhantes realmente ocorrem?
MT: – Como não me deparei com violações de segurança na vida real com frequência, não posso afirmar – talvez elas realmente ocorram. Mas se falarmos sobre a filosofia de desenvolvimento, acreditamos o seguinte: temos um perímetro que protege as pessoas que tratam de segurança – isso é como um cadeado, uma parede; e dentro do perímetro, pode-se fazer o que se quiser. É claro que existem usuários que só podem visualizar, enquanto outros têm permissão para excluir diretórios.
Dependendo das permissões, o dano que os usuários podem causar pode ser como um clique do mouse ou como um elefante. É evidente que um usuário com permissões totais pode fazer qualquer coisa. Já um usuário com permissões limitadas pode causar muito menos dano. Em particular, ele não pode quebrar o sistema.
P: – No perímetro protegido, alguém está tentando formar protocolos inesperados para o servidor, colocando-o de joelhos, e se tiver sorte, o cluster inteiro... É realmente tão 'bom' assim?
MT: – Nunca ouvi falar de tais coisas. Que é possível derrubar um servidor dessa forma não é segredo. Derrubar de dentro, estando no protocolo, sendo um usuário autorizado que pode gravar alguma coisa... Na verdade, isso não é possível, porque ainda assim ele será verificado. Existe a possibilidade de desabilitar essa autenticação para usuários que não desejam - nesse caso, suas questões; eles, grosseiramente falando, derrubaram as paredes e é possível colocar um elefante que vai esmagar... E, na verdade, pode-se se vestir de técnico, aparecer e retirar!
P: – Obrigado pela palestra. Sergey ("Yandex"). No "Mongo", existe uma constante que limita o número de membros votantes no Replica Set, e essa constante é igual a 7 (sete). Por que isso é uma constante? Por que não é um parâmetro qualquer?
MT: – O Replica Set pode ter até 40 nós. Sempre haverá uma maioria. Não sei qual a versão...
P: – No Replica Set, pode-se executar membros não votantes, mas votantes - no máximo 7. Como lidar com a interrupção, se nosso Replica Set está distribuído em 3 data centers? Um data center pode facilmente se desligar, e mais uma máquina pode falhar.
MT: – Isso já está um pouco além da palestra. É uma questão geral. Posso explicá-la depois.
Um pouco de publicidade 🙂
Obrigado por permanecer conosco. Você gosta dos nossos artigos? Quer ver mais materiais interessantes? Apoie-nos fazendo um pedido ou recomendando para conhecidos. , uma alternativa única aos servidores entry-level, que criamos para você: (disponíveis opções com RAID1 e RAID10, até 24 núcleos e até 40GB DDR4).
Dell R730xd por 2 vezes mais barato no datacenter Equinix Tier IV em Amsterdã? Somente conosco na Holanda! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — a partir de $99! Leia sobre
Fonte: habr.com
