

Há mais de 20 anos, observamos páginas da web pelo protocolo HTTP. A maioria dos usuários nem sequer se pergunta o que isso significa e como funciona. Outros sabem que sob o HTTP está o TLS, e abaixo dele está o TCP, sob o qual está o IP, e assim por diante. E há aqueles – hereges – que acreditam que o TCP é coisa do passado, desejando algo mais rápido, confiável e seguro. Mas em suas tentativas de inventar um novo protocolo ideal, eles voltaram às tecnologias dos anos 80 e estão tentando construir seu novo mundo maravilhoso sobre elas.
Um pouco de história: HTTP/1.1
Em 1997, o protocolo de troca de informações textuais HTTP versão 1.1 obteve seu RFC. Naquela época, o protocolo já era utilizado por navegadores há vários anos, e o novo padrão durou mais quinze. O protocolo funcionava apenas no princípio de pedido-resposta e era destinado, principalmente, à transferência de informações textuais.
O HTTP foi projetado para funcionar sobre o protocolo TCP, que garante a entrega confiável de pacotes ao destinatário. O funcionamento do TCP baseia-se no estabelecimento e manutenção de uma conexão confiável entre os pontos finais e na divisão do tráfego em segmentos. Os segmentos possuem seu próprio número sequencial e uma soma de verificação. Se algum dos segmentos não chegar ou chegar com uma soma de verificação incorreta, a transmissão será interrompida até que o segmento perdido seja recuperado.
No HTTP/1.0, a conexão TCP era fechada após cada pedido. Isso era extremamente dispendioso, pois o estabelecimento de uma conexão TCP (3-Way-Handshake) é um processo demorado. No HTTP/1.1, foi apresentado o mecanismo keep-alive, que permite reutilizar uma única conexão para vários pedidos. No entanto, como isso pode facilmente se tornar um gargalo, em diferentes implementações do HTTP/1.1 é permitido abrir várias conexões TCP para um único host. Por exemplo, no Chrome e nas versões mais recentes do Firefox, são permitidas até seis conexões.
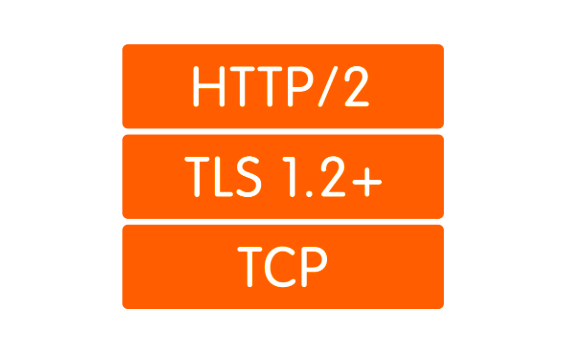
A criptografia também deveria ser deixada a outros protocolos, e para isso o protocolo TLS foi utilizado sobre o TCP, que protegia os dados de forma bastante confiável, mas aumentava ainda mais o tempo necessário para estabelecer a conexão. No final, o processo de handshake passou a ser assim:
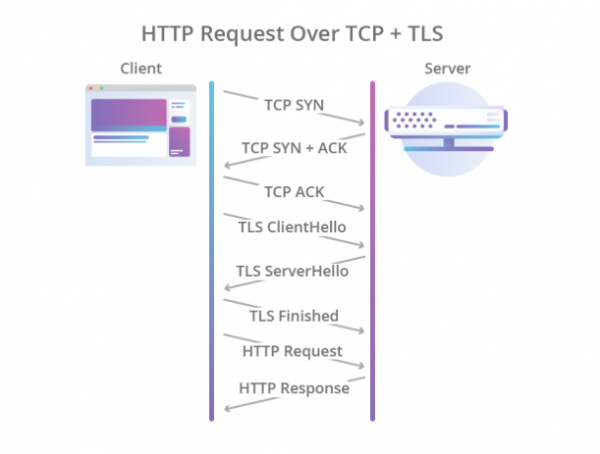
Ilustração Cloudflare
Assim, o HTTP/1.1 tinha uma série de problemas:
- Instalação de conexão lenta.
- Os dados são transmitidos em formato de texto, o que significa que a transmissão de imagens, vídeos e outras informações não textuais é ineficaz.
- Uma conexão TCP é usada para uma única solicitação, o que significa que as demais solicitações devem encontrar outra conexão ou esperar que a conexão atual a libere.
- Apenas o modelo pull é suportado. O padrão não menciona nada sobre server-push.
- Os cabeçalhos são transmitidos em texto.
Se o server-push é razoavelmente implementado através do protocolo WebSocket, as outras questões precisaram ser resolvidas de maneira mais radical.
Um pouco de modernidade: HTTP/2
Em 2012, nas profundezas do Google, começou o trabalho no protocolo SPDY (pronuncia-se 'spidi'). O protocolo foi criado para resolver os principais problemas do HTTP/1.1 e ao mesmo tempo deveria manter a compatibilidade retroativa. Em 2015, o grupo de trabalho IETF apresentou a especificação HTTP/2, baseada no protocolo SPDY. Aqui estão as diferenças no HTTP/2:
- Serialização binária.
- Multiplexação de várias solicitações HTTP em uma única conexão TCP.
- Server-push embutido (sem WebSocket).
O protocolo foi um grande avanço. Ele melhorou significativamente e não requer a criação de várias conexões TCP: todas as solicitações para um único host são multiplexadas em uma. Ou seja, em uma única conexão existem vários chamados streams, cada um com seu ID. Como bônus, vem o server-push embutido.
No entanto, a multiplexação leva a outro problema crucial. Imagine que estamos executando 5 solicitações de forma assíncrona a um único servidor. Ao usar HTTP/2, todas essas solicitações serão executadas dentro de uma única conexão TCP, o que significa que, se um dos segmentos de qualquer solicitação se perder ou chegar de forma incorreta, a transmissão de todas as solicitações e respostas será interrompida até que o segmento perdido seja recuperado. É evidente que quanto pior a qualidade da conexão, mais lento o HTTP/2 funcionará. em condições onde os pacotes perdidos representam 2% do total, o HTTP/1.1 se sai melhor no navegador do que o HTTP/2, pois abre 6 conexões, em vez de uma.
Esse problema é chamado de 'head-of-line blocking' e, infelizmente, não parece possível resolvê-lo ao utilizar TCP.
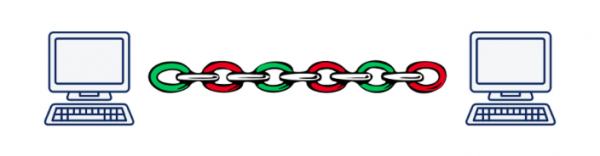
Ilustração de Daniel Steinberg
Como resultado, os desenvolvedores do padrão HTTP/2 fizeram um enorme trabalho e realizaram praticamente tudo o que poderia ser feito no nível de aplicação do modelo OSI. Chegou a hora de descer para o nível de transporte e inventar um novo protocolo de transporte.
Precisamos de um novo protocolo: UDP vs TCP
Logo ficou claro que implementar um protocolo de transporte completamente novo – é uma tarefa irrealizável nas circunstâncias atuais. A questão é que o nível de transporte é conhecido por dispositivos de hardware ou middle-boxes (roteadores, firewalls, servidores NAT…), e ensinar-lhes algo novo é uma tarefa extremamente complicada. Além disso, o suporte a protocolos de transporte está embutido no núcleo dos sistemas operacionais, e os núcleos também não mudam de forma tão ágil.
E aí, poderíamos simplesmente desistir e dizer: "Claro, nós iremos inventar o novo HTTP/3 com prefácio e cortesãs, mas sua implementação levará de 10 a 15 anos (aproximadamente esse tempo será necessário para substituir a maioria dos dispositivos)", mas há outra opção, não tão óbvia: utilizar o protocolo UDP. Sim, aquele mesmo protocolo com o qual trocávamos arquivos em rede local no final dos anos 90 e início dos anos 2000. Quase todos os dispositivos atuais conseguem trabalhar com ele.
Quais são as vantagens do UDP em comparação ao TCP? Em primeiro lugar, não temos uma sessão de nível de transporte, da qual o hardware tem conhecimento. Isso nos permite definir a sessão nos pontos finais e resolver os conflitos que surgirem lá mesmo. Ou seja, não estamos limitados a uma ou várias sessões (como no TCP), mas podemos criar tantas quantas precisarmos. Em segundo lugar, a transmissão de dados via UDP ocorre mais rapidamente do que via TCP. Assim, na teoria, podemos superar o atual teto de velocidade atingido no HTTP/2.
No entanto, o UDP não garante a confiabilidade da transmissão de dados. Na prática, apenas enviamos pacotes, esperando que sejam recebidos do outro lado. Não foi recebido? Bem, não tivemos sorte… Isso foi suficiente para transmitir vídeos para adultos, mas para coisas mais sérias é necessário confiar, e isso significa que teremos que adicionar algo mais sobre o UDP.
Assim como no caso do HTTP/2, o trabalho na criação de um novo protocolo começou no Google em 2012, ou seja, aproximadamente ao mesmo tempo em que o trabalho no SPDY começava. Em 2013, Jim Roskind apresentou ao público em geral , e em 2015 foi submetido um Internet Draft para a padronização no IETF. Naquela época, o protocolo desenvolvido por Roskind no Google já diferia significativamente da versão proposta para padronização, então a versão do Google passou a ser chamada de gQUIC.
O que é QUIC
Primeiramente, como já mencionado, é um encapsulamento sobre o UDP. Sobre o UDP é estabelecida uma conexão QUIC, onde, semelhante ao HTTP/2, podem existir múltiplos fluxos. Esses fluxos existem apenas nos pontos finais e são gerenciados de forma independente. Se um pacote se perder em um fluxo, os outros não serão afetados.
Ilustração de Daniel Steinberg
Em segundo lugar, a criptografia agora é implementada não como um nível separado, mas incluída no protocolo. Isso permite estabelecer conexões e trocar chaves públicas em uma única negociação, além de possibilitar o uso do mecanismo inteligente de 0-RTT handshake, evitando assim atrasos na negociação. Além disso, agora é possível criptografar pacotes de dados individuais. Isso permite que não se aguarde a conclusão da recepção de dados de um fluxo e que os pacotes recebidos sejam descriptografados de forma independente. Esse modo de operação era completamente impossível no TCP, pois o TLS e o TCP operavam de forma independente, e o TLS não sabia como os dados seriam fragmentados pelo TCP. Portanto, não conseguia preparar seus segmentos de forma que corressem um a um nos segmentos TCP e pudessem ser descriptografados de forma independente. Todas essas melhorias permitem que o QUIC reduza a latência em comparação ao TCP.
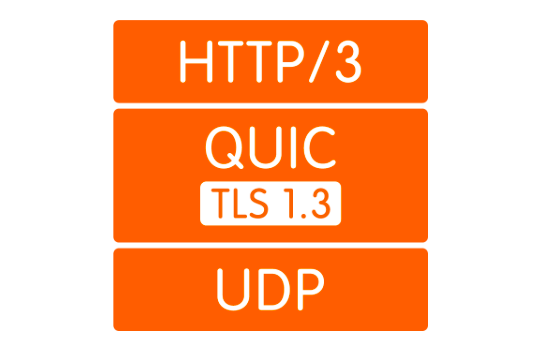
Em terceiro lugar, o conceito de fluxos leves permite desvincular a conexão do endereço IP do cliente. Isso é importante, por exemplo, quando o cliente troca de um ponto de acesso Wi-Fi para outro, mudando seu IP. Nesse caso, ao usar TCP, ocorre um longo processo onde as conexões TCP existentes se encerram por timeout e novas conexões são estabelecidas com o novo IP. No caso do QUIC, o cliente simplesmente continua enviando pacotes ao servidor a partir do novo IP enquanto mantém o antigo ID do fluxo. Como o ID do fluxo agora é único e não é reutilizado, o servidor entende que o cliente mudou de IP, retransmite os pacotes perdidos e continua a comunicação no novo endereço.
Em quarto lugar, o QUIC é implementado no nível da aplicação, e não do sistema operacional. Isso, por um lado, permite que as mudanças no protocolo sejam realizadas mais rapidamente, uma vez que para obter uma atualização, basta atualizar a biblioteca, ao invés de esperar por uma nova versão do SO. Por outro lado, isso leva a um grande aumento no consumo de CPU.
E por último, os cabeçalhos. A compressão de cabeçalhos é um dos pontos que diferem entre QUIC e gQUIC. Não vejo sentido em dedicar muito tempo a isso, apenas direi que na versão submetida à padronização, a compressão de cabeçalhos foi feita para ser o mais semelhante possível à compressão de cabeçalhos no HTTP/2. Pode-se ler mais .
Quão mais rápido é?
Essa é uma pergunta complexa. O fato é que, como ainda não temos um padrão, não há muito o que medir. Provavelmente, os únicos dados estatísticos que temos são as estatísticas do Google, que utiliza gQUIC desde 2013 e em 2016 , que cerca de 90% do tráfego enviado para seus servidores a partir do navegador Chrome agora utiliza QUIC. Nessa mesma apresentação, eles relatam que através do gQUIC, as páginas carregam aproximadamente 5% mais rápido, e em vídeo streaming, há 30% menos travamentos em comparação com TCP.
Em 2017, um grupo de pesquisadores liderado por Arash Molavi Kakhki publicou um estudo sobre o desempenho do gQUIC em comparação com o TCP.
A pesquisa revelou várias fraquezas do gQUIC, como a instabilidade ao misturar pacotes de rede, a ganância (unfairness) em relação à largura de banda do canal e a transmissão mais lenta de objetos pequenos (até 10 kb). Este último, no entanto, pode ser compensado pelo uso do 0-RTT. Em todos os outros casos analisados, o gQUIC mostrou aumento de velocidade em comparação com o TCP. É difícil falar sobre números exatos aqui. É melhor ler ou .
Aqui deve-se mencionar que esses dados dizem respeito especificamente ao gQUIC, e não são atuais para o padrão em desenvolvimento. O que será para QUIC: ainda é um mistério, mas há esperança de que as fraquezas identificadas no gQUIC sejam levadas em conta e corrigidas.
Um pouco sobre o futuro: e quanto ao HTTP/3?
Aqui tudo está cristalino: a API não vai mudar. Tudo permanecerá exatamente como era no HTTP/2. E se a API permanece a mesma, a transição para o HTTP/3 deve ser feita utilizando uma versão atualizada da biblioteca no backend, que suporte o transporte via QUIC. No entanto, ainda teremos que manter o fallback para versões antigas do HTTP por um bom tempo, pois a internet atualmente não está pronta para uma transição completa para o UDP.
Quem já suporta
Aqui implementações existentes do QUIC. Apesar da falta de um padrão, a lista é boa.
Nenhum navegador atualmente suporta QUIC na versão estável. Recentemente, houve informações de que o Chrome ativou o suporte ao HTTP/3, mas apenas na versão Canary.
No backend, apenas o e suporta HTTP/3, mas ainda de forma experimental. O NGINX, no final da primavera de 2019, anunciou que estava trabalhando no suporte ao HTTP/3, mas ainda não terminou.
Quais são os problemas
Vivemos em um mundo real, onde nenhuma grande tecnologia pode avançar para as massas sem encontrar resistência, e o QUIC não é uma exceção.
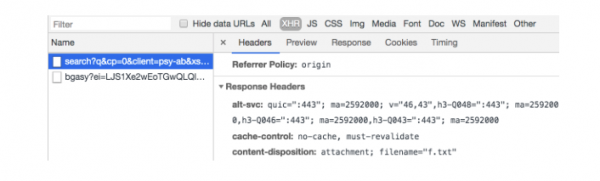
O mais importante é que precisamos explicar ao navegador que "https://" agora não é garantido que leva à porta TCP 443. Pode até não haver TCP. Para isso, utiliza-se o cabeçalho Alt-Svc. Ele permite informar ao navegador que este site também está disponível em um determinado protocolo em um determinado endereço. Em teoria, isso deve funcionar perfeitamente, mas na prática, nos deparamos com o fato de que o UDP pode, por exemplo, estar bloqueado no firewall para evitar ataques DDoS.
Mas mesmo que o UDP não esteja bloqueado, o cliente pode estar atrás de um roteador NAT, que está configurado para manter a sessão TCP pelo endereço IP, e como estamos usando UDP, que não possui uma sessão de hardware, o NAT não manterá a conexão, e a sessão QUIC .
Todos esses problemas estão relacionados ao fato de que o UDP não foi utilizado anteriormente para a transmissão de conteúdo na internet, e os fabricantes de hardware não puderam prever que isso poderia acontecer um dia. Da mesma forma, os administradores ainda não entendem muito bem como configurar corretamente suas redes para trabalhar com QUIC. Essa situação mudará lentamente e, de qualquer forma, tais mudanças levarão menos tempo do que a implementação de um novo protocolo de transporte.
Além disso, como já foi mencionado, o QUIC aumenta significativamente o uso da CPU. Daniel Stenberg um aumento na CPU de até três vezes.
Quando o HTTP/3 chegar
Padrão Até maio de 2020, mas, considerando que os documentos programados para julho de 2019 ainda estão pendentes, pode-se dizer que a data provavelmente será adiada.
O Google utiliza sua implementação do gQUIC desde 2013. Se analisarmos a solicitação HTTP que é enviada ao mecanismo de busca do Google, podemos ver o seguinte:
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
Atualmente, o QUIC parece uma tecnologia bastante crua, mas com grande potencial. Considerando que, nos últimos 20 anos, todas as otimizações de protocolos de nível de transporte se concentraram principalmente no TCP, o QUIC, que geralmente ganha em desempenho, já parece bastante promissor.
No entanto, ainda existem problemas não resolvidos que precisarão ser enfrentados nos próximos anos. O processo pode se arrastar devido à presença de hardware que ninguém gosta de atualizar, mas todas as questões parecem ser resolvíveis e, cedo ou tarde, todos nós teremos HTTP/3.
O futuro está chegando rapidamente!
Fonte: habr.com
