

Neste artigo, apresento minhas reflexões sobre a história e as perspectivas de desenvolvimento da internet, redes centralizadas e descentralizadas e, como resultado, a possível arquitetura da rede descentralizada da próxima geração.
Algo está errado com a internet
Conheci a internet pela primeira vez em 2000. Claro, não foi o começo — a rede já existia antes disso, mas aquele período pode ser considerado como o primeiro auge da internet. A World Wide Web é uma invenção genial de Tim Berners-Lee, o web 1.0 em sua forma clássica. Muitos sites e páginas, se referindo uns aos outros por meio de hyperlinks. À primeira vista, uma arquitetura simples, como todas as coisas geniais: descentralizada e livre. Eu quero — viajo pelos sites de outras pessoas, clicando em hyperlinks; eu quero — crio meu próprio site, onde publico o que me interessa — por exemplo, meus artigos, fotos, programas, hyperlinks para sites que me interessam. E os outros colocam links para mim.
À primeira vista — um quadro idílico? Mas você já sabe como tudo isso terminou.
Havia páginas demais, e a busca por informações tornou-se uma tarefa bastante complexa. Os hyperlinks criados pelos autores não conseguiam estruturar esse volume imenso de informações. Primeiro, surgiram diretórios, preenchidos manualmente, e depois enormes motores de busca, que passaram a usar algoritmos de classificação sofisticados. Sites eram criados e abandonados, informações eram duplicadas e distorcidas. A internet se comercializava rapidamente e se afastava cada vez mais da ideal rede acadêmica. A linguagem de marcação rapidamente se transformou em uma linguagem de formatação. Surgiu a publicidade, banners irritantes e a tecnologia de promoção e engano dos motores de busca — SEO. A rede rapidamente se tornava um lixo informativo. Os hyperlinks deixaram de ser ferramentas de conexão lógica e se transformaram em instrumentos de promoção. Os sites começaram a se fechar, se tornaram herméticos, transformando-se de "páginas" abertas em "aplicativos" fechados, tornando-se apenas meios de gerar lucro.
Naquela época, já me ocorreu uma certa ideia de que "algo não está certo". Uma infinidade de sites, desde páginas iniciais primitivas com um design berrante até "megaportal" sobrecarregados com banners piscantes. Mesmo quando os sites eram sobre o mesmo tema, eles não tinham nenhuma conexão, cada um com seu próprio design, sua própria estrutura, banners irritantes, mecanismos de busca que não funcionavam bem e problemas para download (sim, eu queria ter informações offline). Já naquela época, a internet começava a se transformar em uma espécie de televisão, onde, junto com o conteúdo útil, era colada toda sorte de enfeites.
A descentralização se tornou um pesadelo.
O que eu realmente queria?
Paradoxalmente, mesmo sem saber sobre web 2.0 ou p2p, eu como usuário não precisava de descentralização! Ao recordar meus pensamentos inocentes daquela época, chego à conclusão de que eu precisava de... uma base de dados única! Uma que retornasse todos os resultados de uma só vez, e não apenas os que eram mais adequados para o algoritmo de ranqueamento. Uma onde todos esses resultados estivessem organizados de maneira uniforme e estilizados com meu próprio design único, e não com os designs berrantes de inúmeros Vaquinhas Popkin. Uma que eu pudesse salvar offline e não temer que o site desaparecesse amanhã e as informações se perdessem para sempre. Uma que eu pudesse adicionar minhas próprias informações — como comentários e tags. Uma que eu pudesse buscar, classificar e filtrar com meus próprios algoritmos pessoais.
Web 2.0 e redes sociais
Entretanto, surgiu o conceito de Web 2.0. Formulado em 2005 por Tim O'Reilly, como "a metodologia de projetar sistemas que, ao levar em conta as interações da rede, se tornam melhores quanto mais pessoas os utilizam" — implicando na participação ativa dos usuários na criação e edição coletiva de conteúdo da Web. Sem exagero, o apogeu e o triunfo desse conceito foram as Redes Sociais. Gigantescas plataformas que reúnem bilhões de usuários e armazenam centenas de petabytes de dados.
O que nós recebemos nas redes sociais?
- unificação da interface; descobriu-se que todas as possibilidades de criar designs extravagantes não eram necessárias para os usuários; todas as páginas de todos os usuários têm o mesmo design e isso agrada a todos e é até conveniente; a única diferença é o conteúdo.
- unificação da funcionalidade; a diversidade de scripts também se mostrou desnecessária. «Feed», amigos, álbuns... ao longo da existência das redes sociais, sua funcionalidade se estabilizou e provavelmente não mudará: afinal, a funcionalidade é determinada pelos tipos de atividade das pessoas, e as pessoas praticamente não mudam.
- banco de dados unificado; trabalhar com um banco de dados assim se mostrou muito mais conveniente do que com vários sites dispersos; a busca se tornou muito mais simples. Em vez de escanear continuamente uma variedade de páginas fracas e interligadas, armazenar em cache tudo isso, classificar por algoritmos heurísticos complexos — uma consulta relativamente simples a um único banco de dados com uma estrutura conhecida.
- interface de feedback — curtidas e compartilhamentos; na web convencional, o Google, por exemplo, não conseguia obter feedback dos usuários depois de um clique no link nos resultados de busca. Nas redes sociais, essa conexão se mostrou simples e natural.
O que perdemos? Perdemos a descentralização, e, portanto, a liberdade. Acredita-se que agora nossos dados não nos pertencem. Se antes podíamos hospedar uma página pessoal até mesmo no nosso próprio computador, agora entregamos todos os nossos dados a gigantes da internet.
Além disso, à medida que a Internet se desenvolveu, governos e corporações se interessaram por ela, levando a problemas de censura política e restrições de direitos autorais. Nossas páginas nas redes sociais podem ser banidas e removidas se o conteúdo não obedecer a certas regras da rede; um post imprudente pode levar a responsabilidades administrativas e até criminais.
E aqui estamos nós, pensando novamente: será que não devemos tentar trazer de volta a descentralização? Mas de uma forma diferente, livre das falhas da primeira tentativa?
Redes peer-to-peer
As primeiras redes p2p surgiram muito antes do web 2.0 e se desenvolveram paralelamente à evolução da web. O principal uso clássico do p2p é a troca de arquivos; as primeiras redes foram desenvolvidas para compartilhar música. As primeiras redes (como o Napster) eram, na verdade, centralizadas, e por isso foram rapidamente fechadas pelos detentores de direitos autorais. Seus seguidores optaram pelo caminho da descentralização. Em 2000, surgiram os protocolos ED2K (o primeiro cliente eDokney) e Gnutella, em 2001 — o protocolo FastTrack (cliente KaZaA). Gradualmente, o grau de descentralização aumentou, e as tecnologias foram aprimoradas. Sistemas com "fila de download" foram substituídos por torrents, e surgiu o conceito de tabelas Hash distribuídas (DHT). Com a intensificação da supervisão governamental, a anonimidade dos participantes tornou-se mais procurada. Desde 2000, a rede Freenet está em desenvolvimento, a I2P desde 2003, e o projeto RetroShare foi iniciado em 2006. É possível mencionar diversas redes p2p, tanto as que já existiram e desapareceram quanto as que estão ativas atualmente: WASTE, MUTE, TurtleF2F, RShare, PerfectDark, ARES, Gnutella2, GNUNet, IPFS, ZeroNet, Tribbler e muitas outras. Há muitas. Elas são diferentes. Muito diferentes — tanto em propósito quanto em estrutura… Provavelmente muitos de vocês nem conhecem todos esses nomes. E isso é longe de ser tudo.
No entanto, as redes p2p têm várias desvantagens. Além das falhas técnicas inerentes a cada implementação específica do protocolo e do cliente, pode-se mencionar uma desvantagem bastante geral — a dificuldade de busca (ou seja, tudo o que a Web 1.0 enfrentou, mas em uma versão ainda mais complexa). Não há Google com sua busca onipresente e instantânea. E se, para redes de troca de arquivos, ainda é possível usar a busca por nome de arquivo ou metainformação, encontrar algo, por exemplo, em redes sobrepostas onion ou i2p, é bastante complicado, se é que é possível.
De modo geral, se fizermos analogias com a internet clássica, a maioria das redes descentralizadas estagnou em algum ponto do nível FTP. Imagine uma internet que não tem nada além de FTP: nem sites modernos, nem web 2.0, nem YouTube… É aproximadamente assim que as redes descentralizadas estão. E apesar de algumas tentativas isoladas de mudar algo, por enquanto as mudanças são poucas.
Conteúdo
Vamos abordar mais uma parte importante deste quebra-cabeça — o conteúdo. O conteúdo é o principal problema de qualquer recurso na internet, especialmente de um sistema descentralizado. De onde obtê-lo? Claro, pode-se contar com um grupo de entusiastas (como acontece com as redes P2P existentes), mas, nesse caso, o desenvolvimento da rede será bastante lento, e o conteúdo será escasso.
Trabalhar com a internet convencional é buscar e estudar conteúdo. Às vezes — salvar (se o conteúdo for interessante e útil, muitas pessoas, especialmente aquelas que entraram na rede na época da discagem — inclusive eu — prudentemente o salvam offline, para que não se perca; pois a internet é algo que não podemos controlar, hoje um site existe, amanhã não, hoje há um vídeo no YouTube — amanhã ele é removido, e assim por diante.
E para torrents (que percebemos mais como um meio de entrega do que como uma rede P2P), o salvamento é, na verdade, esperado. E esse é, aliás, um dos problemas dos torrents: uma vez baixado, é difícil mover o arquivo para onde é mais conveniente usá-lo (na maioria das vezes, é necessário regenerar o compartilhamento manualmente) e não é possível renomeá-lo (pode-se fazer um hardlink, mas isso é algo que quase ninguém conhece).
Em geral, muitas pessoas de uma forma ou de outra salvam conteúdo. Qual será seu destino? Normalmente, os arquivos salvos ficam em algum lugar do disco, numa pasta chamada Downloads, em uma grande pilha, e permanecem lá junto com milhares de outros arquivos. Isso é ruim — e, na verdade, ruim para o próprio usuário. Se a internet tem motores de busca, o computador local do usuário não possui nada parecido. É bom se o usuário for organizado e acostumado a classificar os ‘entrantes’ arquivos baixados. Mas nem todos são assim...
Na verdade, há muitas pessoas que não salvam nada e contam completamente com o online. Mas nas redes P2P, presume-se que o conteúdo seja armazenado localmente no dispositivo do usuário e compartilhado com outros participantes. É possível encontrar uma solução que envolva ambas as categorias de usuários em uma rede descentralizada, sem mudar seus hábitos e, mais importante ainda — facilitando suas vidas?
A ideia é bastante simples: e se houver uma ferramenta conveniente e transparente para o usuário salvar conteúdo da internet comum, e uma forma inteligente de salvar — com metainformação semântica, não em uma pilha desordenada, mas em uma estrutura específica com a possibilidade de posterior reestruturação, e ao mesmo tempo compartilhar o conteúdo salvo em uma rede descentralizada?
Vamos começar a salvar
Não vamos considerar o uso utilitário da internet para ver previsões do tempo ou horários de voos. Estamos mais interessados em objetos autosuficientes e, mais ou menos, imutáveis — artigos (desde tweets/postagens em redes sociais até grandes matérias, como aqui no Habr), livros, imagens, programas, gravações de áudio e vídeo. De onde vem a informação principalmente? Normalmente é
- redes sociais (diversas notícias, notas curtas — 'tweets', imagens, áudio e vídeo)
- artigos em recursos temáticos (como o Habr); não há muitos recursos bons, geralmente esses recursos também são construídos com base no princípio das redes sociais
- sites de notícias
Normalmente, lá existem funções padrão: 'curtir', 'repostar', 'compartilhar nas redes sociais', etc.
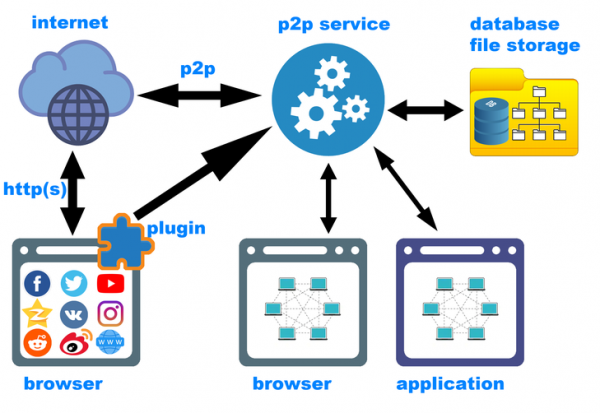
Vamos imaginar um plugin para o navegador, que vai salvar de maneira especial tudo aquilo que curtimos, repostamos, salvamos como 'favorito' (ou pressionamos um botão especial do plugin, exibido no menu do navegador — caso o site não tenha a função de curtir/repostar/adicionar aos favoritos). A ideia principal é que você simplesmente clica em 'curtir' — como fez um milhão de vezes antes, e o sistema salva o artigo, a imagem ou o vídeo em um armazenamento offline especial, e esse artigo ou imagem se torna acessível — tanto para visualização offline através da interface do cliente descentralizado, quanto na própria rede descentralizada! Para mim, isso é muito conveniente. Sem ações extras, e resolvemos várias tarefas de uma vez:
- salvamento de conteúdo valioso, que pode se perder ou ser excluído
- preenchimento rápido da rede descentralizada
- agregação de conteúdo de diferentes fontes (você pode estar registrado em dezenas de recursos da internet, e todos os likes/reposts vão se acumular em uma única base local)
- estruturação de conteúdo interessante para você sua regras
É evidente que o plugin do navegador deve ser configurado para a estrutura de cada site (isso é bastante viável — já existem plugins para salvar conteúdo do YouTube, Twitter, VK, etc.). Não há muitos sites para os quais vale a pena criar plugins personalizados. Geralmente, são redes sociais conhecidas (provavelmente não mais de uma dúzia) e alguns sites temáticos de alta qualidade, como o Habr (também são poucos). Com código aberto e especificação, o desenvolvimento de um novo plugin baseado em um modelo padrão não deve levar muito tempo. Para os demais sites, pode-se usar um botão de salvamento universal que salve toda a página em mhtml — possivelmente, limpando a página de anúncios antes.
Agora sobre a estruturação
Eu entendo por "salvamento inteligente" como pelo menos a conservação de metainformações: fonte do conteúdo (URL), conjunto de likes, tags, comentários, seus identificadores, etc. Afinal, ao salvar normalmente, essa informação se perde... A fonte pode ser entendida não apenas como um URL direto, mas também como um componente semântico: por exemplo, um grupo em uma rede social ou um usuário que fez o repost. O plugin pode ser suficientemente inteligente para usar essa informação para estruturar e taguear automaticamente. Além disso, é importante que o próprio usuário possa sempre adicionar alguma metainformação ao conteúdo salvo, para isso devem ser previstos meios de interface o mais conveniente possível (tenho muitas ideias sobre como fazer isso).
Assim, resolve-se a questão da estruturação e organização dos arquivos locais do usuário. Isso já é um benefício pronto, que pode ser utilizado mesmo sem nenhuma p2p. É simplesmente uma base offline, que sabe o que, de onde e em que contexto salvamos, e permite realizar pequenas pesquisas. Por exemplo, encontrar usuários de uma rede social externa que mais curtiram as mesmas postagens que você. Muitas redes sociais permitem isso de forma explícita?
Aqui já é importante mencionar que apenas um plugin para o navegador, evidentemente, não é suficiente. O segundo componente mais importante do sistema é o serviço de rede descentralizada que opera em segundo plano e atende tanto a própria rede p2p (consultas da rede e consultas do lado do cliente), quanto a preservação de novo conteúdo através do plugin. O serviço, trabalhando em conjunto com o plugin, posicionará o conteúdo no local correto, calculará hashes (e possivelmente conferirá se esse conteúdo já foi salvo anteriormente) e adicionará as metainformações necessárias ao banco de dados local.
O interessante é que o sistema já seria útil nessa forma, sem qualquer p2p. Muitas pessoas utilizam clipadores da web que adicionam conteúdo interessante da web, por exemplo, ao Evernote. A arquitetura proposta é uma versão ampliada desse tipo de clipador.
E, finalmente, a troca p2p.
O mais agradável é que informações e metainformações (tanto capturadas da web quanto as próprias) podem ser trocadas. O conceito de rede social se transfere perfeitamente para a arquitetura p2p. Pode-se dizer que rede social e p2p são como se fossem feitos um para o outro. Qualquer rede descentralizada, idealmente, deveria ser construída como uma rede social, pois só assim funcionará de forma eficaz. "Amigos", "Grupos" — são esses os pares que devem ter conexões duráveis, e estas vêm de uma fonte natural — interesses comuns dos usuários.
Os princípios de preservação e compartilhamento de conteúdo em uma rede descentralizada são completamente idênticos aos princípios de preservação (captura) de conteúdo da internet comum. Se você utiliza algum conteúdo da rede (ou seja, o salvou), qualquer um pode utilizar seus recursos (disco e canal) necessários para obter esse conteúdo específico.
Curtidas — a ferramenta mais simples de preservação e compartilhamento. Se eu curti — não importa se na internet externa ou dentro da rede descentralizada — isso significa que eu gosto do conteúdo, e se assim for — estou disposto a mantê-lo localmente e compartilhar com outros participantes da rede descentralizada.
- O conteúdo não será "perdido"; agora ele está salvo localmente em meu dispositivo, poderei retornar a ele mais tarde, a qualquer momento, sem me preocupar que alguém o apague ou bloqueie.
- Posso categorizar, etiquetar, comentar, associar a outro conteúdo, ou seja, fazer algo significativo com ele — chamaremos isso de "formação de metainformação".
- Posso compartilhar essa metainformação com outros participantes da rede.
- Posso sincronizar minha metainformação com a metainformação de outros participantes.
Talvez a remoção dos deslikes também faça sentido: se o conteúdo não me agrada — é compreensível que eu não queira desperdiçar meu espaço de disco e minha banda de internet para distribuir esse conteúdo. Portanto, os deslikes não se encaixam bem na descentralização (embora às vezes isso possa ser útil). ).
Às vezes, é necessário salvar aquilo que "não gosto". Há uma palavra que diz "preciso" :)
«Favoritos— não expresso uma opinião sobre o conteúdo, mas o salvo na minha base local de favoritos. A palavra "favoritos" não se aplica perfeitamente ao seu significado (para isso existem os likes e a posterior categorização), enquanto "favoritos" (bookmarks) se encaixa bem. O conteúdo nos "favoritos" também é distribuído — se ele é "necessário" para você (ou seja, se de alguma forma você "usa"), é lógico que ele pode ser "necessário" para alguém mais. Por que não usar seus recursos para isso?
Está bastante clara a função de "amigos" . São grupos, pessoas com interesses semelhantes, e portanto, aquelas que provavelmente terão conteúdo interessante. Em uma rede descentralizada, isso significa principalmente assinar o feed de notícias de amigos e ter acesso aos álbuns com o conteúdo que eles salvaram.
Da mesma forma, a função "grupos" são feeds coletivos, ou fóruns, ou algo assim que também pode ser assinado — e, portanto, você pode receber todo o material do grupo e distribuí-lo. Talvez "grupos", assim como grandes fóruns, devessem ser hierárquicos — isso permitiria estruturar melhor o conteúdo dos grupos, além de limitar o fluxo de informações e não receber/não distribuir aquilo que não é muito interessante para você.
Tudo o mais
É importante notar que a arquitetura descentralizada é sempre mais complexa do que a centralizada. Em recursos centralizados, há uma ditadura rígida do código do servidor. Nos descentralizados, há a necessidade de negociar entre muitos participantes iguais. Evidentemente, isso não pode ser feito sem criptografia, blockchains e outras inovações, desenvolvidas principalmente para criptomoedas.
Suponho que possam ser necessários certos classificadores criptográficos mútuos de confiança, criados pelos participantes da rede uns para os outros. A arquitetura deve permitir combater efetivamente botnets, que, existindo em uma nuvem, podem, por exemplo, intercambiar classificações entre si. É desejável que as corporações e fazendas de botnets, apesar de sua superioridade tecnológica, não assumam o controle de tal rede descentralizada; que seu principal recurso sejam pessoas reais, capazes de produzir e estruturar conteúdo interessante e útil para outras pessoas.
Ainda desejo que tal rede impulsione a civilização rumo ao progresso. Tenho uma infinidade de ideias sobre esse assunto, que, no entanto, não se encaixam nos limites deste artigo. Digo apenas que, de certa forma, o conteúdo científico, técnico, médico, etc., deve ter prioridade sobre o conteúdo de entretenimento, e isso exigirá, de fato, certa moderação. A própria moderação de uma rede descentralizada é uma tarefa não trivial, mas é possível resolver (embora a palavra "moderação" aqui seja completamente incorreta e não reflete a essência do processo - nem externamente, nem internamente... e eu nem mesmo inventei como poderia chamar esse processo).
Provavelmente, será desnecessário mencionar a necessidade de garantir a anonimidade - tanto por meios integrados (como no i2p ou Retroshare), quanto passando todo o tráfego pelo TOR ou VPN.
E finalmente, a arquitetura do software (esquematicamente desenhada na imagem do artigo). Como já mencionado, o primeiro componente do sistema é um plugin para o navegador que captura conteúdo com metainformações. O segundo componente fundamental é um serviço p2p que opera em segundo plano (‘backend’). O funcionamento da rede não deve depender da ativação do navegador. O terceiro componente é o software cliente — frontend. Isso pode ser um serviço web local (nesse caso, o usuário poderá trabalhar com a rede descentralizada sem sair do seu navegador favorito) ou um aplicativo GUI separado para um sistema operacional específico (Windows, Linux, MacOS, Android, iOS etc.). Gosto da ideia da coexistência simultânea de todas as opções de frontend. Isso também exigirá uma arquitetura de backend mais rigorosa.
Há muitos outros aspectos que não foram incluídos neste artigo. A conexão com o compartilhamento de repositórios de arquivos existentes (ou seja, quando você já possui alguns terabytes baixados e permite que o cliente escaneie isso, obtenha hashes, os compare com o que existe na Rede e junte-se ao compartilhamento, ao mesmo tempo recebendo da Rede metainformações sobre seus próprios arquivos — nomes normais, descrições, classificações, avaliações etc.), a conexão com fontes externas de metainformação (como bancos de dados do Libgen), a utilização opcional de espaço em disco para armazenar conteúdo criptografado de terceiros (como no Freenet), a arquitetura de integração com redes descentralizadas existentes (aqui é um território desconhecido), a ideia de media hashing (uso de hashes perceptivos especiais para conteúdo de mídia — imagens, áudio e vídeo, permitindo a correlação de arquivos de mídia que têm o mesmo significado, mas diferem em tamanho, resolução etc.) e muito mais.
Resumo do artigo
1. Em redes descentralizadas, não há Google com sua busca e classificação — mas existe uma Comunidade de pessoas reais. A rede social com seus mecanismos de feedback (curtidas, reposts…) e gráfico social (amigos, comunidades…) é o modelo ideal de nível aplicativo para uma rede descentralizada.
2. A ideia principal que trago com este artigo é a salvaguarda automática de conteúdo interessante da internet comum ao dar um like/repost; isso pode ser útil mesmo sem p2p, apenas mantendo um arquivo pessoal de informações interessantes.
3. Este conteúdo também pode automaticamente preencher uma rede descentralizada.
4. O princípio de salvaguarda automática de conteúdo interessante funciona também para likes/reposts na própria rede descentralizada.
Fonte: habr.com
