

No dia 26 de fevereiro, realizamos um meetup do Apache Ignite GreenSource, onde participaram contribuidores do projeto de código aberto. . Um evento importante na vida dessa comunidade foi a reestruturação do componente , que permite implantar microsserviços personalizados diretamente no cluster Ignite. Sobre esse processo desafiador, falou no meetup , engenheiro de software e contribuinte do Apache Ignite há mais de dois anos.
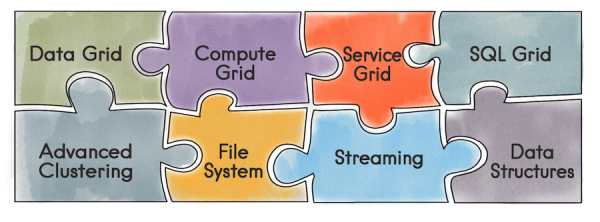
Vamos começar pelo que é o Apache Ignite. É um banco de dados que representa um armazenamento distribuído de Key/Value com suporte a SQL, transações e caching. Além disso, o Ignite permite implantar serviços personalizados diretamente no cluster Ignite. O desenvolvedor tem acesso a todas as ferramentas oferecidas pelo Ignite — estruturas de dados distribuídas, Messaging, Streaming, Compute e Data Grid. Por exemplo, ao utilizar o Data Grid, a necessidade de administrar uma infraestrutura separada para o armazenamento de dados desaparece, reduzindo, consequentemente, os custos associados.
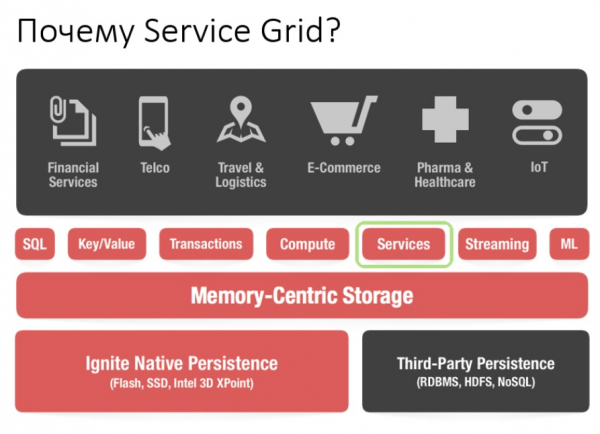
Usando a API Service Grid, é possível implantar um serviço ao simplesmente especificar no arquivo de configuração o esquema de implantação e, consequentemente, o próprio serviço.
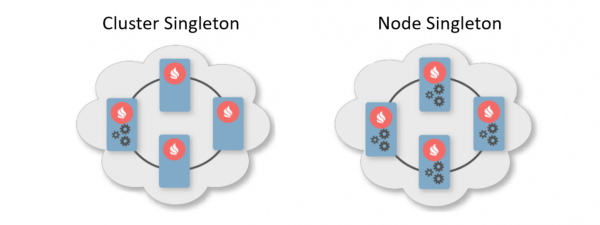
Normalmente, o esquema de implantação é a indicação da quantidade de instâncias que devem ser implantadas nos nós do cluster. Existem dois esquemas de implantação típicos. O primeiro é o Cluster Singleton: em qualquer momento, haverá garantidamente uma instância do serviço personalizado disponível no cluster. O segundo é o Node Singleton: em cada nó do cluster, há uma instância do serviço implantada.
O usuário também pode especificar a quantidade de instâncias do serviço em todo o cluster e definir um predicado para filtrar os nós adequados. Nesse cenário, o Service Grid calculará automaticamente a distribuição ideal para a implantação dos serviços.
Além disso, existe um recurso chamado Affinity Service. Affinity é uma função que define a relação das chaves com partições e a relação das partições com nós na topologia. Com a chave, é possível determinar o nó primário onde os dados são armazenados. Dessa forma, você pode associar seu próprio serviço a uma chave e ao cache da função affinity. Caso a função affinity seja alterada, ocorrerá um redeploy automático. Assim, o serviço estará sempre localizado próximo dos dados que deve manipular, reduzindo, portanto, os custos de acesso à informação. Esse esquema pode ser chamado de cálculos colaborativos de certa maneira.
Agora que abordamos as vantagens do Service Grid, vamos falar sobre sua história de desenvolvimento.
O que havia antes
A implementação anterior do Service Grid era baseada em um cache de sistema replicado transacional chamado Ignite. Sob a palavra "cache" em Ignite, entende-se um armazenamento. Ou seja, não é algo temporário, como se poderia pensar. Apesar de o cache ser replicado e cada nó conter todo o conjunto de dados, internamente o cache tem uma representação particionada. Isso está relacionado à otimização dos armazenamentos.
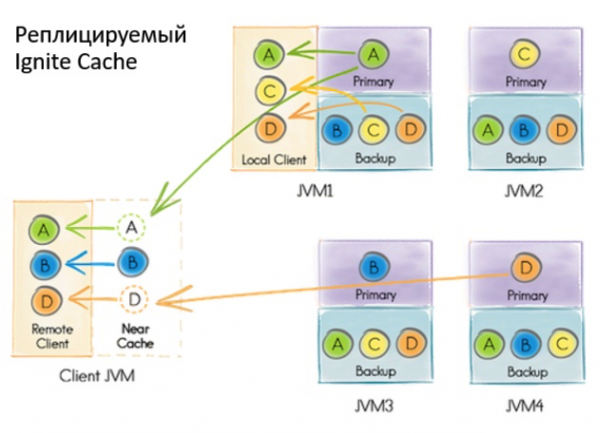
O que acontecia quando um usuário queria implantar um serviço?
- Todos os nós no cluster assinavam para atualizações de dados no armazenamento usando o mecanismo embutido Continuous Query.
- O nó iniciador, sob uma transação read-committed, fazia uma gravação no banco que continha a configuração do serviço, incluindo uma instância serializada.
- Ao receber uma notificação sobre uma nova gravação, o coordenador calculava a distribuição com base na configuração. O objeto obtido era gravado de volta no banco.
- Se o nó entrasse na distribuição, o coordenador deveria implantá-lo.
O que não nos agradava
Em algum momento, chegamos à conclusão de que não era possível operar serviços dessa maneira. Havia várias razões.
Se durante o deployment ocorresse algum erro, só poderíamos saber disso através dos logs do nó onde tudo aconteceu. Existia apenas um deployment assíncrono, então após a devolução do controle ao usuário pelo método de deployment, seria necessário um tempo adicional para o serviço iniciar — e nesse tempo o usuário não poderia gerenciar nada. Para continuar desenvolvendo o Service Grid, implementar novos recursos, atrair novos usuários e facilitar a vida de todos, era necessário mudar algo.
Ao projetar a nova Service Grid, nossa prioridade foi garantir uma implantação síncrona: assim que o usuário recupera o controle da API, ele pode imediatamente usar os serviços. Também queríamos dar ao iniciador a capacidade de lidar com erros de implantação.
Além disso, queríamos facilitar a implementação, especificamente afastar-nos de transações e reequilíbrio. Embora o cache seja replicável e não haja balanceamento, durante uma grande implantação com múltiplos nós surgiram problemas. Ao alterar a topologia, os nós precisam trocar informações e, em uma grande implantação, esses dados podem pesar bastante.
Quando a topologia estava instável, o coordenador precisava recalcular a distribuição dos serviços. E no geral, trabalhar com transações em uma topologia instável pode levar a erros difíceis de prever.
Problemas
Quais grandes mudanças não vêm acompanhadas de problemas? O primeiro deles foi a alteração da topologia. É importante entender que a qualquer momento, mesmo durante a implantação do serviço, um nó pode entrar ou sair do cluster. Além disso, se um nó entrar no cluster durante a implantação, será necessário transmitir todas as informações sobre os serviços para o novo nó de maneira consistente. E isso inclui não apenas o que já foi implementado, mas também implantações atuais e futuras.
Este é apenas um dos problemas que podem ser reunidos em uma lista separada:
- Como implantar serviços configurados estaticamente ao iniciar um nó?
- Saída de um nó do cluster – o que fazer se o nó hospedava serviços?
- O que fazer se o coordenador mudou?
- O que fazer se o cliente se reconectar ao cluster?
- É necessário processar solicitações de ativação/desativação e como?
- E se chamarmos a destruição do cache, e tivermos serviços de afinidade ligados a ele?
E isso está longe de ser tudo.
Solução
Como alvo, escolhemos a abordagem orientada a eventos com a implementação da comunicação entre processos por meio de mensagens. No Ignite, já estão implementados dois componentes que permitem que os nós se enviem mensagens, sendo eles o communication-spi e o discovery-spi.
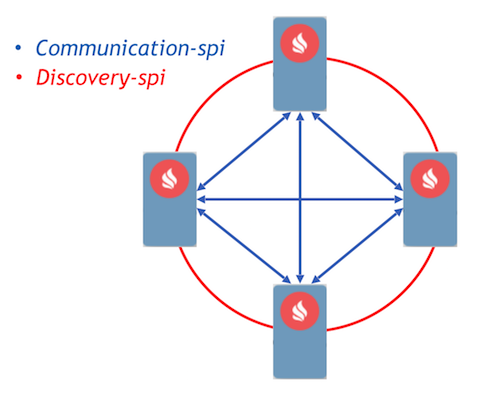
O Communication-spi permite que os nós se comuniquem diretamente e troquem mensagens. Ele é ideal para transferir grandes volumes de dados. O Discovery-spi permite enviar uma mensagem para todos os nós no cluster. Na implementação padrão, isso é feito utilizando a topologia de "anel". Também há integração com o Zookeeper, nesse caso, utiliza-se a topologia de "estrela". É importante notar que o discovery-spi oferece garantias de que a mensagem será entregue na ordem correta a todos os nós.
Vamos considerar o protocolo de deployment. Todas as solicitações de usuários para deployment e undeployment são enviadas pelo discovery-spi. Isso fornece as seguintes garantias:
- A solicitação será recebida por todos os nós do cluster. Isso permitirá que o processamento da solicitação continue com a troca de coordenadores. Também significa que, para uma única mensagem, cada nó terá todos os metadados necessários, tais como a configuração do serviço e sua instância serializada.
- A entrega estrita das mensagens permite resolver conflitos de configurações e solicitações concorrentes.
- Como a entrada de um nó na topologia também é processada via discovery-spi, o novo nó receberá todos os dados necessários para trabalhar com os serviços.
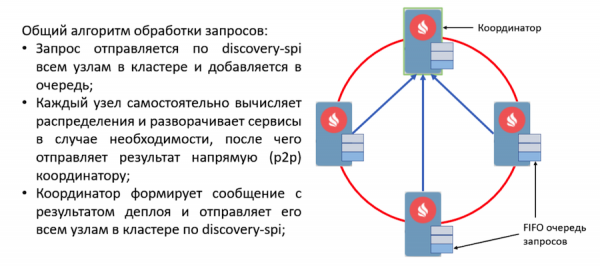
Ao receber a solicitação, os nós no cluster a validam e formam tarefas para processamento. Essas tarefas são colocadas em uma fila e depois processadas em outra thread por um trabalhador separado. Isso é implementado dessa forma porque o deployment pode levar um tempo significativo e atrasar o caro fluxo de discovery é inaceitável.
Todas as solicitações na fila são processadas pelo gerenciador de deployment. Ele tem um trabalhador especial que retira a tarefa dessa fila e a inicializa para começar o deployment. Após isso, as seguintes ações ocorrem:
- Cada nó calcula autonomamente a distribuição usando uma nova função de assignment determinística.
- Os nós formam uma mensagem com os resultados do deployment e a enviam ao coordenador.
- O coordenador agrega todas as mensagens e forma o resultado de todo o processo de deployment, que é enviado via discovery-spi para todos os nós no cluster.
- Ao receber o resultado, o processo de deployment é concluído, após o qual a tarefa é removida da fila.
Novo design orientado a eventos: org.apache.ignite.internal.processors.service.IgniteServiceProcessor.java
Se ocorrer um erro durante a implantação, o nó imediatamente inclui esse erro na mensagem que envia ao coordenador. Após a agregação das mensagens, o coordenador terá informações sobre todos os erros ocorridos durante a implantação e enviará essa mensagem pelo discovery-spi. As informações sobre os erros estarão disponíveis em qualquer nó do cluster.
Esse algoritmo de trabalho processa todos os eventos importantes na Service Grid. Por exemplo, uma mudança de topologia também é uma mensagem pelo discovery-spi. E, em geral, se compararmos com o que havia antes, o protocolo se tornou bastante leve e confiável. O suficiente para lidar com qualquer situação durante a implantação.
O que vem a seguir
Agora sobre os planos. Qualquer grande melhoria no projeto Ignite é realizada como uma iniciativa para aprimorar o Ignite, o chamado IEP. O redesign da Service Grid também possui um IEP — com o título irreverente "Troca de óleo na Service Grid". Mas, na verdade, nós não trocamos o óleo do motor, mas o motor inteiro.
Dividimos as tarefas do IEP em 2 fases. A primeira — uma fase importante, que consiste na reformulação do protocolo de implantação. Ela já foi integrada ao master, e você pode experimentar a nova Service Grid que aparecerá na versão 2.8. A segunda fase inclui muitas outras tarefas:
- Redeploy quente
- Versionamento de serviços
- Aumento da resistência a falhas
- Cliente leve
- Ferramentas de monitoramento e contagem de várias métricas
Por último, podemos recomendar a Service Grid para a construção de sistemas de alta disponibilidade e tolerância a falhas. E também o convidamos a participar do e compartilhando sua experiência. Sua experiência é realmente importante para a comunidade, ajudando a entender o caminho a seguir e como desenvolver o componente no futuro.
Fonte: habr.com
