

In-Memory — um conjunto de conceitos de armazenamento de dados em que eles são mantidos na memória RAM da aplicação, enquanto o disco é usado para backup. Em abordagens tradicionais, os dados são armazenados no disco e a memória atua como cache. Por exemplo, um aplicativo web com backend para processamento de dados solicita esses dados do armazenamento: recebe, transforma e, ao longo da rede, trafega uma grande quantidade de informações. No In-Memory, os cálculos são enviados para os dados – no armazenamento, onde são processados, diminuindo a carga da rede.

Quais outras possibilidades estão disponíveis com o In-Memory e que tipo de abordagem é essa, será explicado por Vladimir Pligin — engenheiro da empresa GridGain. Este material de revisão será útil para desenvolvedores de backend de aplicativos web que não trabalharam com In-Memory e desejam experimentar, ou que estão interessados nas tendências atuais de desenvolvimento de soluções de software e arquiteturas.
Nota. O artigo é baseado na transcrição da palestra de Vladimir na conferência #GetIT Conf. Antes da introdução do isolamento social, costumávamos realizar meetups e conferências para desenvolvedores em Moscovo e São Petersburgo: discutíamos tendências, questões atuais de desenvolvimento, problemas e suas soluções. Agora, não podemos realizar conferências, mas é o momento perfeito para compartilhar materiais úteis do passado.
Quem e como utiliza o In-Memory
O In-Memory é mais utilizado onde a interação rápida com o usuário ou o processamento de grandes volumes de dados é necessário.
- Bancos usam In-Memory, por exemplo, para reduzir a latência ao usar aplicativos pelos clientes ou para análise de clientes antes da concessão de crédito.
- Fintechs usam In-Memory para melhorar o desempenho de serviços e aplicativos bancários, que terceirizam o processamento e análise de dados.
- Companhias de seguros: para calcular riscos, por exemplo, analisando os dados do cliente ao longo de vários anos.
- Empresas logísticas. Elas processam muitos dados, por exemplo, para calcular as rotas ideais para o transporte de cargas e passageiros com milhares de parâmetros, monitorando o status das remessas.
- Varejo. Soluções In-Memory ajudam a atender os clientes mais rapidamente e a processar grandes volumes de informações: remessas, faturas, transações, disponibilidade de milhares de produtos em estoque, gerando relatórios analíticos.
- Em IoT In-Memory substitui bancos de dados tradicionais.
- Empresas farmacêuticas usam In-Memory, por exemplo, para testar combinações de insumos medicamentosos.
Vou compartilhar alguns exemplos de como nossos clientes usam soluções In-Memory e como você pode implementá-las em sua empresa.
In-Memory como armazenamento principal
Um de nossos clientes é um grande fornecedor de equipamentos médicos científicos dos EUA. Eles usam a solução In-Memory como armazenamento de dados principal. Todos os dados são armazenados no disco, enquanto um subconjunto de dados que é ativado fica na memória RAM. Os métodos de acesso ao armazenamento são padrão— GDBC (Generic Database Connector) e linguagem de consultas SQL.
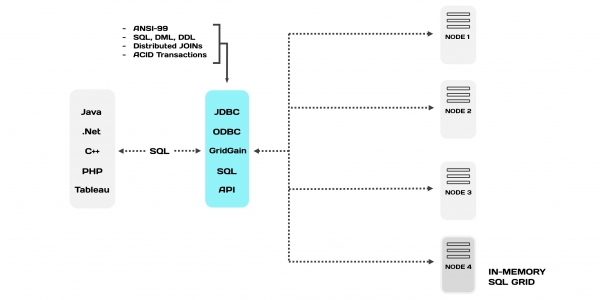
Tudo isso é chamado de In-Memory Database (IMDB) ou Armazenamento Centrado na Memória. Essa classe de soluções tem muitos nomes, não são os únicos.
Características do IMDB:
- Os dados armazenados no In-Memory e acessíveis via SQL são os mesmos que em outras abordagens. Eles estão sincronizados, a única diferença é a forma de apresentação e o modo de acessá-los. A transacionalidade opera entre os dados.
- O IMDB é mais rápido do que os bancos de dados relacionais, pois acessar informações da memória RAM é mais rápido do que do disco.
- Os algoritmos internos de otimização têm menos instruções.
- O IMDB é adequado para gerenciar dados, eventos e transações em aplicações.
O IMDB suporta parcialmente ACID: atomicidade, consistência e isolamento. Mas não suporta 'durabilidade' — ao desligar a energia, todos os dados se perdem. Para resolver esse problema, podem ser usados snapshots — 'imagens' do banco de dados, semelhante a um backup do BD no disco rígido, ou registrar transações (logs) para recuperar dados após reinicialização.
Para criar aplicações tolerantes a falhas
Vamos apresentar a arquitetura clássica de um aplicativo web com alta disponibilidade. Ela funciona assim: todas as solicitações são distribuídas por um balanceador de carga entre os servidores. Este sistema é resistente, pois os servidores se duplicam e se protegem mutuamente em caso de incidentes.
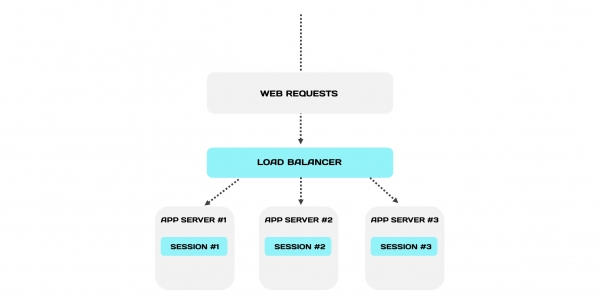
O balanceador direciona todas as solicitações de uma sessão para um único servidor. Este é o mecanismo de sticky sessions: cada sessão é vinculada a servidor, onde é armazenada e processada localmente.
O que acontecerá quando um dos servidores?
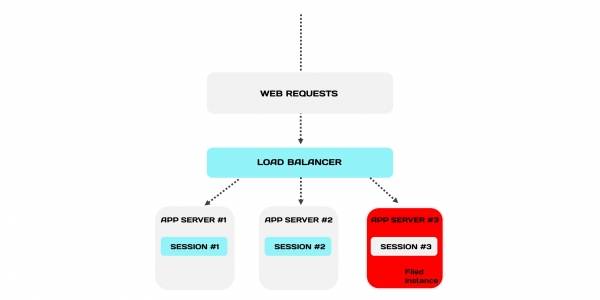
Serviços não será afetado, pois a arquitetura é redundante. Mas perderemos um subconjunto de sessões do servidor que falhou. E também os usuários que estão vinculados a essas sessões. Por exemplo, um cliente finaliza um pedido e, de repente, é desconectado da sua conta. Ele ficará insatisfeito ao ter que se autorizar novamente e descobrir que precisa fazer tudo de novo.
O aplicativo web precisa suportar um grande número de usuários e não 'engasgar', para que seja confortável para eles trabalharem. Mas em caso de falha, a cada nova solicitação, o tempo de comunicação com o armazenamento de sessões aumentará. Isso aumenta a latência média para os demais usuários. Mas eles não querem esperar mais do que estão acostumados.
Esse problema pode ser resolvido, como fez outro de nossos clientes — um grande provedor de PASS dos EUA. Ele utiliza In-Memory para clusterizar sessões web. Para isso, armazena-as não localmente, mas de forma centralizada — em um cluster In-Memory. Nesse caso, as sessões estão disponíveis muito mais rapidamente, pois já estão na memória operacional.
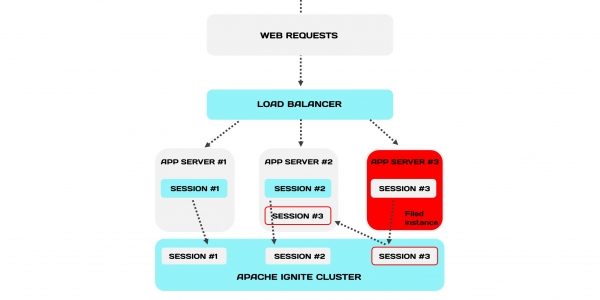
Quando um servidor falha, o balanceador direciona as solicitações do servidor falhou para outros servidores, como na arquitetura clássica. Mas há uma diferença importante: as sessões são armazenadas em um cluster In-Memory e os servidores têm acesso às sessões do servidor que falhou.
Essa arquitetura aumenta a resiliência de todo o sistema. Além disso, é possível até mesmo abrir mão do mecanismo de sticky sessions.
Processamento transacional-analítico híbrido (HTAP)
Normalmente, sistemas transacionais e analíticos são mantidos separados. Quando eles são separados, a base de dados principal é sobrecarregada. Para o processamento analítico, os dados são copiados para uma réplica, para que o processamento analítico não interfira nos processos transacionais. No entanto, a cópia ocorre com atraso — sem atraso, a replicação não é possível. Se fizermos isso de forma síncrona, também irá desacelerar a base de dados principal, e não teremos ganhos.
No HTAP, tudo funciona de maneira diferente — o mesmo repositório de dados é utilizado para a carga transacional dos aplicativos e para as consultas analíticas, que podem levar mais tempo para serem concluídas. Quando os dados estão na memória, as consultas analíticas são executadas mais rapidamente, e o servidor com o banco de dados é menos sobrecarregado (em média).
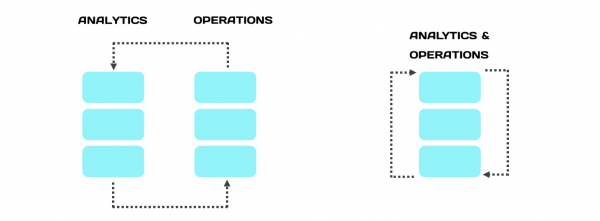
A abordagem híbrida "quebra a barreira" entre o processamento de transações e a análise. Se realizamos a análise no mesmo repositório, as consultas analíticas são executadas sobre dados que estão na memória. Elas são muito mais precisas, interpretáveis e adequadas.
Integração de soluções In-Memory
Uma forma (relativamente) simples — desenvolver tudo do zero. Mantemos os dados no disco, enquanto os dados quentes são armazenados na memória. Isso ajuda a suportar reinicializações de servidores ou quedas.
Aqui, funcionam dois cenários principais, quando os dados são armazenados no disco. No primeiro, queremos suportar falhas ou reinicializações planejadas do cluster ou de partes — queremos usar como um banco de dados simples. No segundo cenário, quando há muitos dados, parte deles fica na memória.
Se não há possibilidade de construir tudo do zero, é possível integrar In-Memory na já arquitetura existente. Mas nem todas as soluções In-Memory são adequadas para isso. Existem três condições obrigatórias. A solução In-Memory deve suportar:
- um método padrão de conexão com o banco de dados que ficará abaixo dele (por exemplo, MySQL);
- uma linguagem de consulta padrão, para não reescrever ou alterar a lógica de interação com o repositório;
- transacionalidade — manter a semântica da interação.
Se todas as três condições forem atendidas, a integração é possível. Colocamos o In-Memory Data Grid entre o aplicativo e o banco de dados. Agora, as consultas de escrita serão delegadas para o banco de dados inferior, enquanto as consultas de leitura vão para o banco de dados, caso os dados não estejam no cache.
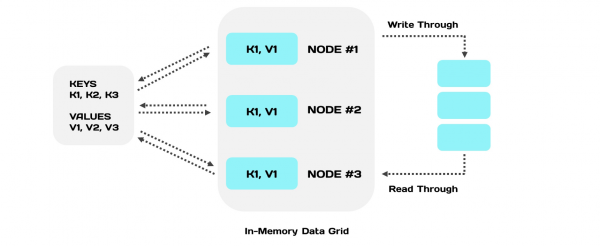
Se você valoriza o acesso rápido a dados e seu processamento, por exemplo, para análise de negócios, pode considerar a implementação de In-Memory. Para a implementação, você pode usar ambas as abordagens ao projetar uma nova arquitetura.
Fonte: habr.com
