

Assim como no , surgiu um problema com o serviço distribuído, que chamaremos de Elvin. Desta vez, eu não descobri o problema por conta própria, fui informado pela equipe de suporte ao cliente.
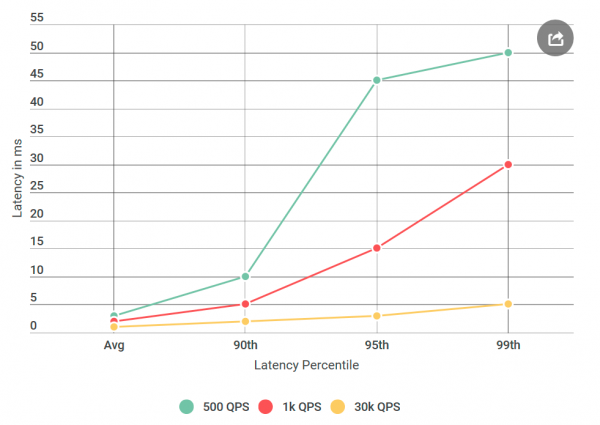
Certa vez, acordei com um e-mail insatisfeito devido a grandes atrasos no Elvin, que planejávamos lançar em breve. Em particular, o cliente enfrentou um atraso no percentil 99 em torno de 50 ms, muito acima do nosso orçamento de latência. Isso foi surpreendente, pois testei rigorosamente o serviço, especialmente em relação à latência, que é um assunto de frequentes queixas.
Antes de entregar o Elvin para testes, realizei muitos experimentos com 40 mil solicitações por segundo (QPS), todos mostraram latência inferior a 10 ms. Eu estava pronto para afirmar que não concordava com os resultados deles. Mas ao olhar novamente para o e-mail, notei algo novo: eu definitivamente não testei as condições que eles mencionaram, o QPS deles era muito menor que o meu. Eu testei em 40 mil QPS, enquanto eles apenas com 1 mil. Realizei outro experimento, desta vez com um QPS mais baixo, apenas para agradá-los.
Como estou escrevendo sobre isso no blog – provavelmente você já percebeu: os números deles estavam corretos. Verifiquei meu cliente virtual repetidamente, tudo com o mesmo resultado: um baixo número de solicitações não apenas aumenta a latência, mas também aumenta o número de solicitações com latência superior a 10 ms. Em outras palavras, se em 40 mil QPS cerca de 50 solicitações por segundo excediam 50 ms, em 1 mil QPS havia 100 solicitações acima de 50 ms a cada segundo. Paradoxo!
Afunilando a busca
Enfrentando um problema de latência em um sistema distribuído com muitos componentes, a primeira coisa a fazer é elaborar uma lista curta de suspeitos. Vamos nos aprofundar um pouco mais na arquitetura do Elvin:
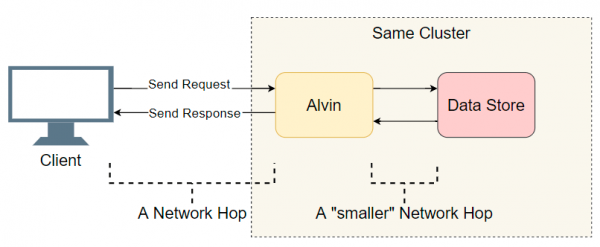
Um bom ponto de partida é a lista de transições de entrada e saída realizadas (chamadas de rede / busca no disco etc.). Vamos tentar descobrir onde está a latência. Além da óbvia entrada e saída com o cliente, o Elvin faz um passo adicional: ele consulta o armazenamento de dados. No entanto, esse armazenamento funciona em um cluster com o Elvin, então a latência lá deve ser menor do que com o cliente. Assim, a lista de suspeitos:
- Chamada de rede do cliente para o Elvin.
- Chamada de rede do Elvin para o armazenamento de dados.
- Busca no disco no armazenamento de dados.
- Chamado de rede do armazenamento de dados para Elvin.
- Chamado de rede de Elvin para o cliente.
Vamos tentar eliminar alguns pontos.
O armazenamento de dados nada tem a ver com isso
Primeiro, transformei Elvin em um servidor ping-ping, que não processa solicitações. Ao receber uma solicitação, ele retorna uma resposta vazia. Se a latência diminui, é um erro na implementação de Elvin ou do armazenamento de dados - nada de incomum. No primeiro experimento, obtemos este gráfico:
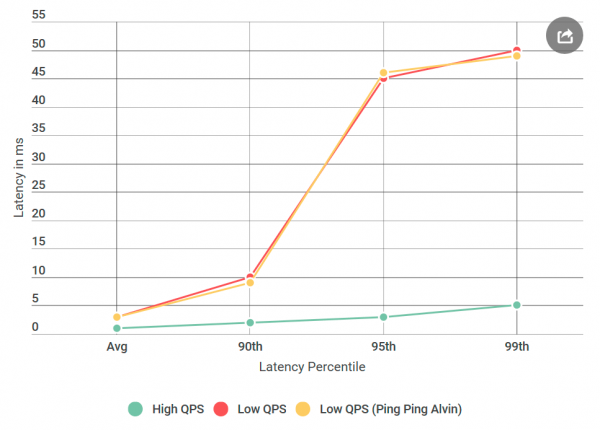
Como podemos ver, ao usar o servidor ping-ping, não há melhora alguma. Isso significa que o armazenamento de dados não aumenta a latência, e a lista de suspeitos é reduzida pela metade:
- Chamada de rede do cliente para o Elvin.
- Chamado de rede de Elvin para o cliente.
Ótimo! A lista está diminuindo rapidamente. Eu pensei que quase descobri a causa.
gRPC
Agora é a hora de apresentar um novo jogador: . Esta é uma biblioteca de código aberto do Google para comunicação intra-processo . Embora gRPC seja bem otimizada e amplamente utilizada, é a primeira vez que a uso em um sistema dessa escala, e eu esperava que minha implementação fosse subótima - para dizer o mínimo.
A presença de gRPC no stack gerou uma nova pergunta: pode ser que minha implementação ou a própria gRPC causa o problema da latência? Adicionamos um novo suspeito à lista:
- O cliente chama a biblioteca
gRPC - A biblioteca
gRPCno cliente, executa a chamada de rede da bibliotecagRPCno servidor - A biblioteca
gRPCse conecta a Elvin (sem operação no caso do servidor ping-pong)
Para que vocês entendam como é o código, minha implementação do cliente/Elvin não difere muito dos exemplos de cliente-servidor .
Nota: a lista acima é um pouco simplificada, pois
gRPCpermite o uso de um modelo de thread próprio (template?), onde o stack de execução se entrelaçagRPCcom a implementação do usuário. Para simplificar, seguiremos este modelo.
O perfilamento resolverá tudo
Eliminando os armazenamentos de dados, pensei que estava quase lá: "Agora é fácil! Vamos aplicar o perfil e descobrir onde a latência aparece". Eu , porque a CPU é muito rápida e costuma não ser o gargalo. A maioria das latências ocorre quando a CPU deve parar de processar para fazer algo mais. O perfilamento preciso da CPU é feito exatamente para isso: ele registra com precisão todas as e mostra onde ocorrem as latências.
Eu peguei quatro perfis: para um alto QPS (baixa latência) e com um servidor ping-pong em baixo QPS (alta latência), tanto do lado do cliente quanto do lado do servidor. E só para garantir, também peguei uma amostra do perfil do processador. Ao comparar os perfis, normalmente procuro por pilhas de chamadas anômalas. Por exemplo, no lado ruim com alta latência, há muito mais mudanças de contexto (10 vezes ou mais). Mas, neste meu caso, o número de mudanças de contexto quase coincidiu. Para meu horror, não havia nada significativo lá.
Depuração adicional
Eu estava desesperado. Não sabia que outras ferramentas poderiam ser usadas, e meu próximo plano consistia basicamente em repetir experimentos com diferentes variações, em vez de diagnosticar claramente o problema.
E se
Desde o início, estava preocupado com um tempo de latência específico de 50 ms. Isso é um tempo muito alto. Decidi que cortaria pedaços do código até conseguir descobrir exatamente qual parte estava causando esse erro. Então, veio um experimento que funcionou.
Como sempre, com a mente retrospectiva, parece que tudo era óbvio. Coloquei o cliente em uma máquina com Elvin— e enviei a solicitação para localhost. E o aumento da latência desapareceu!
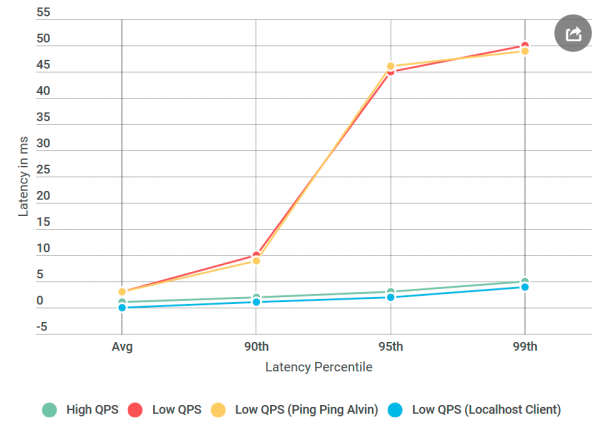
Algo estava errado com a rede.
Acumulando habilidades de engenheiro de rede
Devo confessar: meu conhecimento em tecnologias de rede é horrível, especialmente considerando que trabalho com elas diariamente. Mas a rede era o principal suspeito, e eu precisava aprender como depurá-la.
Felizmente, a internet gosta dos que querem aprender. A combinação de ping e tracert parecia um bom começo para depurar problemas de transporte de rede.
Primeiro, executei na porta TCP de Elvin. Usei as configurações padrão — nada de especial. De mais de mil pings, nenhum ultrapassou 10 ms, exceto o primeiro para aquecimento. Isso contradiz o aumento observado de latência de 50 ms no 99º percentil: para cada 100 solicitações, deveríamos ter visto cerca de uma solicitação com latência de 50 ms.
Então eu tentei : talvez o problema esteja em um dos nós do caminho entre Elvin e o cliente. Mas o tracer também voltou de mãos vazias.
Assim, a causa da latência não era meu código, nem a implementação do gRPC, nem a rede. Comecei a me preocupar que nunca entenderia isso.
Agora, em qual sistema operacional estamos?
gRPC é amplamente utilizado no Linux, mas para Windows é exótico. Decidi realizar um experimento que funcionou: criei uma máquina virtual Linux, compilei o Elvin para Linux e o implantei.
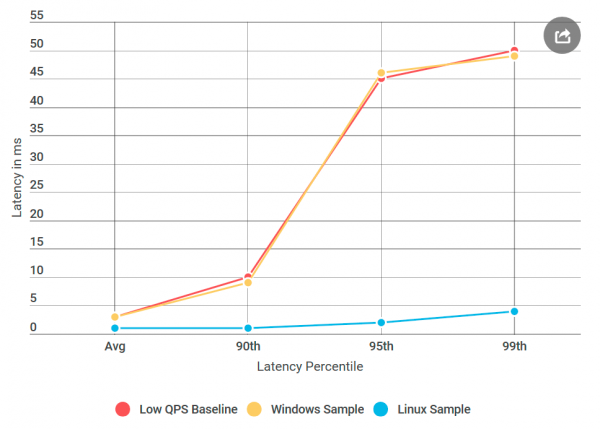
E eis o que aconteceu: no servidor ping-pong Linux não houve os mesmos atrasos que na instância correspondente do Windows, embora a fonte de dados não tenha mudado. A questão parece estar na implementação do gRPC para Windows.
O Algoritmo Nagle
Durante todo esse tempo eu pensei que me faltava uma bandeira. gRPCAgora eu entendi que, na verdade, faltava a gRPC bandeira do Windows. Encontrei uma biblioteca interna RPC na qual tinha certeza de que funcionava bem para todas as bandeiras instaladas . Depois adicionei todas essas bandeiras ao gRPC e implantei o Elvin no Windows, no servidor ping-pong corrigido para Windows!
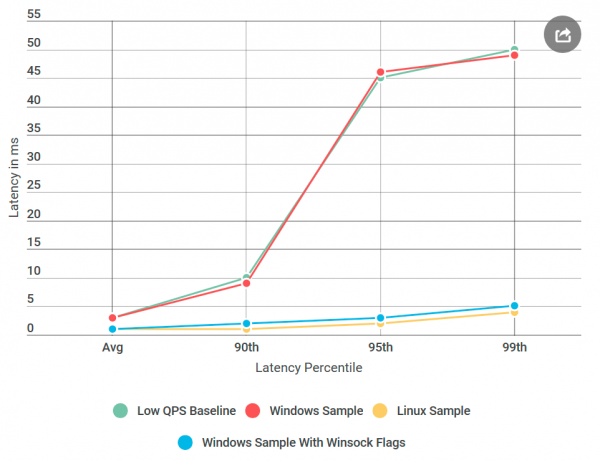
Quase pronto: comecei a remover as bandeiras adicionadas uma a uma, até que a regressão voltou, assim pude identificar sua causa com precisão. Era o infame , o interruptor do algoritmo Nagle.
tenta reduzir o número de pacotes enviados pela rede, retardando a transmissão das mensagens até que o tamanho do pacote exceda um certo número de bytes. Embora isso possa ser agradável para o usuário médio, é prejudicial para servidores em tempo real, pois o sistema operacional retardará algumas mensagens, causando atrasos em um baixo QPS. O gRPC tinha essa bandeira configurada na implementação do Linux para sockets TCP, mas não para Windows. Eu .
Conclusão
Um grande atraso em um baixo QPS foi causado pela otimização do sistema operacional. Ao olhar para trás, a profilagem não detectou o atraso, porque foi realizada no modo núcleo, e não no . Não sei se é possível observar o algoritmo Nagle através das capturas ETW, mas seria interessante.
Quanto ao experimento localhost, provavelmente não envolveu o código de rede real, e o algoritmo Nagle não foi acionado, então os problemas de atraso desapareceram quando o cliente acessou o Elvin através do localhost.
Da próxima vez que você notar um aumento no atraso ao diminuir o número de solicitações por segundo, o algoritmo Nagle deve estar em sua lista de suspeitos!
Fonte: habr.com
