

Olá, Habr!
Você gosta de voar de avião? Eu adoro, mas durante o isolamento social comecei a analisar dados sobre passagens aéreas de um conhecido recurso — Aviasales.
Hoje vamos explorar o funcionamento do Amazon Kinesis, construir um sistema de streaming com análise em tempo real, implantar o banco de dados NoSQL Amazon DynamoDB como o armazenamento de dados principal e configurar o alerta por SMS para passagens interessantes.
Todos os detalhes abaixo! Vamos lá!
Introdução
Para o exemplo, precisaremos de acesso ao . O acesso é gratuito e sem restrições, basta se registrar na seção 'Desenvolvedores' para obter seu token API para acessar os dados.
O principal objetivo deste artigo é fornecer uma compreensão geral sobre o uso da transmissão de informações na AWS, desconsiderando que os dados retornados pela API utilizada não são estritamente atuais e são transmitidos a partir de um cache, que é formado com base nas pesquisas dos usuários dos sites Aviasales.ru e Jetradar.com nas últimas 48 horas.
Os dados sobre passagens aéreas obtidos através da API serão automaticamente analisados pelo Kinesis-agent, instalado na máquina produtora, e enviados para o fluxo correto através do Kinesis Data Analytics. A versão não processada deste fluxo será escrita diretamente no armazenamento. O armazenamento de 'dados crus' implementado no DynamoDB permitirá uma análise mais profunda das passagens usando ferramentas de BI, como o AWS Quick Sight.
Vamos considerar duas opções para implantar toda a infraestrutura:
- Manual — através do AWS Management Console;
- Infraestrutura a partir de código Terraform — para automatizadores que preferem uma abordagem mais relaxada;
Arquitetura do sistema em desenvolvimento
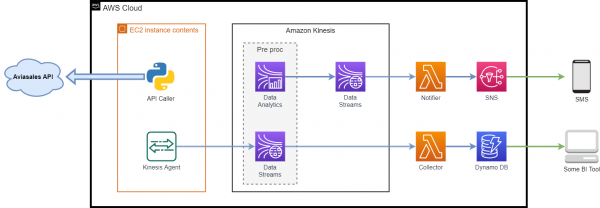
Componentes utilizados:
- — os dados retornados por esta API serão utilizados em todo o trabalho subsequente;
- — uma máquina virtual comum na nuvem, onde será gerado o fluxo de dados de entrada:
- — um aplicativo Java instalado localmente na máquina que fornece uma maneira simples de coletar e enviar dados para o Kinesis (Kinesis Data Streams ou Kinesis Firehose). O agente monitora constantemente um conjunto de arquivos nos diretórios especificados e envia novos dados para o Kinesis;
- — um script em Python que faz solicitações à API e armazena a resposta em uma pasta que o Kinesis Agent monitora;
- — um serviço de transmissão de dados em tempo real com amplas possibilidades de escalabilidade;
- — um serviço sem servidor que simplifica a análise de dados em fluxo em tempo real. O Amazon Kinesis Data Analytics configura recursos para o funcionamento de aplicativos e se escala automaticamente para processar quaisquer volumes de dados de entrada;
- — um serviço que permite executar código sem a necessidade de provisionar e configurar servidores. Todo o poder computacional é escalado automaticamente para cada chamada;
- — um banco de dados de pares "chave-valor" e documentos que garante uma latência inferior a 10 milissegundos, independentemente da escala. Com o DynamoDB, você não precisa provisionar nenhum servidor, aplicar patches ou gerenciá-los. O DynamoDB escala automaticamente as tabelas, ajustando o volume de recursos disponíveis e mantendo um alto desempenho. Nenhuma ação de administração do sistema é necessária;
- — um serviço de mensagens totalmente gerenciado no modelo "publicador-assinante" (Pub/Sub), que permite isolar microsserviços, sistemas distribuídos e aplicativos sem servidor. O SNS pode ser usado para enviar informações para usuários finais por meio de notificações push móveis, mensagens SMS e e-mails.
Preparação inicial
Para emular um fluxo de dados, decidi usar informações sobre passagens aéreas retornadas pela API Aviasales. Em uma lista bastante ampla de diferentes métodos, vamos pegar um deles — "Calendário de preços do mês", que retorna os preços para cada dia do mês, agrupados pelo número de conexões. Se você não enviar o mês da pesquisa na solicitação, a informação retornada será do mês seguinte ao atual.
Então, vamos nos registrar e obter nosso token.
Exemplo de solicitação abaixo:
http://api.travelpayouts.com/v2/prices/month-matrix?currency=rub&origin=LED&destination=HKT&show_to_affiliates=true&token=TOKEN_APIO método de obter dados da API mencionado acima com o token na solicitação funcionará, mas eu prefiro passar o token de acesso por meio do cabeçalho, então no script api_caller.py usaremos exatamente esse método.
Exemplo de resposta:
{{
   "success":true,
   "data":[{
      "show_to_affiliates":true,
      "trip_class":0,
      "origin":"LED",
      "destination":"HKT",
      "depart_date":"2015-10-01",
      "return_date":"",
      "number_of_changes":1,
      "value":29127,
      "found_at":"2015-09-24T00:06:12+04:00",
      "distance":8015,
      "actual":true
   }]
}
No exemplo da resposta da API acima, é mostrado um bilhete de São Petersburgo para Phuket... Ah, por que sonhar...
Como sou de Kazan e Phuket agora é algo que apenas sonhamos, vamos procurar passagens de São Petersburgo para Kazan.
Presume-se que você já tenha uma conta na AWS. Quero chamar a atenção especial para o fato de que o Kinesis e o envio de notificações via SMS não estão incluídos no anual . Mas mesmo assim, considerando alguns dólares, é totalmente viável montar o sistema proposto e brincar com ele. E, claro, não devemos esquecer de deletar todos os recursos depois que não forem mais necessários.
Felizmente, o DynamoDB e as funções Lambda serão relativamente gratuitos para nós se ficarmos dentro dos limites mensais gratuitos. Por exemplo, para o DynamoDB: 25 GB de armazenamento, 25 WCU/RCU e 100 milhões de solicitações. E um milhão de invocações de funções Lambda por mês.
Implantação manual do sistema
Configuração do Kinesis Data Streams
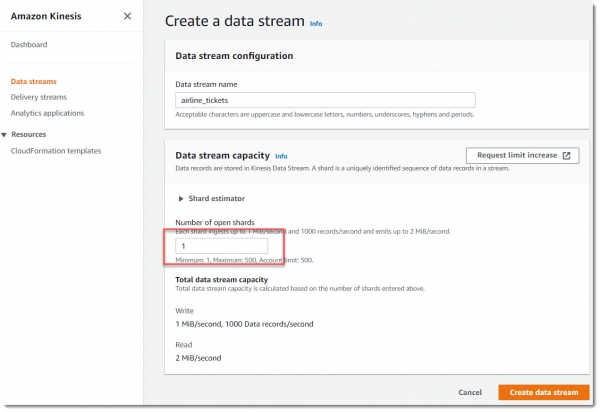
Vamos para o serviço Kinesis Data Streams e criamos dois novos fluxos com um shard cada.
O que é um shard?
Um shard é a unidade básica de transmissão de dados no fluxo Amazon Kinesis. Um shard fornece transmissão de dados de entrada a uma taxa de 1 MB/s e transmissão de dados de saída a uma taxa de 2 MB/s. Um shard suporta até 1000 registros PUT por segundo. Ao criar um fluxo de dados, é necessário especificar o número desejado de shards. Por exemplo, é possível criar um fluxo de dados com dois shards. Este fluxo de dados garantirá uma transmissão de dados de entrada a uma taxa de 2 MB/s e transmissão de dados de saída a uma taxa de 4 MB/s, suportando até 2000 registros PUT por segundo.
Quanto mais shards em seu fluxo, maior será sua capacidade de transferência. Basicamente, essa é a forma como os fluxos são escalonados — adicionando shards. Mas quanto mais shards você tiver, maior será o custo. Cada shard custa 1,5 centavos por hora e mais 1,4 centavos por cada milhão de operações de adição ao fluxo (unidades de carga PUT).
Vamos criar um novo fluxo chamado airline_tickets, será suficiente ter 1 shard:
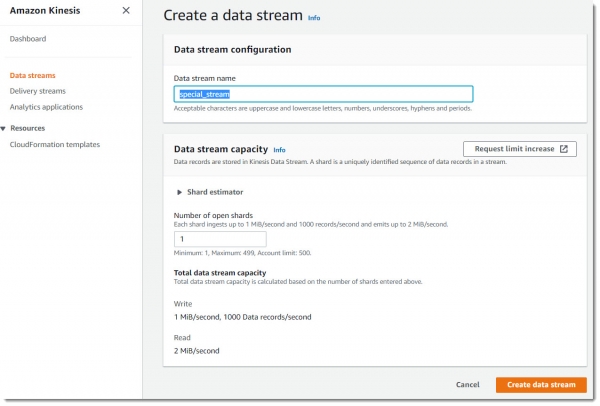
Agora vamos criar mais um fluxo chamado special_stream:
Configuração do produtor
Como produtor de dados para a tarefa, é suficiente usar uma instância EC2 comum. Não precisa ser uma máquina virtual cara e potente, um t2.micro spot serve bem.
Importante: para o exemplo, deve-se usar a imagem — Amazon Linux AMI 2018.03.0, que requer menos configurações para uma rápida inicialização do Kinesis Agent.
Acesse o serviço EC2, crie uma nova máquina virtual e escolha a AMI desejada com o tipo t2.micro, que está incluído no Free Tier:
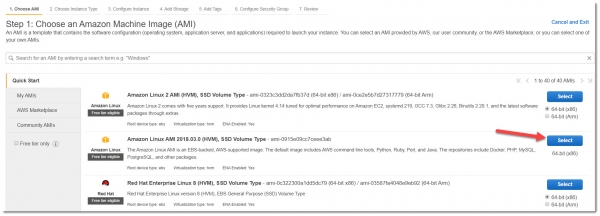
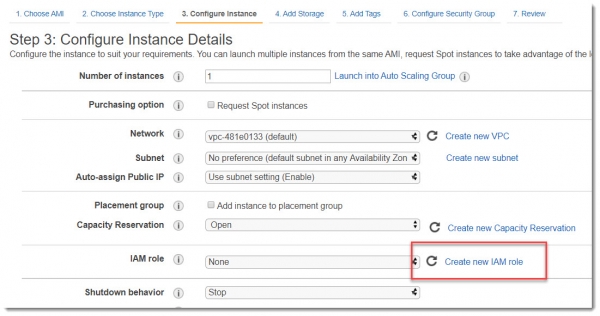
Para que a nova máquina virtual consiga interagir com o serviço Kinesis, é necessário conceder a ela as permissões adequadas. A melhor maneira de fazer isso é atribuir uma IAM Role. Portanto, na tela Step 3: Configure Instance Details, selecione Criar nova IAM Role:
Criação da IAM Role para EC2
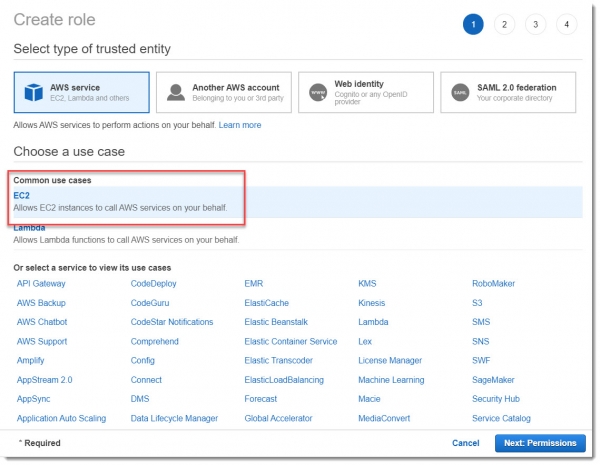
Na janela que se abre, escolha que está criando uma nova role para EC2 e vá para a seção Permissions:
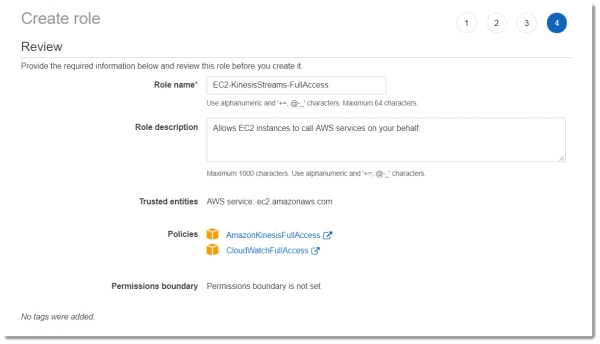
No exemplo de aprendizado, não é necessário se aprofundar em todos os detalhes da configuração granular de permissões nos recursos, então vamos escolher as políticas pré-configuradas pela Amazon: AmazonKinesisFullAccess e CloudWatchFullAccess.
Dê um nome significativo para essa role, por exemplo: EC2-KinesisStreams-FullAccess. O resultado deve ser o mesmo que está indicado na imagem abaixo:
Após criar essa nova role, não se esqueça de anexá-la à instância da máquina virtual que está sendo criada:
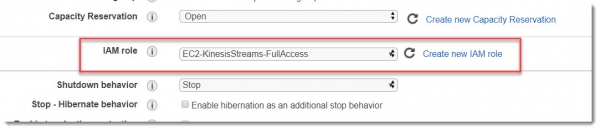
Não mudamos mais nada nesta tela e seguimos para as próximas janelas.
Os parâmetros do disco rígido podem ser mantidos como padrão, e as tags também (embora seja uma boa prática usar tags, pelo menos dando um nome à instância e indicando o ambiente).
Agora estamos na aba Step 6: Configure Security Group, onde é necessário criar um novo grupo de segurança ou identificar um já existente que permita a conexão via SSH (porta 22) na instância. Selecione Source -> My IP e você pode iniciar a instância.
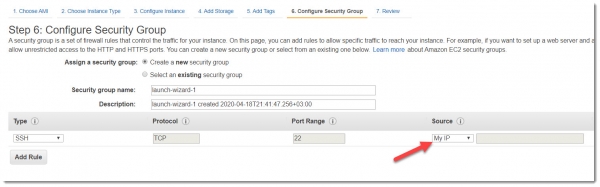
Assim que ela mudar para o status running, você pode tentar se conectar a ela via SSH.
Para obter a possibilidade de trabalhar com o Kinesis Agent, após a conexão bem-sucedida com a máquina, insira os seguintes comandos no terminal:
sudo yum -y update
sudo yum install -y python36 python36-pip
sudo /usr/bin/pip-3.6 install --upgrade pip
sudo yum install -y aws-kinesis-agent
Criaremos uma pasta para armazenar as respostas da API:
sudo mkdir /var/log/airline_ticketsAntes de iniciar o agente, é necessário configurar seu arquivo de configuração:
sudo vim /etc/aws-kinesis/agent.jsonO conteúdo do arquivo agent.json deve ter o seguinte formato:
{
  "cloudwatch.emitMetrics": true,
  "kinesis.endpoint": "",
  "firehose.endpoint": "",

  "flows": [
    {
      "filePattern": "/var/log/airline_tickets/*log",
      "kinesisStream": "airline_tickets",
      "partitionKeyOption": "RANDOM",
      "dataProcessingOptions": [
         {
            "optionName": "CSVTOJSON",
            "customFieldNames": ["cost","trip_class","show_to_affiliates",
                "return_date","origin","number_of_changes","gate","found_at",
                "duration","distance","destination","depart_date","actual","record_id"]
         }
      ]
    }
  ]
}
Como pode ser visto no arquivo de configuração, o agente irá monitorar o diretório /var/log/airline_tickets/ por arquivos com a extensão .log, analisá-los e transmiti-los para o fluxo airline_tickets.
Reiniciamos o serviço e verificamos se ele iniciou e está funcionando:
sudo service aws-kinesis-agent restartAgora vamos baixar o script Python que fará solicitações de dados à API:
REPO_PATH=https://raw.githubusercontent.com/igorgorbenko/aviasales_kinesis/master/producer

wget $REPO_PATH/api_caller.py -P /home/ec2-user/
wget $REPO_PATH/requirements.txt -P /home/ec2-user/
sudo chmod a+x /home/ec2-user/api_caller.py
sudo /usr/local/bin/pip3 install -r /home/ec2-user/requirements.txt
O script api_caller.py solicita dados da Aviasales e salva a resposta obtida no diretório que é escaneado pelo agente Kinesis. A implementação deste script é bastante padrão, existe a classe TicketsApi, que permite acessar a API de forma assíncrona. Passamos para essa classe o cabeçalho com o token e os parâmetros da solicitação:
class TicketsApi:
    """Classe responsável por chamadas à API."""

    def __init__(self, headers):
        """Método de inicialização."""
        self.base_url = BASE_URL
        self.headers = headers

    async def get_data(self, data):
        """Obtém os dados da solicitação à API."""
        response_json = {}
        async with ClientSession(headers=self.headers) as session:
            try:
                response = await session.get(self.base_url, data=data)
                response.raise_for_status()
                LOGGER.info('Status da resposta %s: %s',
                            self.base_url, response.status)
                response_json = await response.json()
            except HTTPError as http_err:
                LOGGER.error('Oops! Ocorreu um erro HTTP: %s', str(http_err))
            except Exception as err:
                LOGGER.error('Oops! Ocorreu um erro: %s', str(err))
            return response_json


def prepare_request(api_token):
    """Retorna os cabeçalhos e a consulta para a solicitação à API."""
    headers = {'X-Access-Token': api_token,
               'Accept-Encoding': 'gzip'}

    data = FormData()
    data.add_field('currency', CURRENCY)
    data.add_field('origin', ORIGIN)
    data.add_field('destination', DESTINATION)
    data.add_field('show_to_affiliates', SHOW_TO_AFFILIATES)
    data.add_field('trip_duration', TRIP_DURATION)
    return headers, data


async def main():
    """Executa o código."""
    if len(sys.argv) != 2:
        print('Uso: api_caller.py ')
        sys.exit(1)
        return
    api_token = sys.argv[1]
    headers, data = prepare_request(api_token)

    api = TicketsApi(headers)
    response = await api.get_data(data)
    if response.get('success', None):
        LOGGER.info('A API retornou %s itens', len(response['data']))
        try:
            count_rows = log_maker(response)
            LOGGER.info('%s linhas foram salvas em %s',
                        count_rows,
                        TARGET_FILE)
        except Exception as e:
            LOGGER.error('Oops! O resultado da solicitação não foi salvo no arquivo. %s',
                         str(e))
    else:
        LOGGER.error('Oops! A solicitação à API foi malsucedida %s!', response)
Para testar a correção das configurações e a funcionalidade do agente, faremos uma execução de teste do script api_caller.py:
sudo ./api_caller.py TOKEN 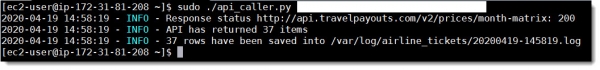
E vemos o resultado do trabalho nos logs do Agente e na aba de Monitoramento no fluxo de dados airline_tickets:
tail -f /var/log/aws-kinesis-agent/aws-kinesis-agent.log 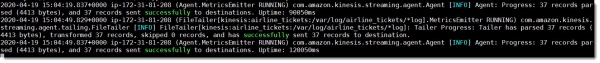
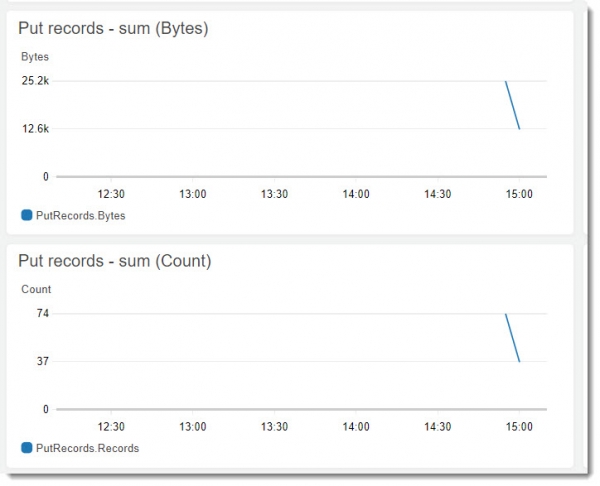
Como podemos ver, tudo está funcionando e o Kinesis Agent está enviando dados para o stream com sucesso. Agora vamos configurar o consumer.
Configuração do Kinesis Data Analytics
Vamos para o componente central de todo o sistema — criaremos um novo aplicativo no Kinesis Data Analytics chamado kinesis_analytics_airlines_app:
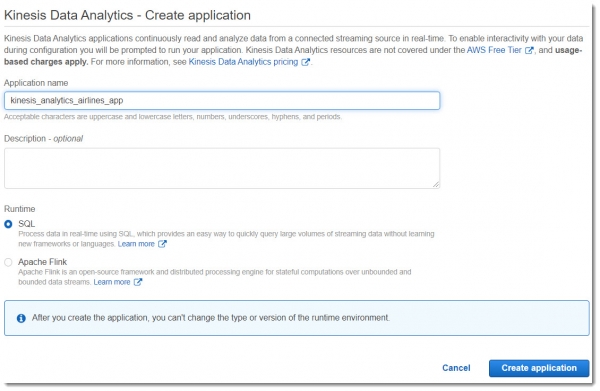
O Kinesis Data Analytics permite executar análises de dados em tempo real de Kinesis Streams usando a linguagem SQL. Este é um serviço totalmente escalável (diferente do Kinesis Streams) que:
- permite criar novos streams (Output Stream) com base em consultas aos dados de origem;
- fornece um stream de erros que ocorreram durante a execução dos aplicativos (Error Stream);
- é capaz de detectar automaticamente o esquema dos dados de entrada (que pode ser redefinido manualmente, se necessário).
Este não é um serviço barato — 0,11 USD por hora de operação, por isso deve ser usado com cuidado e excluído ao finalizar o trabalho.
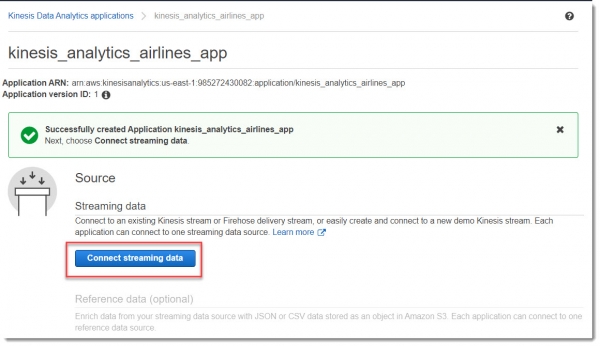
Vamos conectar o aplicativo à fonte de dados:
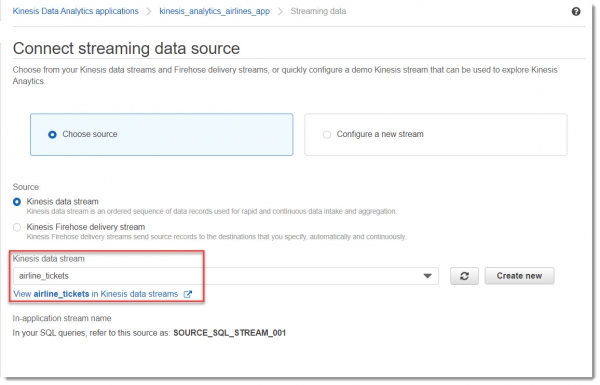
Selecionamos o stream ao qual queremos nos conectar (airline_tickets):
Em seguida, precisamos anexar um novo IAM Role para que o aplicativo possa ler e escrever no stream. Para isso, não precisamos alterar nada no bloco Access permissions:
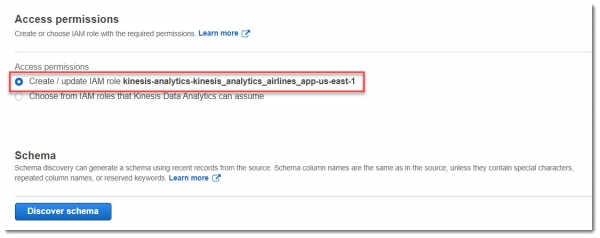
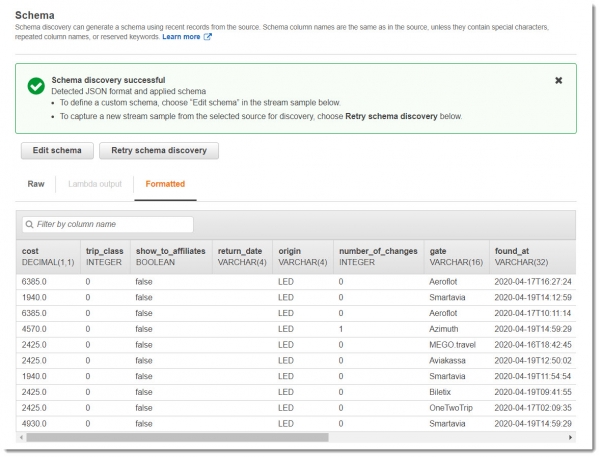
Agora vamos solicitar a detecção do esquema dos dados no stream, para isso, pressionamos o botão 'Discover schema'. Como resultado, um novo IAM role será atualizado (criado) e a detecção do esquema será iniciada a partir dos dados que já chegaram ao stream:
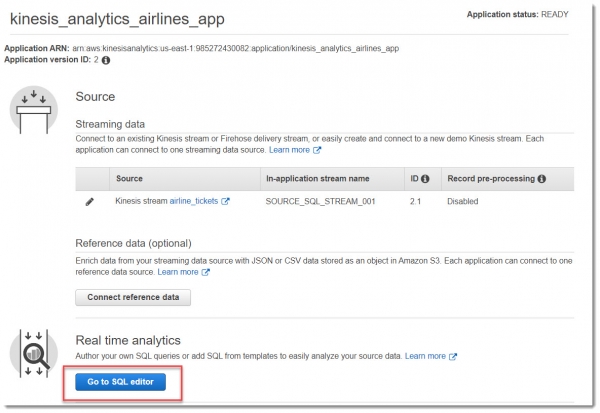
Agora precisamos ir para o editor SQL. Ao pressionar este botão, uma janela aparecerá perguntando sobre o início do aplicativo — escolhemos o que queremos iniciar:
No editor SQL, colamos esta consulta simples e pressionamos Save and Run SQL:
CREATE OR REPLACE STREAM "DESTINATION_SQL_STREAM" ("cost" DOUBLE, "gate" VARCHAR(16));

CREATE OR REPLACE PUMP "STREAM_PUMP" AS INSERT INTO "DESTINATION_SQL_STREAM"
SELECT STREAM "cost", "gate"
FROM "SOURCE_SQL_STREAM_001"
WHERE "cost" < 5000
    and "gate" = 'Aeroflot';
Em bancos de dados relacionais, você trabalha com tabelas, usando os operadores INSERT para adicionar registros e o operador SELECT para consultar dados. No Amazon Kinesis Data Analytics, você trabalha com streams (STREAM) e 'bombas' (PUMP) — consultas contínuas de inserção que inserem dados de um stream em um aplicativo em outro stream.
Na consulta SQL apresentada acima, a busca é por passagens da Aeroflot com um custo abaixo de cinco mil rublos. Todos os registros que atenderem a essas condições serão colocados no stream DESTINATION_SQL_STREAM.
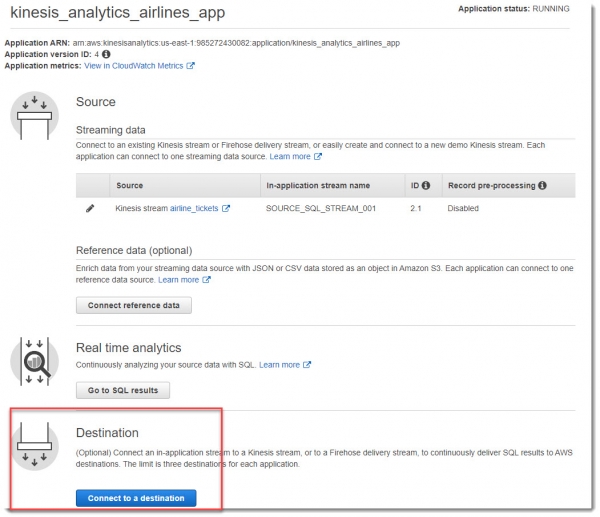
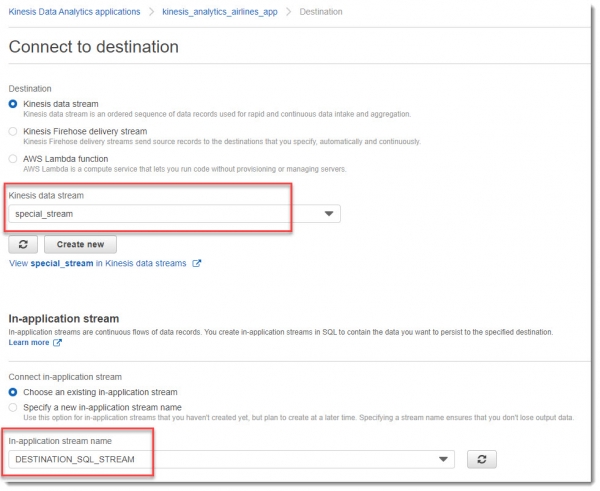
No bloco Destination, escolhemos o fluxo special_stream, e na lista suspensa In-application stream name, colocamos DESTINATION_SQL_STREAM:
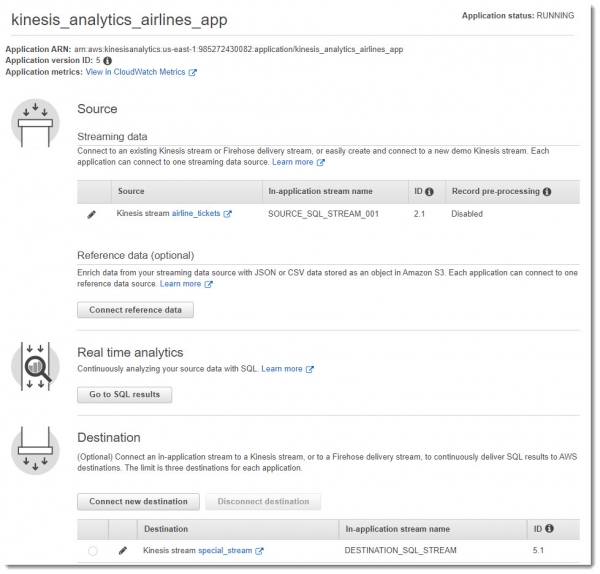
Como resultado de todas as manobras, deve-se obter algo semelhante à imagem abaixo:
Criação e assinatura do tópico SNS
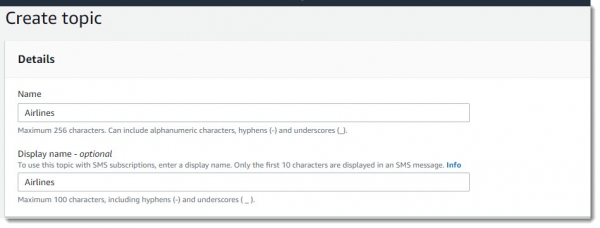
Acesse o serviço Simple Notification Service e crie um novo tópico com o nome Airlines:
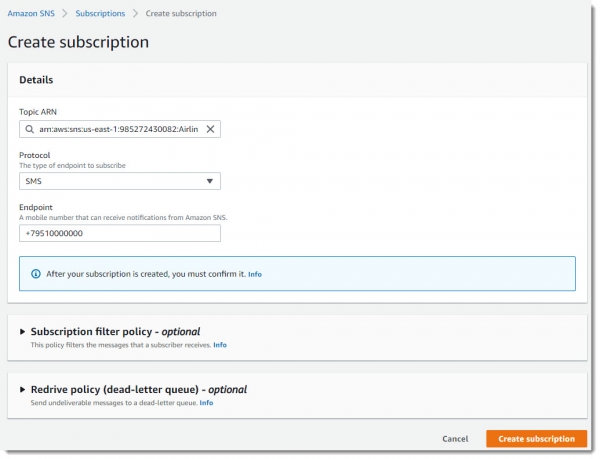
Fazemos a assinatura para este tópico, indicando o número de telefone móvel para o qual as notificações SMS serão enviadas:
Criação da tabela no DynamoDB
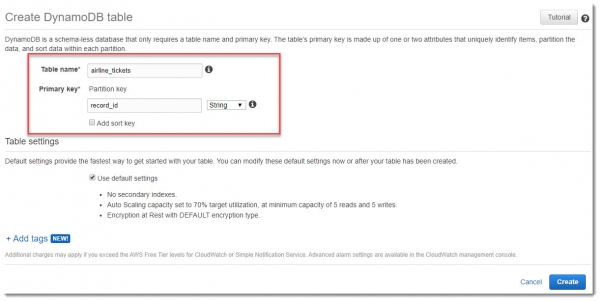
Para armazenar os dados brutos do fluxo airline_tickets, criaremos uma tabela no DynamoDB com o mesmo nome. Usaremos record_id como chave primária:
Criação da função lambda collector
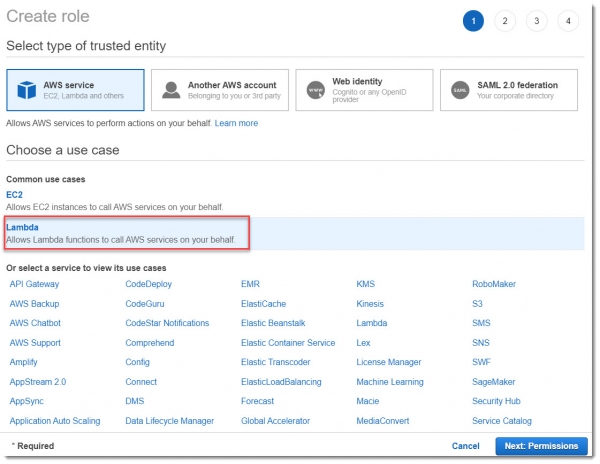
Vamos criar uma função lambda chamada Collector, cuja tarefa será consultar o fluxo airline_tickets e, caso novas entradas sejam encontradas, inserir essas entradas na tabela DynamoDB. É evidente que, além dos direitos padrão, essa lambda deve ter acesso de leitura ao fluxo de dados Kinesis e de gravação no DynamoDB.
Criação de uma função IAM para a função lambda collector
Para começar, vamos criar um novo papel IAM para a lambda chamado Lambda-TicketsProcessingRole:
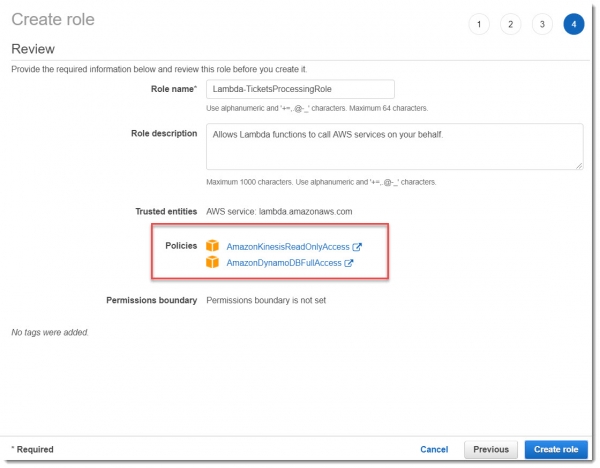
Para este exemplo de teste, as políticas pré-configuradas AmazonKinesisReadOnlyAccess e AmazonDynamoDBFullAccess servem, como mostrado na imagem abaixo:
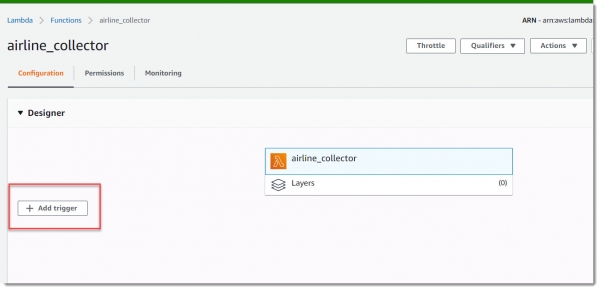
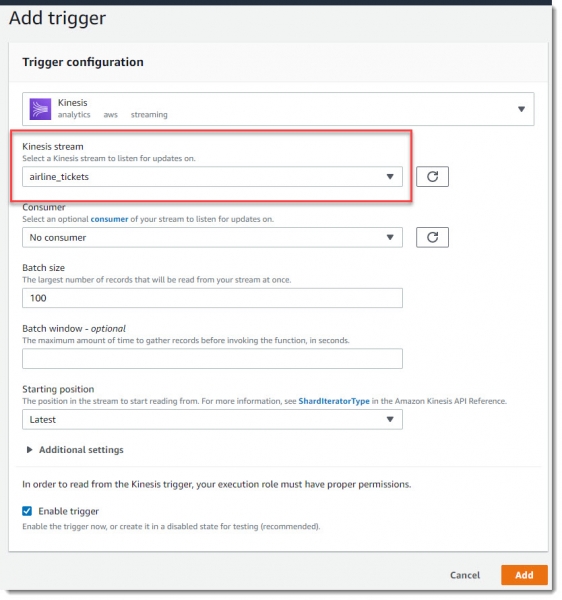
Essa lambda deve ser acionada por um gatilho do Kinesis quando novas entradas chegarem ao fluxo airline_stream, então precisamos adicionar um novo gatilho:
Resta inserir o código e salvar a lambda.
"""Analisando o fluxo e inserindo na tabela do DynamoDB."""
import base64
import json
import boto3
from decimal import Decimal

DYNAMO_DB = boto3.resource('dynamodb')
TABLE_NAME = 'airline_tickets'

class TicketsParser:
    """Analisando informações do fluxo."""

    def __init__(self, table_name, records):
        """Método de inicialização."""
        self.table = DYNAMO_DB.Table(table_name)
        self.json_data = TicketsParser.get_json_data(records)

    @staticmethod
    def get_json_data(records):
        """Retorna dados desserializados do fluxo."""
        decoded_record_data = ([base64.b64decode(record['kinesis']['data'])
                                for record in records])
        json_data = ([json.loads(decoded_record)
                      for decoded_record in decoded_record_data])
        return json_data

    @staticmethod
    def get_item_from_json(json_item):
        """Pré-processa os dados json."""
        new_item = {
            'record_id': json_item.get('record_id'),
            'cost': Decimal(json_item.get('cost')),
            'trip_class': json_item.get('trip_class'),
            'show_to_affiliates': json_item.get('show_to_affiliates'),
            'origin': json_item.get('origin'),
            'number_of_changes': int(json_item.get('number_of_changes')),
            'gate': json_item.get('gate'),
            'found_at': json_item.get('found_at'),
            'duration': int(json_item.get('duration')),
            'distance': int(json_item.get('distance')),
            'destination': json_item.get('destination'),
            'depart_date': json_item.get('depart_date'),
            'actual': json_item.get('actual')
        }
        return new_item

    def run(self):
        """Inserção em lote na tabela."""
        with self.table.batch_writer() as batch_writer:
            for item in self.json_data:
                dynamodb_item = TicketsParser.get_item_from_json(item)
                batch_writer.put_item(dynamodb_item)

        print('Adicionados ', len(self.json_data), 'itens')

def lambda_handler(event, context):
    """Analisa o fluxo e insere na tabela do DynamoDB."""
    print('Recebeu evento:', event)
    parser = TicketsParser(TABLE_NAME, event['Records'])
    parser.run()
Criação da função lambda notifier
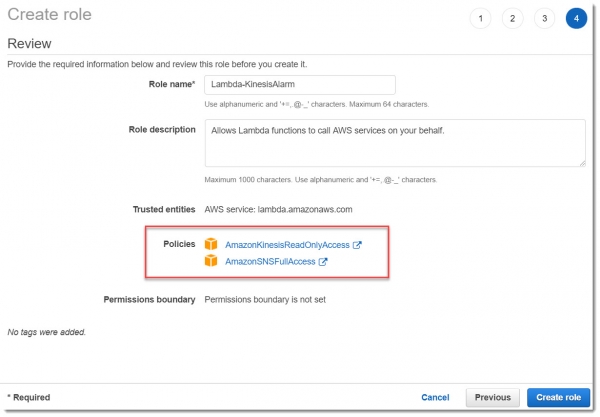
A segunda função lambda, que monitorará o segundo fluxo (special_stream) e enviará uma notificação ao SNS, é criada de maneira semelhante. Portanto, esta lambda deve ter acesso de leitura do Kinesis e enviar mensagens para o tópico SNS designado, que será enviado pelo serviço SNS a todos os assinantes desse tópico (email, SMS, etc.).
Criação de função IAM
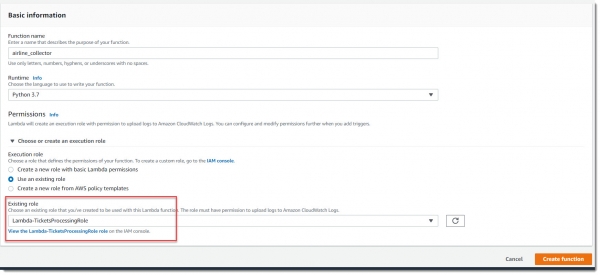
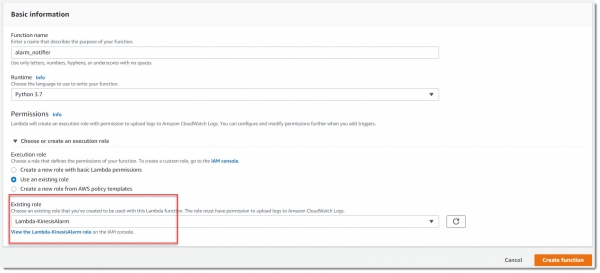
Primeiro, criamos a função IAM Lambda-KinesisAlarm para esta lambda e depois atribuímos essa função à lambda alarm_notifier que está sendo criada:
Esta lambda deve funcionar com um gatilho para a chegada de novos registros no fluxo special_stream, portanto, é necessário configurar o gatilho de forma semelhante ao que fizemos para a lambda Collector.
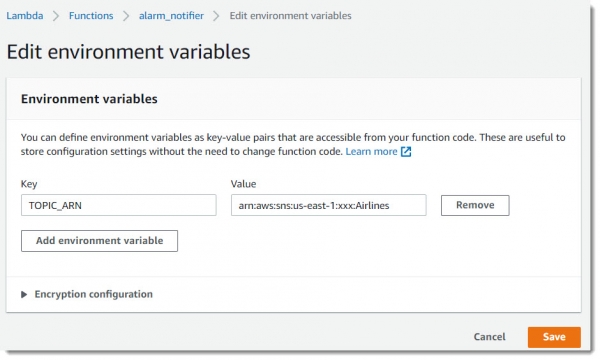
Para facilitar a configuração desta lambda, introduziremos uma nova variável de ambiente — TOPIC_ARN, onde colocamos o ANR (Amazon Resource Names) do tópico Airlines:
E inserimos o código da lambda, que não é muito complexo:
import boto3
import base64
import os

SNS_CLIENT = boto3.client('sns')
TOPIC_ARN = os.environ['TOPIC_ARN']


def lambda_handler(event, context):
    try:
        SNS_CLIENT.publish(TopicArn=TOPIC_ARN,
                           Message='Olá! Eu encontrei algo interessante!',
                           Subject='Alerta de passagens aéreas')
        print('Mensagem de alerta foi entregue com sucesso')
    except Exception as err:
        print('Falha na entrega', str(err))
Parece que a configuração manual do sistema foi concluída. Agora resta apenas testar e garantir que tudo foi configurado corretamente.
Implantação a partir do código Terraform
Preparação necessária
— uma ferramenta open-source muito conveniente para o deployment de infraestrutura a partir de código. Possui sua própria sintaxe, que é fácil de aprender, e uma variedade de exemplos sobre como e o que implantar. O editor Atom ou Visual Studio Code tem muitos plugins úteis que facilitam o trabalho com Terraform.
O distribuidor pode ser baixado . Uma análise detalhada de todas as capacidades do Terraform ultrapassa o escopo deste artigo, portanto, nos limitaremos aos principais pontos.
Como iniciar
O código completo do projeto está localizado . Clone o repositório para o seu ambiente. Antes de iniciar, é necessário garantir que você tenha o AWS CLI instalado e configurado, pois o Terraform buscará credenciais no arquivo ~/.aws/credentials.
Uma boa prática antes de implantar toda a infraestrutura é executar o comando plan, para ver o que o Terraform irá criar na nuvem:
terraform.exe planSerá solicitado que você insira o número do telefone para receber notificações. Neste estágio, a entrada não é obrigatória.
Após analisar o plano de trabalho do programa, podemos iniciar a criação dos recursos:
terraform.exe applyDepois de enviar este comando, novamente aparecerá um convite para inserir o número do telefone; digite 'yes' quando a pergunta sobre a execução real das ações for exibida. Isso permitirá levantar toda a infraestrutura, realizar toda a configuração necessária do EC2, implantar funções Lambda, etc.
Depois que todos os recursos forem criados com sucesso através do código Terraform, você precisará acessar os detalhes do aplicativo Kinesis Analytics (infelizmente, não consegui descobrir como fazer isso diretamente pelo código).
Iniciando o aplicativo:
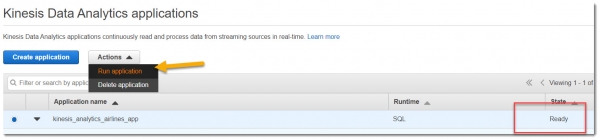
Depois disso, é necessário definir explicitamente o nome do fluxo em aplicação, escolhendo a partir da lista suspensa:
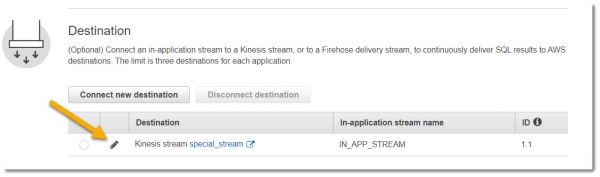
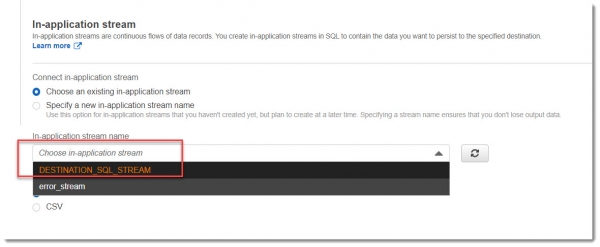
Agora tudo está pronto para funcionar.
Testando a operação do aplicativo
Independentemente de como você implantou o sistema, manualmente ou através do código Terraform, ele funcionará da mesma forma.
Acessamos via SSH à máquina virtual EC2, onde o Kinesis Agent está instalado, e executamos o script api_caller.py
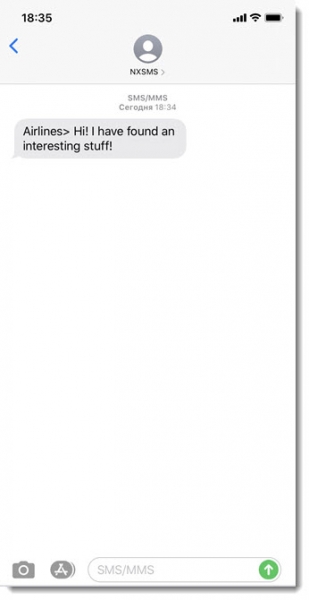
sudo ./api_caller.py TOKENBasta aguardar o SMS no seu número:
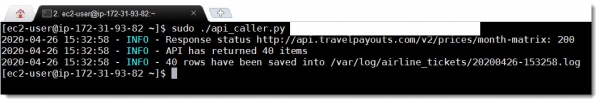
O SMS — a mensagem chega ao celular praticamente em 1 minuto:
Agora precisamos verificar se as gravações foram salvas no banco de dados DynamoDB para uma análise mais detalhada. A tabela airline_tickets contém aproximadamente esses dados:
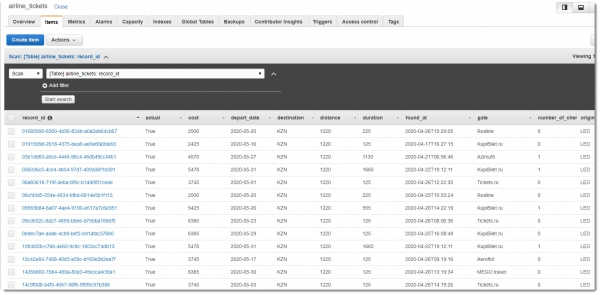
Conclusão
No decorrer do trabalho, foi construída uma sistema de processamento de dados online com base no Amazon Kinesis. Foram considerados os usos do Kinesis Agent em conjunto com o Kinesis Data Streams e a análise em tempo real do Kinesis Analytics usando comandos SQL, assim como a interação do Amazon Kinesis com outros serviços da AWS.
O sistema descrito acima foi implementado de duas maneiras: uma manual, que é mais demorada, e outra rápida por meio de código Terraform.
Todo o código-fonte do projeto está disponível , recomendo que o confira.
Estou à disposição para discutir o artigo e aguardo seus comentários. Espero uma crítica construtiva.
Desejo sucesso!
Fonte: habr.com
