

— é um sistema de gerenciamento de banco de dados em colunas para processamento analítico online (OLAP) de código aberto, criado pela Yandex. É utilizado pela Yandex, CloudFlare, VK.com, Badoo e outros serviços em todo o mundo para armazenar realmente grandes volumes de dados (inserindo milhares de linhas por segundo ou petabytes de dados armazenados em disco).
Em um banco de dados convencional, ou “baseado em linhas”, cujos exemplos incluem MySQL, Postgres, MS SQL Server, os dados são armazenados na seguinte ordem:
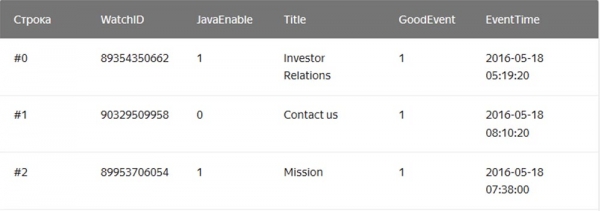
Os valores que pertencem a uma mesma linha são armazenados fisicamente próximos. Nos bancos de dados em colunas, os valores de diferentes colunas são armazenados separadamente, e os dados de uma única coluna ficam juntos:
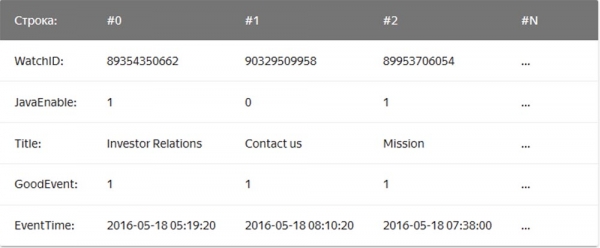
Exemplos de bancos de dados em colunas incluem Vertica, Paraccel (Actian Matrix, Amazon Redshift), Sybase IQ, Exasol, Infobright, InfiniDB, MonetDB (VectorWise, Actian Vector), LucidDB, SAP HANA, Google Dremel, Google PowerDrill, Druid, kdb+.
Empresa – encaminhador de e-mails começou a usar o Clickhouse em 2018 para criar relatórios e ficou muito impressionada com sua simplicidade, escalabilidade, suporte a SQL e velocidade. A rapidez de operação deste banco de dados era quase mágica.
Facilidade
O Clickhouse é instalado no Ubuntu com um único comando. Se você conhece SQL, pode imediatamente começar a usar o Clickhouse para suas necessidades. No entanto, isso não significa que você pode executar «show create table» no MySQL e copiar e colar SQL no Clickhouse.
Em comparação com o MySQL, existem diferenças importantes nos tipos de dados nas definições de esquemas de tabelas, por isso, para operar confortavelmente, você ainda precisará de um tempo para modificar as definições de esquema de tabelas e estudar os mecanismos de tabela.
O Clickhouse funciona muito bem sem qualquer software adicional, mas se você quiser usar replicação, precisará instalar o ZooKeeper. A análise do desempenho das consultas mostra resultados excelentes — as tabelas do sistema contêm todas as informações, e todos os dados podem ser obtidos com o velho e enfadonho SQL.
Desempenho
- de comparação do Clickhouse com Vertica e MySQL em um servidor com a seguinte configuração: dois soquetes Intel® Xeon® CPU E5-2650 v2 @ 2.60GHz; 128 GiB RAM; md RAID-5 em 8 HDD SATA de 6TB, ext4.
- de comparação do Clickhouse com o armazenamento de dados em nuvem Amazon RedShift.
- Trechos do blog :
O banco de dados ClickHouse possui um design muito simples — todos os nós do cluster têm a mesma funcionalidade e utilizam apenas o ZooKeeper para coordenação. Construímos um pequeno cluster composto por vários nós e realizamos testes, durante os quais descobrimos que o sistema apresenta um desempenho bastante impressionante, que corresponde aos benefícios alegados em benchmarks de bancos de dados analíticos. Decidimos analisar mais detalhadamente o conceito que está por trás do ClickHouse. O primeiro obstáculo para a pesquisa foi a falta de ferramentas e a escassez da comunidade ClickHouse, então nos aprofundamos no design deste banco de dados para entender como ele funciona.
O ClickHouse não suporta a recepção de dados diretamente do Kafka, já que é apenas um banco de dados, portanto, escrevemos nosso próprio serviço de adaptadores na linguagem Go. Ele lia mensagens codificadas em Cap’n Proto do Kafka, as transformava em TSV e as inseria no ClickHouse em pacotes através da interface HTTP. Mais tarde, reescrevemos esse serviço para usar a biblioteca Go junto com nossa própria interface ClickHouse para melhorar o desempenho. Ao avaliar o desempenho da recepção de pacotes, descobrimos algo importante — o desempenho do ClickHouse depende fortemente do tamanho do pacote, ou seja, da quantidade de linhas inseridas simultaneamente. Para entender por que isso acontece, estudamos como o ClickHouse armazena dados.
O principal mecanismo, ou melhor, a família de mecanismos para tabelas utilizada no ClickHouse para armazenamento de dados é o MergeTree. Este mecanismo é conceitualmente semelhante ao algoritmo LSM utilizado no Google BigTable ou no Apache Cassandra, mas evita a construção de uma tabela intermediária em memória e grava os dados diretamente no disco. Isso proporciona uma excelente capacidade de gravação, uma vez que cada pacote inserido é classificado apenas pela ‘chave primária’ primary key, compactado e gravado no disco para formar um segmento.
A ausência de tabelas de memória ou de qualquer conceito de “frescura” dos dados também significa que os dados só podem ser adicionados; a modificação ou exclusão não é suportada pelo sistema. Atualmente, a única maneira de remover dados é por meses do calendário, uma vez que os segmentos nunca cruzam o final do mês. A equipe do ClickHouse está trabalhando ativamente para tornar essa função personalizável. Por outro lado, isso torna a gravação e a fusão de segmentos sem conflitos, portanto, a largura de banda de recepção escala linearmente com o número de inserções paralelas até que ocorra a saturação de I/O ou de núcleos.
No entanto, essa circunstância também significa que o sistema não é adequado para pequenos pacotes, portanto, serviços Kafka e insertores são utilizados para o buffer. Além disso, o ClickHouse continua a realizar constantemente a fusão de segmentos em segundo plano, de modo que muitas pequenas partes de informações serão combinadas e gravadas um número maior de vezes, aumentando assim a intensidade da gravação. Nesse processo, um número excessivo de partes não relacionadas causará um throttle agressivo das inserções até que a fusão prossiga. Descobrimos que o melhor compromisso entre a recepção de dados em tempo real e o desempenho da recepção é aceitar uma quantidade limitada de inserções por segundo para a tabela.
A chave para o desempenho de leitura de tabelas é a indexação e a localização dos dados no disco. Não importa quão rápida seja a manipulação; quando o mecanismo precisa escanear terabytes de dados do disco e utiliza apenas uma parte deles, isso levará tempo. O ClickHouse é um armazenamento em coluna, portanto, cada segmento contém um arquivo para cada coluna com valores classificados para cada linha. Assim, colunas inteiras que não estão na consulta podem ser puladas inicialmente, e várias células podem ser processadas em paralelo com execução vetorizada. Para evitar a varredura completa, cada segmento possui um pequeno arquivo de índice.
Dado que todas as colunas estão ordenadas por 'chave primária', o arquivo de índice contém apenas rótulos (linhas capturadas) de cada N-ésima linha, para poder armazená-las na memória mesmo para tabelas muito grandes. Por exemplo, é possível configurar o padrão para 'marcar cada 8192ª linha', então a indexação 'esparsa' de uma tabela com 1 trilhão de linhas, que facilmente cabe na memória, ocupará apenas 122.070 caracteres.
Desenvolvimento do sistema
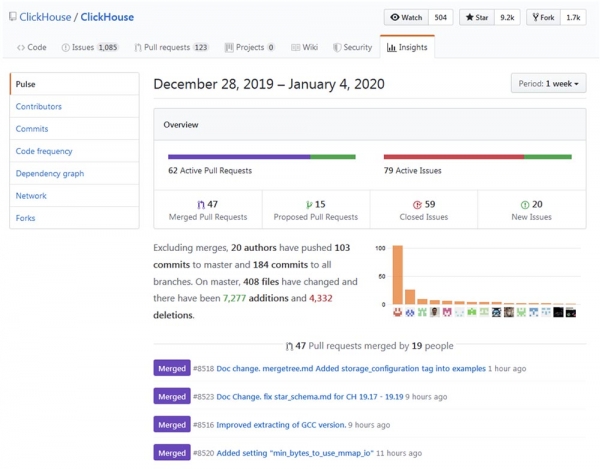
O desenvolvimento e a melhoria do ClickHouse podem ser acompanhados em e verificar que o processo de 'amadurecimento' está ocorrendo a um ritmo impressionante.
Popularidade
Parece que a popularidade do ClickHouse está crescendo exponencialmente, especialmente na comunidade de língua russa. A conferência High Load 2018 (Moscovo, 8-9 de novembro de 2018) mostrou que monstros como vk.com e Badoo usam o ClickHouse, com o qual inserem dados (por exemplo, logs) de dezenas de milhares de servidores ao mesmo tempo. No vídeo de 40 minutos, . Em breve, publicaremos a transcrição no Habr para facilitar o trabalho com o material.
Áreas de aplicação
Após dedicar algum tempo à pesquisa, acredito que existem áreas em que o ClickHouse pode ser útil ou capaz de substituir completamente outras soluções mais tradicionais e populares, como MySQL, PostgreSQL, ELK, Google Big Query, Amazon RedShift, TimescaleDB, Hadoop, MapReduce, Pinot e Druid. A seguir, detalhes sobre o uso do ClickHouse para modernizar ou substituir completamente os SGBDs mencionados.
Aprimorando MySQL e PostgreSQL
Recentemente, substituímos parcialmente o MySQL pelo ClickHouse para a plataforma de boletins informativos . O problema era que o MySQL, devido a um design mal planejado, registrava cada e-mail enviado e cada link nesse e-mail com um hash base64, criando uma enorme tabela MySQL (email_stats). Após enviar apenas 10 milhões de e-mails para os assinantes do serviço, essa tabela ocupava 150 GB de espaço em disco, e o MySQL começava a 'lentar' em consultas simples. Para resolver o problema de espaço em disco, utilizamos com sucesso a compactação da tabela InnoDB, que a reduziu em 4 vezes. No entanto, ainda não faz sentido armazenar mais de 20-30 milhões de e-mails no MySQL apenas para ler o histórico, pois qualquer consulta simples que, por algum motivo, precise realizar uma varredura completa gera swapping e uma grande carga de I/O, resultando em alertas regulares do Zabbix.
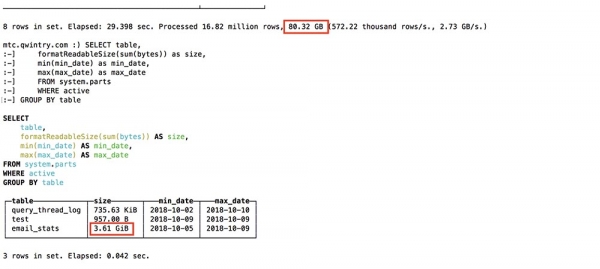
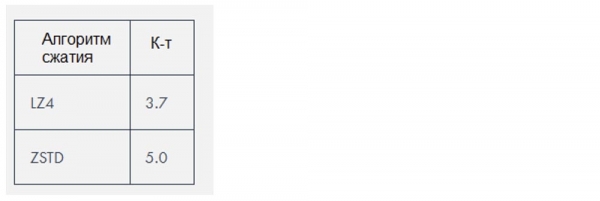
O Clickhouse utiliza dois algoritmos de compressão que reduzem o volume de dados em cerca de , mas neste caso específico, os dados eram particularmente 'compactáveis'.
Substituição do ELK
Com base na experiência pessoal, a pilha ELK (ElasticSearch, Logstash e Kibana, neste caso específico o ElasticSearch) requer muito mais recursos para operar do que o necessário para armazenar logs. O ElasticSearch é um ótimo mecanismo se você precisa de uma boa pesquisa de texto completo nos logs (e eu não acho que você realmente precise disso), mas fico intrigado sobre por que se tornou o mecanismo padrão de fato para registro. Seu desempenho de ingestão, em combinação com o Logstash, nos causava problemas mesmo com cargas relativamente pequenas e exigia cada vez mais memória e espaço em disco. Como banco de dados, o Clickhouse é melhor que o ElasticSearch pelos seguintes motivos:
- Suporte ao dialeto SQL;
- Melhor taxa de compressão dos dados armazenados;
- Suporte à busca por expressões regulares Regex em vez de busca por texto completo;
- Planejamento de consultas aprimorado e maior desempenho geral.
Atualmente, o maior problema ao comparar o ClickHouse com o ELK é a falta de soluções para descarregamento de logs, bem como a escassez de documentação e tutoriais sobre o assunto. Nesse caso, qualquer usuário pode configurar o ELK com o guia da Digital Ocean, o que é crucial para a rápida adoção de tecnologias como esta. Existe um motor de banco de dados aqui, mas ainda não há Filebeat para ClickHouse. Sim, ele está presente. e sistema para trabalhar com logs , existe uma ferramenta para inserir dados de arquivos de log no ClickHouse, mas tudo isso leva mais tempo. No entanto, o ClickHouse continua sendo o líder devido à sua simplicidade, portanto até novatos conseguem instalá-lo facilmente e começar a usar em plena funcionalidade em apenas 10 minutos.
Preferindo soluções minimalistas, tentei usar o FluentBit, uma ferramenta para coleta de logs com um consumo de memória muito baixo, junto com o ClickHouse, evitando o uso do Kafka. No entanto, é necessário resolver pequenas incompatibilidades, como , antes que isso possa ser feito sem uma camada proxy que converta os dados do FluentBit para o ClickHouse.
Como alternativa ao Kibana, é possível usar o ClickHouse como backend . Pelo que eu entendi, pode haver problemas de desempenho ao renderizar uma grande quantidade de itens de dados, especialmente com versões mais antigas do Grafana. Na Qwintry, ainda não tentamos isso, mas reclamações sobre isso ocasionalmente aparecem no canal de suporte do ClickHouse no Telegram.
Substituto do Google Big Query e Amazon RedShift (solução para grandes empresas)
A melhor maneira de usar o BigQuery é carregar 1 TB de dados JSON e executar consultas analíticas sobre eles. O Big Query é um excelente produto, cuja escalabilidade é difícil de superestimar. É um software muito mais complexo do que o ClickHouse, que opera em um cluster interno, mas do ponto de vista do cliente, tem muito em comum com o ClickHouse. O BigQuery pode rapidamente "encarecer" assim que você passar a pagar por cada SELECT, portanto, é uma verdadeira solução SaaS com todos os seus prós e contras.
O ClickHouse é a melhor escolha quando você executa muitas consultas que são caras em termos de computação. Quanto mais consultas SELECT você realiza a cada dia, mais faz sentido substituir o Big Query pelo ClickHouse, pois essa troca pode economizar milhares de dólares quando se trata de muitos terabytes de dados processados. Isso não se aplica a dados armazenados, cuja обработка no Big Query é bastante barata.
No artigo do cofundador da Altinity, Alexander Zaitsev fala sobre as vantagens dessa migração de SGBD.
Substituição do TimescaleDB
TimescaleDB é uma extensão do PostgreSQL que otimiza o trabalho com séries temporais em um banco de dados tradicional., ).
Embora o ClickHouse não seja um concorrente sério no nicho de séries temporais, sua estrutura em colunas e a execução vetorial de consultas o tornam, na maioria das vezes, muito mais rápido que o TimescaleDB para o processamento de consultas analíticas. Além disso, o desempenho da entrada de dados em lotes do ClickHouse é cerca de 3 vezes superior, e ele usa 20 vezes menos espaço em disco, o que é realmente importante para o manuseio de grandes volumes de dados históricos..
Ao contrário do ClickHouse, a única maneira de economizar um pouco de espaço em disco no TimescaleDB é usando ZFS ou sistemas de arquivos semelhantes.
As atualizações futuras do ClickHouse provavelmente introduzirão a compressão Delta, tornando-o ainda mais adequado para o processamento e armazenamento de dados de séries temporais. O TimescaleDB pode ser a melhor escolha em comparação ao ClickHouse 'nu' nas seguintes situações:
- instalações pequenas com muito pouca memória RAM (<3 GB);
- um grande número de pequenos INSERTs que você não deseja agrupar em grandes fragmentos;
- melhor consistência, uniformidade e requisitos ACID;
- suporte ao PostGIS;
- integração com tabelas PostgreSQL existentes, pois, essencialmente, o TimescaleDB é PostgreSQL.
Concorrência com sistemas Hadoop e MapReduce
O Hadoop e outros produtos MapReduce podem realizar muitos cálculos complexos, mas geralmente operam com enormes latências. O ClickHouse corrige esse problema, processando terabytes de dados e fornecendo resultados quase instantaneamente. Assim, o ClickHouse é muito mais eficiente para realizar investigações analíticas rápidas e interativas, o que deve interessar os especialistas em processamento de dados.
Concorrência com Pinot e Druid
Os concorrentes mais próximos do ClickHouse são produtos open source lineares escaláveis em colunas, Pinot e Druid. Um excelente trabalho comparativo entre esses sistemas foi publicado no artigo de 1º de fevereiro de 2018.
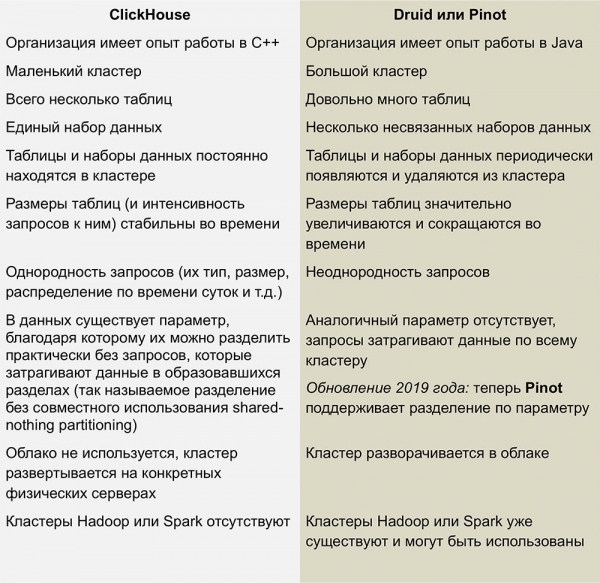
Este artigo precisa de atualização – afirma que o ClickHouse não suporta operações de UPDATE e DELETE, o que não é totalmente correto em relação às últimas versões.
Não temos experiência suficiente com esses SGBDs, mas não gosto nem um pouco da complexidade da infraestrutura necessária para rodar o Druid e o Pinot — é um monte de "partes móveis" cercadas por Java.
Druid e Pinot são projetos incubados da Apache, cujo progresso é amplamente documentado pela Apache nas páginas de seus projetos no GitHub. O Pinot surgiu na incubadora em outubro de 2018, enquanto o Druid nasceu 8 meses antes — em fevereiro.
A falta de informações sobre como o AFS funciona me levanta algumas perguntas, talvez até tolas. Fico curioso se os autores do Pinot notaram que a Apache Foundation é mais inclinada ao Druid e se essa preferência provocou alguma inveja em relação ao concorrente? O desenvolvimento do Druid desacelerará enquanto o do Pinot acelerará, se os patrocinadores que suportam o primeiro de repente se interessarem pelo segundo?
Desvantagens do ClickHouse
Imaturidade: é evidente que ainda é uma tecnologia não trivial, mas, de qualquer forma, não há nada parecido em outros SGBDs columnar.
Pequenas inserções funcionam mal em alta velocidade: as inserções devem ser agrupadas em grandes chunks, pois o desempenho de inserções pequenas diminui proporcionalmente ao número de colunas em cada linha. É assim que o ClickHouse armazena dados no disco — cada coluna representa 1 arquivo ou mais, então, para inserir 1 linha com 100 colunas, é necessário abrir e gravar pelo menos 100 arquivos. É por isso que um intermediário é necessário para bufferizar inserções (a menos que o próprio cliente faça a bufferização) — geralmente, isso é Kafka ou algum sistema de gerenciamento de filas. Também é possível usar o mecanismo Buffer table para depois copiar grandes fragmentos de dados para tabelas MergeTree.
As junções de tabelas são limitadas à memória RAM do servidor, mas pelo menos elas existem! Por exemplo, o Druid e o Pinot não têm essas junções, pois são difíceis de implementar diretamente em sistemas distribuídos que não suportam a movimentação de grandes volumes de dados entre nós.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
Nos próximos anos, planejamos usar amplamente o ClickHouse na Qwintry, pois esse SGBD oferece um excelente equilíbrio entre desempenho, baixa sobrecarga, escalabilidade e simplicidade. Estou quase certo de que começará a se espalhar rapidamente assim que a comunidade ClickHouse encontrar mais maneiras de usá-lo em instalações pequenas e médias.
Um pouco de publicidade 🙂
Obrigado por permanecer conosco. Você gosta dos nossos artigos? Quer ver mais materiais interessantes? Apoie-nos fazendo um pedido ou recomendando para conhecidos. , uma alternativa única aos servidores entry-level, que criamos para você: (disponíveis opções com RAID1 e RAID10, até 24 núcleos e até 40GB DDR4).
Dell R730xd por 2 vezes mais barato no datacenter Equinix Tier IV em Amsterdã? Somente conosco na Holanda! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — a partir de $99! Leia sobre
Fonte: habr.com
