

Atualmente, existem soluções prontas (proprietárias) para monitoramento de fluxos IP(TS), como e , que possuem um conjunto bastante rico de funções e geralmente essas soluções estão disponíveis para grandes operadores que lidam com serviços de TV. Este artigo descreve uma solução com base no projeto de código aberto , destinada ao controle mínimo de fluxos IP(TS) com base no contador de continuidade (CC) e na taxa de bits. Uma possível aplicação é o monitoramento da perda de pacotes ou do fluxo inteiro através de um canal L2 alugado (que não pode ser monitorado adequadamente, por exemplo, lendo os contadores de perda nas filas).
Um resumo sobre o TSDuck
TSDuck é um software de código aberto (licença 2-Clause BSD) composto por um conjunto de utilitários de console e uma biblioteca para desenvolvimento de suas próprias utilidades ou plugins para manipulação de fluxos TS. Como entrada, suporta IP (multicast/unicast), http, hls, tuneres dvb, demodulador de dektec dvb-asi, possui um gerador interno de fluxo TS e leitura de arquivos. Como saída, permite gravação em arquivo, IP (multicast/unicast), hls, dektec dvb-asi e moduladores HiDes, players (mplayer, vlc, xine) e drop. Entre a entrada e a saída, é possível inserir diversos processadores de tráfego, como re-mapeamento de PIDs, realizar scrambled/descrambled, análise de contadores CC, contagem de taxa de bits e outras operações típicas para fluxos TS.
Neste artigo, serão utilizados fluxos IP (multicast) como entrada, usando os processadores bitrate_monitor (do nome é fácil entender o que é) e continuity (análise dos contadores CC). Sem grandes dificuldades, é possível substituir IP multicast por outro tipo de entrada suportado pelo TSDuck.
Existem do TSDuck para a maioria dos sistemas operacionais atuais. Para Debian, não há, mas consegui compilar sem problemas no Debian 8 e no Debian 10.
Em seguida, será utilizada a versão TSDuck 3.19-1520, no sistema operacional Linux (para preparar a solução, foi usado o Debian 10, para uso real — CentOS 7)
Preparação do TSDuck e do SO
Antes de monitorar fluxos reais, é necessário garantir que o TSDuck esteja funcionando corretamente e que não haja perdas no nível da placa de rede ou do sistema operacional (socket). Isso é necessário para não ficar adivinhando onde ocorreram as perdas — na rede ou 'dentro do servidor'. Para verificar as perdas no nível da placa de rede, pode-se usar o comando ethtool -S ethX; o tuning é feito com o mesmo ethtool (geralmente, é necessário aumentar o buffer RX (-G) e às vezes desativar alguns offloads (-K)). Como recomendação geral, é aconselhável usar uma porta separada para receber o tráfego analisado, se possível, isso minimiza falsos positivos relacionados ao fato de que a perda aconteceu especificamente na porta do analisador devido à presença de outro tráfego. Se essa possibilidade não existir (usando um mini-computador/NUC com uma única porta), é altamente recomendável configurar a priorização do tráfego analisado em relação ao restante do dispositivo ao qual o analisador está conectado. Em ambientes virtuais, deve-se ter cuidado e ser capaz de identificar as perdas de pacotes começando pela porta física e terminando no aplicativo dentro da máquina virtual.
Geração e recebimento de fluxo dentro do host
Como primeiro passo na preparação do TSDuck, vamos gerar e receber tráfego dentro de um único host usando netns.
Preparando o ambiente:
ip netns add P #criamos netns P, onde a análise de tráfego ocorrerá
ip link add type veth #criamos um par veth - deixamos o veth0 no netns por padrão (neste interface será gerado tráfego)
ip link set dev veth1 netns P #movemos veth1 para netns P (neste interface será recebido o tráfego)
ip netns exec P ifconfig veth1 192.0.2.1/30 up #levantamos o IP no veth1, não importa qual exatamente
ip netns exec P ip ro add default via 192.0.2.2 #configuramos a rota padrão dentro do netns P
sysctl net.ipv6.conf.veth0.disable_ipv6=1 #desativamos o IPv6 no veth0 - isso é feito para que o lixo não contabilize no contador TX
ifconfig veth0 up #levantamos o interface veth0
ip route add 239.0.0.1 dev veth0 #criamos uma rota para que o SO direcione o tráfego para 239.0.0.1 na direção de veth0
O ambiente está pronto. Iniciamos o analisador de tráfego:
ip netns exec P tsp --realtime -t
 -I ip 239.0.0.1:1234
 -P continuity
 -P bitrate_monitor -p 1 -t 1
 -O drop
onde '-p 1 -t 1' significa que deve-se calcular a taxa de bits a cada segundo e exibir as informações sobre a taxa de bits a cada segundo
Iniciamos o gerador de tráfego a uma velocidade de 10Mbit/s:
tsp -I craft
 -P regulate -b 10000000
 -O ip -p 7 -e --local-port 6000 239.0.0.1:1234
onde "-p 7 -e" significa que devemos empacotar 7 pacotes TS em 1 pacote IP e fazê-lo rigidamente (-e), ou seja, sempre aguardar 7 pacotes TS do último processador antes de enviar a formação do pacote IP.
O analisador começa a mostrar as mensagens esperadas:
* 2020/01/03 14:55:44 - bitrate_monitor: 2020/01/03 14:55:44, bitrate TS: 9.970.016 bits/s
* 2020/01/03 14:55:45 - bitrate_monitor: 2020/01/03 14:55:45, bitrate TS: 10.022.656 bits/s
* 2020/01/03 14:55:46 - bitrate_monitor: 2020/01/03 14:55:46, bitrate TS: 9.980.544 bits/s
Agora adicionamos algumas perdas:
ip netns exec P iptables -I INPUT -d 239.0.0.1 -m statistic --mode random --probability 0.001 -j DROPe aparecem mensagens do tipo:
* 2020/01/03 14:57:11 - continuity: índice do pacote: 80.745, PID: 0x0000, faltando 7 pacotes
* 2020/01/03 14:57:11 - continuity: índice do pacote: 83.342, PID: 0x0000, faltando 7 pacotes
o que é esperado. Desligamos a perda de pacotes (ip netns exec P iptables -F) e tentamos aumentar a taxa de bits do gerador para 100 Mbit/s. O analisador relata uma série de erros CC e cerca de 75 Mbit/s em vez de 100. Tentamos entender quem é o culpado — se o gerador não está acompanhando ou se o problema não está nele, para isso iniciamos a geração de uma quantidade fixa de pacotes (700.000 pacotes TS = 100.000 pacotes IP):
# ifconfig veth0 | grep TX
       TX packets 151825460  bytes 205725459268 (191.5 GiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
# tsp -I craft -c 700000 -P regulate -b 100000000 -P count -O ip -p 7 -e --local-port 6000 239.0.0.1:1234
* count: PID    0 (0x0000):    700,000 packets
# ifconfig veth0 | grep TX
        TX packets 151925460  bytes 205861259268 (191.7 GiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
Como pode ser visto, exatamente 100.000 pacotes IP foram gerados (151925460-151825460). Portanto, verificamos o que está acontecendo com o analisador, para isso comparamos com o contador RX na veth1, que é estritamente igual ao contador TX na veth0, então vemos o que acontece no nível do socket:
# ip netns exec P cat /proc/net/udp
  sl  local_address rem_address   st tx_queue rx_queue tr tm->when retrnsmt   uid  timeout inode ref pointer drops
  133: 010000EF:04D2 00000000:0000 07 00000000:00000000 00:00000000 00000000     0        0 72338 2 00000000e0a441df 24355
Aqui podemos ver o número de perdas = 24355. Em pacotes TS, isso é 170485 ou 24,36% de 700000, assim vemos que os 25% da taxa de bits perdida são perdas no socket UDP. As perdas no socket UDP normalmente ocorrem devido à falta de buffer, verificamos qual é o tamanho do buffer do socket por padrão e o tamanho máximo do buffer do socket:
# sysctl net.core.rmem_default
net.core.rmem_default = 212992
# sysctl net.core.rmem_max
net.core.rmem_max = 212992
Assim, se os aplicativos não solicitarem explicitamente o tamanho do buffer, os sockets são criados com um buffer de 208 KB, mas se solicitarem mais, ainda não receberão o solicitado. Como no tsp para entrada IP podemos definir o tamanho do buffer (—buffer-size), não vamos alterar o tamanho do socket padrão, apenas definiremos o tamanho máximo do buffer do socket e especificaremos o tamanho do buffer explicitamente através dos argumentos tsp:
sysctl net.core.rmem_max=8388608
ip netns exec P tsp --realtime -t -I ip 239.0.0.1:1234 -b 8388608 -P continuity -P bitrate_monitor -p 1 -t 1 -O drop
Com esse ajuste no buffer do socket, agora a taxa de bits reportada é de aproximadamente 100 Mbit/s, sem erros CC.
Com base no consumo de CPU pelo próprio aplicativo tsp. Para um núcleo i5-4260U CPU @ 1.40GHz, analisar um fluxo de 10 Mbps requer 3-4% de CPU, 100 Mbps — 25%, 200 Mbps — 46%. Com uma porcentagem de perda de pacotes configurada, a carga na CPU praticamente não aumenta (mas pode diminuir).
Em hardware mais potente, foi possível gerar e analisar fluxos de mais de 1 Gbps sem problemas.
Testando em placas de rede reais
Após o teste na par de veth, é necessário pegar dois hosts ou duas portas de um único host, conectar as portas entre si, iniciar um gerador em uma porta e um analisador na outra. Aqui, não houve surpresas, mas na verdade tudo depende do hardware; quanto mais fraco, mais interessante será a situação.
Utilização dos dados obtidos pelo sistema de monitoramento (Zabbix)
O tsp não possui uma API legível por máquina, como SNMP ou similar. As mensagens CC precisam ser agregadas pelo menos a cada 1 segundo (com uma alta porcentagem de perda de pacotes, pode haver centenas/milhares/dezenas de milhares por segundo, dependendo da taxa de bits).
Portanto, para manter tanto as informações quanto plotar gráficos sobre erros de CC e taxa de bits e lidar com possíveis falhas, as seguintes opções podem ser consideradas:
- Fazer o parsing e agregar (por CC) a saída do tsp, ou seja, convertê-la para a forma necessária.
- Modificar o próprio tsp e/ou os plugins processadores bitrate_monitor e continuity, para que o resultado seja apresentado em uma forma legível por máquina, adequada para o sistema de monitoramento.
- Criar um aplicativo próprio usando a biblioteca tsduck.
É evidente que, em termos de esforço, a opção 1 é a mais simples, especialmente considerando que o próprio tsduck é escrito em uma linguagem de baixo nível (nos padrões atuais, C++).
Um simples protótipo de parser + agregador em bash mostrou que em um fluxo de 10 Mbps e 50% de perda de pacotes (o pior cenário), o processo bash consumia de 3 a 4 vezes mais CPU do que o próprio processo tsp. Essa possibilidade é inaceitável. Na verdade, aqui está uma parte desse protótipo abaixo.
Macarrão no bash
#!/usr/bin/env bash

missingPackets=0
ccErrorSeconds=0
regexMissPackets='^* (.+) - continuity:.*missing ([0-9]+) packets$'
missingPacketsTime=""

ip netns exec P tsp --realtime -t -I ip -b 8388608 "239.0.0.1:1234" -O drop -P bitrate_monitor -p 1 -t 1  -P continuity 2>&1 |
while read i
do
    #line example:* 2019/12/28 23:41:14 - continuity: packet index: 6,078, PID: 0x0100, missing 5 packets
    #line example 2: * 2019/12/28 23:55:11 - bitrate_monitor: 2019/12/28 23:55:11, TS bitrate: 4,272,864 bits/s
    if [[ "$i" == *continuity:* ]]
    then
        if [[ "$i" =~ $regexMissPackets ]]
        then
            missingPacketsTimeNew="${BASH_REMATCH[1]}" #timestamp (seconds)
            if [[ "$missingPacketsTime" != "$missingPacketsTimeNew" ]] #new second with CC error
            then
                ((ccErrorSeconds += 1))
            fi
            missingPacketsTime=$missingPacketsTimeNew
            packets=${BASH_REMATCH[2]} #TS missing packets
            ((missingPackets += packets))
        fi
    elif [[ "$i" == *bitrate_monitor:* ]]
    then
        : #...
    fi
done
Além de funcionar de forma inaceitavelmente lenta, o bash não possui threads normais, os jobs do bash são processos independentes e foi necessário registrar a cada segundo o valor de missingPackets no side-effect (ao receber a mensagem sobre a taxa de bits, que chega a cada segundo). No final, o bash foi deixado de lado e decidiu-se escrever uma camada (parser + agregador) em golang. O consumo de CPU do código equivalente em golang é de 4 a 5 vezes menor do que o próprio processo tsp. O aumento de velocidade da camada ao substituir o bash por golang foi de aproximadamente 16 vezes e, no geral, o resultado é aceitável (sobrecarga de CPU de 25% no pior caso). O arquivo original em golang está .
Executando a camada
Para executar a camada, foi criado um modelo simples de serviço para systemd (). Presume-se que a própria camada esteja compilada em um arquivo binário (go build tsduck-stat.go), colocado em /opt/tsduck-stat/. Presume-se que seja utilizado golang com suporte a monotonic clock (>=1.9).
Para criar uma instância do serviço, é necessário executar o comando systemctl enable tsduck-stat@239.0.0.1:1234, e depois iniciá-lo usando systemctl start tsduck-stat@239.0.0.1:1234.
Discovery do Zabbix
Para que o zabbix possa realizar o discovery dos serviços em execução, foi feito um (discovery.sh), no formato necessário para o discovery do Zabbix, presume-se que ele esteja localizado lá mesmo — em /opt/tsduck-stat. Para executar o discovery através do zabbix-agent, é necessário adicionar na diretório de configurações do zabbix-agent para adicionar o parâmetro do usuário.
Template do Zabbix
(tsduck_stat_template.xml) contém a regra de auto-descoberta, protótipos de itens de dados, gráficos e gatilhos.
Checklist resumido (porque pode que alguém decida usar)
- Certifique-se de que o tsp não está descartando pacotes em "condições ideais" (o gerador e o analisador estão conectados diretamente), se houver descartes, veja o p.2 ou o texto do artigo sobre isso.
- Faça o ajuste do máximo do buffer do socket (net.core.rmem_max=8388608).
- Compile tsduck-stat.go (go build tsduck-stat.go).
- Coloque o template do serviço em /lib/systemd/system.
- Inicie os serviços usando systemctl, verifique se os contadores começaram a aparecer (grep "" /dev/shm/tsduck-stat/*). O número de serviços corresponde ao número de fluxos multicast. Pode ser necessário criar uma rota para o grupo multicast, possivelmente desativar o rp_filter ou criar uma rota para o ip de origem.
- Execute discovery.sh, certifique-se de que ele gera json.
- Cole o config do zabbix-agent, reinicie o zabbix-agent.
- Carregue o template no Zabbix, aplique-o ao host que está sendo monitorado e no qual está instalado o zabbix-agent, aguarde cerca de 5 minutos e verifique se novos itens de dados, gráficos e gatilhos apareceram.
Resultado
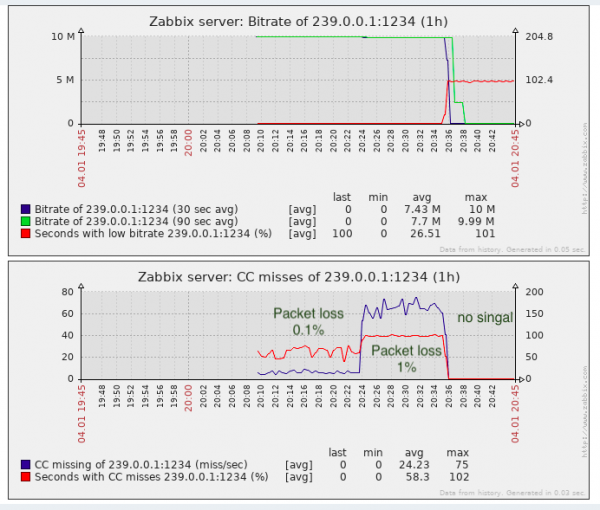
Para a tarefa de identificar perda de pacotes, isso é quase suficiente, afinal, é melhor do que não ter monitoramento.
Na verdade, as CC-«perdas» podem ocorrer ao unir fragmentos de vídeo (até onde sei, é assim que as inserções são feitas em centros de televisão locais na Rússia, ou seja, sem recalcular o contador CC), isso deve ser lembrado. Em soluções proprietárias, esse problema é parcialmente contornado pela detecção de marcas SCTE-35 (se forem adicionadas pelo gerador de fluxo).
Do ponto de vista do monitoramento da qualidade do transporte, falta monitoramento de jitter (IAT), uma vez que o equipamento de TV (sejam moduladores ou dispositivos finais) tem requisitos para esse parâmetro e nem sempre é possível aumentar o jitbuffer indefinidamente. E o jitter pode variar quando o equipamento de grande buffer é utilizado no trânsito e o QoS para a transmissão desse tráfego em tempo real não está bem configurado ou não está configurado.
Fonte: habr.com
