

Olá a todos, meu nome é Sergey Emelyanchik. Sou o gerente da empresa Audit-Telecom, o principal desenvolvedor e autor do sistema Veliam. Decidi escrever um artigo sobre como eu e um amigo criamos uma empresa de outsourcing, desenvolvemos um software para nós e, posteriormente, começamos a distribuí-lo para todos os interessados através do sistema SaaS. Vou compartilhar como eu categoricamente não acreditava que isso era possível. O artigo conterá não apenas a narrativa, mas também detalhes técnicos sobre como o produto Veliam foi criado, incluindo alguns trechos do código-fonte. Contarei quais erros cometemos e como os corrigimos depois. Tive dúvidas se deveria publicar um artigo assim. Mas pensei que era melhor fazer isso, obter feedback e melhorar, do que não publicar e ficar pensando no que poderia ter sido…
Antecedentes
Trabalhei em uma empresa como funcionário de TI. A empresa era bastante grande, com uma estrutura de rede complexa. Não vou me detiver nas minhas funções, apenas direi que elas definitivamente não incluíam o desenvolvimento de nada.
Tínhamos um monitoramento, mas, por puro interesse acadêmico, queria tentar escrever o meu próprio, mais simples. A ideia era que fosse na web, para que fosse fácil acessar e verificar o que estava acontecendo com a rede de qualquer dispositivo, incluindo dispositivos móveis via Wi-Fi, e também queria entender rapidamente qual sala tinha o equipamento que 'apresentou problemas', pois havia exigências bastante rigorosas em termos de tempo de resposta para esses problemas. Assim, surgiu em minha mente o plano de criar uma página web simples, com um fundo jpeg do diagrama da rede, recortar nessa imagem os próprios dispositivos com seus endereços IP, e sobrepor à imagem, nas coordenadas corretas, um conteúdo dinâmico na forma de endereços IP verdes ou vermelhos piscando. A tarefa está definida, vamos começar.
Anteriormente, eu trabalhei com programação em Delphi, PHP, JS e muito superficialmente em C++. Conheço bastante sobre o funcionamento de redes: VLAN, Roteamento (OSPF, EIGRP, BGP), NAT. Isso foi suficiente para escrever um protótipo de monitoramento primitivo de forma independente.
Escrevi o que planejei em PHP. O servidor Apache e o PHP estavam no Windows porque o Linux, naquele momento, era algo que eu não entendia e achava muito complicado. Como descobri mais tarde, eu estava muito enganado; em muitos aspectos, o Linux é bem mais simples que o Windows. Mas esse é um assunto à parte, e todos sabemos quantas discussões existem sobre isso. O agendador de tarefas do Windows acionava, com um intervalo curto (não me lembro exatamente, mas algo em torno de uma vez a cada três segundos), um script PHP que verificava todos os objetos com um simples ping e salvava o estado em um arquivo.
system(“ping -n 3 -w 100 {$ip_address}“);
Sim, sim, naqueles momentos eu também não dominava o trabalho com bancos de dados. Eu não sabia que era possível paralelizar processos, e a verificação de todos os nós da rede levava muito tempo, pois acontecia em um único fluxo. Especialmente problemas surgiam quando vários nós estavam indisponíveis, já que cada um deles atrasava o script em 300 ms. No lado do cliente, havia uma função simples em loop, que a cada poucos segundos baixava as informações atualizadas do servidor com uma requisição Ajax e atualizava a interface. E, depois de três pings falhos consecutivos, se a página da web com monitoramento estivesse aberta no computador, uma música animada tocava.
Quando tudo funcionou, fiquei muito inspirado com o resultado e pensei que poderia adicionar mais coisas (dada a minha experiência e possibilidades). Mas eu sempre não gostei de sistemas com um milhão de gráficos, que eu achava, e ainda acho hoje, na maioria das vezes desnecessários. Queria apenas integrar o que realmente me ajudaria no trabalho. Este princípio se mantém até hoje como fundamental no desenvolvimento do Veliam. Além disso, percebi que seria muito legal se não fosse necessário manter a monitoria aberta e saber sobre os problemas, e sim abrir a página e ver onde está localizado o nó problemático e o que fazer a seguir quando o problema aparecer. Não costumava ler o e-mail naquela época, simplesmente não o usava. Encontrei na internet que existiam gateways de SMS, para os quais se podia enviar uma solicitação GET ou POST, e eles me enviariam um SMS para o celular com o texto que eu escrevesse. Eu imediatamente percebi que queria muito isso. E comecei a estudar a documentação. Depois de algum tempo, consegui, e agora eu recebia SMS sobre problemas na rede no meu celular com o nome do "objeto caído". Embora o sistema fosse primitivo, ele foi escrito por mim, e o que mais me motivou a desenvolvê-lo foi que era um programa prático que realmente me ajudava no trabalho.
E então chegou o dia em que uma das conexões de internet caiu no trabalho, e meu monitoramento não me avisou sobre isso. Já que os DNS do Google ainda estavam respondendo bem. Era hora de pensar em como monitorar se o canal de comunicação estava ativo. Havia várias ideias de como fazer isso. Não tinha acesso a todo o equipamento. Tive que inventar uma maneira de entender qual dos canais estava ativo, mas sem ter a possibilidade de ver isso no equipamento de rede. Então, um colega sugeriu a ideia de que talvez o rastreamento de rotas até servidores públicos poderia diferir dependendo do canal de comunicação pelo qual a conexão à internet estava sendo feita. Verifiquei, e era verdade. Havia diferentes rotas durante o rastreamento.
system(“tracert -d -w 500 8.8.8.8”);
Assim surgiu mais um script, mais precisamente, a rastreabilidade foi adicionada ao final do mesmo script que fazia ping em todos os dispositivos da rede. Afinal, esse era outro processo longo, que ocorria no mesmo thread e atrasava o funcionamento de todo o script. Mas na época isso não era tão óbvio. De qualquer forma, ele cumpria sua função, o código especificava rigidamente qual deveria ser a rastreabilidade de cada um dos canais. Assim, o sistema começou a funcionar, monitorando (para ser honesto, esse termo é exagerado, visto que não coletava métricas, apenas realizava pings) dispositivos de rede (roteadores, switches, wi-fi etc.) e canais de comunicação com o mundo exterior. Mensagens de texto chegavam normalmente e no diagrama era sempre visível onde estava o problema.
Além disso, no trabalho cotidiano, era necessário realizar a cross-referência. E sempre era cansativo acessar os switches Cisco para verificar qual interface deveria ser utilizada. Seria ótimo clicar no monitoramento de um objeto e ver a lista de suas interfaces com descrições. Isso economizaria meu tempo. E o melhor é que nesse esquema não precisaria abrir o Putty ou SecureCRT, inserir credenciais e comandos. Eu simplesmente clicava no monitoramento, via o que precisava e seguia com meu trabalho. Comecei a buscar formas de interagir com os switches. De imediato, encontrei duas opções: SNMP ou acessar o switch via SSH, inserir os comandos necessários e analisar o resultado. Descartamos o SNMP devido à complexidade da implementação, pois estava ansioso para obter resultados. Com o SNMP, teria que passar um bom tempo estudando o MIB para formar dados sobre as interfaces com base nessas informações. Existe um comando maravilhoso no CISCO
show interface statusEla mostra exatamente o que eu precisava para gerenciamento de comutadores. Por que se preocupar com SNMP, quando eu só queria ver a saída desse comando, pensei. Depois de algum tempo, implementei essa funcionalidade. Cliquei no objeto na página da web. Um evento foi acionado, pelo qual o cliente fazia uma solicitação ao servidor via AJAX, e este, por sua vez, se conectava via SSH ao comutador que eu precisava (as credenciais estavam embutidas no código, não queria fazer menus separados onde pudesse mudar as credenciais pela interface, precisava do resultado e rápido) colocava lá o comando mencionado acima e retornava ao navegador. Assim, comecei a ver informações sobre interfaces com um único clique do mouse. Isso foi extremamente conveniente, especialmente quando era necessário visualizar essas informações em vários comutadores ao mesmo tempo.
O monitoramento de canais baseado em rastreamento acabou não sendo a melhor ideia, pois, às vezes, havia trabalhos na rede, e o rastreamento poderia mudar e o monitoramento começava a alertar que havia problemas no canal. Mas, após gastar muito tempo analisando, percebia que todos os canais funcionavam e meu monitoramento estava me enganando. Então, pedi aos colegas que gerenciavam os comutadores que fornecessem apenas syslog quando o estado de visibilidade dos vizinhos mudasse. Assim, isso era muito mais simples, rápido e preciso do que o rastreamento. Chegava um evento do tipo neighbor lost, e eu imediatamente fazia um alerta sobre a queda do canal.
Em seguida, surgiram saídas de clique no objeto com mais alguns comandos e adicionei SNMP para coletar algumas métricas, e, em resumo, foi isso. O sistema não se desenvolveu mais. Ele fazia tudo o que eu precisava, era uma boa ferramenta. Muitos leitores, provavelmente, vão me dizer que existem muitos softwares na internet para resolver essas questões. Mas, na verdade, eu não encontrei produtos gratuitos na época e realmente queria desenvolver minhas habilidades de programação, e o que pode me motivar melhor para isso do que uma tarefa prática real? Com isso, a primeira versão do monitoramento foi concluída e não foi mais modificada.
Criação da empresa Audit-Telecom
Com o tempo, comecei a trabalhar paralelamente em outras empresas, já que meu horário de trabalho me permitia fazer isso. Quando você trabalha em diferentes empresas, rapidamente desenvolve habilidades em diversas áreas e amplia sua visão. Existem empresas onde, como se costuma dizer, você é alfaiate, ceifeiro e toca gaita. Por um lado, isso é desafiador, mas por outro, se você não for preguiçoso, torna-se um especialista multifacetado, o que permite resolver tarefas mais rapidamente e de forma mais eficaz, porque você sabe como funciona a área relacionada.
Meu amigo Pavel (também da área de TI) estava constantemente me incentivando a abrir meu próprio negócio. Houve inúmeras ideias com várias opções de empreendimento. Isso foi discutido por vários anos. E, no final, não chegamos a lugar nenhum, porque sou cético e Pavel é sonhador. Sempre que ele propunha uma ideia, eu nunca a acreditava e me recusava a participar. Mas realmente queríamos abrir nosso próprio negócio.
Finalmente, conseguimos encontrar uma opção que agradava a ambos e começamos a trabalhar no que sabemos fazer. Em 2016, decidimos criar uma empresa de TI que ajudaria os negócios a resolver desafios de tecnologia da informação. Isso inclui a implementação de sistemas de TI (1C, servidores de terminais, servidor de correio, etc.), seu suporte, um HelpDesk clássico para usuários e administração de redes.
Para ser sincero, no creía en la empresa aproximadamente en un 99.9% en el momento de su creación. Pero de alguna manera, Pavel logró convencerme de intentarlo, y avanzando un poco, resultó que tenía razón. Pavel y yo pusimos 300,000 rublos cada uno, registramos una nueva LLC llamada "Audit-Telecom", alquilamos una pequeña oficina, hicimos tarjetas de presentación geniales, en fin, como probablemente la mayoría de los empresarios novatos e inexpertos, y comenzamos a buscar clientes. La búsqueda de clientes es en sí misma una historia aparte. Quizás escribamos un artículo separado en el blog corporativo si a alguien le interesa. Llamadas en frío, folletos, y demás. No obtuvimos resultados. Como ahora leo de muchas historias de negocios, en gran medida, todo depende de la suerte. Tuvimos suerte, y a las pocas semanas de haber creado la empresa, mi hermano Vladimir se acercó a nosotros y trajo nuestro primer cliente. No quiero abrumar con detalles sobre el trabajo con los clientes, este artículo no trata de eso. Solo diré que fuimos a una auditoría, identificamos puntos críticos y esos puntos fallaron mientras se tomaba la decisión de si colaborar con nosotros de manera permanente como subcontratistas. Después de eso, se tomó inmediatamente una decisión positiva.
Luego, principalmente a través del boca a boca entre conocidos, comenzaron a aparecer otras empresas bajo nuestro servicio. El helpdesk estaba en un sistema. Las conexiones al equipo de red y a los servidores en otro, o más bien, cada uno tenía su propio método. Algunos guardaban accesos directos, otros usaban libretas de direcciones RDP. El monitoreo era otro sistema separado. Trabajar en sistemas dispares es muy inconveniente para el equipo. Información importante se pierde de vista. Por ejemplo, si el servidor terminal de un cliente se vuelve inaccesible, inmediatamente llegan solicitudes de los usuarios de ese cliente. El especialista de soporte genera una solicitud (que llegó por teléfono). Si los incidentes y solicitudes se registraran en un solo sistema, el especialista de soporte vería inmediatamente cuál es el problema del usuario y se lo comunicaría, mientras se conecta al objeto necesario para manejar la situación. Todos estarían al tanto de la situación táctica y trabajarían de manera coordinada. No encontramos un sistema que combine todo esto. Quedó claro que era hora de crear nuestro propio producto.
Continuación del trabajo en nuestro propio sistema de monitoreo
Ficou claro que o sistema que havia sido desenvolvido anteriormente não atendia em nada às atuais necessidades. Nem em termos de funcionalidade, nem em qualidade. Decidiu-se, então, reescrever o sistema do zero. Graficamente, isso deveria ter uma aparência completamente diferente. Deveria ser um sistema hierárquico, que permitisse abrir rapidamente e de forma prática os objetos necessários para cada cliente. O esquema da primeira versão simplesmente não se justificava, já que os clientes eram diversos e não importava em que local estavam os equipamentos. Isso já havia sido transferido para a documentação.
Portanto, as tarefas:
- Estrutura hierárquica;
- Uma parte do servidor que poderia ser instalada no cliente na forma de uma máquina virtual para coletar as métricas necessárias e enviar para um servidor central que as agregaria e nos apresentaria;
- Notificações. Aqueles que não podem ser ignorados, pois naquele momento não havia ninguém disponível para apenas monitorar a tela;
- Sistema de tickets. Começaram a surgir clientes para os quais atendíamos não apenas equipamentos de servidores e rede, mas também estações de trabalho;
- Possibilidade de se conectar rapidamente a servidores e equipamentos a partir do sistema;
As tarefas foram definidas, e começamos a desenvolver. Ao mesmo tempo, estávamos lidando com solicitações dos clientes. Naquele momento, éramos apenas quatro pessoas. Começamos a desenvolver ambas as partes, tanto o servidor central quanto o servidor para instalação nos clientes. A essa altura, o Linux já não nos era estranho e decidimos que as máquinas virtuais que estariam nos clientes seriam baseadas em Debian. Não haveria instaladores, apenas faríamos um projeto da parte do servidor em uma máquina virtual específica e depois a clonaria para os clientes necessários. Este foi mais um erro. Posteriormente, ficou claro que esse esquema não tinha um mecanismo de atualização bem definido. Ou seja, adicionávamos um novo recurso e, em seguida, surgia todo um problema para distribuí-lo para todos os servidores dos clientes, mas voltaremos a isso mais tarde, tudo a seu tempo.
Criamos o primeiro protótipo. Ele conseguia pingar os dispositivos de rede e servidores dos clientes que precisávamos e enviar esses dados para o nosso servidor central. Esse, por sua vez, atualizava esses dados na base geral no servidor central. Aqui, vou relatar não apenas a história de como e o que foi realizado, mas também quais erros amadores foram cometidos e como depois tivemos que pagar por isso em tempo. Assim, toda a árvore de objetos era armazenada em um único arquivo na forma de um objeto serializado. Enquanto conectávamos alguns clientes ao sistema, tudo estava mais ou menos normal, embora às vezes aparecessem alguns artefatos que eram completamente incompreensíveis. Mas quando conectamos uma dúzia de servidores ao sistema, começaram a acontecer milagres. Às vezes, por razões incompreensíveis, todos os objetos no sistema simplesmente desapareciam. É importante notar que os servidores que os clientes tinham enviavam dados ao servidor central a cada poucos segundos por meio de uma solicitação POST. O leitor atento e o programador experiente já perceberam que surgia um problema de acesso simultâneo ao mesmo arquivo onde o objeto serializado era armazenado a partir de diferentes threads ao mesmo tempo. E foi exatamente quando isso acontecia que surgiam milagres com o desaparecimento de objetos. O arquivo simplesmente se tornava vazio. Mas isso tudo não foi descoberto imediatamente, e sim somente durante a operação com vários servidores. Durante esse tempo, foi adicionada uma funcionalidade para escanear portas (os servidores enviavam ao central não só informações sobre a disponibilidade de dispositivos, mas também sobre as portas abertas). Isso foi feito chamando o comando:
$connection = @fsockopen($ip, $port, $errno, $errstr, 0.5);
os resultados costumavam estar errados e a varredura levava muito tempo. Quase esqueci do ping, que era realizado através do fping:
system("fping -r 3 -t 100 {$this->ip}");
Isso tudo também não foi paralelizado, portanto o processo era muito demorado. Mais tarde, no fping, já era passado imediatamente toda a lista de endereços IP necessários para verificação e recebíamos de volta uma lista pronta daqueles que responderam. Ao contrário de nós, o fping conseguia paralelizar os processos.
Mais uma tarefa rotineira comum era a configuração de alguns serviços via WEB. Por exemplo, o ECP do MS Exchange. Na verdade, isso é apenas um link. Decidimos que era necessário permitir que adicionássemos esses links diretamente ao sistema, para não termos que procurar na documentação ou em favoritos como acessar o ECP de um cliente específico. Assim, surgiu o conceito de links de recurso para o sistema, cuja funcionalidade está disponível até hoje e não sofreu alterações, quase.
Funcionamento dos links de recurso no Veliam
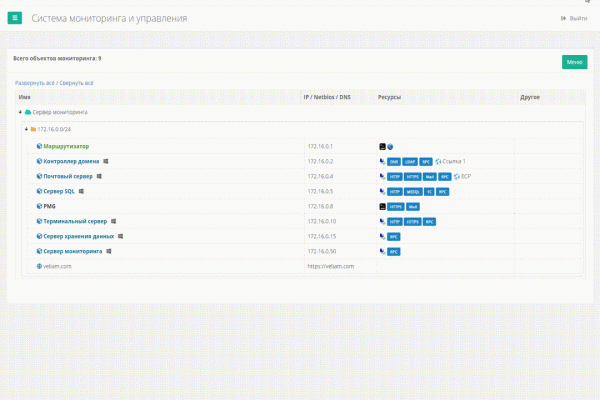
Conexões remotas
Assim é que isso funciona na versão atual do Veliam
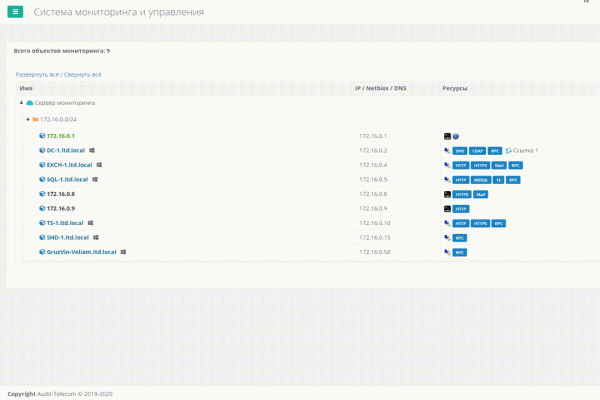
Uma das tarefas era a conexão rápida e conveniente aos servidores, que já eram muitos (mais de uma centena), e percorrer milhões de atalhos RDP salvos com antecedência era extremamente inconveniente. Precisávamos de uma ferramenta. Existe um software na internet que funciona como uma espécie de agenda de endereços para essas conexões RDP, mas não estão integrados ao sistema de monitoramento, e as credenciais não podem ser salvas. Inserir as credenciais para diferentes clientes repetidamente é um verdadeiro pesadelo, especialmente quando você se conecta dezenas de vezes por dia a diferentes servidores. Com SSH a situação é um pouco melhor, há muitos softwares bons que permitem organizar essas conexões em pastas e lembrar das credenciais. Mas existem dois problemas. O primeiro - para conexões RDP e SSH não encontramos um único programa. O segundo - se em algum momento não estou no meu computador e preciso me conectar rapidamente, ou se simplesmente reinstalei o sistema, terei que consultar a documentação para verificar as credenciais desse cliente. Isso é inconveniente e uma perda de tempo.
A estrutura hierárquica que precisávamos para os servidores dos clientes já existia em nosso produto interno. Precisávamos apenas pensar em como integrar facilmente as conexões rápidas ao equipamento necessário. Para começar, pelo menos dentro da nossa própria rede.
Considerando que o cliente em nosso sistema era um navegador que não tinha acesso aos recursos locais do computador para simplesmente executar um aplicativo necessário com algum comando, foi criado um sistema de 'esquema de URL personalizado do Windows'. Assim surgiu um 'plugin' para o nosso sistema, que simplesmente incluía o Putty e o Remote Desktop Plus e, ao ser instalado, apenas registrava a URI no Windows. Agora, quando queríamos nos conectar a um objeto via RDP ou SSH, clicávamos nessa ação em nosso sistema e ativava a operação da URI personalizada. O mstsc.exe padrão, embutido no Windows, ou o putty, que fazia parte do 'plugin', eram iniciados. Uso a palavra plugin entre aspas porque isso não é um plugin de navegador no sentido clássico.
Isso já era alguma coisa. Uma agenda de contatos conveniente. E no caso do Putty, tudo estava realmente bom, pois podíamos fornecer tanto o IP da conexão quanto o login e a senha como parâmetros de entrada. Ou seja, para os servidores Linux em nossa rede, já nos conectávamos com um clique sem precisar inserir senhas. Mas com RDP as coisas não eram tão simples. No mstsc padrão, não era possível fornecer as credenciais como parâmetros. O Remote Desktop Plus veio em auxílio. Ele permitia fazer isso. Atualmente já conseguimos nos virar sem ele, mas por um bom tempo ele foi um valioso assistente em nosso sistema. Com sites HTTP(S) tudo era simples, esses objetos simplesmente abriam no navegador e pronto. Conveniente e prático. Mas isso era uma felicidade apenas na rede interna.
Como a grande maioria dos problemas que resolvíamos era remotamente do escritório, a maneira mais simples era fazer VPNs para os clientes. Assim, a partir do nosso sistema podíamos nos conectar a eles. Mas ainda era um pouco inconveniente. Para cada cliente era necessário manter uma tonelada de conexões salvas em cada computador. VPN Antes de nos conectar a qualquer um, era preciso ativar a respectiva VPN. Utilizamos essa solução por um bom tempo. Mas o número de clientes aumentou, o número de VPNs também, e tudo isso começou a se tornar incômodo e precisava ser resolvido. Especialmente lágrimas nos vinham aos olhos após a reinstalação do sistema, quando era preciso inserir novamente dezenas de conexões VPN no novo perfil do Windows. Chega de suportar isso, pensei, e comecei a refletir sobre o que poderíamos fazer com essa situação.
É comum que todos os clientes utilizem dispositivos da famosa marca Mikrotik como roteadores. Eles são bastante funcionais e convenientes para realizar praticamente qualquer tarefa. Entre os pontos negativos, está o fato de que são frequentemente 'sequestrados'. Resolmos esse problema de maneira simples, bloqueando todos os acessos externos. Contudo, era necessário ter uma forma de acessá-los sem a necessidade de ir até o local do cliente, pois isso tomava muito tempo. Simplesmente criamos túneis para cada Mikrotik e os separamos em um pool distinto, sem qualquer roteamento, para evitar a fusão da nossa rede com as redes dos clientes e entre elas.
A ideia surgiu de conectar o servidor central de monitoramento, que conhecia as credenciais SSH de todos os Mikrotiks dos clientes, ao objeto desejado no sistema. O servidor seria capaz de criar uma regra de redirecionamento para o host necessário na porta correta. Aqui há vários pontos a considerar. A solução não é universal — funcionará apenas para o Mikrotik, pois a sintaxe dos comandos varia entre os roteadores. Além disso, essas redireções precisariam ser posteriormente removidas, mas a parte servidor da nossa sistema não conseguia monitorar se eu havia terminado minha sessão de trabalho via RDP. E, definitivamente, essa redireção representava uma vulnerabilidade para o cliente. Não estávamos em busca de universalidade, uma vez que o produto era utilizado apenas internamente e não havia planos de torná-lo público.
Cada um dos problemas foi resolvido de uma maneira específica. Quando uma regra era criada, o redirecionamento estava disponível apenas para um IP externo específico (aquele que havia iniciado a conexão). Assim, conseguimos evitar brechas de segurança. No entanto, a cada conexão desse tipo, uma nova regra era adicionada ao Mikrotik na página NAT e não era removida. E todos sabem que quanto mais regras existem, maior é a carga no processador do roteador. Além disso, eu não conseguia aceitar o fato de que, ao acessar um determinado Mikrotik, eu encontraria centenas de regras mortas que ninguém mais queria.
Uma vez que nosso servidor não consegue monitorar o estado da conexão, deixe que o Mikrotik o faça. Escrevi um script que monitorava continuamente todas as regras de redirecionamento com uma descrição específica (description) e verificava se havia uma conexão TCP adequada. Se não houvesse uma por um tempo considerável, provavelmente a conexão já havia sido encerrada e essa regra de redirecionamento poderia ser removida. Tudo funcionou, o script trabalhou bem.
A propósito, aqui está ele:
global atmonrulecounter {"dontDelete"="dontDelete"}
:foreach i in=[/ip firewall nat find comment~"atmon_script_main"] do={
	local dstport [/ip firewall nat get value-name="dst-port" $i]
	local dstaddress [/ip firewall nat get value-name="dst-address" $i]
	local dstaddrport "$dstaddress:$dstport"
	#log warning message=$dstaddrport
	local thereIsCon [/ip firewall connection find dst-address~"$dstaddrport"]
	if ($thereIsCon = "") do={
		set ($atmonrulecounter->dstport) ($atmonrulecounter->dstport + 1)
		#:log warning message=($atmonrulecounter->dstport)
		if (($atmonrulecounter->dstport) > 5) do={
			#log warning message="Removendo regras nat adicionadas automaticamente pelo atmon_script"
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_main_$dstport"]
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_sub_$dstport"]
			set ($atmonrulecounter->dstport) 0
		}
	} else {
		set ($atmonrulecounter->dstport) 0
	}
}
Com certeza poderia ter sido feito de forma mais bonita, rápida, etc., mas funcionava, não sobrecarregava os Mikrotiks e lidava muito bem. Finalmente conseguimos conectar-nos aos servidores e equipamentos de rede dos clientes com apenas um clique do mouse. Sem precisar iniciar a VPN ou inserir senhas. O sistema se tornou realmente muito conveniente de usar. O tempo de manutenção foi reduzido, e todos nós estávamos gastando tempo trabalhando, e não tentando conectar-nos aos objetos necessários.
Backup do Mikrotik
Tínhamos configurado o backup de todos os Mikrotiks para FTP. E no geral, tudo estava bem. Mas quando precisávamos recuperar o backup, era necessário abrir esse FTP e procurá-lo lá. Temos um sistema no qual todos os roteadores estão registrados, e sabemos nos comunicar com os dispositivos via SSH. O que não poderíamos fazer para que o sistema mesmo retirasse os backups de todos os Mikrotiks diariamente, pensei eu. E comecei a implementar isso. Conectamo-nos, fizemos o backup e o trouxemos para o armazenamento.
Código do script em PHP para captura de backup do Mikrotik:
<?php

	$IP = '0.0.0.0';
	$LOGIN = 'admin';
	$PASSWORD = '';
	$BACKUP_NAME = 'test';

    $connection = ssh2_connect($IP, 22);

    if (!ssh2_auth_password($connection, $LOGIN, $PASSWORD)) exit;

    ssh2_exec($connection, '\/system backup save name="atmon" password="atmon"');
    stream_get_contents($connection);
    ssh2_exec($connection, '\/export file="atmon.rsc"');
    stream_get_contents($connection);
    sleep(40); \/\/ Waiting for backup process to complete

    $sftp = ssh2_sftp($connection);

    \/\/ Download backup file
    $size = filesize("ssh2.sftp:\/\/ $sftp\/atmon.backup");
    $stream = fopen("ssh2.sftp:\/\/ $sftp\/atmon.backup", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read < $len && ($buf = fread($stream, $len - $read))) {
        $read += strlen($buf);
        $contents .= $buf;
    }
    file_put_contents ($BACKUP_NAME . '.backup', $contents);
    @fclose($stream);

    sleep(3);
    \/\/ Download RSC file
    $size = filesize("ssh2.sftp:\/\/ $sftp\/atmon.rsc");
    $stream = fopen("ssh2.sftp:\/\/ $sftp\/atmon.rsc", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read
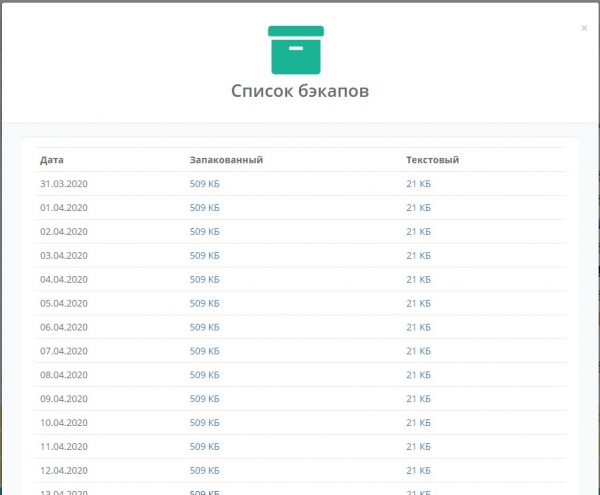
O backup é feito de duas formas — binário e configuração de texto. O binário ajuda a restaurar rapidamente a configuração necessária, enquanto o texto permite entender o que fazer se houver uma substituição forçada de hardware e não for possível carregar o binário nele. Assim, temos mais uma funcionalidade conveniente no sistema. Além disso, ao adicionar novos Mikrotiks, não foi necessário configurar nada, apenas adicionei o objeto ao sistema e defini as credenciais do SSH. Depois disso, o sistema cuidou automaticamente da captura dos backups. Na versão atual do SaaS Veliam, essa funcionalidade ainda não está disponível, mas em breve será portado.
Capturas de tela de como isso parecia no sistema interno
Transição para armazenamento adequado em banco de dados
Já mencionei anteriormente que apareciam artefatos. Às vezes, toda a lista de objetos no sistema simplesmente desaparecia; outras vezes, ao editar um objeto, as informações não eram salvas e eu tinha que renomear o objeto três vezes. Isso irritava a todos. O desaparecimento de objetos ocorria raramente e era facilmente recuperável restaurando o mesmo arquivo. No entanto, a falha ao editar objetos era muito comum. Provavelmente, eu não fiz isso inicialmente através do BD porque não conseguia imaginar como manter uma árvore com todas as suas relações em uma tabela plana. É uma tabela plana, enquanto a árvore é hierárquica. Mas uma boa solução para acesso múltiplo, e posteriormente (com a complexificação do sistema) para transações, é um SGBD. Certamente não sou o primeiro a enfrentar esse problema. Decidi pesquisar. Descobri que já haviam criado soluções antes de mim e existem vários algoritmos que constroem uma árvore a partir de uma tabela plana. Analisando cada um, implementei um deles. Mas isso já era uma nova versão do sistema, pois basicamente tive que reescrever muito por causa disso. O resultado foi previsível; os problemas de comportamento aleatório do sistema desapareceram. Alguém pode dizer que esses erros são bastante amadores (scripts de thread única, armazenamento de informações que tinham acesso simultâneo múltiplo de diferentes threads em um arquivo, etc.) no campo do desenvolvimento de software. Pode ser, mas meu trabalho principal era a administração, e a programação era um hobby. Eu simplesmente não tinha experiência em trabalhar em equipe com programadores, onde coisas tão elementares poderiam ter sido imediatamente indicadas por colegas mais experientes. Então, eu aprendi tudo isso na prática, mas absorvi muito bem o material. E, além disso, meu trabalho incluía reuniões com clientes, ações voltadas para tentar impulsionar a empresa, uma tonelada de questões administrativas dentro da empresa e muito mais. Mas, de qualquer forma, o que já existia era desejado. Tanto eu quanto os outros usávamos o produto no nosso trabalho diário. Houve ideias que se mostraram claramente malsucedidas, e soluções para as quais perdi tempo e, no final, ficou claro que eram ferramentas não funcionais, que ninguém usava e que não foram incorporadas ao Veliam.
Serviço de Atendimento ao Cliente — HelpDesk
Vale a pena mencionar como foi desenvolvido o HelpDesk. Esta é uma história à parte, pois no Veliam já estamos na terceira versão completamente nova, que se distingue de todas as anteriores. Atualmente, é um sistema simples, intuitivo, sem frescuras, e com a possibilidade de integração com o domínio, além de permitir o acesso a este mesmo perfil do usuário de qualquer lugar através de um link enviado por e-mail. E o mais importante, é possível se conectar ao solicitante via VNC diretamente do ticket, sem VPN ou redirecionamentos de portas, independente de estar em casa ou no escritório. Vou contar como chegamos a isso, o que existia antes e quais eram as soluções problemáticas.
Conectamo-nos aos usuários por meio do famoso TeamViewer. Em todos os computadores dos usuários que atendemos, o TV está instalado. A primeira coisa que fizemos errado e posteriormente eliminamos foi a vinculação de cada cliente ao HWID do hardware. Como o usuário acessava o sistema HW para solicitar suporte? Em todos os computadores, além do TV, foi instalada uma ferramenta especial, desenvolvida em Lazarus (aqui muitos levantarão as sobrancelhas e talvez até procurem no Google o que é isso, mas eu sabia que, entre as linguagens compiladas, Delphi era a mais adequada, e o Lazarus é quase o mesmo, só que gratuito). De forma geral, o usuário executava um script especial, que lançava essa ferramenta, que por sua vez lia o HWID do sistema e, depois disso, o navegador era iniciado e a autenticação ocorria. Por que isso foi feito? Em algumas empresas, a contagem de usuários atendidos é feita individualmente, e o preço do suporte mensal é formado com base no número de pessoas. Isso é compreensível, você dirá, mas por que a vinculação ao hardware? Muito simples, alguns indivíduos voltavam para casa e faziam um pedido a partir do laptop pessoal dizendo "façam tudo bonito para mim aqui". Além de ler o HWID do sistema, a ferramenta extraía do registro o ID atual do TeamViewer e também o transmitia para nós. O TeamViewer possui uma API para integração. E nós fizemos essa integração. Mas havia um problema. Através dessas APIs, não é possível se conectar ao computador do usuário a menos que ele inicie claramente essa sessão e, após tentar se conectar, ele deve ainda pressionar "confirmar". Naquele momento, parecia lógico para nós que, sem a permissão do usuário, ninguém deveria se conectar, e já que a pessoa estava no computador, ela iniciaria a sessão e responderia afirmativamente ao pedido de conexão remota. Mas tudo não foi tão simples. Os solicitantes se esqueciam de iniciar a sessão e era necessário orientá-los isso durante uma conversa telefônica. Isso consumia tempo e irritava ambas as partes do processo. Além disso, não era raro que uma pessoa deixasse um pedido, mas só permitisse a conexão quando ela saía para almoçar. Afinal, o problema não é crítico e não quer que seu fluxo de trabalho seja interrompido. Portanto, ele não pressionaria nenhum botão para permitir a conexão. Foi assim que surgiu uma funcionalidade adicional na autenticação do HelpDesk — a leitura do ID do TeamViewer. Sabíamos a senha padrão que era utilizada na instalação do TeamViewer. Na verdade, apenas o sistema sabia, pois estava embutida no instalador e em nosso sistema. Assim, havia um botão de conexão no pedido que, ao ser pressionado, não exigia esperar nada, mas abria imediatamente o TeamViewer e realizava a conexão. No final, surgiram dois tipos de conexões possíveis. Através da API oficial do TeamViewer e a nossa própria solução. Para minha surpresa, a primeira opção foi quase imediatamente abandonada, embora houvesse uma orientação para usá-la apenas em casos especiais e quando o usuário desse seu consentimento. Afinal, a segurança agora é primordial. Mas, surpreendentemente, os solicitantes não estavam interessados nisso. Eles não se incomodavam absolutamente com alguém se conectando sem pressionar o botão de confirmação. E, assim, a funcionalidade de conexão através da API foi eliminada por falta de necessidade.
Migração para multithreading no Linux
Já faz tempo que surge a questão de acelerar a passagem do scanner de rede para verificar a abertura de uma lista pré-definida de portas e a simples execução de pings nos objetos da rede. A primeira solução que vem à mente é a multithreading. Como o tempo principal gasto no ping é a espera pela resposta do pacote, e o próximo ping não pode começar até que o pacote anterior retorne, em empresas com mais de 20 servidores e equipamentos de rede, isso já funcionava de forma bastante lenta. A questão é que um pacote pode se perder, e não se pode notificar imediatamente o administrador do sistema. Ele simplesmente deixaria de notar esse tipo de spam rapidamente. Portanto, é necessário pingar cada objeto mais de uma vez antes de concluir sobre a indisponibilidade. Sem entrar em detalhes muito específicos, é preciso paralelizar, porque se isso não for feito, o administrador do sistema provavelmente ficará sabendo do problema pelo cliente e não pelo sistema de monitoramento.
PHP por si só não suporta multithreading. Suporta multiprocessamento, é possível criar forks. Mas eu já tinha escrito um mecanismo de polling e queria fazer de forma que eu lesse todos os nós que precisava do banco de dados uma única vez, pingasse todos ao mesmo tempo, aguardasse a resposta de cada um e somente depois escrevesse os dados. Isso economiza no número de requisições de leitura. Essa ideia se encaixava perfeitamente na multithreading. Para PHP, existe o módulo PThreads, que permite a verdadeira multithreading; entretanto, tive que me esforçar bastante para configurá-lo no PHP 7.2, mas a tarefa foi concluída. A varredura de portas e o ping se tornaram rápidos. Em vez dos 15 segundos que levava antes, agora esse processo leva 2 segundos. Esse foi um bom resultado.
Auditoria rápida de novas empresas
Como surgiu a funcionalidade de coleta de várias métricas e características de hardware? É simples. Às vezes, somos contratados apenas para auditar a infraestrutura de TI atual. E o mesmo é necessário para acelerar a auditoria de um novo cliente. Precisávamos de algo que nos permitisse entrar em uma empresa média ou grande e rapidamente entender o que eles têm. O ping na rede interna é bloqueado, na minha opinião, apenas por aqueles que querem complicar a própria vida, e, pela nossa experiência, são poucos. Mas eles existem. Assim, é possível escanear rapidamente as redes em busca de dispositivos com um simples ping. Depois, podemos adicioná-los e escanear em busca de portas abertas que nos interessam. Na verdade, essa funcionalidade já existia, só era necessário adicionar um comando do servidor central para que o subordinado escaneasse as redes designadas e adicionasse à lista tudo o que encontrasse. Esqueci de mencionar que se supunha que já tínhamos uma imagem pronta com o sistema configurado (servidor subordinado de monitoramento) que poderíamos simplesmente implantar no cliente durante a auditoria e conectá-lo à nossa nuvem.
No resultado da auditoria, normalmente, encontra-se uma série de informações diversas, e uma delas é sobre que dispositivos existem na rede. Em primeiro lugar, estávamos interessados nos servidores Windows e estações de trabalho Windows que fazem parte do domínio. Pois, em empresas de médio e grande porte, a ausência de um domínio é, provavelmente, uma exceção à regra. Para estabelecer uma referência comum, em minha perspectiva, uma média é de 100+ pessoas. Foi necessário encontrar uma maneira de coletar dados de todas as máquinas e servidores Windows, sabendo seus IPs e a conta do administrador do domínio, mas sem instalar nenhum software em cada uma delas. O interface WMI vem em auxílio. Windows Management Instrumentation (WMI), em tradução literal, significa Instrumentação de Gerenciamento do Windows. O WMI é uma das tecnologias fundamentais para a gestão centralizada e monitoramento do funcionamento de várias partes da infraestrutura de TI sob a plataforma Windows. Extraído da wiki. Depois, foi preciso novamente trabalhar para coletar o wmic (este é o cliente WMI) para Debian. Após tudo estar pronto, bastava apenas consultar os nós necessários via wmic em busca das informações desejadas. Através do WMI, é possível obter quase qualquer informação de um computador Windows e, mais do que isso, também pode-se controlar o computador, por exemplo, enviando-o para reiniciar. Assim, surgiu a coleta de informações sobre estações e servidores Windows em nosso sistema. Além disso, acompanhamos também as informações atuais sobre os indicadores de carga do sistema. Solicitamos esses dados com mais frequência e as informações sobre o hardware com menos frequência. Com isso, realizar a auditoria tornou-se um pouco mais agradável.
Decisão sobre a disseminação de software
Nós mesmos utilizamos o sistema diariamente, e ele está sempre acessível a cada membro da equipe técnica. E pensamos que poderíamos compartilhar com outros aquilo que já temos. O sistema ainda não estava pronto para ser disseminado. Era necessário revisar muito do que foi feito para que a versão local se transformasse em SaaS. Isso incluiu alterações em vários aspectos técnicos do funcionamento do sistema (conexões remotas, serviço de suporte), análise de módulos para licenciamento, shardização das bases de dados dos clientes, escalabilidade de cada um dos serviços e desenvolvimento de sistemas de autoatualização para todas as partes. Mas sobre isso falaremos na segunda parte do artigo.
Atualizar
Fonte: habr.com
