

O conteúdo deste artigo foi retirado do meu .
Mecanismo de movimentação de dados
- Bloco de dados dblk_t
- Mensagem mblk_t
- Funções de operação com mensagens mblk_t
- Fila queue_t
- Funções de operação com filas queue_t
- Conexão de filtros
- Ponto de sinal do grafo de processamento de dados
- Atividades nos bastidores do ticker
- Bufferizador (MSBufferizer)
- Funções de operação com MSBufferizer
Na parte anterior Desenvolvemos nosso próprio filtro. Este artigo será dedicado à estrutura do mecanismo interno de movimentação de dados entre filtros de media streamer. Isso permitirá, posteriormente, criar filtros complexos com menor esforço.
Mecanismo de movimentação de dados
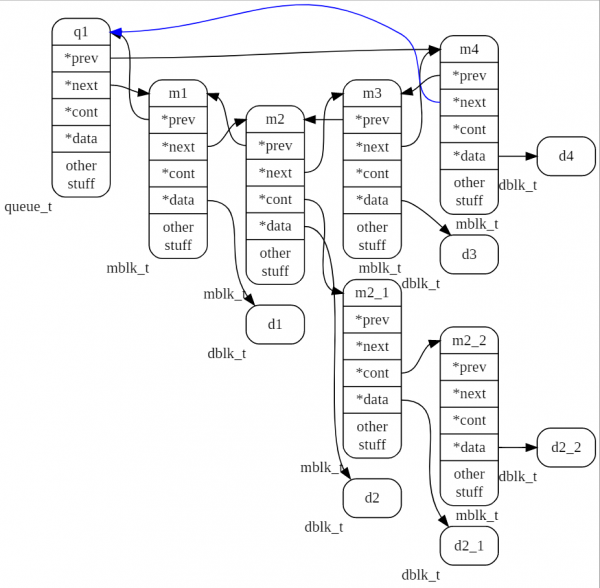
A movimentação de dados no media streamer é realizada através de filas descritas pela estrutura queue_t. Através das filas, movem-se sequências de mensagens do tipo mblk_t, que em si mesmas não contêm dados do sinal, mas apenas referências à mensagem anterior, à próxima mensagem e ao bloco de dados. Além disso, quero enfatizar que há um campo para referência a uma mensagem do mesmo tipo, que permite organizar uma lista encadeada de mensagens. O grupo de mensagens, unidas por essa lista, será chamado de tupla. Assim, qualquer elemento da fila pode ser uma única mensagem mblk_t, ou pode ser a cabeça de uma tupla de mensagens mblk_t. Cada mensagem da tupla pode ter seu próprio bloco de dados associado. A necessidade das tuplas será discutida um pouco mais adiante.
Como mencionado acima, a própria mensagem não contém um bloco de dados; em vez disso, contém apenas um ponteiro para a área de memória onde o bloco é armazenado. Nesta parte, a imagem geral do funcionamento do media streamer lembra um depósito de portas do desenho animado 'Monsters, Inc.', onde as portas (referências aos dados — os quartos) se movem a uma velocidade absurda ao longo de correias transportadoras suspensas, enquanto os próprios quartos permanecem imóveis.
Agora, avançando pela hierarquia de baixo para cima, vamos analisar detalhadamente as entidades mencionadas do mecanismo de transmissão de dados no media streamer.
Bloco de dados dblk_t
Um bloco de dados é composto por um cabeçalho e um buffer de dados. O cabeçalho é descrito pela seguinte estrutura,
typedef struct datab
{
unsigned char *db_base; // Ponteiro para o início do buffer de dados.
unsigned char *db_lim;  // Ponteiro para o final do buffer de dados.
void (*db_freefn)(void*); // Função para liberar memória ao remover o bloco.
int db_ref; // Contador de referências.
} dblk_t;
Os campos da estrutura contêm ponteiros para o início do buffer, o fim do buffer e a função de remoção do buffer de dados. O último elemento no cabeçalho db_ref — é um contador de referências, que, ao atingir zero, serve como sinal para a remoção desse bloco da memória. Se o bloco de dados foi criado pela função datab_alloc() , o buffer de dados será alocado na memória logo após o cabeçalho. Em todos os outros casos, o buffer pode estar localizado em um lugar separado. No buffer de dados estarão os sinais ou outros dados que queremos processar através de filtros.
Uma nova instância do bloco de dados é criada usando a função:
dblk_t *datab_alloc(int size);Como parâmetro de entrada, ela recebe o tamanho dos dados que o bloco armazenará. A memória é alocada maior para que no início da memória alocada seja colocado o cabeçalho — a estrutura datab. Mas ao usar outras funções, isso não acontece sempre; em alguns casos, o buffer de dados pode estar separado do cabeçalho do bloco de dados. Os campos da estrutura são configurados ao criar para que seu campo db_base aponte para o início da área de dados, e db_lim para o seu fim. O contador de referências é configurado para um. O ponteiro da função de limpeza de dados é configurado para zero. db_ref Como foi dito, os elementos da fila têm o tipo
Mensagem mblk_t
mblk_t, ele é definido da seguinte maneira: typedef struct msgb { struct msgb *b_prev; // Ponteiro para o elemento anterior da lista. struct msgb *b_next; // Ponteiro para o próximo elemento da lista. struct msgb *b_cont; // Ponteiro para anexar a mensagem outras mensagens, para criar uma tupla de mensagens. struct datab *b_datap; // Ponteiro para a estrutura do bloco de dados. unsigned char *b_rptr; // Ponteiro para o início da área de dados para ler os dados do buffer b_datap. unsigned char *b_wptr; // Ponteiro para o início da área de dados para gravar os dados do buffer b_datap. uint32_t reserved1; // Campo reservado 1, o media streamer coloca informações de serviço aqui. uint32_t reserved2; // Campo reservado 2, o media streamer coloca informações de serviço aqui. #if defined(ORTP_TIMESTAMP) struct timeval timestamp; #endif ortp_recv_addr_t recv_addr; } mblk_t;
no início contém ponteirosEstrutura mblk_t b_prev b_next, , que são necessários para organizar uma lista duplamente encadeada (que é a filaEm seguida, há um ponteiro queue_t).
b_cont b_cont, que é usado apenas quando a mensagem entra na tupla. Para a última mensagem na tupla, este ponteiro permanece nulo.
Em seguida, vemos um ponteiro para o bloco de dados b_datap, para o qual existe a mensagem. Depois seguem os ponteiros para a área dentro do buffer de dados do bloco. O campo b_rptr indica o local do qual os dados serão lidos do buffer. O campo b_wptr indica o local do qual os dados serão escritos no buffer.
Os campos restantes são de natureza auxiliar e não se relacionam com o funcionamento do mecanismo de transferência de dados.
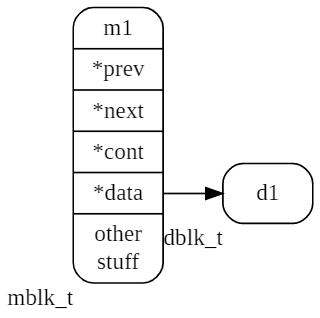
Abaixo está uma mensagem única chamada m1 e um bloco de dados. d1.
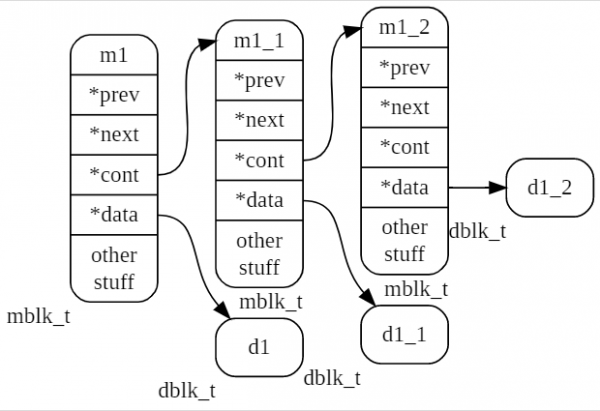
Na próxima figura, é apresentado uma tupla com três mensagens m1, m1_1, m1_2.
As funções para trabalhar com mensagens mblk_t
Uma nova mensagem mblk_t é criada pela função:
mblk_t *allocb(int size, int pri); ela aloca na memória uma nova mensagem mblk_t com um bloco de dados de tamanho especificado tamanho, o segundo argumento — pri não é utilizado na versão da biblioteca em questão. Ele deve permanecer nulo. Durante a execução da função, memória será alocada para a estrutura da nova mensagem e a função mblk_init(), que zerará todos os campos da instância criada da estrutura e, em seguida, com o mencionado acima, datab_alloc()criará o buffer de dados. Depois disso, os campos na estrutura serão configurados:
mp->b_datap=datab;
mp->b_rptr=mp->b_wptr=datab->db_base;
mp->b_next=mp->b_prev=mp->b_cont=NULL;
No final, obtemos uma nova mensagem com os campos inicializados e um buffer de dados vazio. Para adicionar dados à mensagem, é necessário copiá-los para o buffer do bloco de dados:
memcpy(msg->b_rptr, data, size);onde data — é o ponteiro para a fonte de dados, e tamanho — é o seu tamanho.
Em seguida, precisamos atualizar o ponteiro da posição de gravação para que ele aponte novamente para o início da área livre no buffer:
msg->b_wptr = msg->b_wptr + sizeSe for necessário criar uma mensagem a partir de um buffer já existente, sem cópia, usa-se a função:
mblk_t *esballoc(uint8_t *buf, int size, int pri, void (*freefn)(void*)); A função, após criar a mensagem e a estrutura do bloco de dados, ajustará seus ponteiros para os dados no endereço buf. Ou seja, neste caso, o buffer de dados não está localizado imediatamente após os campos do cabeçalho do bloco de dados, como foi ao criar o bloco de dados pela função. datab_alloc()O buffer de dados passado para a função permanecerá onde estava, mas, com a ajuda dos ponteiros, será acionado para o cabeçalho de bloco de dados recém-criado, que, por sua vez, se conectará à mensagem.
A uma mensagem mblk_t podem ser anexados vários blocos de dados sequencialmente. Isso é feito pela função:
mblk_t * appendb(mblk_t *mp, const char *data, int size, bool_t pad); mp — é a mensagem à qual um novo bloco de dados será adicionado;
data — é um ponteiro para o bloco, cuja cópia será adicionada à mensagem;
tamanho — é o tamanho dos dados;
pad — é um sinalizador indicando que o tamanho da memória alocada deve ser alinhado a um limite de 4 bytes (a complementação será feita com zeros).
Se houver espaço suficiente no buffer de dados da mensagem, os novos dados serão anexados após os dados já existentes. Se o espaço livre no buffer de dados da mensagem for menor que tamanho, uma nova mensagem é criada, com um tamanho de buffer suficiente, e os dados são copiados para seu buffer. Essa nova mensagem é anexada à original por meio de um ponteiro. b_contNesse caso, a mensagem se transforma em uma tupla.
Se for necessário adicionar mais um bloco de dados à tupla, deve-se usar a função:
void msgappend(mblk_t *mp, const char *data, int size, bool_t pad);ela localizará a última mensagem na tupla (esta terá b_cont como nula) e chamará a função appendb().
Para saber o tamanho dos dados em uma mensagem ou tupla, pode-se usar a função:
int msgdsize(const mblk_t *mp);ela percorrerá todas as mensagens da tupla e retornará a quantidade total de dados nos buffers de dados dessas mensagens. Para cada mensagem, a quantidade de dados é calculada assim:
mp->b_wptr - mp->b_rptrPara combinar duas tuplas, usa-se a função:
mblk_t *concatb(mblk_t *mp, mblk_t *newm);ela anexa a tupla newm ao final da tupla mp e retorna um ponteiro para a última mensagem da tupla resultante.
Se necessário, a tupla pode ser convertida em uma única mensagem com um único bloco de dados, isso é feito pela função:
void msgpullup(mblk_t *mp,int len);se o argumento len for igual a -1, o tamanho do buffer alocado é determinado automaticamente. Se len Se um número positivo for fornecido, um buffer desse tamanho será criado e os dados das mensagens da tupla serão copiados para ele. Se o buffer acabar, a cópia será interrompida. A primeira mensagem da tupla receberá um buffer do novo tamanho com os dados copiados. As demais mensagens serão descartadas e a memória será retornada ao heap.
Ao remover a estrutura mblk_t é levado em conta o contador de referências do bloco de dados, se ao chamar freeb() ele for igual a zero, o buffer de dados é removido junto com a instância mblk_t, que aponta para ele.
Inicialização dos campos da nova mensagem:
void mblk_init(mblk_t *mp);Adicionando mais uma porção de dados à mensagem:
mblk_t * appendb(mblk_t *mp, const char *data, size_t size, bool_t pad);Se os novos dados não couberem no espaço livre do buffer de dados da mensagem, uma mensagem criada separadamente com um buffer do tamanho necessário será anexada à mensagem (o ponteiro para a mensagem adicionada é estabelecido na primeira mensagem) e a mensagem se transforma em uma tupla.
Adicionando uma porção de dados à tupla:
void msgappend(mblk_t *mp, const char *data, size_t size, bool_t pad); A função chama appendb() em um loop.
Unindo duas tuplas em uma:
mblk_t *concatb(mblk_t *mp, mblk_t *newm);Mensagem newm será anexado a mp.
Criando uma cópia de uma única mensagem:
mblk_t *copyb(const mblk_t *mp);Cópia completa da tupla com todos os blocos de dados:
mblk_t *copymsg(const mblk_t *mp);Os elementos da tupla são copiados pela função copyb().
Criando uma cópia leve da mensagem. mblk_tNesse caso, o bloco de dados não é copiado, mas seu contador de referências é incrementado. db_ref:
mblk_t *dupb(mblk_t *mp);Criando uma cópia leve da tupla. Os blocos de dados não são copiados, apenas seus contadores de referências são incrementados. db_ref:
mblk_t *dupmsg(mblk_t* m);Unindo todas as mensagens da tupla em uma só mensagem:
void msgpullup(mblk_t *mp,size_t len);Se o argumento len for igual a -1, o tamanho do buffer reservado é determinado automaticamente.
Removendo a mensagem, a tupla:
void freemsg(mblk_t *mp);O contador de referências do bloco de dados é decrementado em uma unidade. Se atingir zero, o bloco de dados também é removido.
Contando o volume total de dados na mensagem ou tupla.
size_t msgdsize(const mblk_t *mp);Extraindo uma mensagem do final da fila:
mblk_t *ms_queue_peek_last (q);Copiando o conteúdo dos campos reservados de uma mensagem para outra (na verdade, esses campos contêm bandeiras que são usadas pelo media streamer):
mblk_meta_copy(const mblk_t *source, mblk *dest);Fila queue_t
A fila de mensagens no media streamer é implementada como uma lista duplamente encadeada circular. Cada elemento da lista contém um ponteiro para um bloco de dados com as contagens de sinal. Isso significa que apenas os ponteiros para o bloco de dados se movem, enquanto os próprios dados permanecem imóveis. Ou seja, apenas as referências a eles se movem.
Estrutura que descreve a fila queue_t, mostrada abaixo:
typedef struct _queue
{
   mblk_t _q_stopper; /* "Elemento vazio" da fila, não aponta para dados, usado apenas para gerenciar a fila. Ao inicializar a fila (qinit()), seus ponteiros são configurados para apontar para si mesmos. */
   int q_mcount;        // Número de elementos na fila.
} queue_t;
A estrutura contém um campo — um ponteiro _q_stopper do tipo *mblk_t, que aponta para o primeiro elemento (mensagem) na fila. O segundo campo da estrutura é um contador de mensagens que estão na fila.
Na figura abaixo, é mostrada a fila com o nome q1, contendo 4 mensagens m1, m2, m3, m4.
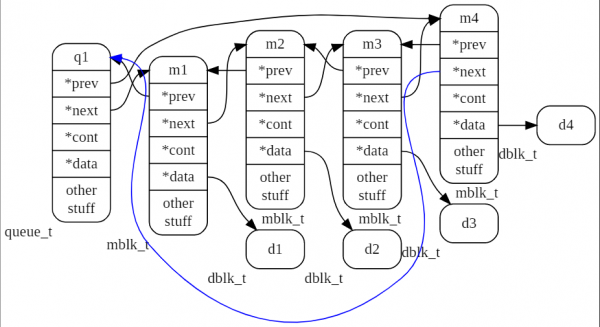
Na próxima figura, é mostrada a fila com o nome q1, contendo 4 mensagens m1, m2, m3, m4. A mensagem m2 é o cabeçalho da tupla, que também inclui outras duas mensagens m2_1 e m2_2.
Funções de operação com filas queue_t
Inicialização da fila:
void qinit(queue_t *q);Campo _q_stopper (daqui em diante, chamaremos de "stopper") é inicializado pela função mblk_init(), seu ponteiro do elemento anterior e do próximo elemento são configurados para apontar para ele mesmo. O contador de elementos da fila é zerado.
Adicionando um novo elemento (mensagem):
void putq(queue_t *q, mblk_t *m);Um novo elemento m é adicionado ao final da lista, os ponteiros do elemento são configurados para que o stopper se torne o próximo elemento para ele, e ele para o stopper, o contador de elementos na fila é incrementado.
Extraindo um elemento da fila:
mblk_t * getq(queue_t *q); é extraída a mensagem que está após o stopper, o contador de elementos é decrementado. Se não houver elementos na fila além do stopper, retorna-se 0.
Inserindo uma mensagem na fila:
void insq(queue_t *q, mblk_t *emp, mblk_t *mp); Elemento mp é inserido antes do elemento emp. Se emp=0, então a mensagem é adicionada ao final da fila.
Extraindo a mensagem do cabeçalho da fila:
void remq(queue_t *q, mblk_t *mp); O contador de elementos é decrementado.
Lendo o ponteiro para o primeiro elemento na fila:
mblk_t * peekq(queue_t *q); Removendo todos os elementos da fila junto com os próprios elementos:
void flushq(queue_t *q, int how);Argumento how não usado. O contador de elementos da fila é definido como zero.
Macro para ler o ponteiro do último elemento da fila:
mblk_t * qlast(queue_t *q);Ao trabalhar com filas de mensagens, deve-se ter em mente que ao chamar ms_queue_put(q, m) com um ponteiro nulo para a mensagem, a função entra em loop. Seu programa ficará travado. O mesmo comportamento é observado com ms_queue_next(q, m).
Conexão de filtros
A fila descrita acima é usada para transmitir mensagens de um filtro para outro ou de um para vários filtros. Os filtros e suas conexões formam um gráfico direcionado. A entrada ou saída de um filtro será designada pelo termo genérico "pino". Para descrever a ordem das conexões entre os filtros, utiliza-se o conceito de "ponto de sinal". Um ponto de sinal é uma estrutura _MSCPoint, que contém um ponteiro para o filtro e o número de um de seus pinos, descrevendo assim a conexão de uma das entradas ou saídas do filtro.
Ponto de sinal do grafo de processamento de dados
typedef struct _MSCPoint{
struct _MSFilter *filter; // Ponteiro para o filtro do mediastreamer.
int pin;                        // Número de uma das entradas ou saídas do filtro, ou seja, pino.
} MSCPoint;
Os pinos dos filtros são numerados a partir de zero.
A conexão de dois pinos através de uma fila de mensagens é descrita pela estrutura _MSQueue, que contém a fila de mensagens e ponteiros para dois pontos de sinal que ela conecta:
typedef struct _MSQueue
{
queue_t q;
MSCPoint prev;
MSCPoint next;
}MSQueue;
Chamaremos essa estrutura de link de sinal. Cada filtro do mediastreamer contém uma tabela de links de entrada e uma tabela de links de saída (MSQueue). O tamanho das tabelas é definido na criação do filtro, como já fizemos com a variável exportada do tipo MSFilterDesc, ao desenvolver nosso próprio filtro. Abaixo está a estrutura que descreve qualquer filtro no mediastreamer, MSFilter:
struct _MSFilter{
    MSFilterDesc *desc;
    /* Pointer to the filter descriptor. */
    /* Protected attributes, they cannot be moved or removed otherwise plugin operation will be disrupted. */
    ms_mutex_t lock;      /* Semaphore. */
    MSQueue **inputs;     /* Table of input links. */
    MSQueue **outputs;    /* Table of output links. */
    struct _MSFactory *factory; /* Pointer to the factory that created this filter instance. */
    void *padding;              /* Not used, will be engaged if protected fields are added. */
    void *data;                 /* Pointer to an arbitrary structure for storing filter's internal state data and intermediate computations. */
    struct _MSTicker *ticker;   /* Pointer to the ticker object, which must not be null when process() function is called. */
    /* private attributes, they can be moved and changed at any time */
    MSList *notify_callbacks; /* List of callbacks used to handle filter events. */
    uint32_t last_tick;       /* Number of the last tick when process() was called. */
    MSFilterStats *stats;     /* Statistics of the filter's operation. */
    int postponed_task; /* Number of postponed tasks. Some filters may delay data processing (calling process()) for several ticks. */
    bool_t seen;  /* A flag that the ticker uses to mark that this filter instance has already been serviced in this tick. */
};
typedef struct _MSFilter MSFilter;
Depois que conectamos os filtros em nosso programa em C de acordo com nosso plano (mas não conectamos o ticker), criamos um gráfico direcionado, cujos nós são instâncias da estrutura MSFilter, e as arestas são instâncias de links MSQueue.
Atividades nos bastidores do ticker
Quando eu disse que o ticker é um filtro fonte de ticks, não era toda a verdade sobre ele. O ticker é um objeto que executa funções em intervalos regulares process() de todos os filtros do esquema (grafo) ao qual está conectado. Quando conectamos o ticker ao filtro do grafo em nosso programa em C, mostramos ao ticker o grafo que ele irá gerenciar a partir desse momento, até que o desconectemos. Após a conexão, o ticker começa a inspecionar o grafo sob sua responsabilidade, compilando uma lista de filtros que nele estão incluídos. Para não "contar" o mesmo filtro duas vezes, ele marca os filtros detectados, definindo uma flag seen. A busca é realizada nas tabelas de links, que existem em cada filtro.
Durante sua excursão de introdução ao gráfico, o ticker verifica se há entre os filtros pelo menos um que funciona como fonte de blocos de dados. Se nenhum for encontrado, o gráfico é considerado inválido e o ticker encerra sua operação de forma abrupta.
Se o gráfico se mostrou "válido", para cada filtro encontrado, a função é chamada para inicialização. preprocess(). Assim que chega o momento do próximo ciclo de processamento (por padrão a cada 10 milissegundos), o ticker chama a função. process() para todos os filtros de origem encontrados anteriormente, e depois para os outros filtros da lista. Se um filtro tem links de entrada, o início da função. process() se repete até que as filas de links de entrada estejam vazias. Depois disso, ele passa para o próximo filtro da lista e "rolls" até que os links de entrada sejam liberados de mensagens. O ticker passa de filtro para filtro até que a lista termine. Assim, o processamento do ciclo termina.
Agora vamos voltar às tuplas e discutir a razão pela qual tal entidade foi adicionada ao media streamer. De maneira geral, o volume de dados necessário para o algoritmo que opera dentro do filtro não coincide e não é múltiplo do tamanho dos buffers de dados que entram. Por exemplo, estamos escrevendo um filtro que realiza uma rápida transformação de Fourier, que por definição pode processar apenas blocos de dados cujo tamanho é uma potência de dois. Vamos considerar 512 amostras. Se os dados são gerados por um canal telefônico, o buffer de dados de cada mensagem de entrada nos trará 160 amostras do sinal. Há uma tentação de não retirar dados da entrada até que haja a quantidade necessária de dados. Mas nesse caso, haverá uma colisão com o ticker, que tentará, sem sucesso, passar o filtro até que a fila de entrada se esvazie. Anteriormente, nomeamos essa regra como o terceiro princípio de operação do filtro. De acordo com esse princípio, a função process() do filtro deve retirar todos os dados das filas de entrada.
Além disso, não será possível retirar apenas 512 amostras na entrada, pois a coleta deve ser feita em blocos inteiros, ou seja, o filtro deverá coletar 640 amostras e, utilizando 512 delas, manter o restante até acumular uma nova porção de dados. Assim, nosso filtro, além de seu trabalho principal, deve garantir ações auxiliares para o armazenamento intermediário dos dados de entrada. Os desenvolvedores do mediastreamer e a solução dessa tarefa geral criaram um objeto especial — MSBufferizer (bufferizador), que resolve essa questão através de tuplas.
Bufferizador (MSBufferizer)
Este é um objeto que irá acumular os dados de entrada dentro do filtro e começará a enviá-los para processamento assim que a quantidade de informações for suficiente para executar o algoritmo do filtro. Enquanto o bufferizador acumula dados, o filtro funcionará em modo ocioso, sem utilizar o poder computacional do processador. Mas assim que a função de leitura do bufferizador retornar um valor diferente de zero, a função process() do filtro começará a retirar e processar os dados do bufferizador em porções do tamanho necessário, até sua exaustão.
Os dados que ainda não foram utilizados permanecem no bufferizador como o primeiro elemento da tupla, ao qual se conectam os blocos subsequentes de dados de entrada.
Estrutura que descreve o bufferizador:
struct _MSBufferizer{
queue_t q; /* Fila de mensagens. */
int size; /* Tamanho total dos dados atualmente no bufferizador. */
};
typedef struct _MSBufferizer MSBufferizer;
Funções de operação com MSBufferizer
Criação de uma nova instância do bufferizador:
MSBufferizer * ms_bufferizer_new(void);Memória é alocada, inicializada em ms_bufferizer_init() e um ponteiro é retornado.
Função de inicialização:
void ms_bufferizer_init(MSBufferizer *obj); A fila q, campo tamanho é inicializada em zero.
Adicionando mensagem:
void ms_bufferizer_put(MSBufferizer *obj, mblk_t *m); A mensagem m é adicionada à fila. O tamanho calculado dos blocos de dados é acrescido a tamanho.
Transfere todos os mensagens da fila de dados do link para o bufferizador q:
void ms_bufferizer_put_from_queue(MSBufferizer *obj, MSQueue *q); A transferência das mensagens do link q para o bufferizador é realizada com a função ms_bufferizer_put().
Lendo do bufferizador:
int ms_bufferizer_read(MSBufferizer *obj, uint8_t *data, int datalen); Se o tamanho dos dados acumulados no bufferizador for menor que o solicitado (datalen), a função retorna zero, a cópia de dados em data não é realizada. Caso contrário, a cópia de dados é feita sequencialmente a partir das tuplas no buffer. Após a cópia, a tupla é removida e a memória é liberada. A cópia é encerrada no momento em que datalen bytes forem copiados. Se o espaço terminar no meio de um bloco de dados, este bloco será encurtado para a parte restante não copiada. Na próxima chamada, a cópia continuará a partir desse ponto.
Lendo a quantidade de dados disponíveis no momento no buffer:
int ms_bufferizer_get_avail(MSBufferizer *obj); Retorna o campo tamanho do buffer.
Descarte de parte dos dados no buffer:
void ms_bufferizer_skip_bytes(MSBufferizer *obj, int bytes);A quantidade especificada de bytes de dados é extraída e descartada. Os dados mais antigos são descartados.
Remoção de todas as mensagens no buffer:
void ms_bufferizer_flush(MSBufferizer *obj); O contador de dados é redefinido para zero.
Remoção de todas as mensagens no buffer:
void ms_bufferizer_uninit(MSBufferizer *obj); A reinicialização do contador não é realizada.
Remoção do buffer e liberação de memória:
void ms_bufferizer_destroy(MSBufferizer *obj); Exemplos de uso do buffer podem ser encontrados no código fonte de vários filtros de mídia streaming. Por exemplo, no filtro MS_L16_ENC, que realiza a reordenação de bytes nas amostras da ordem de rede para a ordem do host:
No próximo artigo, discutiremos a questão da avaliação da carga sobre o ticker e as maneiras de combater a carga computacional excessiva no mediastreamer.
Fonte: habr.com
