

Olá a todos. Aqui é Vladislav Rodin. Atualmente, sou o responsável pelo curso "Arquiteto de Alta Carga" na OTUS e também dou aulas em cursos dedicados à arquitetura de software.
Além de lecionar, como vocês podem notar, também escrevo material autoral para o blog da OTUS no Habr, e hoje quero dedicar este artigo ao lançamento do curso , para o qual as inscrições estão abertas no momento.
Introdução
Em Nós conversamos sobre como as transações em bancos de dados servem para resolver duas tarefas: garantir a tolerância a falhas e o acesso a dados em um ambiente concorrente. Para realizar completamente essas tarefas, uma transação deve ter propriedades ACID. Hoje, falaremos detalhadamente sobre a letra I (isolamento) nesta sigla.
Isolamento
O isolamento resolve a tarefa de acesso a dados em um ambiente concorrente, na verdade oferecendo proteção contra condições de corrida. Idealmente, o isolamento significa serialização, ou seja, uma propriedade que garante que o resultado da execução de transações em paralelo seja o mesmo que se fossem executadas sequencialmente. O principal problema dessa propriedade é que é muito difícil de ser garantida tecnicamente e, como consequência, afeta bastante o desempenho do sistema. É por isso que o isolamento é frequentemente relaxado, aceitando os riscos de algumas anomalias, sobre as quais falaremos a seguir. A possibilidade de surgimento de certas anomalias caracteriza exatamente o nível de isolamento das transações.
As anomalias mais conhecidas são: leitura suja, leitura não repetível, leitura fantasma, mas na verdade existem mais 5: escrita suja, atualização de cursor perdida, atualização perdida, viés de leitura, viés de escrita.
Escrita suja
A essência da anomalia é que transações podem sobrescrever dados não confirmados.
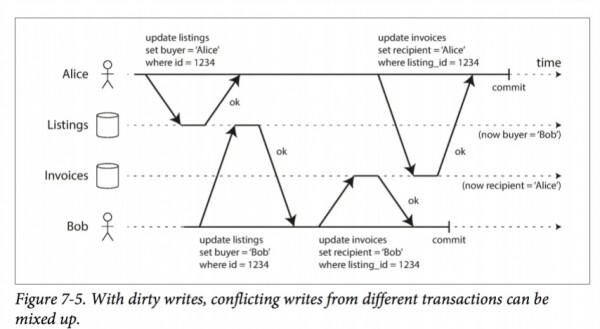
Essa anomalia é perigosa não apenas porque os dados podem entrar em conflito após o commit de ambas as transações (como na imagem), mas também porque quebra a atomicidade: ao permitir sobrescrever dados não confirmados, não está claro como reverter uma transação sem afetar a outra.
A anomalia é tratada de maneira relativamente simples: colocamos um bloqueio na escrita antes do início da gravação, impedindo que outras transações modifiquem a gravação até que o bloqueio seja removido.
Leitura suja
Leitura suja significa ler dados não confirmados.
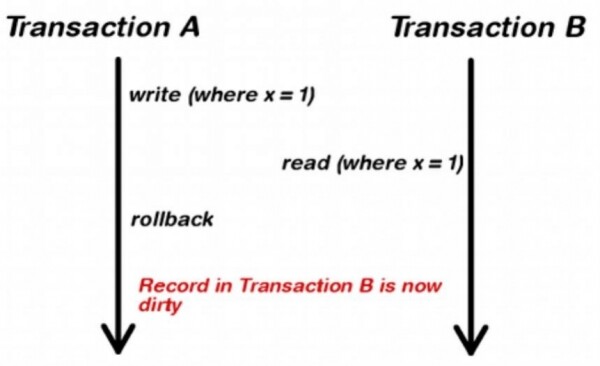
Problemas surgem quando é necessário realizar alguma ação ou tomar decisões com base em uma amostra.
Para corrigir a anomalia, pode-se aplicar um bloqueio de leitura, mas isso afetará bastante o desempenho. É muito mais simples dizer que, para o rollback da transação, o estado original dos dados (antes do início da gravação) deve necessariamente ser salvo no sistema. Por que não ler daí? Isso é bastante acessível, portanto, a maioria dos bancos de dados desativa a leitura suja por padrão.
Atualização perdida
Atualização perdida refere-se a atualizações perdidas, e a tradução reflete com bastante precisão a essência do problema:
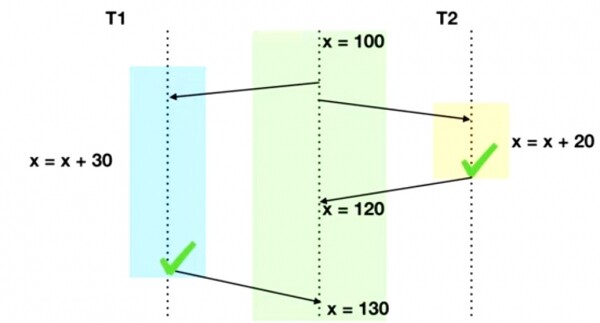
Na prática, o resultado da transação T2 foi cancelado. Essa situação é corrigida com bloqueios explícitos ou implícitos de registro. Ou seja, ou simplesmente realizamos a atualização do registro, e, nesse caso, ocorre um bloqueio implícito, ou executamos select for update, causando um bloqueio de leitura e gravação. Note que essa operação é bastante perigosa: com nossa leitura "inocente", bloqueamos outras leituras. Alguns bancos oferecem uma opção mais segura, select for share, que permite ler os dados, mas não permite modificá-los.
Atualização de cursor perdida
Para um controle mais fino, os bancos podem oferecer outras ferramentas, como cursores. Um cursor é uma estrutura que contém um conjunto de linhas e permite iterar sobre elas. declare cursor_name for select_statement. O conteúdo do cursor é descrito pelo select.
Qual é a finalidade do cursor? A questão é que alguns bancos de dados oferecem bloqueio em todos os registros selecionados pelo select (estabilidade de leitura), ou apenas no registro em que o cursor está atualmente (estabilidade de cursor). Com a estabilidade de cursor, realiza-se um bloqueio curto, o que ajuda a reduzir o número de bloqueios caso estejamos iterando sobre uma grande amostra de dados. Por isso, a anomalia de atualização perdida é destacada separadamente para o cursor.
Leitura não repetível
Leitura não repetível implica que, durante a execução da nossa transação, 2 leituras consecutivas de um mesmo registro resultarão em diferentes resultados, porque outra transação interferiu entre essas duas leituras, alterou nossos dados e foi confirmada.
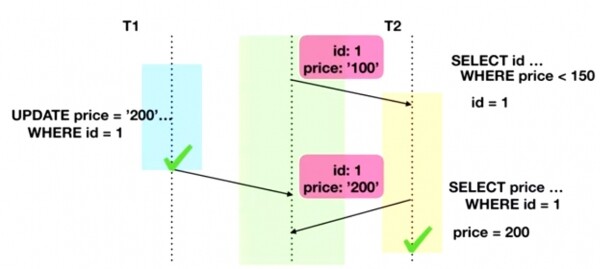
Por que isso é um problema? Imagine que o objetivo da transação T2 na imagem é selecionar todos os produtos cujo preço é inferior a 150 u.e. Alguém atualizou o preço para 200 u.e. Assim, o filtro estabelecido não funcionou.
Essas anomalias param de ocorrer com a adição de bloqueios em duas fases ou com o uso do mecanismo MVCC, sobre o qual gostaria de falar separadamente.
Leitura fantasma
Chama-se leitura fantasma a leitura de dados que foram adicionados por outra transação.
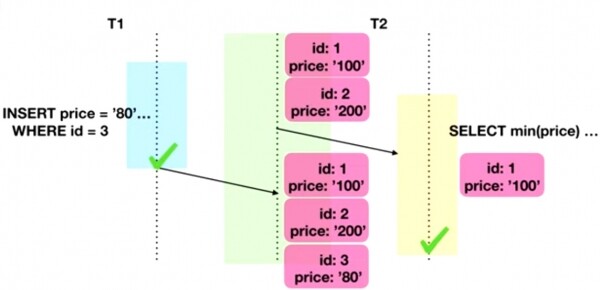
Como exemplo, podemos observar a seleção incorreta do produto mais barato ao ocorrer essa anomalia.
Eliminar as leituras fantasmas é bastante difícil. Um bloqueio comum não é suficiente, pois não podemos bloquear o que ainda não existe. Os sistemas 2PL utilizam bloqueio preditivo, enquanto os sistemas MVCC cancelam transações que podem ser violadas por inserções. Ambos os mecanismos são relativamente pesados.
Desvio de leitura
O desvio de leitura ocorre quando trabalhamos com várias tabelas, cujo conteúdo deve mudar consistentemente.
Suponha que existam tabelas representando posts e suas metainformações:
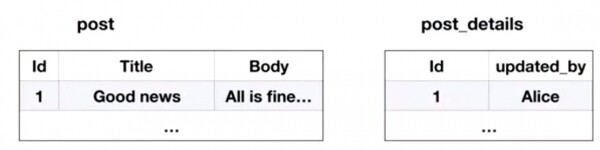
Uma transação lê das tabelas, enquanto outra as modifica:
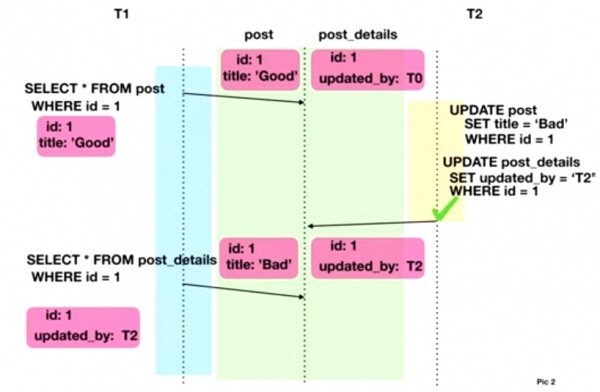
Como resultado da execução da transação T1, o post title = Good, e updated_by = T2, o que apresenta uma certa inconsistência.
Na verdade, isso é uma leitura não repetível, mas envolvendo várias tabelas.
Para corrigir isso, T1 pode aplicar bloqueios em todas as linhas que irá ler, impedindo a transação T2 de alterar as informações. No caso do MVCC, a transação T2 será cancelada. A proteção contra essa anomalia pode se tornar importante se utilizarmos cursores.
Desvio de escrita
Esta anomalia também é mais fácil de explicar com um exemplo: suponha que em nosso sistema pelo menos um médico deve estar de plantão, mas ambos os médicos decidiram cancelar seu plantão:
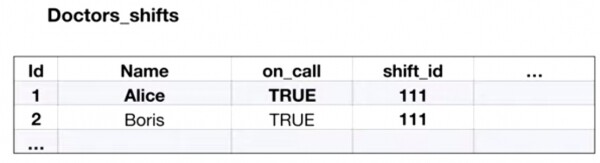
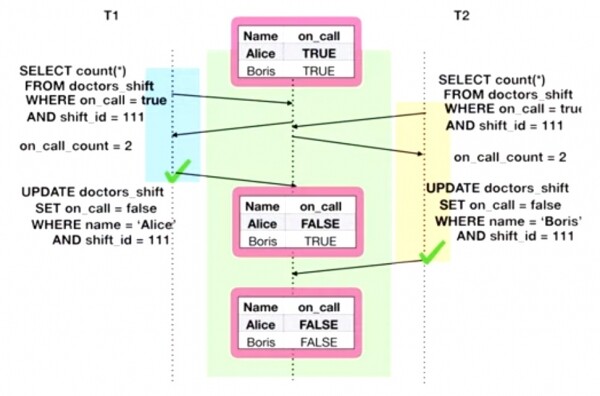
A anomalia levou ao fato de que nenhum dos médicos comparecerá ao plantão. Por que isso ocorreu? Porque a transação verificou uma condição que pode ser violada por outra transação, e devido à isolação, não vimos essa alteração.
Isso é o mesmo que uma leitura não repetível. Como uma alternativa, as seleções podem aplicar bloqueios nesses registros.
Write skew e read skew são combinações das anomalias anteriores. Podemos considerar write skew, que é essencialmente uma leitura fantasma. Vamos considerar uma tabela que contém nomes de funcionários, seus salários e o projeto em que estão trabalhando:
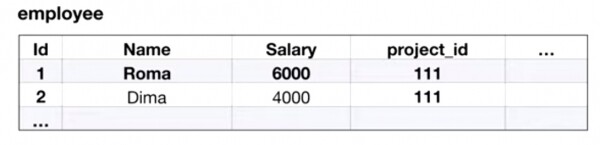
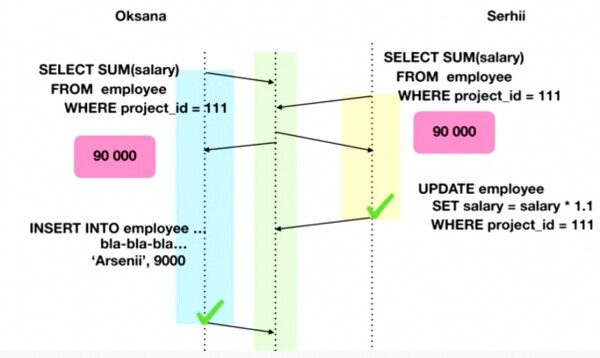
No final, obtemos o seguinte cenário: cada gerente pensava que sua mudança não levaria a um estouro do orçamento, portanto, fizeram alterações de pessoal que, no total, levaram a um excesso de gastos.
A causa do problema é exatamente a mesma que a da leitura fantasma.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
A diminuição do nível de isolamento de transações em um banco de dados é um compromisso entre segurança e desempenho; essa escolha deve ser feita com base nos riscos potenciais para os negócios diante de determinadas anomalias.
Fonte: habr.com
