

Bem-vindo, Habr!
Em seu tempo, fomos os primeiros a lançar o tema e continuamos a desenvolvê-lo. Em particular, achamos interessante o tema da interação entre Kafka e . Um artigo introdutório (e bastante cauteloso) sobre o assunto foi publicado no blog da Confluent em outubro do ano passado, sob a autoria de Gwen Shapiro. Hoje, queremos chamar sua atenção para um artigo mais recente, de abril, de Johann Gyger, que, embora tenha usado um ponto de interrogação no título, aborda o tema de forma mais concreta, acompanhando o texto com links interessantes. Pedimos desculpas pela tradução livre de "chaos monkey", se puderem!
Introdução
O Kubernetes é projetado para trabalhar com cargas de trabalho sem estado. Geralmente, essas cargas são apresentadas na forma de uma arquitetura de microsserviços, sendo leves, bem escaláveis horizontalmente, obedecendo aos princípios de aplicativos de 12 fatores, permitindo o uso de disjuntores automáticos (circuit breaker) e macacos do caos (chaos monkeys).
O Kafka, por outro lado, atua essencialmente como um banco de dados distribuído. Assim, ao trabalhar, você precisa lidar com o estado, que é muito mais pesado do que um microsserviço. O Kubernetes suporta cargas de trabalho com estado, mas, como aponta Kelsey Hightower em dois de seus tweets, deve-se ter cautela com elas:
Alguns acreditam que, ao aplicar o Kubernetes em uma carga de trabalho com estado, ele se transforma em um banco de dados totalmente gerenciado capaz de competir com o RDS. Isso não é verdade. Pode ser que, se esforçar bastante, adicionar componentes adicionais e envolver uma equipe de engenheiros SRE, seja possível configurar o RDS sobre o Kubernetes.
Sempre recomendo extrema cautela ao executar cargas de trabalho com estado no Kubernetes. A maioria daqueles que se perguntam: "posso executar cargas de trabalho com estado no Kubernetes?" não possui experiência suficiente com Kubernetes, muitas vezes nem mesmo com a carga sobre a qual estão perguntando.
Então, devemos executar o Kafka no Kubernetes? Uma pergunta de retorno: será que o Kafka funcionaria melhor sem o Kubernetes? É por isso que quero enfatizar neste artigo como Kafka e Kubernetes se complementam e quais armadilhas podem surgir ao combiná-los.
Tempo de Execução
Vamos falar sobre algo básico — o ambiente de tempo de execução como um todo.
Processo
Os brokers do Kafka são convenientes ao trabalhar com CPU. O TLS pode trazer alguns custos. No entanto, os clientes do Kafka podem sobrecarregar mais a CPU se utilizarem criptografia, mas isso não afeta os brokers.
Memória
Os brokers do Kafka consomem muita memória. O tamanho máximo da heap do JVM geralmente deve ser limitado a 4-5 GB, mas você também precisará de bastante memória do sistema, já que o Kafka utiliza muito o cache de disco. No Kubernetes, defina adequadamente os limites de recursos e as solicitações do contêiner.
Armazenamento de dados
O armazenamento de dados em contêineres é efêmero — os dados se perdem na reinicialização. Para os dados do Kafka, você pode usar um volume emptyDir, e o efeito será semelhante: os dados do seu broker serão perdidos após a finalização. Suas mensagens ainda podem ser preservadas em outros brokers como réplicas. Portanto, após a reinicialização, o broker que falhou deve primeiro replicar todos os dados, e esse processo pode levar um tempo considerável.
É por isso que você deve usar um armazenamento de dados durável. Deve ser um armazenamento durável não local com sistema de arquivos XFS ou, mais precisamente, ext4. Não use NFS. Eu avisei. NFS nas versões v3 ou v4 não funcionará. Em resumo, o broker Kafka irá falhar se não conseguir excluir um diretório de dados devido a um problema de 'renomeações problemáticas' que ocorre no NFS. Se ainda não o convenci, preste muita atenção . O armazenamento de dados deve ser não local, para que o Kubernetes possa escolher um novo nó com mais flexibilidade após a reinicialização ou realocação.
Rede
Assim como em muitos sistemas distribuídos, o desempenho do Kafka depende muito de minimizar as latências da rede e maximizar a largura de banda. Não tente colocar todos os brokers em um único nó, pois isso reduzirá a disponibilidade. Se um nó do Kubernetes falhar, todo o cluster Kafka também falhará. Da mesma forma, não espalhe o cluster Kafka por datacenters inteiros. O mesmo se aplica ao cluster Kubernetes. Um bom compromisso, neste caso, é escolher diferentes zonas de disponibilidade.
Configuração
Manifests comuns
No site do Kubernetes, há sobre como configurar o ZooKeeper usando manifests. Como o ZooKeeper faz parte do Kafka, é conveniente começar por aqui para entender quais conceitos do Kubernetes são aplicáveis. Depois de entender isso, você poderá aplicar os mesmos conceitos ao cluster Kafka.
- Por: um Pod é a menor unidade que pode ser implantada no Kubernetes. O pod contém sua carga de trabalho, e o próprio pod corresponde a um processo no seu cluster. O pod contém um ou mais contêineres. Cada servidor ZooKeeper no conjunto e cada broker no cluster Kafka funcionarão em um pod separado.
- StatefulSet: StatefulSet é um objeto do Kubernetes que trabalha com múltiplas cargas de trabalho que mantêm estados, e tais cargas exigem coordenação. StatefulSets oferecem garantias em relação à ordenação dos pods e à sua exclusividade.
- Serviços sem cabeça: os serviços permitem desacoplar os pods dos clientes usando um nome lógico. O Kubernetes é responsável pelo balanceamento de carga nesse caso. No entanto, ao lidar com cargas de trabalho que mantêm estado, como no caso do ZooKeeper e Kafka, os clientes precisam se comunicar com uma instância específica. É aqui que os serviços sem cabeça são úteis: nesse caso, o cliente ainda terá um nome lógico, mas não precisará se conectar diretamente ao pod.
- Volume para armazenamento persistente: esses volumes são necessários para configurar o armazenamento em bloco persistente não local mencionado acima.
Sobre fornece um conjunto abrangente de manifests que facilita o início do trabalho com Kafka no Kubernetes.
Diagramas Helm
Helm é um gerenciador de pacotes para Kubernetes, comparável a gerenciadores de pacotes para sistemas operacionais, como yum, apt, Homebrew ou Chocolatey. Com ele, é fácil instalar pacotes de software predefinidos, descritos nos gráficos do Helm. Um gráfico bem elaborado do Helm facilita a tarefa complexa de como configurar corretamente todos os parâmetros para usar o Kafka no Kubernetes. Existem vários gráficos do Kafka: o oficial está , há um de , e outro de .
Operadores
Devido a certas desvantagens do Helm, ganha popularidade uma outra ferramenta: operadores do Kubernetes. Um operador não apenas empacota software para Kubernetes, mas também permite que você implemente e gerencie esse software.
Na lista são mencionados dois operadores para Kafka. Um deles é . Com o Strimzi, é fácil criar um cluster Kafka em questão de minutos. Quase nenhuma configuração é necessária, além do mais, o próprio operador oferece algumas funcionalidades interessantes, como a criptografia TLS ponto a ponto dentro do cluster. A Confluent também fornece .
Desempenho
É muito importante testar o desempenho, fornecendo pontos de controle para sua instância Kafka instalada. Esses testes ajudarão você a descobrir gargalos potenciais antes que os problemas comecem. Felizmente, o Kafka já oferece duas ferramentas para testar desempenho: kafka-producer-perf-test.sh e kafka-consumer-perf-test.sh. Utilize-as ativamente. Para referência, você pode comparar com os resultados descritos em Jay Kreps, ou se orientar por Amazon MSK de Stéphane Maarek.
Operações
Monitoramento
A transparência no sistema é muito importante – caso contrário, você não entenderá o que está acontecendo. Atualmente, existe um sólido conjunto de ferramentas que garante monitoramento baseado em métricas no estilo cloud native. Dois ferramentas populares para esse fim são Prometheus e Grafana. O Prometheus pode coletar métricas de todos os processos Java (Kafka, Zookeeper, Kafka Connect) usando um exportador JMX – da maneira mais simples. Se você adicionar as métricas do cAdvisor, será possível ter uma visão mais completa de como os recursos são utilizados no Kubernetes.
O Strimzi possui um exemplo muito conveniente de painel Grafana para Kafka. Ele visualiza métricas-chave, como as sobre setores com pouca replicação ou aqueles que estão offline. Tudo é muito claro. Essas métricas são complementadas por informações sobre o uso de recursos e desempenho, além de indicadores de estabilidade. Dessa forma, você obtém monitoramento básico do cluster Kafka sem custo algum!
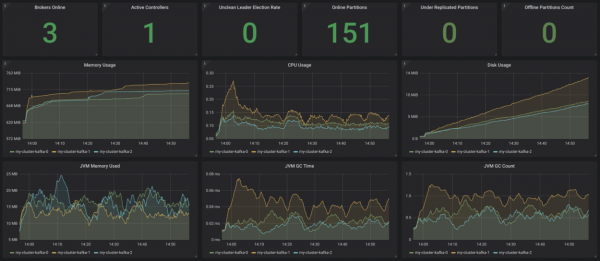
Fonte:
Tudo isso seria bem complementado com o monitoramento de clientes (métricas de consumidores e produtores), bem como o monitoramento de latência (para isso há ) e monitoramento de ponta a ponta - para isso utilize .
Registro
A gravação de logs é mais uma tarefa crucial. Certifique-se de que todos os containers na sua instalação do Kafka estejam registrando logs em stdout e stderr, e também garanta que seu cluster Kubernetes agregue todos os logs em uma infraestrutura de registro centralizada, como .
Verificação de integridade
O Kubernetes utiliza sondas de "vitalidade" (liveness) e prontidão (readiness) para verificar se seus pods estão funcionando corretamente. Se a verificação de vitalidade falhar, o Kubernetes interromperá este container e, em seguida, o reiniciará automaticamente, se a política de reinício estiver configurada corretamente. Se a verificação de prontidão falhar, o Kubernetes isolará este pod da prestação de serviços. Dessa forma, em tais casos, não será mais necessária a intervenção manual, o que é uma grande vantagem.
Implantação de atualizações
StatefulSet suporta atualizações automáticas: ao escolher a estratégia RollingUpdate, cada pod Kafka será atualizado um por um. Assim, é possível reduzir a duração de inatividade a zero.
Escalabilidade
Escalar um cluster Kafka não é uma tarefa simples. No entanto, no Kubernetes, é muito fácil escalar os pods para um determinado número de réplicas, o que significa que você poderá definir declarativamente quantos brokers Kafka desejar. O mais complicado, nesse caso, é a reassociação de setores após a escalabilidade para cima ou antes da escalabilidade para baixo. Novamente, o Kubernetes ajudará você com essa tarefa.
Administração
As tarefas relacionadas à administração do seu cluster Kafka, especialmente a criação de tópicos e a reatribuição de partições, podem ser realizadas por meio de scripts shell disponíveis, acessando a interface de linha de comando em seus pods. No entanto, essa solução não é muito elegante. O Strimzi suporta a gestão de tópicos por meio de outro operador. Há espaço para aprimoramento aqui.
Backup e recuperação
Agora, a disponibilidade do Kafka dependerá também da disponibilidade do Kubernetes. Se o seu cluster Kubernetes falhar, no pior dos casos, o cluster Kafka também falhará. De acordo com a Lei de Murphy, isso certamente ocorrerá e você perderá dados. Para reduzir o risco desse tipo de situação, é aconselhável desenvolver bem a estratégia de backup. Pode-se usar o MirrorMaker, outra alternativa é utilizar o S3, como descrito neste da Zalando.
Conclusão
Ao trabalhar com clusters Kafka pequenos ou médios, é definitivamente sensato utilizar o Kubernetes, pois ele proporciona flexibilidade adicional e facilita o trabalho com operadores. Se você tiver requisitos não funcionais muito rigorosos relacionados a latência e/ou largura de banda, talvez seja melhor considerar outra opção de implantação.
Fonte: habr.com
