

Neste artigo, vamos explicar como e por que desenvolvemos – um mecanismo que transmite informações entre aplicativos cliente e servidores 1C: Enterprise – desde a definição da tarefa até o planejamento da arquitetura e detalhes da implementação.
O Sistema de Interação (daqui em diante – SI) é um sistema de mensagens distribuído e tolerante a falhas com entrega garantida. O SI foi projetado como um serviço de alta carga com alta escalabilidade, disponível tanto como um serviço online (fornecido pela empresa 1C) quanto como um produto empacotado, que pode ser implantado em suas próprias capacidades de servidor.
O SI utiliza um armazenamento distribuído e um sistema de busca . Também falaremos sobre Java e como escalamos horizontalmente o PostgreSQL.
Formulação do problema
Para entender por que fizemos o Sistema de Interação, vou explicar um pouco sobre como é o desenvolvimento de aplicativos de negócios na 1C.
Para começar – um pouco sobre nós para aqueles que ainda não conhecem o que fazemos:) Nós desenvolvemos a plataforma tecnológica "1C: Enterprise". A plataforma inclui uma ferramenta de desenvolvimento de aplicativos de negócios, além de um runtime que permite que os aplicativos de negócios funcionem em um ambiente multiplataforma.
A paradigmas de desenvolvimento cliente-servidor
Os aplicativos de negócios criados na "1C: Enterprise" operam em uma arquitetura cliente-servidor de "SGBD – servidor de aplicativos – cliente". O código aplicativo, escrito na , pode ser executado no servidor de aplicativos ou no cliente. Todo o trabalho com objetos de aplicativo (diretórios, documentos, etc.) e a leitura e gravação de banco de dados são realizados apenas no servidor. A funcionalidade de formulários e da interface de comando também é implementada no servidor. No cliente, realiza-se a obtenção, abertura e exibição de formulários, "comunicação" com o usuário (alertas, perguntas...), pequenos cálculos nos formulários que requerem uma resposta rápida (por exemplo, multiplicar preço por quantidade), manipulação de arquivos locais e interação com hardware.
No código de aplicação, os cabeçalhos de procedimentos e funções devem indicar explicitamente onde o código será executado — usando as diretivas &НаКлиенте / &НаСервере (&AtClient / &AtServer na versão em inglês da linguagem). Os desenvolvedores em 1C agora vão me corrigir, dizendo que, na verdade, as diretivas são , mas para nós isso não é relevante no momento.
Do código do cliente, é possível chamar o código do servidor, mas não é possível chamar o código do cliente a partir do código do servidor. Essa é uma limitação fundamental imposta por várias razões. Especialmente porque o código do servidor deve ser escrito de tal forma que funcione de maneira idêntica, independentemente de onde for chamado — do cliente ou do servidor. E se houver uma chamada de código do servidor a partir de outro código do servidor, o cliente está ausente como tal. Além disso, durante a execução do código do servidor, o cliente que o chamou pode ter fechado ou saído do aplicativo, e o servidor não terá mais ninguém para chamar.

O código que processa o clique de um botão: a chamada do procedimento do servidor a partir do cliente funcionará, mas a chamada do procedimento do cliente a partir do servidor não funcionará.
Isso significa que, se quisermos, a partir do servidor, enviar uma mensagem para o aplicativo cliente, por exemplo, que a formação de um relatório 'de longa duração' foi concluída e o relatório pode ser visualizado — não temos esse recurso. Precisamos recorrer a artifícios, como interrogar periodicamente o servidor a partir do código do cliente. Mas essa abordagem sobrecarrega o sistema com chamadas desnecessárias e, de forma geral, não parece muito elegante.
E também há a necessidade, por exemplo, de notificar o aplicativo cliente sobre uma -para que, ao receber um telefonema, ele encontre o chamador na base de dados de contrapartes e mostre ao usuário as informações sobre o contato que está ligando. Ou, por exemplo, ao receber um pedido no armazém, notificar o aplicativo cliente do pedido. De modo geral, há muitos casos em que tal mecanismo seria útil.
A formulação propriamente dita
Criar um mecanismo de troca de mensagens. Rápido, confiável, com entrega garantida e possibilitando busca flexível de mensagens. Basear-se nesse mecanismo para implementar um mensageiro (mensagens, chamadas de vídeo) que opere dentro das aplicações 1C.
Projetar um sistema horizontalmente escalável. O aumento da carga deve ser compensado pelo aumento no número de nós.
Implementação
Decidimos não integrar a parte do servidor do SV diretamente na plataforma 1C:Enterprise, mas sim implementá-la como um produto separado, cujo API pode ser chamado a partir do código das soluções aplicativas 1C. Isso foi feito por várias razões, sendo a principal o desejo de possibilitar a troca de mensagens entre diferentes aplicações 1C (por exemplo, entre Gestão de Vendas e Contabilidade). Diferentes aplicações 1C podem operar em diferentes versões da plataforma 1C:Enterprise, estar em diferentes servidores, etc. Nessas condições, a implementação do SV como um produto separado, que fica "ao lado" das instalações do 1C, é a solução mais otimizada.
Portanto, decidimos fazer o SV como um produto separado. Para pequenas empresas, recomendamos o uso do servidor SV que instalamos em nossa nuvem (wss://1cdialog.com), para evitar custos adicionais relacionados à instalação e configuração local do servidor. Já os grandes clientes podem achar conveniente instalar seu próprio servidor SV em suas infraestruturas. Usamos uma abordagem similar em nosso produto SaaS na nuvem. – ele é lançado como um produto de série para instalação em clientes e também está disponível em nossa nuvem. .
Aplicativo
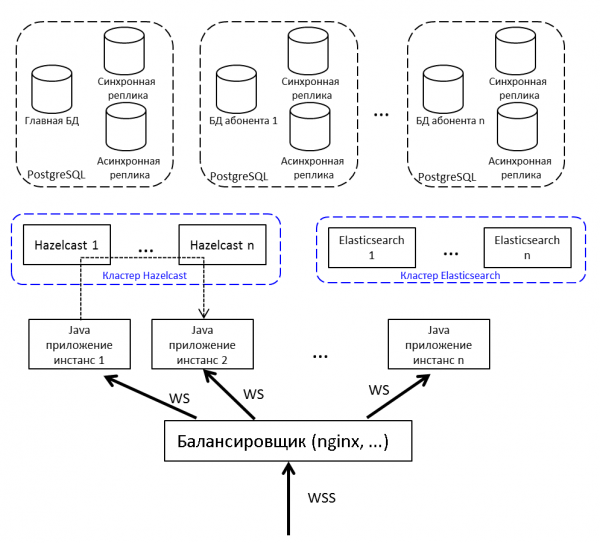
Para distribuir a carga e garantir a continuidade, não implementaremos um único aplicativo Java, mas vários, e colocaremos um balanceador de carga à frente deles. Se for necessário transmitir uma mensagem de nó para nó, utilizaremos publish/subscribe no Hazelcast.
A comunicação do cliente com o servidor é feita via websocket. Isso é muito adequado para sistemas em tempo real.
Cache distribuído
Fizemos uma escolha entre Redis, Hazelcast e Ehcache. Era 2015. O Redis acabou de lançar um novo cluster (muito novo, arriscado), existe o Sentinel com muitas limitações. O Ehcache não sabe criar clusters (essa funcionalidade surgiu depois). Decidimos tentar com o Hazelcast 3.4.
O Hazelcast forma clusters "pronto para uso". Em modo de um único nó, ele não é muito útil e só pode servir como cache – não sabe gravar dados no disco; se perder o único nó, perde-se os dados. Estamos implementando vários Hazelcasts, entre os quais fazemos backup de dados críticos. O cache não é feito backup – não nos importa.
Para nós, o Hazelcast é:
- Um repositório de sessões de usuário. Ir sempre buscar a sessão no banco de dados leva tempo, por isso armazenamos todas as sessões no Hazelcast.
- Cache. Procurando o perfil do usuário – verifique no cache. Escreveu uma nova mensagem – coloque no cache.
- Tópicos para comunicação das instâncias do aplicativo. O nó gera um evento e o coloca no tópico Hazelcast. Outros nós do aplicativo, que estão inscritos neste tópico, recebem e processam o evento.
- Bloqueios de cluster. Por exemplo, criamos uma discussão com uma chave única (discussão singleton dentro do banco 1C):
conversationKeyChecker.check("BENCOLÔNICA");

      doInClusterLock("BENCOLÔNICA", () -> {

          conversationKeyChecker.check("BENCOLÔNICA");

          createChannel("BENCOLÔNICA");
      });
Verificamos que o canal não existe. Pegamos o bloqueio, verificamos novamente e criamos. Se não verificarmos após pegar o bloqueio, existe a chance de que outra thread também tenha verificado e agora esteja tentando criar a mesma discussão – e ela já existe. Não é possível fazer o bloqueio através de synchronized ou Lock comum do Java. Através do banco – é lento, e ainda por cima, é um desperdício, através do Hazelcast – é exatamente o que precisamos.
Escolhemos o SGBD
Temos uma grande e bem-sucedida experiência em trabalhar com PostgreSQL e em colaborar com os desenvolvedores desse SGBD.
Com o cluster, o PostgreSQL não é fácil – existem , , , mas, em geral, isso não é noSQL, que se escalonam de forma nativa. Não consideramos o noSQL como o principal armazenamento, era suficiente usar o Hazelcast, com o qual não havíamos trabalhado antes.
Como precisamos escalar um banco de dados relacional – significa . Como você sabe, no sharding dividimos o banco de dados em partes separadas de modo que cada uma delas possa ser movida para um servidor separado.
A primeira opção do nosso sharding previa a possibilidade de distribuir cada uma das tabelas do nosso aplicativo em diferentes servidores em diferentes proporções. Muitas mensagens no servidor A – por favor, vamos mover parte desta tabela para o servidor B. Essa solução clamava por uma otimização prematura, então decidimos nos limitar à abordagem multi-tenant.
Você pode ler sobre multi-tenant, por exemplo, no site .
No contexto do SV, existem os conceitos de aplicativo e assinante. Um aplicativo é uma instalação específica de um software de negócios, como ERP ou Contabilidade, com seus próprios usuários e dados de negócios. O assinante é a organização ou pessoa física que registra o aplicativo no servidor SV. Um assinante pode ter vários aplicativos registrados, e esses aplicativos podem trocar mensagens entre si. O assinante é o inquilino em nosso sistema. Mensagens de vários assinantes podem estar em um único banco de dados físico; se percebermos que um assinante está gerando muito tráfego, movemos-o para um banco de dados físico separado (ou até um servidor de banco de dados separado).
Temos um banco de dados principal onde armazenamos uma tabela de roteamento com informações sobre a localização de todos os bancos de dados dos assinantes.
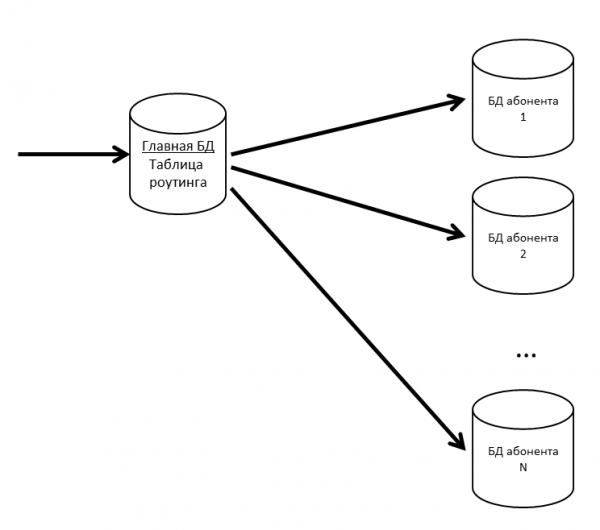
Para que o banco de dados principal não se torne um gargalo, mantemos a tabela de roteamento (e outros dados frequentemente acessados) em cache.
Se o banco de dados do assinante começar a desacelerar, faremos a partição internamente. Em outros projetos, usamos a .
Como perder mensagens dos usuários é indesejável, mantemos nossos bancos de dados com réplicas. A combinação de réplicas síncronas e assíncronas nos protege em caso de perda do banco de dados principal. A perda de uma mensagem só ocorrerá se o banco de dados principal e sua réplica síncrona falharem simultaneamente.
Se a réplica síncrona falhar, a réplica assíncrona torna-se síncrona.
Se o banco de dados principal falhar, a réplica síncrona torna-se o banco de dados principal, e a réplica assíncrona torna-se a réplica síncrona.
Elasticsearch para busca
Como, além de tudo, o SV também é um mensageiro, precisamos de uma busca rápida, conveniente e flexível, levando em conta a morfologia e correspondências imprecisas. Decidimos não reinventar a roda e usar o sistema de busca livre Elasticsearch, criado com base na biblioteca . Também implantamos o Elasticsearch em um cluster (mestre – dados – dados), para evitar problemas caso nós nós do aplicativo falhem.
No github encontramos para Elasticsearch e a utilizamos. No índice Elasticsearch, armazenamos as raízes das palavras (definidas pelo plugin) e N-gramas. À medida que o usuário digita o texto para pesquisa, procuramos o texto digitado entre os N-gramas. Ao salvar no índice, a palavra "textos" será dividida nos seguintes N-gramas:
[te, tex, text, textos, ex, exs, ext, extos, xs, xt, xst, st, sty, ty],
E também será salva a raiz da palavra "texto". Essa abordagem permite buscar tanto no início, quanto no meio e no final da palavra.
Visão geral
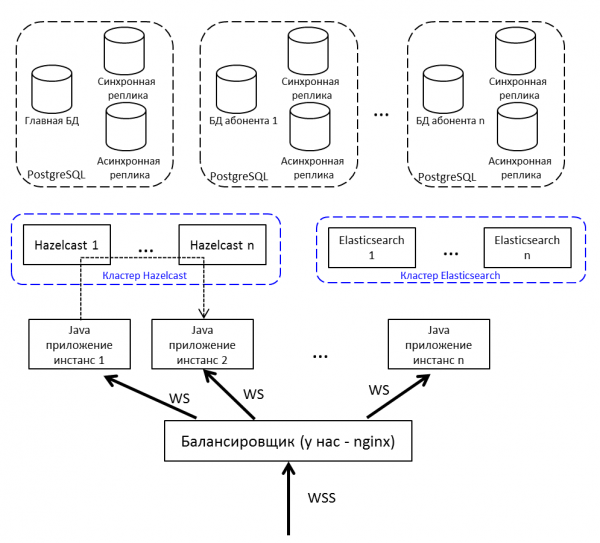
Repetição da imagem do início do artigo, mas já com explicações:
- Balanceador, exposto na internet; temos – nginx, pode ser qualquer um.
- As instâncias da aplicação Java se comunicam entre si através do Hazelcast.
- Para trabalhar com websocket utilizamos .
- A aplicação Java é escrita em Java 8, consiste em bundles . Nos planos – migração para Java 10 e transição para módulos.
Desenvolvimento e teste
Durante o desenvolvimento e teste do SV, enfrentamos várias características interessantes dos produtos que utilizamos.
Teste de carga e vazamentos de memória
A cada lançamento do SV, é realizado um teste de carga. Ele é considerado bem-sucedido quando:
- O teste rodou por vários dias e não houve interrupções no serviço
- O tempo de resposta para operações-chave não excedeu o limite confortável
- A degradação de performance em comparação com a versão anterior não foi superior a 10%
Preenchemos a base de dados de teste com informações — para isso, obtemos do servidor de produção informações sobre o assinante mais ativo, multiplicamos seus números por 5 (número de mensagens, discussões, usuários) e assim testamos.
Realizamos o teste de carga do sistema de interação em três configurações:
- Teste de estresse
- Apenas conexões
- Registro de assinantes
No teste de estresse, lançamos várias centenas de threads, que continuamente sobrecarregam o sistema: escrevem mensagens, criam discussões, obtêm a lista de mensagens. Simulamos ações de usuários comuns (obter a lista de minhas mensagens não lidas, mandar mensagem para alguém) e soluções programáticas (enviar um pacote de outra configuração, processar uma notificação).
Por exemplo, assim é como parte do teste de estresse se parece:
- Um usuário entra no sistema
- Solicita suas discussões não lidas
- Com 50% de probabilidade lê as mensagens
- Com 50% de probabilidade escreve mensagens
- Depois, o usuário:
- Com 20% de probabilidade, cria uma nova discussão
- Escolhe aleatoriamente qualquer uma de suas discussões
- Entra na discussão
- Solicita mensagens, perfis de usuários
- Cria cinco mensagens dirigidas a usuários aleatórios dessa discussão
- Sai da discussão
- Repete 20 vezes
- Sai do sistema, retorna ao início do script
- Um chatbot entra no sistema (emula a troca de mensagens do código de soluções aplicacionais)
- Com 50% de probabilidade, cria um novo canal para troca de dados (discussão especial)
- Com 50% de probabilidade, escreve uma mensagem em qualquer um dos canais existentes
O cenário "Somente conexões" não surgiu por acaso. Às vezes, usuários conectam o sistema, mas ainda não se envolveram. Cada usuário liga o computador às 09:00, estabelece uma conexão com o servidor e fica em silêncio. Esses indivíduos são perigosos, são muitos – de seus pacotes só temos PING/PONG, mas mantêm a conexão com o servidor (não podem desconectar – e se houver uma nova mensagem). O teste reproduz a situação em que muitos usuários tentam se autenticar no sistema em meia hora. É semelhante a um teste de estresse, mas o foco está exatamente nessa primeira entrada – para que não haja falhas (a pessoa não utiliza o sistema, mas ele já desliga – é difícil imaginar algo pior).
O cenário de registro de assinantes começa com a primeira execução. Realizamos um teste de estresse e estávamos confiantes de que a comunicação não estava lenta. Mas os usuários chegaram e o registro começou a falhar por timeout. No registro, usamos , que está vinculado à entropia do sistema. O servidor não conseguia acumular entropia suficiente e, ao solicitar um novo SecureRandom, ficava congelado por dezenas de segundos. Existem várias soluções para essa situação, por exemplo: mudar para um menos seguro /dev/urandom, instalar um hardware específico que gera entropia, ou gerar números aleatórios antecipadamente e armazenar em um pool. Temporariamente, fechamos o problema com um pool, mas desde então executamos um teste separado para o registro de novos assinantes.
Como gerador de carga, usamos . Ele não consegue trabalhar com websocket, é necessário um plugin. Os primeiros resultados na busca por "jmeter websocket" são , que recomendam .
Foi dele que decidimos começar.
Quase imediatamente após o início dos testes sérios, descobrimos que começaram a ocorrer vazamentos de memória no JMeter.
O plugin é uma história à parte; com 176 estrelas, ele tem 132 forks no github. O próprio autor não faz commits desde 2015 (nós o pegamos em 2015, na época isso não levantou suspeitas), há alguns problemas levantados no github sobre vazamentos de memória, 7 pull requests não fechados.
Se você decidir realizar testes de carga com este plugin, preste atenção nas seguintes discussões:
- Em um ambiente multithread, foi usado um LinkedList comum, resultando em em tempo de execução. Isso é resolvido either switching to ConcurrentLinkedDeque, or using synchronized blocks. Para nós, escolhemos a primeira opção ().
- Vazamento de memória, durante o desconexão, as informações sobre a conexão não são deletadas ().
- No modo streaming (quando o websocket não é fechado no final da amostra, mas utilizado adiante no plano) os padrões de resposta não funcionam ().
Isso é daqueles que estão no github. O que fizemos:
- Peguemos (@elyrank) – nele foram corrigidos os problemas 1 e 3
- Resolvemos o problema 2
- Atualizamos o jetty de 9.2.14 para 9.3.12
- Encapsulamos SimpleDateFormat em ThreadLocal; SimpleDateFormat não é thread-safe, o que levava a NPE em tempo de execução
- Eliminamos mais um vazamento de memória (a conexão não estava sendo fechada corretamente durante a desconexão)
E ainda assim ele continua vazando!
A memória não acabava em um dia, e sim em dois. Não sobrava tempo, decidimos executar menos threads, mas em quatro agentes. Isso deveria ser suficiente, pelo menos, por uma semana.
Dois dias se passaram...
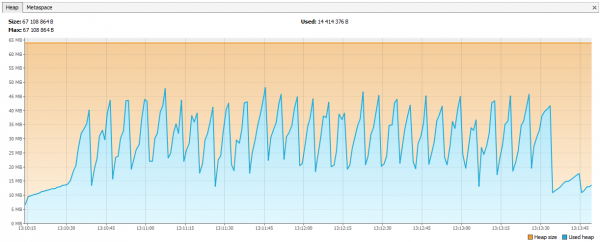
Agora a memória começou a acabar no Hazelcast. Nos logs era visível que após alguns dias de testes, o Hazelcast começou a reclamar da falta de memória, e depois de algum tempo o cluster desmoronava, e os nós continuavam morrendo um a um. Conectamos o JVisualVM ao hazelcast e vimos uma "serra ascendente" – ele chamava regularmente o GC, mas não conseguia limpar a memória.
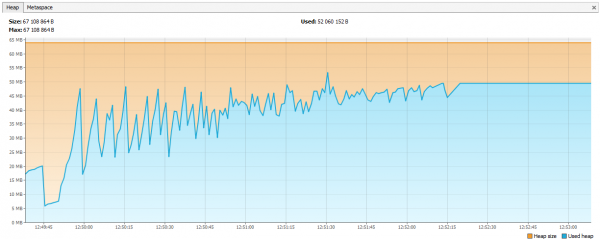
Descobriu-se que no hazelcast 3.4 ao remover um map / multiMap (map.destroy()) a memória não é totalmente liberada:
Agora o erro foi corrigido na versão 3.5, mas na época isso era um problema. Nós criamos novos multiMap com nomes dinâmicos e os removíamos de acordo com nossa lógica. O código se parecia mais ou menos com isto:
public void join(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.put(auth.getUserId(), auth);
}

public void leave(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.remove(auth.getUserId(), auth);

    if (sessions.size() == 0) {
        sessions.destroy();
    }
}
Chamado:
service.join(auth1, "NOVAS_MENSAGENS_NO_DISCUSSÃO_UUID1");
service.join(auth2, "NOVAS_MENSAGENS_NO_DISCUSSÃO_UUID1");
O multiMap era criado para cada assinatura e removido quando não era mais necessário. Decidimos que criaríamos um Map, onde a chave seria o nome da assinatura e os valores seriam os identificadores de sessão (a partir dos quais podemos obter os identificadores dos usuários, se necessário).
public void join(Authentication auth, String sub) {
    addValueToMap(sub, auth.getSessionId());
}

public void leave(Authentication auth, String sub) {
    removeValueFromMap(sub, auth.getSessionId());
}
Os gráficos se estabilizaram.
O que mais aprendemos sobre testes de carga
- JSR223 precisa ser escrito em groovy e incluir cache de compilação – isso é muito mais rápido. .
- Os gráficos do Jmeter-Plugins são mais fáceis de entender do que os padrões. .
Sobre nossa experiência com Hazelcast
Hazelcast era um produto novo para nós; começamos a trabalhar com ele na versão 3.4.1, e agora nosso servidor de produção está rodando a versão 3.9.2 (no momento da escrita deste artigo, a última versão do Hazelcast era a 3.10).
Geração de ID
Começamos com identificadores numéricos. Vamos imaginar que precisamos de um Long para uma nova entidade. Sequence no banco de dados não serve, pois as tabelas estão envolvidas no sharding – resultaria em uma mensagem ID=1 no BD1 e ID=1 no BD2, e assim por diante. No Elasticsearch não poderia usar ID assim, nem no Hazelcast, mas o pior é que se você quiser juntar dados de dois bancos em um só (por exemplo, decidindo que um banco é suficiente para esses assinantes). Pode criar vários AtomicLongs no Hazelcast e manter o contador lá, assim a performance para obter um novo ID seria incrementAndGet mais o tempo da solicitação para o Hazelcast. Mas no Hazelcast existe algo mais otimizado – o FlakeIdGenerator. Cada cliente recebe um intervalo de IDs ao fazer uma solicitação, por exemplo, o primeiro receberá de 1 a 10.000, o segundo de 10.001 a 20.000 e assim por diante. Agora o cliente pode emitir novos identificadores de forma autônoma, até que seu intervalo se esgote. Funciona rapidamente, mas ao reiniciar a aplicação (e o cliente do Hazelcast) uma nova sequência começa – daí podem ocorrer lacunas, etc. Além disso, não é muito compreensível para os desenvolvedores por que os IDs são numéricos, mas vêm de forma tão desordenada. Pesamos tudo e decidimos mudar para UUIDs.
A propósito, para aqueles que querem ser como o Twitter, existe a biblioteca Snowcast – uma implementação do Snowflake sobre o Hazelcast. Você pode vê-la aqui:
Mas nós não chegamos a ela.
TransactionalMap.replace
Mais uma surpresa: TransactionalMap.replace não funciona. Aqui está o teste:
@Test
public void replaceInMap_putsAndGetsInsideTransaction() {

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            context.getMap("map").put("key", "oldValue");
            context.getMap("map").replace("key", "oldValue", "newValue");

            String value = (String) context.getMap("map").get("key");
            assertEquals("newValue", value);

            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}

Esperado : newValue
Real : oldValue
Tive que escrever meu próprio replace, usando getForUpdate:
protected  boolean replaceInMap(String mapName, K key, V oldValue, V newValue) {
    TransactionalTaskContext context = HazelcastTransactionContextHolder.getContext();
    if (context != null) {
        log.trace("[CACHE] Substituindo valor em um mapa transacional");
        TransactionalMap map = context.getMap(mapName);
        V value = map.getForUpdate(key);
        if (oldValue.equals(value)) {
            map.put(key, newValue);
            return true;
        }

        return false;
    }
    log.trace("[CACHE] Substituindo valor em um mapa não transacional");
    IMap map = hazelcastInstance.getMap(mapName);
    return map.replace(key, oldValue, newValue);
}
Teste não apenas as estruturas de dados comuns, mas também suas versões transacionais. Pode acontecer que IMap funcione, enquanto o TransactionalMap não.
Adicionar um novo JAR sem downtime
Primeiro decidimos gravar no Hazelcast objetos de nossas classes. Por exemplo, temos a classe Application, queremos salvá-la e lê-la. Salvamos:
IMap map = hazelcastInstance.getMap("application");
map.set(id, application);
Lemos:
IMap map = hazelcastInstance.getMap("application");
return map.get(id);
Está tudo funcionando. Depois decidimos construir um índice no Hazelcast para pesquisar por ele:
map.addIndex("subscriberId", false);E ao gravar uma nova entidade, começamos a receber ClassNotFoundException. O Hazelcast tentava atualizar o índice, mas não sabia nada sobre nossa classe e queria que fornecêssemos um JAR com essa classe. Fizemos isso, tudo funcionou, mas surgiu um novo problema: como atualizar o JAR sem parar completamente o cluster? O Hazelcast não captura o novo JAR durante uma atualização pontual. Nesse momento, decidimos que poderíamos viver sem pesquisar pelo índice. Afinal, se usássemos o Hazelcast como um repositório tipo chave-valor, funcionaria? Não exatamente. Aqui novamente há um comportamento diferente entre IMap e TransactionalMap. Onde o IMap não se importa, o TransactionalMap gera um erro.
IMap. Registramos 5000 objetos, lemos. Tudo conforme o esperado.
@Test
void get5000() {
    IMap map = hazelcastInstance.getMap("application");
    UUID subscriberId = UUID.randomUUID();

    for (int i = 0; i < 5000; i++) {
        UUID id = UUID.randomUUID();
        String title = RandomStringUtils.random(5);
        Application application = new Application(id, title, subscriberId);

        map.set(id, application);
        Application retrieved = map.get(id);
        assertEquals(id, retrieved.getId());
    }
}
E não funciona na transação, recebemos ClassNotFoundException:
@Test
void get_transaction() {
    IMap map = hazelcastInstance.getMap("application_t");
    UUID subscriberId = UUID.randomUUID();
    UUID id = UUID.randomUUID();

    Application application = new Application(id, "qwer", subscriberId);
    map.set(id, application);

    Application retrievedOutside = map.get(id);
    assertEquals(id, retrievedOutside.getId());

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            TransactionalMap transactionalMap = context.getMap("application_t");
            Application retrievedInside = transactionalMap.get(id);

            assertEquals(id, retrievedInside.getId());
            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}
Na versão 3.8, foi introduzido o mecanismo de User Class Deployment. Você pode designar um nó principal e atualizar o arquivo JAR nele.
Agora mudamos completamente a abordagem: nós mesmos serializamos em JSON e salvamos no Hazelcast. O Hazelcast não precisa conhecer a estrutura das nossas classes, e nós podemos fazer atualizações sem tempo de inatividade. A versão dos objetos de domínio é gerenciada pela aplicação. Várias versões da aplicação podem estar em execução ao mesmo tempo, e é possível que uma nova aplicação escreva objetos com novos campos, enquanto a antiga ainda não conhece esses campos. Ao mesmo tempo, a nova aplicação lê objetos gravados pela antiga, que não possuem os novos campos. Esses casos são tratados dentro da aplicação, mas para simplicidade, não mudamos nem removemos os campos, apenas expandimos as classes adicionando novos campos.
Como garantimos alto desempenho
Quatro chamadas ao Hazelcast – bom, duas ao banco de dados – ruim
É sempre melhor buscar dados no cache do que no banco de dados, mas também não queremos armazenar registros não utilizados. A decisão sobre o que armazenar em cache é deixada para a última etapa do desenvolvimento. Quando a nova funcionalidade está codificada, ativamos o log de todas as consultas no PostgreSQL (log_min_duration_statement em 0) e iniciamos testes de carga por cerca de 20 minutos. Com os logs coletados, utilitários como pgFouine e pgBadger conseguem gerar relatórios analíticos. Nos relatórios, procuramos em primeiro lugar por consultas lentas e frequentes. Para consultas lentas, elaboramos um plano de execução (EXPLAIN) e avaliamos se é possível acelerar essa consulta. Consultas frequentes com os mesmos dados de entrada se encaixam bem no cache. Tentamos manter as consultas "planas", com uma tabela por consulta.
Operação
O SV como serviço online foi lançado em operação na primavera de 2017, e como produto separado, o SV saiu em novembro de 2017 (naquele momento, no status de versão beta).
Mais de um ano de operação, não ocorreram problemas sérios no funcionamento do serviço online SV. Monitoramos o serviço online através do , coletamos e fazemos deploy do .
O pacote do servidor SV é fornecido na forma de pacotes nativos: RPM, DEB, MSI. Além disso, para Windows, oferecemos um instalador único na forma de um único EXE, que instala o servidor, Hazelcast e Elasticsearch em uma única máquina. Inicialmente chamávamos essa versão de instalação de "demonstração", mas agora ficou claro que esta é a opção de implantação mais popular.
Fonte: habr.com
