

Olá, Habr!
Eu trabalho na equipe do Tinkoff, que desenvolve um centro de notificações próprio. Principalmente, desenvolvo em Java usando Spring Boot e resolvo vários problemas técnicos que surgem no projeto.
A maioria dos nossos microsserviços interagem de forma assíncrona através de um broker de mensagens. Anteriormente, utilizamos o IBM MQ como broker, que não conseguiu lidar com a carga, mas tinha altas garantias de entrega.
Como substituto, nos foi sugerido o Apache Kafka, que possui um alto potencial de escalabilidade, mas, infelizmente, requer uma abordagem praticamente individual de configuração para diferentes cenários. Além disso, o mecanismo de entrega at least once, que opera no Kafka por padrão, não permitia manter o nível necessário de consistência fora da caixa. A seguir, compartilharei nossa experiência na configuração do Kafka, especificamente como configurar e viver com a entrega exactly once.
Entrega garantida e muito mais
Os parâmetros que discutiremos a seguir ajudarão a evitar uma série de problemas com as configurações de conexão padrão. Mas primeiro, vamos nos concentrar em um parâmetro que facilitará a possível depuração.
Isso ajudará client.id para o Producer e o Consumer. À primeira vista, pode-se usar o nome do aplicativo como valor, e na maioria das vezes isso funcionará. No entanto, a situação em que várias Consumers são usadas no aplicativo e você atribui o mesmo client.id a elas gera o seguinte aviso:
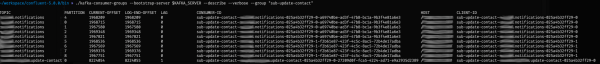
org.apache.kafka.common.utils.AppInfoParser — Erro ao registrar AppInfo mbean javax.management.InstanceAlreadyExistsException: kafka.consumer:type=app-info,id=kafka.test-0Se você deseja usar JMX em um aplicativo com Kafka, isso pode ser um problema. Para essa situação, é melhor usar como valor do client.id uma combinação do nome do aplicativo e, por exemplo, o nome do tópico. O resultado da nossa configuração pode ser visto na saída do comando kafka-consumer-groups das ferramentas da Confluent:
Agora, vamos analisar o cenário de entrega garantida de mensagens. O Kafka Producer possui um parâmetro acks, que permite configurar quantas confirmações o líder do cluster deve receber antes de considerar a mensagem escrita com sucesso. Este parâmetro pode assumir os seguintes valores:
- 0 — confirmações não serão contabilizadas.
- 1 — parâmetro padrão, necessário acknowledgment apenas de 1 réplica.
- −1 — são necessários acknowledgments de todas as réplicas sincronizadas (configuração do cluster. min.insync.replicas).
Dos valores listados, um acks igual a −1 oferece as garantias mais fortes de que a mensagem não será perdida.
Como todos sabemos, sistemas distribuídos são não confiáveis. Para se proteger contra falhas temporárias, o Kafka Producer fornece o parâmetro retries, que permite definir o número de tentativas de reenvio dentro de delivery.timeout.ms. Como o parâmetro retries tem um valor padrão de Integer.MAX_VALUE (2147483647), o número de reenvios de uma mensagem pode ser regulado apenas alterando o delivery.timeout.ms.
Avançando para a entrega exatamente uma vez
As configurações listadas permitem que nosso Producer entregue mensagens com alta garantia. Agora vamos falar sobre como garantir a gravação de apenas uma cópia da mensagem no tópico Kafka? No caso mais simples, para isso o Producer deve definir o parâmetro enable.idempotence como true. A idempotência garante a gravação de apenas uma mensagem em uma partição específica de um tópico. Uma condição prévia para habilitar a idempotência são os valores acks = all, retry > 0, max.in.flight.requests.per.connection ≤ 5. Se esses parâmetros não forem definidos pelo desenvolvedor, então os valores mencionados acima serão aplicados automaticamente.
Quando a idempotência está configurada, é necessário garantir que mensagens idênticas cheguem sempre às mesmas partições. Isso pode ser feito configurando a chave e o parâmetro partitioner.class no Producer. Vamos começar pela chave. Para cada envio, ela deve ser a mesma. Isso é facilmente alcançado utilizando algum identificador de negócio da mensagem original. O parâmetro partitioner.class tem o valor padrão de . Com esta estratégia de partição padrão, agimos da seguinte forma:
- Se a partição for explicitamente especificada ao enviar a mensagem, a utilizamos.
- Se a partição não for especificada, mas a chave for, escolhemos a partição com base no hash da chave.
- Se nem a partição nem a chave forem especificadas — escolhemos as partições em ordem (round-robin).
Além disso, o uso de chave e envio idempotente com o parâmetro max.in.flight.requests.per.connection = 1 oferece um processamento ordenado de mensagens no Consumer. É importante lembrar que, se o gerenciamento de acesso estiver configurado em seu cluster, serão necessárias permissões para escrita idempotente no tópico.
Se por acaso você sentir falta das capacidades de envio idempotente por chave ou se a lógica do lado do Producer exigir a manutenção da consistência de dados entre diferentes partições, as transações podem ser a solução. Além disso, com transações encadeadas, você pode condicionalmente sincronizar a gravação no Kafka, por exemplo, com uma gravação no banco de dados. Para habilitar o envio transacional no Producer, é necessário que ele tenha idempotência e você também deve definir transactional.id. Se o seu cluster Kafka tiver gerenciamento de acesso habilitado, então para a gravação transacional, assim como para a idempotente, serão necessárias permissões de gravação que podem ser concedidas por meio de uma máscara com o valor armazenado em transactional.id.
Formalmente, qualquer string pode ser usada como identificador de transação, por exemplo, o nome do aplicativo. Mas se você estiver executando várias instâncias de um mesmo aplicativo com o mesmo transactional.id, a primeira instância iniciada será interrompida com um erro, pois o Kafka a considerará um processo zumbi.
org.apache.kafka.common.errors.ProducerFencedException: O Producer tentou realizar uma operação com uma epoch antiga. Ou existe um producer mais novo com o mesmo transactionalId, ou a transação do producer expirou no broker.Para resolver esse problema, adicionamos um sufixo ao nome do aplicativo a partir do nome do host, obtido das variáveis de ambiente.
O Producer está configurado, mas as transações no Kafka controlam apenas o escopo da mensagem. Independentemente do status da transação, a mensagem é imediatamente enviada ao tópico, mas possui atributos de sistema adicionais.
Para que essas mensagens não sejam lidas pelo Consumer antes do tempo, é necessário configurar o parâmetro isolation.level para o valor read_committed. Esse Consumer poderá ler mensagens não transacionais como antes, e as transacionais somente após o commit.
Se você configurou todas as configurações mencionadas anteriormente, você configurou a entrega exatamente uma vez. Parabéns!
Mas há mais um detalhe. O transactional.id que configuramos acima é, na verdade, um prefixo da transação. Ao gerenciador de transações, um número sequencial é adicionado a ele. O identificador resultante é gerado em transactional.id.expiration.ms, que é configurado em um cluster Kafka e tem como valor padrão "7 dias". Se durante esse tempo o aplicativo não recebeu mensagens, ao tentar a próxima transmissão transacional, você receberá InvalidPidMappingException. Após isso, o coordenador de transações emitirá um novo número sequencial para a próxima transação. Nesse caso, a mensagem pode ser perdida se a InvalidPidMappingException não for tratada corretamente.
Em vez de resultados
Como você pode notar, não é suficiente apenas enviar mensagens para o Kafka. É preciso escolher uma combinação de parâmetros e estar preparado para fazer alterações rápidas. Neste artigo, procurei mostrar em detalhes a configuração de entrega exactly once e descrevi alguns problemas de configuração do client.id e transactional.id que enfrentamos. Abaixo estão as configurações do Producer e do Consumer resumidas.
Producer:
- acks = all
- retries > 0
- enable.idempotence = true
- max.in.flight.requests.per.connection ≤ 5 (1 — para envio ordenado)
- transactional.id = ${application-name}-${hostname}
Consumer:
- isolation.level = read_committed
Para minimizar erros em futuros aplicativos, fizemos nossa própria camada sobre a configuração do spring, onde já estão definidos os valores para alguns dos parâmetros mencionados.
Aqui estão alguns materiais para estudo independente:
Fonte: habr.com
