

Vivemos em um momento incrível, onde é possível conectar rapidamente e facilmente várias ferramentas open-source prontas, configurá-las com "consciência desligada" usando conselhos do Stack Overflow, sem se aprofundar em "muitas letras", e colocá-las em operação comercial. E quando for necessário atualizar/expandir ou alguém reiniciar acidentalmente algumas máquinas, perceber que começou um pesadelo insistente e confuso, tudo se complicou a ponto de não ser mais reconhecível, não há retorno, o futuro é nebuloso e, em vez de programar, é mais seguro criar abelhas e fazer queijo.
Não é à toa que colegas mais experientes, com cabelos grisalhos e cheios de bugs, contemplando a implantação incrivelmente rápida de pacotes de "containers" em "cubos" em dezenas de servidores com "linguagens da moda" que possuem suporte embutido para I/O assíncrono-não bloqueante, sorriem modestamente. Eles silenciosamente continuam relendo "man ps", mergulhando até sangrar os olhos nos códigos fontes do "nginx" e escrevendo-escrevendo-escrevendo testes unitários. Os colegas sabem que o mais interessante está por vir, quando "tudo isso" um dia se tornar um pesadelo no Ano Novo. E só um profundo entendimento da natureza unix, a tabela de estados TCP/IP e os algoritmos básicos de ordenação-busca poderão ajudá-los a trazer o sistema de volta à vida à meia-noite.
Ah sim, me distraí um pouco, mas espero que tenha conseguido transmitir o estado de expectativa.
Hoje quero compartilhar nossa experiência na implantação de um stack acessível e conveniente para DataLake, que resolve a maioria das tarefas analíticas da empresa para diferentes departamentos.
Algum tempo atrás, chegamos à conclusão de que as empresas precisam cada vez mais dos frutos tanto da análise de produto quanto da técnica (sem mencionar a cereja do bolo que é o machine learning) e, para compreender tendências e riscos, é necessário coletar e analisar cada vez mais métricas.
Análise técnica básica em "Bitrix24"
Há alguns anos, juntamente com o lançamento do serviço «Bitrix24», investimos tempo e recursos na criação de uma plataforma analítica simples e confiável, que ajudasse a identificar rapidamente problemas na infraestrutura e planejar o próximo passo. É claro que os instrumentos deveriam ser prontos, além de serem o mais simples e compreensíveis possível. Como resultado, escolhemos o nagios para monitoramento e o munin para análise e visualização. Agora temos milhares de verificações no nagios, centenas de gráficos no munin e os colegas utilizam isso diariamente com sucesso. As métricas são claras, os gráficos são evidentes, o sistema funciona de forma confiável há vários anos e novos testes e gráficos são regularmente adicionados: ao introduzirmos um novo serviço, adicionamos vários testes e gráficos. Boa jornada.
Mantenha o pulso — análise técnica aprofundada
O desejo de receber informações sobre problemas «o mais rápido possível» nos levou a experimentações ativas com ferramentas simples e compreensíveis — pinba e xhprof.
Pinba nos enviava, em pacotes UDP, estatísticas sobre a velocidade de execução das partes das páginas web em PHP, e era possível visualizar em tempo real, no armazenamento MySQL (o pinba vem com seu próprio mecanismo MySQL para análise rápida de eventos), uma lista curta de problemas e reagir a eles. O xhprof, de forma automática, permitia coletar gráficos de execução das páginas PHP mais lentas dos clientes e analisar o que poderia ter causado isso — tranquilamente, enquanto tomávamos um chá ou algo mais forte.
Algum tempo atrás, o conjunto de ferramentas foi enriquecido com mais um motor bastante simples e compreensível, baseado em um algoritmo de indexação reversa, brilhantemente implementado na lendária biblioteca Lucene — Elastic/Kibana. A ideia simples de gravação multithread de documentos em um índice inverso do Lucene, com base em eventos nos logs, e a busca rápida por eles utilizando divisão em facetas — revelou-se, de fato, útil.
Apesar da aparência um tanto técnica das visualizações no Kibana, com conceitos de baixo nível como «bucket» e uma linguagem reinventada da já esquecida álgebra relacional — a ferramenta tem nos ajudado bastante nas seguintes tarefas:
- Quantos erros PHP ocorreram no portal Bitrix24 p1 no último hora e quais foram? Compreender, perdoar e corrigir rapidamente.
- Quantas chamadas de vídeo foram feitas nos portais na Alemanha nas últimas 24 horas, com que qualidade e houve problemas com o canal/rede?
- Quão bem funciona a funcionalidade do sistema (nossa extensão em C para PHP), compilada a partir do código-fonte na última atualização do serviço e distribuída aos clientes? Não houve segfaults?
- Os dados dos clientes estão armazenados na memória do PHP? Não há erros de superação da memória alocada para os processos: "out of memory"? Encontrar e neutralizar.
Aqui está um exemplo concreto. Apesar de testes minuciosos e em múltiplos níveis, o cliente encontrou um erro frustrante e inesperado em um caso muito não padrão e com dados de entrada corrompidos, o alarme soou e iniciou-se o processo de correção rápida:
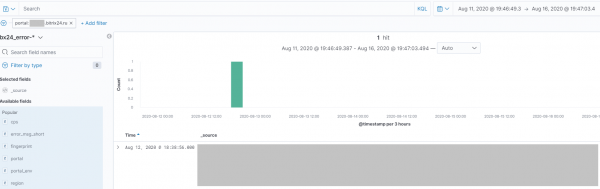
Além disso, a Kibana permite configurar alertas para eventos específicos e, em pouco tempo, dezenas de funcionários de diferentes departamentos passaram a usar a ferramenta — desde suporte técnico e desenvolvimento até QA.
A atividade de qualquer departamento dentro da empresa passou a ser monitorada e medida de forma conveniente — em vez de análise manual de logs nos servidores, basta configurar uma vez o processamento dos logs e seu envio para o cluster Elastic, para desfrutar, por exemplo, da visualização no dashboard Kibana do número de gatinhos de duas cabeças impressos em 3D no último mês lunar.
Análise de negócios básica
Todos sabem que muitas vezes a análise de negócios nas empresas começa com o uso extremamente intenso do, sim, sim, Excel. Mas o importante é que não termine por lá. O Google Analytics na nuvem ainda acelera o processo — você rapidamente se acostuma ao que é bom.
Na nossa empresa, que se desenvolve de forma harmoniosa, começaram a aparecer por aqui e ali "profetas" de um trabalho mais intenso com dados maiores. As necessidades por relatórios mais profundos e multifacetados têm surgido regularmente e, com o esforço da equipe de diferentes departamentos, há algum tempo foi organizado uma solução simples e prática — uma combinação de ClickHouse e PowerBI.
Por um bom tempo, essa solução flexível ajudou bastante, mas gradualmente foi percebido que o ClickHouse não é elástico e não pode ser tratado de qualquer maneira.
É importante entender bem que ClickHouse, assim como Druid, Vertica e Amazon RedShift (que é baseado em postgres), são mecanismos analíticos otimizados para uma análise bastante conveniente (somas, agregações, mínimo-máximo em uma coluna e um pouco de joins), pois são organizados para um armazenamento eficiente de colunas em tabelas relacionais, ao contrário do conhecido MySQL e de outros bancos de dados (orientados a linhas).
Na essência, ClickHouse é apenas um banco de dados mais espaçoso, com uma inserção pontual não muito conveniente (isso foi intencional, está tudo bem), mas com uma análise agradável e um conjunto de funções poderosas interessantes para trabalhar com dados. Sim, você pode até criar um cluster — mas, você entende que usar um microscópio para pregar um prego não é exatamente o mais adequado, e começamos a procurar outras soluções.
Demanda por python e analistas
Em nossa empresa, há muitos desenvolvedores que escrevem código quase todos os dias há 10-20 anos em PHP, JavaScript, C#, C/C++, Java, Go, Rust, Python, Bash. Também temos muitos administradores de sistemas experientes, que já enfrentaram várias catástrofes que parecem não se encaixar nas leis da estatística (por exemplo, quando a maioria dos discos em RAID-10 é destruída durante uma forte descarga elétrica). Nessas condições, há muito tempo era difícil entender o que era um 'analista em python'. Python é como PHP, só que o nome é um pouco mais longo e há menos vestígios de substâncias que alteram a consciência no código fonte do interpretador. No entanto, à medida que novos relatórios analíticos eram criados, os desenvolvedores experientes começaram a perceber cada vez mais a importância da especialização em ferramentas como numpy, pandas, matplotlib, seaborn.
Um papel decisivo foi provavelmente desempenhado pelos desmaios repentinos dos funcionários ao ouvir as palavras 'regressão logística' e a demonstração da construção eficiente de relatórios sobre grandes volumes de dados com a ajuda do, sim, pyspark.
Apache Spark, sua paradigma funcional, para o qual a álgebra relacional se encaixa perfeitamente e suas capacidades impressionaram tanto os desenvolvedores acostumados ao MySQL que a necessidade de fortalecer as fileiras com analistas experientes se tornou clara como o dia.
As tentativas seguintes do Apache Spark/Hadoop de decolar e o que não saiu exatamente como o planejado
No entanto, logo ficou claro que havia algo sistematicamente errado com o Spark, ou talvez apenas precisássemos lavar as mãos com mais frequência. Se as pilhas Hadoop/MapReduce/Lucene foram feitas por programadores suficientemente experientes, como é óbvio se olharmos de forma crítica o código fonte em Java ou as ideias de Doug Cutting em Lucene, o Spark, de repente, foi escrito em uma linguagem exótica muito debatida do ponto de vista da praticidade e que atualmente não está sendo desenvolvida, o Scala. O colapso regular das computações no cluster Spark devido à alocação de memória ilógica e não muito transparente para operações de redução (muitos chaves chegam de uma vez) criou ao seu redor a aura de algo que ainda tem espaço para crescer. Além disso, a situação foi agravada pelo grande número de portas abertas estranhas, arquivos temporários crescendo nos lugares mais inesperados e uma infinidade de dependências do jar — o que provocava nos administradores de sistema uma sensação conhecida desde a infância: ódio feroz (ou talvez deveríamos ter lavado as mãos com sabão).
Nós, como resultado, "sobrevivemos" a vários projetos analíticos internos que utilizavam ativamente o Apache Spark (incluindo Spark Streaming, Spark SQL) e o ecossistema Hadoop (e por aí vai). Apesar de termos aprendido a "preparar" isso de maneira razoável e monitorá-lo e "ele" praticamente parou de falhar repentinamente devido à mudança no caráter dos dados e ao desbalanceamento do hash uniforme do RDD, o desejo de pegar algo que já estivesse pronto, atualizado e gerenciado em algum lugar na nuvem se intensificou cada vez mais. Foi nesse momento que tentamos usar uma distribuição cloud ready da Amazon Web Services — e, posteriormente, tentamos resolver tarefas já nela. O EMR é o Apache Spark preparado pela Amazon com software adicional da ecossistema, aproximadamente como as distribuições da Cloudera/Hortonworks.
"Armazenamento de arquivos elástico para análise — uma necessidade urgente"
A experiência de "preparar" Hadoop/Spark com queimaduras em diversas partes do corpo não foi em vão. Começou a se tornar cada vez mais clara a necessidade de criar um armazenamento de arquivos único, acessível e confiável, que fosse resistente a falhas de hardware e onde se pudesse armazenar arquivos em diferentes formatos de diferentes sistemas, realizando coletas de dados para relatórios de maneira eficiente e em um tempo razoável.
Também gostaria que a atualização do software desta plataforma não se tornasse um pesadelo de noite de Ano Novo, com a leitura de rastros Java de 20 páginas e a análise de quilômetros de logs detalhados do funcionamento do cluster usando o Spark History Server e uma lupa com iluminação. Gostaria de ter uma ferramenta simples e transparente que não exigisse mergulhos regulares sob o capô, caso o desenvolvedor parasse de executar uma consulta MapReduce padrão devido à falta de memória do worker responsável pela redução dos dados, devido a um algoritmo de particionamento de dados de entrada mal escolhido.
Amazon S3 — um candidato a DataLake?
A experiência de trabalhar com Hadoop/MapReduce me ensinou que precisamos de um sistema de arquivos confiável e escalável e, acima disso, workers escaláveis que venham mais perto dos dados para não transferir dados pela rede. Os workers devem ser capazes de ler dados em diferentes formatos, mas, preferencialmente, não ler informações desnecessárias e que seja possível armazenar os dados antecipadamente em formatos convenientes para os workers.
Mais uma vez — a ideia principal. Não há desejo de "carregar" grandes dados em um único motor de análise em cluster, que eventualmente vai se afogar e precisará ser shardado de forma pouco estética. Queremos armazenar arquivos, apenas arquivos, em um formato compreensível e executar consultas analíticas eficazes com várias ferramentas, mas claras. E a quantidade de arquivos em diferentes formatos só vai aumentar. E é melhor shardar os dados de entrada, não o motor. Precisamos de um DataLake escalável e universal, decidimos nós...
E se armazenássemos arquivos em um armazenamento em nuvem escalável e familiar para muitos, como o Amazon S3, sem nos preocuparmos em fazer nossas próprias misturas com o Hadoop?
Entendido, dados pessoais "não podem", mas e outros dados, se os transferirmos e os "usarmos de forma eficaz"?
O ecossistema de análise de big data em cluster da Amazon Web Services — em termos muito simples
Com base na nossa experiência com o AWS, o Apache Hadoop/MapReduce é amplamente utilizado lá há muito tempo e de várias maneiras, por exemplo, no serviço DataPipeline (invejo meus colegas, eles realmente aprenderam a usá-lo corretamente). Aqui configuramos backups de diferentes serviços a partir de tabelas DynamoDB:
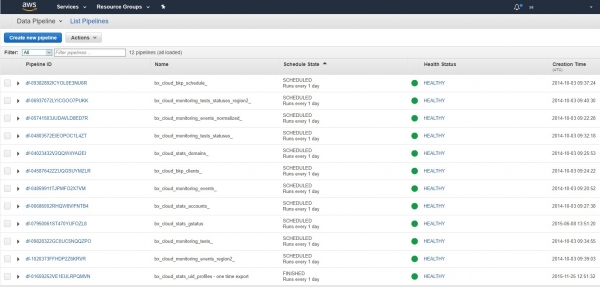
E eles são executados regularmente em clusters integrados de Hadoop/MapReduce como um relógio há vários anos. "Configurou e esqueceu":
Além disso, é possível realizar de forma eficaz o datascience, criando notebooks Jupiter na nuvem para analistas e utilizando o AWS SageMaker para treinar e implantar modelos de IA. Veja como isso funciona para nós:
E sim, você pode criar um notebook na nuvem para si ou para um analista e conectá-lo a um cluster Hadoop/Spark, fazer os cálculos e, em seguida, "apertar os parafusos":
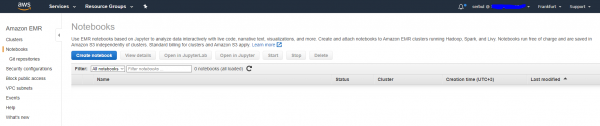
É realmente conveniente para projetos analíticos individuais e, para alguns, utilizamos com sucesso o serviço EMR para cálculos em grande escala e análises. E quanto a uma solução sistemática para DataLake, será que conseguimos? Nesse momento, estávamos à beira da esperança e do desespero, continuando a busca.
AWS Glue – uma versão equipada do Apache Spark "potencializada".
Descobrimos que a AWS possui uma versão "própria" do stack "Hive/Pig/Spark". O papel do Hive, ou seja, o catálogo de arquivos e seus tipos no DataLake é desempenhado pelo serviço "Data catalog", que não esconde sua compatibilidade com o formato Apache Hive. Nesse serviço, você deve adicionar informações sobre onde seus arquivos estão e em qual formato. Os dados podem estar não apenas no S3, mas também em bancos de dados, mas isso não será discutido neste post. Veja como o catálogo de dados DataLake está organizado para nós:
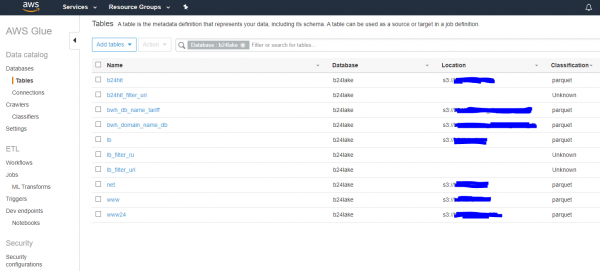
Os arquivos estão registrados, ótimo. Se os arquivos forem atualizados, iniciamos manualmente ou programados crawlers que atualizarão as informações no lago e as salvarão. A partir daí, os dados do lago podem ser processados e os resultados enviados para algum lugar. No caso mais simples, exportamos também para o S3. O processamento de dados pode ser feito em qualquer lugar, mas recomenda-se configurar o processo de processamento em um cluster Apache Spark utilizando as funcionalidades avançadas via API AWS Glue. Basicamente, você pode pegar o bom e velho código em Python utilizando a biblioteca pyspark e configurá-lo para execução em N nós de um cluster de alguma capacidade, com monitoramento, sem precisar mexer nas entranhas do Hadoop e arrastar contêineres de docker, ou resolver conflitos de dependência.
Mais uma vez – uma ideia simples. Não é necessário configurar o Apache Spark, basta escrever o código em Python para pyspark, testá-lo localmente na sua área de trabalho e, em seguida, executá-lo em um grande cluster na nuvem, especificando onde estão os dados de origem e onde salvar o resultado. Às vezes, isso é necessário e útil, e é assim que está configurado para nós:
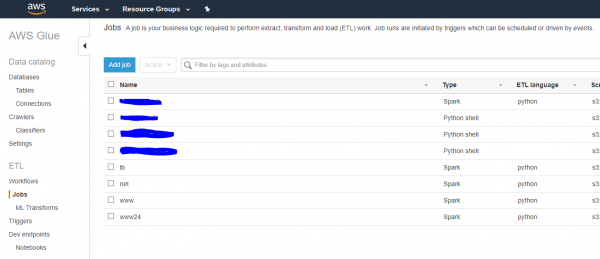
Assim, se precisar fazer algum cálculo em um cluster Spark com dados no S3 – escreva o código em python/pyspark, teste e siga em frente para a nuvem.
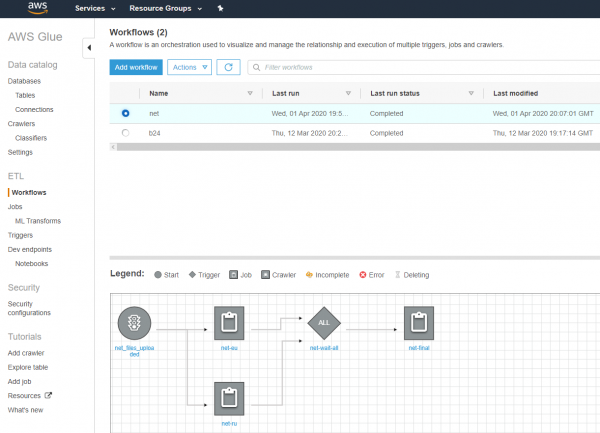
E quanto à orquestração? E se uma tarefa falhar e desaparecer? Sim, é proposto criar um pipeline bonito no estilo Apache Pig e até tentamos isso, mas decidimos por enquanto usar nossa orquestração profundamente personalizada em PHP e JavaScript (eu entendo, isso gera um certo dissonância cognitiva, mas funciona, há anos e sem erros).
O formato dos arquivos armazenados no lago é a chave para o desempenho
É muito, muito importante entender mais dois pontos-chave. Para que as consultas sobre os dados dos arquivos no lago sejam executadas da forma mais rápida possível e o desempenho não degrade ao adicionar novas informações, é necessário:
- Manter as colunas dos arquivos separadas (para não precisar ler todas as linhas para entender o que há nas colunas). Para isso, adotamos o formato parquet com compressão
- É muito importante shardear os arquivos em pastas, na forma de: idioma, ano, mês, dia, semana. Motores que compreendem esse tipo de sharding verão apenas as pastas necessárias, sem ter que escanear todos os dados.
Basicamente, dessa forma, você apresenta os dados de origem da maneira mais eficiente para os mecanismos analíticos que podem acessar e ler seletivamente apenas as colunas necessárias dessas pastas shardadas. Não é necessário 'carregar' dados em nenhum lugar (o armazenamento simplesmente estouraria) — apenas coloque-os de forma sensata no sistema de arquivos no formato correto. É claro que deve ficar claro que armazenar um enorme arquivo csv no DataLake, que precisa ser lido linha por linha pelo cluster para extrair colunas — não é muito sensato. Reflita sobre os dois pontos mencionados acima novamente, se ainda não está claro para que tudo isso.
AWS Athena — um 'gênio' da lâmpada mágica
E aqui, ao criar o lago, nos deparamos casualmente com o Amazon Athena. De repente, ficou claro que, ao organizar adequadamente nossos enormes arquivos de log em shards e pastas no formato de colunas (parquet), é possível fazer seleções extremamente informativas rapidamente e construir relatórios SEM, sem um cluster Apache Spark/Glue.
O mecanismo Athena, que opera sobre dados no s3, é baseado no lendário — representante da família de abordagens MPP (processamento paralelo massivo) para processamento de dados, que obtém dados onde eles estão, de s3 e Hadoop a Cassandra e arquivos de texto comuns. Basta pedir ao Athena para executar uma consulta SQL e então tudo "funciona rápido e automaticamente". É importante notar que o Athena é "inteligente", ele acessa apenas as pastas shardadas necessárias e lê apenas as colunas relevantes na consulta.
Os pedidos ao Athena também são tarifados de forma interessante. Pagamos por . Ou seja, não pagamos pelo número de máquinas no cluster por minuto, mas… pelos dados realmente escaneados em 100-500 máquinas, apenas os necessários para realizar a consulta.
E ao solicitar apenas as colunas necessárias das pastas corretamente shardadas, descobrimos que o serviço Athena nos custa dezenas de dólares por mês. É maravilhoso, quase de graça, em comparação com a análise em clusters!
Aqui está, aliás, como shardamos nossos dados no s3:
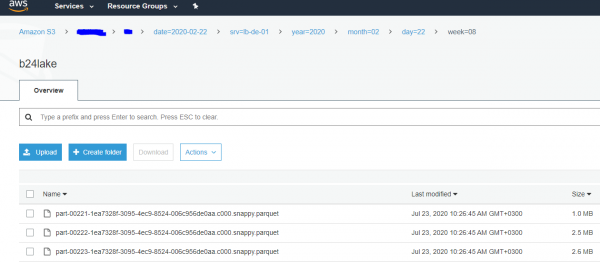
Como resultado, em pouco tempo, diferentes departamentos da empresa, desde segurança da informação até análise, começaram a fazer pedidos ao Athena e rapidamente, em segundos, obter respostas úteis de grandes dados ao longo de períodos consideráveis: meses, semestres, etc.
Mas fomos além e começamos a buscar respostas na nuvem : analista na console habitual escreve uma consulta SQL que, em 100-500 máquinas, "por centavos" vasculha os dados no s3 e retorna a resposta geralmente em segundos. Conveniente. E rápido. Até agora parece inacreditável.
Como resultado, decidindo armazenar dados no s3, em um formato de coluna eficiente e com uma fragmentação razoável dos dados por pastas… obtivemos um DataLake e um motor analítico rápido e barato — gratuitamente. E ele se tornou muito popular na empresa, pois entende SQL e funciona ordens de grandeza mais rápido do que por meio do início/parada/configuração de clusters. "E se o resultado é o mesmo, por que pagar mais?"
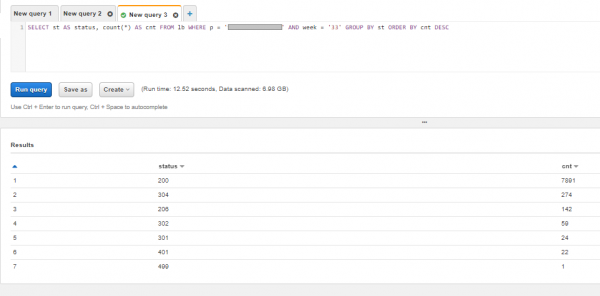
Uma consulta ao Athena se parece mais ou menos com isto. Se desejado, claro, pode-se formular uma complexa e multi-página, mas vamos nos limitar a uma simples agregação. Vamos ver quais códigos de resposta o cliente teve há algumas semanas nos logs do servidor web e garantir que não há erros:
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
Após um caminho que não posso dizer que foi longo, mas foi doloroso, avaliando constantemente os riscos, o nível de complexidade e o custo de suporte, encontramos uma solução para DataLake e análise que nos agrada tanto pela velocidade quanto pelo custo de propriedade.
Descobrimos que construir um DataLake eficiente, rápido e barato para as necessidades de departamentos completamente diferentes da empresa é uma tarefa que mesmo desenvolvedores experientes, que nunca trabalharam como arquitetos e não sabem desenhar quadrados em quadrados com setas, podem realizar, conhecendo 50 termos da ecossistema Hadoop.
No início do caminho, a cabeça doía com a quantidade de zoológicos loucos de softwares abertos e fechados e a compreensão do peso da responsabilidade para com as futuras gerações. Basta começar a construir seu DataLake a partir de ferramentas simples: nagios/munin -> elastic/kibana -> Hadoop/Spark/s3..., coletando feedback e entendendo profundamente a física dos processos que ocorrem. Deixe tudo o que é complicado e obscuro para inimigos e concorrentes.
Se você não quer ir para a nuvem e gosta de manter, atualizar e corrigir projetos abertos, pode construir uma estrutura semelhante à nossa localmente, em máquinas de escritório baratas com Hadoop e Presto em cima. O principal é não parar e seguir em frente, contar, buscar soluções simples e claras, e tudo dará certo! Boa sorte a todos e até a próxima!
Fonte: habr.com
