

Meu nome é Pavel Parkhomenko, sou desenvolvedor de ML. Neste artigo, gostaria de falar sobre o funcionamento do serviço Yandex Zen e compartilhar melhorias técnicas que permitiram aumentar a qualidade das recomendações. Neste post, você aprenderá como encontrar entre milhões de documentos os mais relevantes para o usuário em apenas alguns milissegundos; como realizar a decomposição contínua de uma grande matriz (composta por milhões de colunas e dezenas de milhões de linhas), para que novos documentos recebam seu vetor em apenas algumas dezenas de minutos; como reutilizar a decomposição da matriz usuário-artigo, para obter uma boa representação vetorial para vídeos.
Nossa base de recomendações contém milhões de documentos de diferentes formatos: artigos de texto, criados em nossa plataforma e extraídos de sites externos, vídeos, narrativas e posts curtos. O desenvolvimento de um serviço como este está associado a muitos desafios técnicos. Aqui estão alguns deles:
- Dividir as tarefas computacionais: realizar todas as operações pesadas offline e na hora, executar apenas a aplicação rápida dos modelos, para responder em 100-200 ms.
- Considerar rapidamente as ações do usuário. Para isso, é necessário que todos os eventos sejam instantaneamente entregues ao recomendador e impactem os resultados das modelos.
- Fazer com que o feed se adapte rapidamente ao comportamento dos novos usuários. As pessoas que chegam ao sistema devem sentir que seu feedback influencia as recomendações.
- Compreender rapidamente a quem recomendar um novo artigo.
- Reagir rapidamente ao constante surgimento de novo conteúdo. Dezena de milhares de artigos são lançados todos os dias, e muitos deles têm uma vida útil limitada (como notícias, por exemplo). Isso os diferencia de filmes, músicas e outros conteúdos que têm uma longa duração e são mais caros para criar.
- Transferir conhecimentos de um domínio para outro. Se em um sistema de recomendação existem modelos treinados para artigos de texto e acrescentamos vídeos a ele, podemos reutilizar os modelos existentes para que o novo tipo de conteúdo seja melhor classificado.
Vou contar como resolvemos esses desafios.
Seleção de candidatos
Como reduzir, em poucos milissegundos, a quantidade de documentos considerados em milhares de vezes, sem praticamente piorar a qualidade da classificação?
Suponha que treinamos muitos modelos de ML, geramos recursos a partir deles e treinamos outro modelo que classifica documentos para o usuário. Tudo estaria bem, mas não se pode simplesmente calcular todos os recursos para todos os documentos em tempo real, se esses documentos são milhões e as recomendações precisam ser feitas em 100-200 ms. A tarefa é escolher de milhões um subconjunto que será classificado para o usuário. Essa etapa é geralmente chamada de seleção de candidatos. Existem alguns requisitos para isso. Em primeiro lugar, a seleção deve ser muito rápida, para que o tempo para a própria classificação seja maximizado. Em segundo lugar, ao reduzir significativamente o número de documentos para a classificação, devemos preservar ao máximo os documentos relevantes para o usuário.
O nosso princípio de seleção de candidatos evoluiu ao longo do tempo, e atualmente chegamos a um esquema em várias etapas:
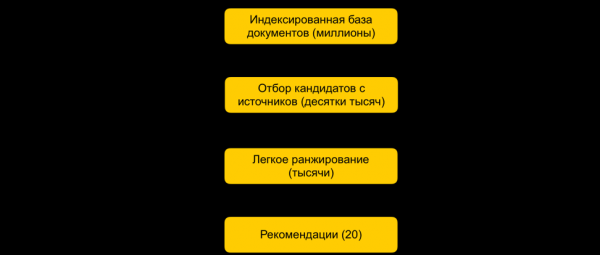
Primeiro, todos os documentos são divididos em grupos, e dos grupos são selecionados os documentos mais populares. Os grupos podem ser sites, temas, clusters. Para cada usuário, com base em seu histórico, são selecionados os grupos mais próximos e, a partir deles, são escolhidos os melhores documentos. Também usamos um índice kNN para encontrar os documentos mais próximos do usuário em tempo real. Existem vários métodos para a construção do índice kNN, e o que melhor funcionou para nós foi (Hierarchical Navigable Small World graphs). Este é um modelo hierárquico que permite encontrar, em poucos milissegundos, os N vetores mais próximos para o usuário a partir de uma base de milhões. Inicialmente, indexamos toda a nossa base de documentos offline. Como a busca no índice é bastante rápida, é possível, se tivermos vários embeddings fortes, criar vários índices (um para cada embedding) e consultar cada um deles em tempo real.
Temos dezenas de milhares de documentos para cada usuário. Isso ainda é muito para contar todas as características, então, neste estágio, aplicamos uma classificação leve — um modelo simplificado de classificação pesada com menos características. O objetivo é prever quais documentos estarão no topo do modelo pesado. Os documentos com a maior previsão serão usados no modelo pesado, ou seja, na última etapa de classificação. Essa abordagem permite, em dezenas de milissegundos, reduzir a base de documentos considerados para o usuário de milhões para milhares.
Passo ALS em tempo de execução
Como considerar o feedback do usuário imediatamente após o clique?
Um fator importante nas recomendações é o tempo de resposta ao feedback do usuário. Isso é especialmente crucial para novos usuários: quando alguém começa a usar o sistema de recomendações, recebe um feed não personalizado com uma variedade de documentos. Assim que faz o primeiro clique, é necessário levar isso em conta imediatamente e se ajustar aos seus interesses. Se calculássemos todos os fatores offline, a rápida reação do sistema se tornaria impossível devido ao atraso. Portanto, é necessário processar as ações do usuário em tempo real. Para esses fins, usamos o passo ALS em tempo de execução para construir a representação vetorial do usuário.
Suponha que temos uma representação vetorial para todos os documentos. Por exemplo, podemos offline, com base no texto do artigo, construir embeddings usando ELMo, BERT ou outros modelos de aprendizado de máquina. Como podemos obter a representação vetorial dos usuários neste mesmo espaço com base em suas interações no sistema?
Princípio geral de formação e decomposição da matriz usuário-documentoSuponha que temos m usuários e n documentos. Para alguns usuários, sabemos a relação deles com alguns documentos. Então, essa informação pode ser representada na forma de uma matriz m x n: as linhas correspondem aos usuários, e as colunas — aos documentos. Como a maioria dos documentos não foi vista pela pessoa, a maior parte das células da matriz permanecerá vazia, enquanto outras estarão preenchidas. Para cada evento (curtida, descurtida, clique) na matriz, está previsto algum valor — mas vamos considerar um modelo simplificado, onde a curtida corresponde a 1 e a descurtida a -1.
Vamos decompor a matriz em duas: P (m x d) e Q (d x n), onde d é a dimensão da representação vetorial (geralmente um número pequeno). Assim, cada objeto terá um vetor d-dimensional (o usuário — uma linha na matriz P, o documento — uma coluna na matriz Q). Esses vetores serão os embeddings dos respectivos objetos. Para prever se um usuário gostará de um documento, podemos simplesmente multiplicar seus embeddings.
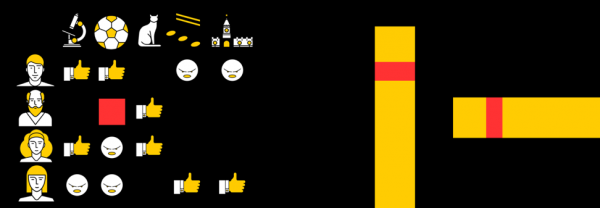
Um dos possíveis métodos de decomposição de matriz é o ALS (Alternating Least Squares). Vamos otimizar a seguinte função de perda:

Aqui, rui é a interação do usuário u com o documento i, qi é o vetor do documento i, pu é o vetor do usuário u.
Então, o vetor do usuário otimizado em termos de erro quadrático médio (com vetores de documentos fixos) é encontrado analiticamente através da solução da respectiva regressão linear.
Isso é chamado de "passo ALS". O próprio algoritmo ALS consiste em fixar alternadamente uma das matrizes (dos usuários e dos artigos) e atualizar a outra, encontrando a solução ótima.
Felizmente, encontrar a representação vetorial do usuário é uma operação bastante rápida que pode ser realizada em tempo real, utilizando instruções vetoriais. Esse truque permite que o feedback do usuário seja considerado imediatamente na classificação. O mesmo embedding pode ser utilizado em um índice kNN para melhorar a seleção de candidatos.
Filtragem colaborativa distribuída
Como realizar a fatoração matricial distribuída incremental e encontrar rapidamente a representação vetorial de novos artigos?
O conteúdo não é a única fonte de sinais para recomendações. Outra fonte importante é a informação colaborativa. Bons sinais em classificação tradicionalmente podem ser obtidos a partir da decomposição da matriz usuário-documento. No entanto, ao tentar fazer essa decomposição, encontramos problemas:
1. Temos milhões de documentos e dezenas de milhões de usuários. A matriz não cabe inteira em uma única máquina, e a decomposição será muito lenta.
2. A maior parte do conteúdo no sistema tem um curto tempo de vida: os documentos permanecem relevantes apenas por algumas horas. Portanto, é necessário construir sua representação vetorial o mais rápido possível.
3. Se construirmos a decomposição logo após a publicação do documento, ele não terá sido avaliado por um número suficiente de usuários. Assim, sua representação vetorial provavelmente não será muito boa.
4. Se um usuário der um like ou dislike, não poderemos considerar isso imediatamente na decomposição.
Para resolver os problemas listados, implementamos uma decomposição distribuída da matriz usuário-documento com atualização incremental frequente. Como isso funciona?
Suponha que temos um cluster de N máquinas (N na casa das centenas) e queremos realizar a decomposição distribuída da matriz, que não cabe em uma única máquina. A questão é como executar essa decomposição de modo que, por um lado, cada máquina tenha dados suficientes e, por outro, que os cálculos sejam independentes?
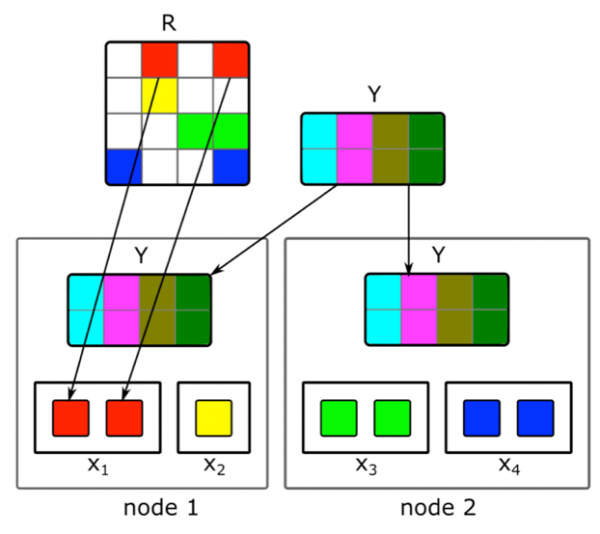
Usaremos o algoritmo de decomposição ALS descrito acima. Vamos considerar como executar distribuidamente um passo do ALS – os passos restantes serão semelhantes. Suponha que temos a matriz de documentos fixada e queremos construir a matriz de usuários. Para isso, vamos dividi-la em N partes por linhas, cada parte contendo aproximadamente o mesmo número de linhas. Enviaremos para cada máquina as células não vazias das linhas correspondentes, bem como a matriz de embeddings dos documentos (por completo). Como ela não é muito grande, e a matriz usuário-documento geralmente é bem esparsa, esses dados caberão em uma máquina comum.
Esse truque pode ser repetido ao longo de várias eras até a convergência do modelo, alternando a matriz fixa. Mas mesmo assim, a decomposição da matriz pode levar várias horas. E isso não resolve o problema de que é necessário obter rapidamente os embeddings de novos documentos e atualizar os embeddings daqueles sobre os quais havia pouca informação ao construir o modelo.
A implementação de uma atualização incremental rápida do modelo nos ajudou. Suponha que temos um modelo treinado atualmente. Desde o seu treinamento, surgiraram novos artigos com os quais nossos usuários interagiram, além de artigos que tiveram pouca interação durante o treinamento. Para obter rapidamente o embedding desses artigos, usamos os embeddings dos usuários obtidos durante o primeiro grande treinamento do modelo e fazemos um passo de ALS para calcular a matriz de documentos com a matriz de usuários fixa. Isso permite obter os embeddings de forma bastante rápida — em poucos minutos após a publicação do documento — e atualizar frequentemente os embeddings de documentos recentes.
Para que as ações da pessoa sejam levadas em conta imediatamente nas recomendações, durante a execução não usamos os embeddings dos usuários obtidos offline. Em vez disso, fazemos um passo de ALS e obtemos o vetor atual do usuário.
Transferência para outro domínio.
Como usar o feedback do usuário em artigos de texto para construir uma representação vetorial de vídeos?
Inicialmente, recomendávamos apenas artigos de texto, portanto, muitos dos nossos algoritmos estão ajustados para esse tipo de conteúdo. Mas ao adicionar conteúdo de outro tipo, nos deparamos com a necessidade de adaptação dos modelos. Como abordamos esse desafio no caso de vídeos? Uma das opções foi re-treinar todos os modelos do zero. Mas isso é demorado e, além disso, parte dos algoritmos é exigente quanto ao tamanho do conjunto de treinamento, que ainda não está disponível em quantidade suficiente para o conteúdo do novo tipo nos primeiros momentos de sua vida no serviço.
Seguimos um caminho diferente e reutilizamos modelos de textos para vídeos. A criação de representações vetoriais de vídeos foi facilitada pelo mesmo truque com ALS. Pegamos a representação vetorial dos usuários com base em textos e fizemos um passo de ALS, utilizando informações sobre visualizações de vídeo. Assim, obtivemos facilmente a representação vetorial do vídeo. E, em tempo de execução, simplesmente calculamos a proximidade entre o vetor do usuário, obtido com base em textos, e o vetor do vídeo.
Conclusão
O desenvolvimento do núcleo de um sistema de recomendação em tempo real envolve diversas tarefas. É preciso processar dados rapidamente e aplicar métodos de ML para utilizar esses dados de forma eficaz; construir sistemas distribuídos complexos, que consigam processar sinais de usuários e novas unidades de conteúdo em um tempo mínimo; entre muitas outras tarefas.
No sistema atual, cuja estrutura descrevi, a qualidade das recomendações para o usuário aumenta conforme sua atividade e duração de permanência no serviço. Mas, claro, aqui reside a principal dificuldade: o sistema tem dificuldade em entender as preferências de uma pessoa que interagiu pouco com o conteúdo. Melhorar as recomendações para novos usuários é nossa tarefa chave. Continuaremos a otimizar os algoritmos para que o conteúdo relevante para a pessoa chegue mais rapidamente ao seu feed, enquanto o conteúdo irrelevante não seja exibido.
Fonte: habr.com
