

Meu nome é Anton Baderin. Trabalho no Centro de Altas Tecnologias e sou responsável pela administração de sistemas. Há um mês, nossa conferência corporativa foi concluída, onde compartilhamos experiências acumuladas com a comunidade de TI da nossa cidade. Falei sobre monitoramento de aplicações web. O material foi destinado a profissionais de nível júnior ou médio, que ainda não implementaram esse processo do zero.
A pedra angular de qualquer sistema de monitoramento é resolver os problemas dos negócios. Monitorar apenas por monitorar não interessa a ninguém. E o que o negócio quer? Que tudo funcione rapidamente e sem erros. O negócio quer proatividade, que identifiquemos problemas no funcionamento do serviço e os solucionemos o mais rápido possível. Essas são, na verdade, as questões que resolvi durante o ano passado em um projeto de um dos nossos clientes.
Sobre o projeto
O projeto é um dos maiores programas de fidelidade do país. Ajudamos redes de varejo a aumentar a frequência de vendas por meio de diversas ferramentas de marketing, como cartões de bônus. No total, o projeto envolve 14 aplicações que operam em dez servidores.
Durante as entrevistas, percebi repetidamente que os administradores nem sempre abordam corretamente o monitoramento de aplicações web: muitos ainda se limitam a métricas do sistema operacional, monitorando serviços apenas ocasionalmente.
No meu caso, anteriormente o sistema de monitoramento do cliente era baseado no Icinga. Isso não resolvia as questões mencionadas anteriormente. Muitas vezes, o cliente nos informava sobre problemas e frequentemente não tínhamos dados suficientes para descobrir a causa.
Além disso, havia uma compreensão clara da falta de perspectivas para seu desenvolvimento futuro. Acho que aqueles que conhecem o Icinga vão entender. Assim, decidimos reestruturar completamente o sistema de monitoramento de aplicações web no projeto.
Prometheus
Escolhemos o Prometheus com base em três indicadores principais:
- Um grande número de métricas disponíveis. No nosso caso, são 60 mil. Claro, vale mencionar que a grande maioria delas não utilizamos (provavelmente cerca de 95%). Por outro lado, todas são relativamente baratas. Para nós, esse é outro extremo, em comparação com o Icinga que usávamos anteriormente. Naquele sistema, adicionar métricas era especialmente difícil: as que existiam eram caras (basta olhar o código-fonte de qualquer plugin). Qualquer plugin era um script em Bash ou Python, cuja execução não é barata em termos de recursos consumidos.
- Este sistema consome uma quantidade relativamente pequena de recursos. Para todas as nossas métricas, são suficientes 600 MB de memória RAM, 15% de um núcleo e algumas dezenas de IOPS. Claro, é necessário executar os exporters de métricas, mas todos eles são escritos em Go e também não são exigentes. Não acho que isso seja um problema nas circunstâncias atuais.
- Oferece a possibilidade de migração para o Kubernetes. Considerando os planos do cliente, a escolha é óbvia.
ELK
Anteriormente, não coletávamos nem processávamos logs. As desvantagens são claras para todos. Optamos pelo ELK, uma vez que já tínhamos experiência com este sistema. Armazenamos apenas os logs das aplicações. Os principais critérios de escolha foram a busca em texto completo e a sua rapidez.
Clickhouse
Inicialmente, a escolha recaiu sobre o InfluxDB. Nós percebíamos a necessidade de coletar logs do Nginx, estatísticas do pg_stat_statements e armazenar dados históricos do Prometheus. Não gostamos do Influx, pois ele ocasionalmente começava a consumir muita memória e caía. Além disso, queríamos agrupar solicitações por remote_addr, mas o agrupamento neste SGBD é apenas por tags. As tags são caras (em termos de memória), e sua quantidade é limitadamente condicional.
Começamos a busca do zero. Precisávamos de uma base analítica com consumo mínimo de recursos, preferencialmente com compressão de dados no disco.
Clickhouse atende a todos esses critérios, e nunca nos arrependemos da escolha. Não escrevemos grandes volumes de dados nele (o número de inserções é de cerca de cinco mil por minuto).
NewRelic
O NewRelic tem sido nosso parceiro historicamente, pois foi a escolha do cliente. Aqui, é usado como APM.
Zabbix
Usamos o Zabbix exclusivamente para monitorar a Black Box de várias APIs.
Definindo a abordagem de monitoramento
Queríamos decompor a tarefa e, assim, sistematizar a abordagem ao monitoramento.
Dividi nossa sistema nos seguintes níveis:
- hardware e VMS;
- sistema operacional;
- serviços do sistema, stack de software;
- aplicativo;
- lógica de negócios.
As vantagens dessa abordagem:
- sabemos quem é responsável pelo funcionamento de cada nível e, a partir disso, podemos enviar alertas;
- podemos usar a estrutura ao suprimir alertas — seria estranho enviar um alerta de indisponibilidade de banco de dados quando a máquina virtual inteira está indisponível.
Como nossa tarefa é identificar falhas no funcionamento do sistema, precisamos destacar em cada nível um conjunto de métricas que devemos observar ao escrever regras de alerta. Vamos passar pelos níveis "VMS", "Sistema Operacional" e "Serviços do Sistema, stack de software".
Máquinas virtuais
Alojamento nos fornece processador, disco, memória e rede. E tivemos problemas com os dois primeiros. Portanto, métricas:
Tempo de CPU roubado — ao comprar uma máquina virtual na Amazon (t2.micro, por exemplo), é necessário entender que você não recebe um núcleo de processador inteiro, mas apenas uma cota de seu tempo. E quando você a esgotar, eles começarão a roubar sua CPU.
Essa métrica permite monitorar esses momentos e tomar decisões. Por exemplo, se é necessário optar por um plano mais robusto ou separar o processamento de tarefas em segundo plano e solicitações de API. servidor.
IOPS + Tempo de espera de CPU — por algum motivo, muitos provedores de hospedagem em nuvem falham em fornecer IOPS suficientes. Além disso, um gráfico com baixos índices de IOPS não é um argumento para eles. Portanto, é importante coletar também o tempo de espera da CPU. Com esse par de gráficos — IOPS baixos e alta espera de I/O — já é possível dialogar com o provedor e resolver o problema.
Sistema operacional
Métricas do sistema operacional:
- quantidade de memória disponível em %;
- atividade de uso de swap: vmstat swapin, swapout;
- quantidade de inodes disponíveis e espaço livre no sistema de arquivos em %
- carga média;
- número de conexões em estado tw;
- preenchimento da tabela conntrack;
- a qualidade do trabalho da rede pode ser monitorada com a ferramenta ss, pacote iproute2 — recebendo dela a métrica RTT das conexões e agrupando por porta de destino.
Além disso, no nível do sistema operacional, temos a entidade processos. É importante destacar no sistema um conjunto de processos que desempenham um papel crucial em sua operação. Se, por exemplo, você tem vários pgpool, deve coletar informações sobre cada um deles.
O conjunto de métricas é o seguinte:
- CPU;
- A memória é, em primeiro lugar, residente;
- IO — preferencialmente em IOPS;
- FileFd — abertos e limite;
- Falhas significativas na página — assim você pode entender qual processo está sendo trocado.
Todo o monitoramento é feito em Docker, usamos o Cadvisor para coletar dados de métricas. Em outras máquinas, aplicamos o process-exporter.
Serviços de sistema, stack de software
Cada aplicativo tem suas próprias especificidades, e é difícil destacar um conjunto específico de métricas.
O conjunto universal é:
- taxa de requisições;
- número de erros;
- latência;
- saturação.
Os exemplos mais marcantes de monitoramento deste nível em nosso sistema são — Nginx e PostgreSQL.
O serviço mais sobrecarregado em nosso sistema é o banco de dados. Antes, tínhamos problemas frequentes para descobrir o que o banco de dados estava fazendo.
Vimos alta carga nos discos, mas os slowlogs não mostravam muita coisa. Resolvemos esse problema com o pg_stat_statements, uma visão que coleta estatísticas de consultas.
Isso é tudo que o administrador precisa.
Construímos gráficos de atividade de requisições de leitura e escrita:
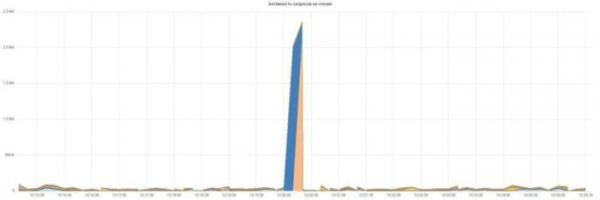
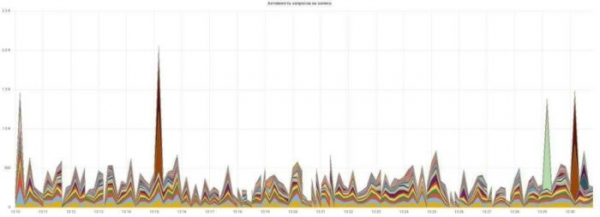
É simples e claro, cada requisição tem sua própria cor.
Um exemplo igualmente notável são os logs do Nginx. Não é surpreendente que poucos os analisem ou os citem na lista de obrigatórios. O formato padrão não é muito informativo e precisa ser estendido.
Pessoalmente, adicionei request_time, upstream_response_time, body_bytes_sent, request_length, request_id. Construímos gráficos de tempo de resposta e número de erros:
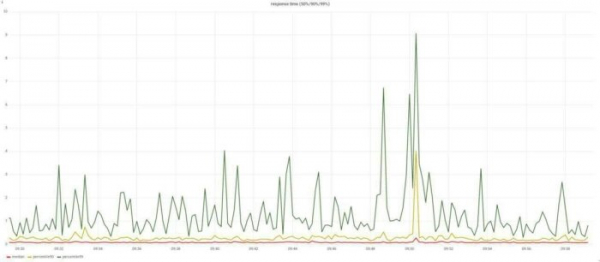
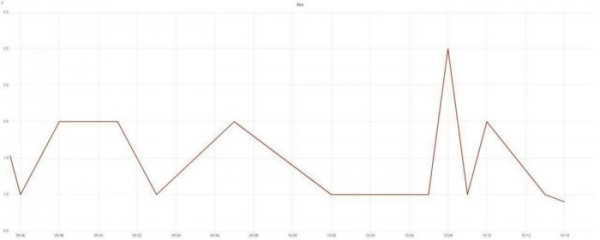
Construímos gráficos de tempo de resposta e número de erros. Lembre-se? Eu falei sobre as tarefas de negócios? Para serem rápidas e sem erros? Já resolvemos essas questões com dois gráficos. E com eles, já é possível contatar os administradores de plantão.
Mas ainda resta um problema — garantir a rápida resolução das causas do incidente.
Resolução de incidentes
Todo o processo desde a identificação até a resolução do problema pode ser dividido em várias etapas:
- identificação do problema;
- notificação do administrador de plantão;
- reação ao incidente;
- eliminação das causas.
É importante que façamos isso o mais rápido possível. E se nas etapas de identificação do problema e envio da notificação não conseguimos economizar muito tempo — dois minutos serão necessários de qualquer forma, as etapas seguintes são um campo inexplorado para melhorias.
Vamos imaginar que o telefone do atendente tocou. O que ele vai fazer? Procurar respostas para perguntas — o que quebrou, onde quebrou, como reagir? É assim que respondemos a essas perguntas:
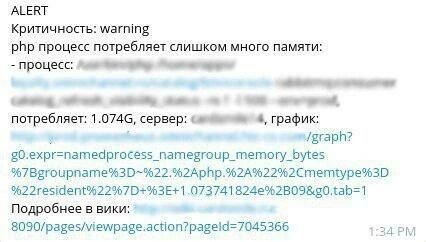
Nós simplesmente incluímos todas essas informações no texto da notificação, fornecendo um link para a página da wiki que descreve como reagir a esse problema, como resolvê-lo e escalá-lo.
Ainda não mencionei o nível de aplicação e lógica de negócios. Infelizmente, nossos aplicativos ainda não implementaram a coleta de métricas. A única fonte de alguma informação nesses níveis são os logs.
Alguns pontos importantes.
Primeiro, escreva logs estruturados. Não inclua o contexto no texto da mensagem. Isso dificulta sua agrupamento e análise. O Logstash leva muito tempo para normalizar tudo isso.
Em segundo lugar, use corretamente os níveis de severidade. Cada linguagem tem seu próprio padrão. Pessoalmente, destaco quatro níveis:
- não existem erros;
- erro do lado do cliente;
- erro do nosso lado, sem perda de dinheiro e sem riscos;
- erro do nosso lado, com perda de dinheiro.
Resumindo. Precisamos tentar construir o monitoramento a partir da lógica de negócios. Devemos nos esforçar para monitorar o próprio aplicativo e operar com métricas como número de vendas, número de novos registros de usuários, número de usuários ativos no momento e assim por diante.
Se todo o seu negócio é apenas um botão no navegador, é necessário monitorar se ele está sendo clicado e se está funcionando corretamente. Tudo o mais não importa.
Se você não tem isso, pode tentar compensar nos logs do aplicativo, logs do Nginx e assim por diante, como fizemos. Você deve estar o mais próximo possível do aplicativo.
As métricas do sistema operacional são, claro, importantes, mas não interessam ao negócio, nós não somos pagos por elas.
Fonte: habr.com
