

Olá a todos, meu nome é Alexandre, trabalho na CIAN como engenheiro e sou responsável pela administração de sistemas e automação de processos de infraestrutura. Nos comentários de um dos artigos anteriores, fomos solicitados a explicar de onde obtemos 4 TB de logs por dia e o que fazemos com eles. Sim, temos muitos logs, e para processá-los, criamos um cluster de infraestrutura separado que nos permite resolver problemas de forma rápida. Neste artigo, contarei como, ao longo de um ano, adaptamos esse cluster para lidar com o fluxo de dados em constante crescimento.
Como começamos
Nos últimos anos, a carga no cian.ru cresceu muito rapidamente, e no terceiro trimestre de 2018, o site alcançou 11,2 milhões de usuários únicos por mês. Naquela época, em momentos críticos, perdíamos até 40% dos logs, o que impedia nossa capacidade de responder rapidamente a incidentes, fazendo com que gastássemos muito tempo e esforço para resolvê-los. Além disso, muitas vezes não conseguíamos encontrar a causa do problema, e ele se repetia após algum tempo. Foi um verdadeiro inferno que precisava ser resolvido.
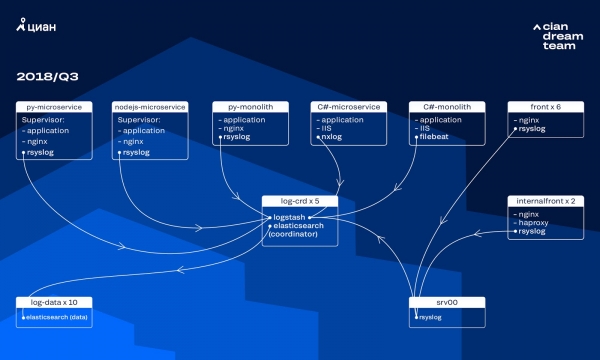
Naquela época, para armazenar os logs, utilizávamos um cluster de 10 data nodes com ElasticSearch versão 5.5.2 e configurações de índice padrão. Ele foi implementado há mais de um ano como uma solução popular e acessível: naquela época, o fluxo de logs não era tão grande, e não havia sentido em criar configurações não convencionais.
O processamento dos logs de entrada era realizado pelo Logstash em diferentes portas em cinco coordenadores do ElasticSearch. Um índice, independentemente do tamanho, consistia em cinco shards. Havia rotação horária e diária, resultando na criação de cerca de 100 novos shards a cada hora. Enquanto os logs não eram muito numerosos, o cluster conseguia lidar e ninguém prestava atenção nas suas configurações.
Problemas de crescimento rápido
O volume de logs gerados cresceu muito rapidamente, pois dois processos se sobrepuseram. Por um lado, o número de usuários do serviço estava aumentando. Por outro lado, começamos a transitar ativamente para uma arquitetura de microserviços, dividindo nossos antigos monólitos em C# e Python. Vários novos microserviços, que substituíam partes do monólito, geravam significativamente mais logs para o cluster de infraestrutura.
A escalabilidade nos levou a um ponto onde o cluster se tornou praticamente incontrolável. Quando os logs começaram a chegar a uma taxa de 20 mil mensagens por segundo, a rotação frequente e inútil aumentou o número de shards para 6 mil, e cada nó estava lidando com mais de 600 shards.
Isso causava problemas de alocação de memória, e quando um nó falhava, todos os shards se deslocavam simultaneamente, multiplicando o tráfego e sobrecarregando os outros nós, tornando quase impossível gravar dados no cluster. E durante esse período, ficamos sem logs. E quando havia um problema com servidor perdíamos 1/10 do cluster no geral. A grande quantidade de índices pequenos tornava as coisas ainda mais complicadas.
Sem logs, não entendíamos as causas do incidente e podíamos, cedo ou tarde, cometer os mesmos erros novamente, o que era inaceitável para a nossa equipe, já que todos os mecanismos de trabalho estavam exatamente voltados para o oposto — nunca repetir os mesmos problemas. Para isso, precisávamos de um volume completo de logs e a entrega deles praticamente em tempo real, uma vez que a equipe de engenheiros de plantão monitorava alertas não apenas de métricas, mas também de logs. Para entender a magnitude do problema — na época, o volume total de logs era de cerca de 2 TB por dia.
Estabelecemos a meta de eliminar completamente a perda de logs e reduzir o tempo de entrega no cluster ELK para no máximo 15 minutos durante situações de emergência (esse número se tornou um KPI interno).
Um novo mecanismo de rotação e nós hot-warm
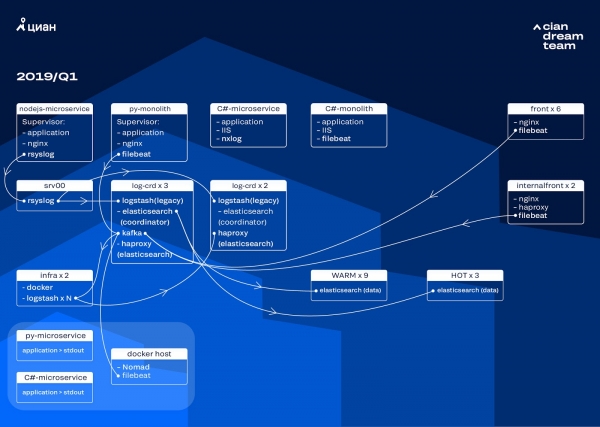
Iniciamos a transformação do cluster com a atualização da versão do ElasticSearch de 5.5.2 para 6.4.3. Mais uma vez, o cluster da versão 5 caiu, e decidimos desligá-lo e atualizá-lo completamente — afinal, não havia logs. Portanto, essa transição foi feita em apenas algumas horas.
A transformação mais significativa nesta fase foi a implementação em três nós com um coordenador atuando como um buffer intermediário do Apache Kafka. O broker de mensagens nos livrou da perda de logs durante problemas com o ElasticSearch. Ao mesmo tempo, adicionamos 2 nós ao cluster e migramos para uma arquitetura hot-warm com três nós "quentes", distribuídos em diferentes racks no data center. Neles, redirecionamos os logs que não podiam ser perdidos de jeito nenhum — nginx, além dos logs de erros das aplicações. Os outros nós receberam logs menores — debug, warning, etc., e após 24 horas, os "logs importantes" foram transferidos dos nós "quentes".
Para não aumentar a quantidade de índices pequenos, passamos da rotação por tempo para o mecanismo de rollover. Havia muitas informações em fóruns sobre a confiabilidade insatisfatória da rotação por tamanho do índice, por isso decidimos usar a rotação pelo número de documentos no índice. Analisamos cada índice e registramos a quantidade de documentos após a qual a rotação deve ser acionada. Assim, conseguimos um tamanho de shard otimizado — não mais que 50 GB.
Otimização do cluster
No entanto, não nos livramos completamente dos problemas. Infelizmente, ainda surgiam pequenos índices: eles não atingiam o tamanho necessário, não eram rotacionados e eram removidos pela limpeza global dos índices mais antigos que três dias, pois eliminamos a rotação por data. Isso resultou na perda de dados, pois o índice desaparecia completamente do cluster, e a tentativa de gravação em um índice inexistente quebrava a lógica do curator que utilizávamos para gerenciamento. O alias para gravação era transformado em índice e quebrava a lógica do rollover, causando um crescimento descontrolado de alguns índices até 600 GB.
Por exemplo, para a configuração de rotação:
curator-elk-rollover.yaml

---
actions:
  1:
    action: rollover
    options:
      name: "nginx_write"
      conditions:
        max_docs: 100000000
  2:
    action: rollover
    options:
      name: "python_error_write"
      conditions:
        max_docs: 10000000
Na ausência do rollover alias, ocorreu um erro:
ERROR     alias "nginx_write" not found.
ERROR     Failed to complete action: rollover.  : Unable to perform index rollover with alias "nginx_write".
Nós deixamos a solução desse problema para a próxima iteração e nos concentramos em outra questão: mudamos para a lógica de trabalho pull do Logstash, que lida com o processamento dos logs de entrada (remoção de informações desnecessárias e enriquecimento). Colocamos-no em um docker, que iniciamos através do docker-compose, e também hospedamos o logstash-exporter, que fornece métricas ao Prometheus para monitoramento em tempo real do fluxo de logs. Assim, permitimos a nós mesmos mudar suavemente o número de instâncias do logstash responsáveis pelo processamento de cada tipo de log.
Enquanto aprimorávamos o cluster, o tráfego do cian.ru cresceu para 12,8 milhões de usuários únicos por mês. Como resultado, nossas transformações acabaram não acompanhando as mudanças no ambiente de produção, e enfrentamos o problema de que os nós 'quentes' não conseguiam lidar com a carga e estavam atrasando toda a entrega dos logs. Recebíamos os dados 'quentes' sem falhas, mas a entrega dos demais exigia intervenção manual para fazer o rollover e distribuir os índices de forma equilibrada.
Com isso, a escalabilidade e a alteração das configurações das instâncias do logstash no cluster tornavam-se complicadas, pois era um docker-compose local, e todas as ações eram realizadas manualmente (para adicionar novos endpoints, era necessário acessar manualmente todos os servidores e executar docker-compose up -d em cada um deles).
Redistribuição dos logs
Em setembro deste ano, ainda continuávamos a desmembrar o monólito, a carga no cluster aumentava, e o fluxo de logs se aproximava de 30 mil mensagens por segundo.
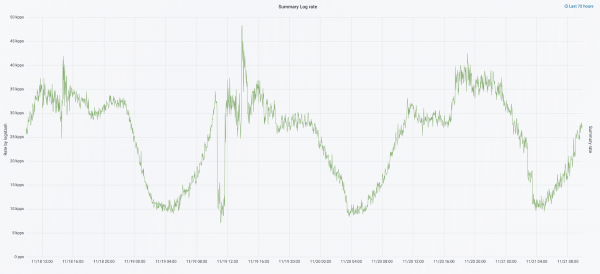
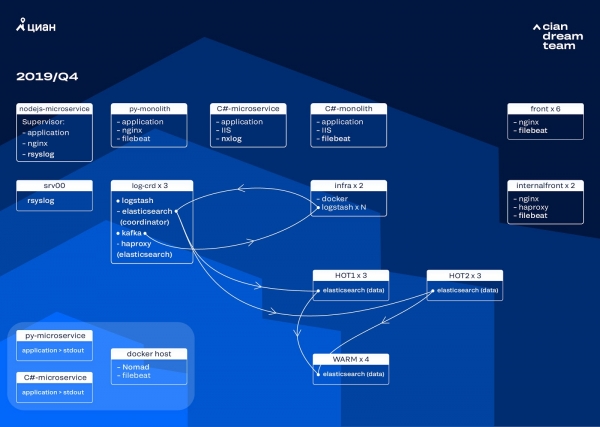
Começamos a próxima iteração com uma atualização de hardware. Passamos de cinco coordenadores para três, trocamos os nós de dados e ganhamos em custo e armazenamento. Para os nós, usamos duas configurações:
- Para os nós 'quentes': E3-1270 v6 / 960Gb SSD / 32 Gb x 3 x 2 (3 para Hot1 e 3 para Hot2).
- Para os nós 'quentes': E3-1230 v6 / 4Tb SSD / 32 Gb x 4.
Nesta iteração, movemos o índice com os logs de acesso dos microserviços, que ocupa tanto espaço quanto os logs dos frontais nginx, para o segundo grupo de três nós 'quentes'. Agora, armazenamos os dados nos nós 'quentes' por 20 horas, e depois os transferimos para os 'quentes' junto com os outros logs.
Resolvemos o problema do desaparecimento dos pequenos índices ajustando a rotação deles. Agora, os índices são rotacionados a cada 23 horas, mesmo que haja poucos dados. Isso aumentou ligeiramente o número de shards (agora são cerca de 800), mas do ponto de vista de desempenho do cluster, isso é aceitável.
Como resultado, o cluster ficou com seis nós 'quentes' e apenas quatro 'frios'. Isso causa um pequeno atraso nas consultas em grandes intervalos de tempo, mas um aumento no número de nós no futuro resolverá esse problema.
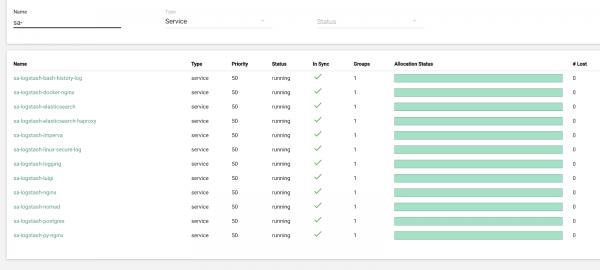
Nesta iteração, também corrigimos o problema da falta de escalonamento semi-automático. Para isso, implantamos um cluster de infraestrutura Nomad — semelhante ao que já temos em produção. Por enquanto, o número de Logstash não é ajustado automaticamente de acordo com a carga, mas chegaremos lá.
Planos futuros
A configuração implementada escala muito bem, e atualmente armazenamos 13,3 TB de dados — todos os logs de 4 dias, necessários para a análise rápida de alertas. Parte dos logs estamos convertendo em métricas, que armazenamos no Graphite. Para facilitar o trabalho dos engenheiros, temos métricas para o cluster de infraestrutura e scripts para a correção semi-automática de problemas típicos. Após o aumento do número de nós de dados, planejado para o próximo ano, mudaremos o armazenamento de dados de 4 para 7 dias. Isso será suficiente para o trabalho operacional, pois sempre tentamos investigar incidentes o mais rápido possível, enquanto os dados de telemetria servem para investigações de longo prazo.
Em outubro de 2019, a visitação do cian.ru cresceu para 15,3 milhões de usuários únicos por mês. Isso foi um teste sério para a solução arquitetônica de entrega de logs.
Atualmente, estamos nos preparando para atualizar o ElasticSearch para a versão 7. No entanto, para isso, teremos que atualizar o mapeamento de muitos índices no ElasticSearch, pois eles foram migrados da versão 5.5 e foram declarados obsoletos na versão 6 (na versão 7, eles simplesmente não existem). E isso significa que, durante o processo de atualização, certamente haverá algum imprevisto que nos deixará sem logs temporariamente. Da versão 7, aguardamos com mais expectativa o Kibana, com uma interface aprimorada e novos filtros.
Alcançamos nosso objetivo principal: deixamos de perder logs e reduzimos o tempo de inatividade do cluster de infraestrutura de 2-3 falhas por semana para algumas horas de manutenção por mês. Todo esse trabalho em produção é quase imperceptível. No entanto, agora podemos identificar com precisão o que está acontecendo com nosso serviço, podemos fazer isso rapidamente em um modo tranquilo e não precisamos nos preocupar com a perda de logs. No geral, estamos satisfeitos, felizes e nos preparando para novos feitos, sobre os quais contaremos mais tarde.
Fonte: habr.com
