

Se você não entende o que é DevOps, aqui está um breve resumo. DevOps é um conjunto de práticas que reduzem os medos dos engenheiros e diminuem a quantidade de falhas na produção de software. Geralmente, também reduzem o tempo de lançamento ao mercado — o período desde a ideia até a entrega do produto final aos clientes, permitindo realizar rapidamente experimentos de negócios.
Como iniciar a transformação DevOps? De forma resumida: escolhemos o serviço com o qual começaremos o processo, identificamos as pessoas envolvidas com o serviço, construímos um Value Stream Map, criamos uma equipe temporária que se dedicará à transformação inicialmente e definimos uma tarefa para ela. Repetimos o ciclo quantas vezes forem necessárias.
Um plano detalhado de transformação DevOps com exemplos e instruções está disponível abaixo — na transcrição Andrey Alexandrov — de um engenheiro da empresa Express42, que consulta sobre o crescimento do DevOps, acelerando esse processo, pois já construiu um mapa de armadilhas. Se você acha que a transformação não é necessária ou que a sua especificidade torna as práticas DevOps inadequadas, use o relatório como um guia para identificar e remover limitações.
Se você está preocupado com a questão da transformação DevOps, então sua empresa é grande e é preciso escalar esse processo aos poucos por toda a estrutura. Enquanto houver necessidade de transformar a equipe ou eliminar alguma limitação, o algoritmo abaixo pode ser repetido.
Escolha do serviço
O plano está traçado, vamos começar pelo primeiro passo — a escolha do serviço. O primeiro critério é a vida útil: há serviços antigos — legacy, e novos. Podemos começar tanto com os antigos quanto com os novos.
Escolher um serviço jovem faz sentido. Ele é novo, não há ainda um processo estabelecido de trabalho na equipe responsável. Não há uma montanha de dívida técnica em torno dele, não é necessário estar sempre consertando. Podemos fazer com ele o que quisermos.
No caso de um serviço antigo, há problemas relacionados ao fato de que mudar sempre é difícil. Já existem certas limitações sérias, mas talvez sejam administradas por pessoas que já estão prontas para tudo mudar — elas estão cansadas e querem fazer algo diferente porque estão enfrentando dificuldades.
Trabalhar com um serviço antigo cria um forte precedente na sua empresa — é possível mudar algo. Se você mudou um serviço novo, ele vai para produção 100 vezes por hora, e tudo está bem, então as pessoas na sua empresa podem dizer:
— Este é um novo serviço! Era tudo simples, tente fazer algo com a nossa sucata.
Um serviço legado faz sentido para transformação quando você a realiza com alguém, por exemplo, se convidou um consultor externo. Sejamos honestos, a transformação vai abalar tudo o que for possível.. Você está experimentando e não sabe para onde irá, quais tecnologias e por que irá usar, onde e quais armadilhas nos processos podem surgir. Portanto, é mais fácil mudar para um novo.
Se você faz tudo sozinho e a empresa não tem competência séria — vamos de novo serviço. Se você conhece um consultor externo e tem recursos — escolha o antigo.
Existem serviços que são apenas uma interface para os usuários, como um site simples ou um aplicativo móvel. Mas existem coisas sérias, como o billing. Se algo der errado com o billing — será complicado resolver. Aqui também temos escolhas.
Trabalhamos ou com um serviço crítico, mas já estamos sofrendo por causa dele, ele cria limitações, ou trabalhamos com a interface. Esse é o segundo critério de escolha. Da mesma forma, há a possibilidade de envolver um consultor experiente — vamos trabalhar com a opção mais difícil.
Mas mesmo assim, eu não recomendaria fazer isso, porque, enquanto não houver entendimento sobre com o que trabalhar e em qual direção transformar, pegar algo crítico e revisá-lo — não é uma boa ideia. Portanto, neste caso, preferimos trabalhar com a interface, cuja falha não é crítica.
Vamos considerar agora a equipe do serviço. Com aqueles que gerenciam esse serviço, teremos que trabalhar constantemente e interagir em um contato muito próximo.
As pessoas na equipe podem ser divididas em duas categorias: conservadores — vivem no velho mundo ou simplesmente não sabem nada sobre DevOps, e inovadores, que trazem todas as práticas da moda. Os segundos nem sempre entendem o assunto, mas pelo menos estão prontos para ele.
Por um lado, conservadores — pessoas experientes: estão na empresa há muito tempo, entendem tudo, mas não sabem sobre as práticas. Por outro lado — inovadores, que ouviram algo, mas provavelmente não trabalham na empresa há muito tempo. Com quem é melhor trabalhar?
Com os conservadores, teremos que interagir de qualquer forma, pois este é o serviço deles. Teremos que nos comunicar com eles, esclarecer a especificidade do serviço, o que pode ser feito de uma maneira e o que pode ser feito de outra. Dependemos de suas consultas. Certamente teremos que delegar algo a eles, porque conhecem melhor seu serviço. Portanto, é importante com qual equipe teremos contato no final.
É lógico escolher a equipe de inovadores, porque os conservadores podem ser obstáculos.
Na prática, muitas vezes acontece que pessoas conservadoras têm experiência substancial, mas não entendem como seguir adiante. Elas simplesmente têm medo de que, após a transformação e reestruturação do serviço, serão demitidas por não serem mais necessárias. Às vezes, simplesmente por não entender o que está acontecendo, elas sabotam o trabalho.
Tive um caso em que um membro da equipe consertava tudo o que pudesse, porque supostamente era mais crítico do que o que estávamos fazendo. Damos uma tarefa: implementar hoje este pedaço — não, do outro lado do mundo há um incêndio, vamos consertá-lo. É difícil trabalhar com pessoas assim.
Pessoas da equipe de conservadores frequentemente ignoram as tarefas ou as adiavam até o último momento. E se, Deus nos livre, você cometeu um erro e atribuiu a eles KPI sobre a quantidade de tarefas concluídas, mas alguma parte foi, de alguma forma, excluída do KPI, então eles não farão nada. De certo modo, estarão certos, porque assim perderão o bônus.
Com os inovadores é mais fácil — eles são mais leais.. Eles já ouviram algo, querem avançar, então ajudarão. Precisamos de pessoas que estão dispostas a enfrentar dificuldades no início: se o serviço está mudando, todas as dificuldades e obstáculos cairão sobre os inovadores como pioneiros. Os inovadores querem tudo o que é novo e moderno, e estão dispostos a sofrer.
Os conservadores podem ser convertidos mais tarde à sua fé. Quando você mostrar que mudou um pedaço e tudo funciona bem, provavelmente eles também vão querer experimentar e aceitar a nova religião DevOps.
Em resumo. Se fizermos toda a transformação em nossa empresa por conta própria, escolheremos: um novo serviço, de preferência com uma interface simples, para não sofremos muito com suas falhas, e uma equipe de inovadores.
Se houver a possibilidade de chamar um consultor externo, em vez de um novo, devemos utilizar o serviço antigo, que já nos causa problemas. As pessoas que lidaram com a transformação por um bom tempo em diferentes empresas viram várias situações e já entendem como fazer a coisa certa e para onde realmente ir.
Quem está envolvido?
Precisamos encontrar todos aqueles que têm algum tipo de relação com o serviço: desenvolvedores, testadores, administradores, profissionais de segurança, gerentes e, possivelmente, Product Owners. Apesar de os Product Owners não serem técnicos, eles têm um papel no serviço: tomam decisões e definem tarefas.
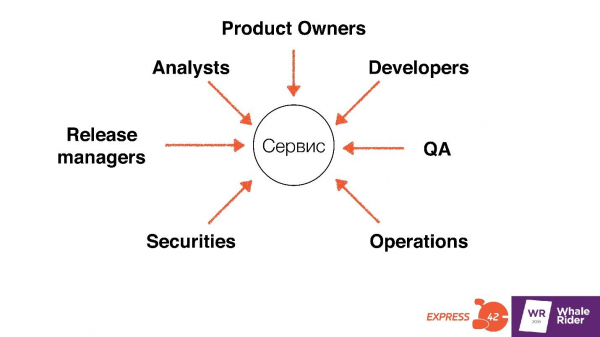
Todos que tomam qualquer tipo de decisão e influenciam o que acontece com o serviço precisam ser encontrados, conhecidos e conversados.
Para que eles nos servem? Para saber com quem negociar.. Durante a transformação, quando o princípio habitual de trabalho com o serviço muda, haverá problemas inevitavelmente. Haverá alguns erros durante um tempo enquanto testamos novas abordagens. As pessoas precisam estar preparadas para isso e concordar.
Depois, teremos que construir o Value Stream Map e sem essas pessoas não conseguiremos, porque só elas juntas conhecem a visão completa do que está acontecendo. Uma única pessoa nunca sabe tudo que acontece com o serviço.
Elas recomendarão pessoas para a equipe. Mais tarde discutiremos por que precisamos de uma equipe separada. Teremos que incluir pessoas dos departamentos existentes. Aqueles que têm relação com o serviço poderão indicar colegas que pensam em nossa direção, que podem nos ajudar e têm competência no que precisamos.
Em seguida, reunimos todas essas pessoas de diferentes departamentos em uma sala e começamos a construir o Value Stream Map.
Construímos o Value Stream Map.
Value Stream Map é um diagrama ou mapa que mostra o fluxo de valores até o cliente.É todo o processo desde a concepção da ideia até sua implementação, incluindo todas as etapas intermediárias e como o valor chega aos nossos clientes.
O Value Stream Map é necessário para visualizar todas as etapas de desenvolvimento,localizar problemas por meio de medições que existem no processo atual e começar a resolvê-los, e definir um objetivo inicial.É o lugar onde começaremos a realmente fazer algo.
Métricas
Na literatura sobre Value Stream Map, muitas métricas diferentes são descritas, mas para começar, precisamos apenas de três.
Lead Time — atraso/espera. — o tempo que esperamos por algo. Por exemplo, um testador aguarda a liberação do ambiente para testes e, nesse tempo, não pode fazer nada.
Tempo de Valor Agregado — tempo de trabalho útil — aquele que gastamos em determinada etapa para criar valor final para o usuário. Por exemplo, o testador iniciou seu teste e começou a revisar algo. Esse é o tempo de trabalho útil, quando realmente fazemos algo para o produto. É por isso que os clientes pagam — por software de qualidade.
%C/A — porcentagem de trabalho aceito. Temos uma etapa — desenvolvimento, a segunda etapa — testes. Quantas funcionalidades os testadores aceitaram dos desenvolvedores, e essa é a porcentagem.
Mais ou menos assim é o nosso mapa.
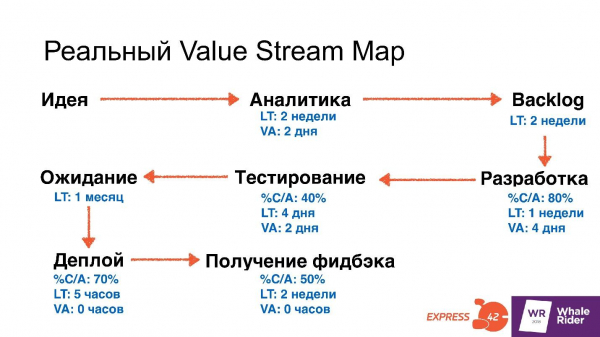
Ele pode parecer diferente dependendo da estrutura organizacional, do número de departamentos e do que você faz. Mas, de uma forma geral, o mapa terá duas etapas: a ideia e análise. Nesta etapa, esperamos dados, por exemplo, Lead Time de 2 semanas e Tempo de Valor Agregado de 2 dias.
Estamos cobrindo absolutamente todas as etapas com métricas.
Backlog — quantas tarefas ficaram após os analistas as terem concebido.
Desenvolvimento — quantas semanas os desenvolvedores aguardaram esclarecimentos sobre as tarefas, ambientes ou equipamentos — não importa, mas eles estão esperando por algo. Por exemplo, 4 dias para implementar uma funcionalidade. Aqui surge a métrica %C/A. Os desenvolvedores pegaram apenas 80% das tarefas do Backlog. Eles acreditam que as outras 20% não têm um T documento claro o suficiente e as enviaram para revisão.
Testes. No esquema, LT é definido como 4 dias. Por exemplo, os testadores aguardaram a liberação do ambiente de teste, VA 2 dias eles realmente testaram algo, e %C/A = 40%. — apenas 40% do código ou funcionalidades que os desenvolvedores enviaram foram considerados adequados pelos testadores. O restante não foi aprovado por algum motivo.
Não vou me aprofundar em como fazer essas medições, no final do artigo recomendarei literatura onde você pode aprender sobre isso.
A única coisa que recomendo — não acreditem nas pessoas que irão montar um Mapa de Fluxo de Valor com você. Elas estimam quanto tempo diferentes processos levam, mas essas estimativas nem sempre são precisas, então é melhor medir você mesmo.
Tivemos uma situação em que fomos ao departamento de Operações e perguntamos quanto tempo leva para entregar uma nova funcionalidade em produção. Nos disseram que eram 10 minutos, e pensamos: por que viemos a esta empresa? Descobrimos que 10 minutos é o tempo que um script leva para pegar o código e entregá-lo no servidor. Mas antes disso, o release fica três dias no servidor apenas parado — há uma tarefa no Backlog que precisa ser implantada. Portanto, existe uma fase de espera antes da fase de implantação, em que o projeto simplesmente fica parado. Se não tivéssemos ido com um bloco de notas, não tivéssemos nos fixado em uma tarefa no Jira e não começássemos a rastreá-la etapa por etapa, acreditaríamos que tudo estava ótimo e que não havia problema algum.
Portanto, você realmente terá que fazer medições, de preferência não apenas uma vez, para ter uma noção mais próxima da realidade. Dependendo do Value Stream Map, você tomará uma decisão sobre de onde começar e o que corrigir primeiro.
Equipe temporária
Muitas empresas que decidiram implementar DevOps criam uma equipe, mas não uma temporária; elas existem por vários anos. Se você consultar um serviço DevOps apologize, onde estão descritos diferentes padrões de construção de estruturas organizacionais em DevOps, perceberá que isso é um antipadrão.
Quando a equipe DevOps existe continuamente por vários anos, é um grande erro, porque DevOps é sobre comunicação entre departamentos, sobre velocidade e eficiência.
Se uma equipe existe entre os departamentos apenas para fazer algo separado e existe por muito tempo, ela cria uma barreira desnecessária. Agora, em vez de o programador ir diretamente ao administrador para resolver a questão, ele precisa primeiro consultar o departamento de DevOps, que então seguirá adiante.
Portanto, para começar, é preciso criar uma equipe temporária.. Ela vai durar condicionalmente seis meses, no máximo um ano, dependendo da tarefa em questão, apenas para eliminar uma limitação que escolhemos. Depois disso, ela vai morrer. Se escolhermos o próximo ponto onde estamos com muita dor e entendermos que também precisamos de uma equipe separada para isso, então a criaremos novamente. Mas em uma base 'permanente', tais equipes não devem existir — assim, elas apenas prejudicam a comunicação e assumem tarefas separadas, apenas para fazer algo. Essas tarefas podem estar completamente desconectadas de DevOps e de transformação. Por que não delegar essa tarefa para departamentos existentes?
Por que uma equipe temporária é necessária
Conflito com os processos atuais. A transformação DevOps é uma mudança não apenas nas tecnologias e ferramentas que usamos, mas também na própria forma de trabalho, no pensamento e nos valores. Se a equipe trabalhar como já está acostumada, não conseguirá experimentar outras abordagens.
Essas pessoas precisam viver com outras regras: ignorar todos os KPIs da empresa, porque estão tentando trabalhar de forma diferente. Equipes temporárias não preencherão requisições para obter um servidor, mas irão diretamente ao departamento que os gerencia, exigindo que lhes forneçam imediatamente o que precisa, porque é uma tarefa prioritária e porque estão tentando viver de forma diferente. A equipe tem um conflito total com todos os processos atuais. Para que os métodos de trabalho existentes não os atrapalhem agora e para que eles não atrapalhem os outros, isolamos essas pessoas, criando uma equipe separada.
Evitando a burocracia em experimentos. Em equipes temporárias, não há burocracia, elas não preenchem relatórios de horas trabalhadas, não prestam contas aos gerentes. Este é um mundo absolutamente separado, onde as pessoas vivem e pensam de maneira diferente, e se ocupam com coisas completamente diferentes. Não devemos atrapalhá-los desnecessariamente.
Trabalho contínuo no serviço. No primeiro ponto, escolhemos algo em que iremos experimentar. Experimentar e buscar maneiras de trabalhar melhor é bom, mas também queremos desenvolver funcionalidades. Se toda a equipe, em vez de se concentrar nas funcionalidades, se envolver com a transformação, começaremos a perder receitas, e os bugs ficarão pendentes por muito tempo — isso não é necessário. A criação de uma equipe temporária permite experimentar sem interromper o trabalho no produto.
Não gastar tempo em tarefas de trabalho. Isso novamente é sobre o produto. Fazer a equipe experimentar outras ferramentas e afins leva muito tempo. Para que as pessoas aprendam a usar as ferramentas, comecem a implementá-las e usá-las adequadamente, levará, no mínimo, seis meses. Se elas também estiverem envolvidas com o produto, esses seis meses se estenderão indefinidamente. Se as pessoas estão lidando com o produto, elas acabam trabalhando com os processos antigos — o que não precisamos.
Portanto, de diferentes departamentos, destacamos pessoas para uma equipe separada que será responsável pela transformação do serviço. Como resultado, o serviço funciona, continua a se desenvolver e ao mesmo tempo realizamos alguns experimentos nele.
A equipe temporária se dedica apenas à transformação DevOps — à eliminação das restrições que encontramos, e nada mais.
A equipe é composta por pessoas versáteis. Isso significa que não trouxemos apenas desenvolvedores. Não viemos ao serviço e retiramos metade da equipe — não, nós pegamos pessoas de diferentes departamentos. Alguns pontos atrás, identificamos diferentes departamentos e diversos funcionários que têm a ver com o serviço que está sendo transformado. Desses, estamos montando uma equipe porque ela precisa ser versátil — nós iremos mudar tanto o processo de teste quanto o processo de desenvolvimento e o processo de manutenção do serviço. Competências variadas são necessárias.
Normalmente, escolhemos um desenvolvedor, um testador e um engenheiro — um de cada, e juntos inventamos uma solução que permita viver de forma diferente.
É desejável que essas pessoas tenham autoridade na organização. Pode ser necessário trazer um conservador, mesmo que não queiramos. Se tivermos uma empresa grande, nem todos acreditarão em nossa ideia, e alguns podem tentar colocar obstáculos, por exemplo, não liberando um ambiente de testes. É aqui que será necessário um 'autoridade' — uma pessoa respeitável com vasta experiência, que conquistou o respeito dos colegas. A autoridade do funcionário na equipe facilitará a tarefa e o trabalho da equipe temporária. As pessoas vão pensar:
— Ah, esse cara legal que todos nós conhecemos e respeitamos se juntou — deve haver algo no DevOps que vale a pena conferir!
Definimos um objetivo
Reunimos pessoas, escolhemos um serviço, examinamos as restrições, identificamos em quem vamos influenciar. Agora precisamos estabelecer um objetivo e ele deve ser bem definido em termos de SMART — tudo do jeito que gostamos.
Específico — específico.
Mensurável — mensurável. Este é um ponto muito importante do SMART. Se você não consegue medir algo, não pode alterá-lo e entender o que você fez melhor ou pior.
Atingível — atingível. Ajuste para a sua especificidade. Se você é uma empresa enterprise com uma longa história e um grande peso de responsabilidades, que lança uma versão do produto uma vez por ano, você não conseguirá lançar novas versões do produto a cada hora. Isso não vai funcionar. Portanto, defina uma meta realista, que seja alcançável dentro de um prazo aceitável.
Relevante — relevante. Eliminamos apenas a limitação que realmente afeta nossas metas atuais.
Limitada no Tempo — limitada no tempo. Se não há um prazo, a equipe fará qualquer coisa: tentará 15 tecnologias em vez de 3, escreverá relatórios enormes, fará pesquisas inúteis, polirá sua implementação até brilhar, quando o objetivo já foi alcançado.
A meta é obtida com a ajuda do Value Stream Map — reunimos todas as pessoas e desenhamos. Mas agora, com base no Value Stream Map anterior, desenhamos o que queremos obter.
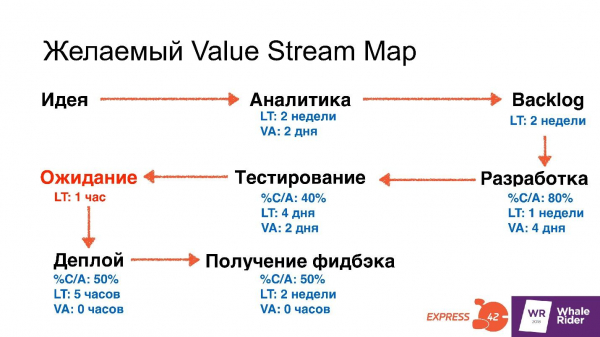
Identificamos uma limitação que vamos eliminar agora mesmo — isso é o que a equipe fará. Para exemplo, eu peguei a espera entre o lançamento concluído e sua implantação em produção — essa é a limitação mais comum que as pessoas apresentam aos consultores.
Com base nisso, formulamos uma tarefa: queremos que a espera entre o lançamento concluído e a entrada em ação seja, no máximo, uma hora.
Exemplos de tarefas.
- Reduzir o Lead Time de teste de 4 dias para 1 hora.
- Reduzir o Value Added Time para testes de 2 dias para 3 horas.
- Reduzir o Lead Time de implantação de 5 horas para 10 minutos.
- Aumentar o C/A de 50% para 95%, ou seja, aumentar a quantidade de features que os testadores aceitam, em outras palavras, melhorar a qualidade do trabalho dos desenvolvedores.
Os exemplos de tarefas não foram tirados do nada — são baseados em medições que fizemos ao elaborar o Value Stream Map.
Definimos uma tarefa semelhante para nossa equipe e uma limitação de prazo. Dependendo de quão bem as coisas estão na sua empresa, você define prazos diferentes. Em média, para eliminar uma limitação, se as pessoas estão fazendo isso pela primeira vez e ainda não sabem com quais tecnologias e como especificamente resolverão o problema, normalmente leva-se seis meses.
Planejamento curto
Então, nossa equipe está formada, temos um objetivo e as pessoas começam a trabalhar. Um ponto importante é o planejamento curto: sprints de uma a duas semanase, no máximo, melhorias mensuráveis todas as semanas e ajustes no curso.
Por exemplo, costumamos utilizar a abordagem moving-moving, onde toda a equipe se reúne no início de cada semana, anota em um arquivo o que cada um fará. Após uma semana, verificamos: o que foi feito e o que não foi feito, se não foi, por quê, e pensamos no que fazer a seguir.
Os sprints permitem ajustar o curso a tempo.
Testamos algo por uma semana ou duas: tecnologias, abordagens, métodos de trabalho; depois, medimos novamente e vemos - com essa abordagem, foi melhor ou pior? Se pior, significa que estamos indo na direção errada, precisamos ajustar o curso: definir outra tarefa, adotar outra tecnologia ou fazer algo diferente. Sprints curtos de 1-2 semanas permitem manobrar e desistir a tempo de decisões ruins.
Compartilhamos os sucessos
A equipe alcança alguns sucessos, pequenos ou grandes — não importa, sempre há um resultado. Todos devem saber sobre esse resultado: aqueles que estão envolvidos com DevOps e os departamentos vizinhos. No mundo ideal, seria desejável que isso chegasse a todos as pessoas da empresa.
Por quê? Se queremos transformar não apenas uma parte da empresa, remover não uma limitação, mas todas, para que a empresa se torne ágil, o código chegue rapidamente ao cliente e nada quebre, precisamos que todos sejam leais à ideia de DevOps. Você não conseguirá aplicar a abordagem a serviços e equipes que são categoricamente contra.
Para que haja lealdade, devemos contar a todos que tentamos isso — temos um resultado, experimente também! Isso aumentará o interesse e a lealdade ao que fazemos, as pessoas começarão a tentar fazer algo agora mesmo. Como mostra a experiência, quando contamos o que tentamos e o que conseguimos, outras equipes começam a perguntar como e o que fizemos. Elas olham as implementações, o código, a documentação, aparecem com perguntas e tentam mudar algo em seus próprios contextos.
Contar sobre o que você conseguiu é importante. Assim, você convencerá a sua equipe de conservadores, que queriam fazer tudo da maneira antiga, a se transformar em inovadores.
Total
Escolhemos um serviço, como ponto de partida - o local onde começaremos as mudanças na empresa. Identificamos todos os que têm alguma relação com o serviço e junto com eles construímos o Value Stream Map, medimos e observamos onde e quais são as restrições.
Formamos uma nova equipe temporária, que se encarregará da tarefa proposta. Com base nas medições e no Value Stream Map desenhamos um novo mapa, destacando a restrição que iremos resolver. Com base nessa restrição definimos uma tarefa, que será responsabilidade da equipe. A tarefa deve ser obrigatoriamente SMART — específica, mensurável, relevante para as tarefas atuais e com um prazo definido.
Repetimos o processo, até transformarmos todos os nossos serviços na forma desejada e eliminarmos todas as restrições.
Bônus. Materiais úteis
Para aqueles que decidiram se dedicar ao DevOps por conta própria.
Projeto 'Fênix'
O título original é 'The Phoenix Project: A Novel about IT, DevOps, and Helping Your Business Win'. É um romance sobre DevOps — a história de como um funcionário se tornou chefe de um departamento que estava sempre em chamas. A nova liderança recebeu a tarefa:
— Você tem alguns anos para corrigir tudo, para que finalmente possamos entregar nosso produto rapidamente e de forma eficiente aos nossos clientes.
'Projeto 'Fênix'. Um romance sobre como o DevOps muda a vida para melhor' — um livro para todos os líderes, pois são essas pessoas que tomam as decisões sobre o que acontece na empresa. Se você é engenheiro ou programador e deseja que a transformação comece em sua empresa — compre o livro e presenteie a liderança. Este romance explica tudo, é uma leitura rápida e fácil.
Guia de DevOps
Um livro mais complexo. Lançado há alguns anos em inglês com o título 'The DevOps Handbook: How to create world-class agility, reliability, and security in Technology organizations', mas agora já está disponível em russo. É um verdadeiro manual prático: como realizar medições, o que é o Value Stream Map e para que serve, por onde começar e em que ordem. O livro é para aqueles que desejam fazer tudo por conta própria. O mais importante é que ele traz exemplos de experiências de outras empresas.
Por exemplo, é mencionado como uma empresa construiu um Value Stream Map e percebeu que seu impedimento não estava no produto, mas no fato de que o caixa tinha que ir da loja para o escritório vizinho para usar esse produto. Em vez de resolver o problema com um software, eles simplesmente compraram tablets para seus vendedores, e agora ninguém precisa sair, pois todas as ações são realizadas no local de trabalho. Conclusão: o Value Stream Map pode ser aplicado não apenas a software, mas a todos os processos da organização.
Acelere
Título completo: "Accelerate: The Science of Lean Software and DevOps: Building and Scaling High Performing Technology Organizations". Este é o próximo nível — hardcore. O livro foi lançado no ano passado, por enquanto apenas em inglês, e trata de pesquisas. Os autores — Nicole Forsgren, Jez Humble e Gene Kim — aplicaram diversas práticas em várias empresas por muitos anos e pesquisaram como e quais práticas influenciam.
No segundo capítulo, que aborda medições, são mencionados o Value Stream Map, as métricas que citei e muitas outras, além de ser descrito detalhadamente o processo de medições. Os autores realizam medições por meio de questionários e auto acompanhamento de tarefas. É explicado detalhadamente quais métricas devem ser medidas corretamente, quais não devem, erros humanos nas medições. Se você tem dificuldades com medições, consulte o segundo capítulo do livro "Accelerate". Se em sua equipe há apenas muitas práticas, mas não está claro quais práticas aplicar agora, quais depois, quais realmente funcionam e quais não — leia, o livro explica tudo.
A transformação é uma questão na interseção de DevOps e gerenciamento. Em algum lugar nessa área de interseção entre desenvolvimento, operações e testes estão os temas que tentamos discutir em , a mesma integração é necessária para criar um produto de qualidade – o principal tema . Gerenciamento no festival apresenta — significa que todas as ideias para transformação estão lá. Junte-se a nós nos dias 27 e 28 de maio, vamos nos integrar e nos transformar.
Fonte: habr.com
