

Nunca aconteceu antes, e aqui estamos de novo!
Em um projeto recente, decidimos utilizar o Liquibase desde o início para evitar problemas no futuro. Como se revelou, nem todos os novos membros da equipe sabem utilizá-lo corretamente. Eu realizei um workshop interno e, em seguida, decidi transformá-lo em um artigo.
O artigo inclui dicas úteis e uma descrição das três armadilhas mais evidentes nas quais se pode cair ao trabalhar com ferramentas de migração de bancos de dados relacionais, especialmente o Liquibase. É direcionado a desenvolvedores Java de nível Júnior e Médio; para desenvolvedores mais experientes, pode ser interessante para estruturar e revisar o que provavelmente já é conhecido.
Liquibase e Flyway são as principais tecnologias concorrentes para o controle de versões de estruturas relacionais no mundo Java. A primeira é completamente gratuita e, na prática, é frequentemente escolhida para uso, portanto, o Liquibase é o protagonista desta publicação. No entanto, algumas das práticas descritas podem ser universais, dependendo da arquitetura do seu aplicativo.
As migrações de estruturas relacionais surgiram como uma solução necessária para combater a baixa flexibilidade dos repositórios de dados relacionais. Na era da programação orientada a objetos, o trabalho com bancos de dados implicava descrever um esquema uma única vez e não alterá-lo mais. Contudo, a realidade é que tudo muda, e alterações na estrutura das tabelas são frequentemente necessárias. Naturalmente, esse processo pode ser doloroso e desagradável.
Não vou me aprofundar na descrição da tecnologia e nas instruções sobre como adicionar a biblioteca ao seu projeto, sobre esse assunto já foram escritos artigos suficientes:
Além disso, já houve um ótimo artigo sobre dicas úteis:
Dicas
Quero compartilhar meus conselhos e comentários que nasceram através do suor, sangue e dor ao resolver problemas de migração.
1. Antes de começar, é importante ler a seção de melhores práticas. Liquibase
estão descritas coisas simples, mas muito importantes, sem as quais o uso da biblioteca pode complicar sua vida. Por exemplo, uma abordagem não estruturada para gerenciar changsets, cedo ou tarde, levará a confusões e migrações quebradas. Se alterações no esquema do banco de dados e na lógica dos serviços não forem lançadas simultaneamente, há uma grande probabilidade de que isso resulte em testes quebrados ou em um ambiente corrompido. Além disso, as recomendações para o uso do Liquibase no site oficial incluem um item sobre desenvolver e testar scripts de rollback junto com os scripts principais de migração. E no artigo existem exemplos de código relacionados a migrações e ao mecanismo de rollback.
2. Se você começou a usar ferramentas de migração – não permita alterações manuais na estrutura do banco de dados
Como se costuma dizer: “Uma vez Persil — sempre Persil”. Se o banco de dados da sua aplicação começou a ser gerenciado pelas ferramentas Liquibase — quaisquer alterações manuais instantaneamente resultam em um estado inconsistente, e o nível de confiança nos changsets se torna igual a zero. Os riscos potenciais incluem várias horas desperdiçadas na recuperação do banco de dados e, na pior das hipóteses, um servidor danificado. Se na sua equipe houver um DBA Architect da ‘antiga guarda’, explique pacientemente e com reflexão como tudo ficará ruim se ele simplesmente editar o banco a seu critério no SQL Developer.
3. Se o changset já foi enviado para o repositório, evite edições
Se outro desenvolvedor fizer pull e aplicar um changset que, por sua vez, será editado — ele certamente mencionará você com boas palavras quando receber um erro ao iniciar a aplicação. Se a edição do changset vazar de alguma forma para o desenvolvimento — será necessário percorrer um caminho escorregadio de hotfixes. O cerne do problema gira em torno da validação das mudanças por hash – o mecanismo principal do Liquibase. Ao editar o código do changset, o hash muda. A edição de changsets só é possível quando existe a possibilidade de implantar todo o banco do zero sem perda de dados. Nesse caso, o refatoramento do código SQL ou XML pode, ao contrário, facilitar a vida, tornando as migrações mais legíveis. Um exemplo pode ser a situação em que, ao iniciar a aplicação, o esquema do banco de dados original foi acertado internamente na equipe.
4. Tenha backups de banco de dados verificados, se possível
Aqui, creio que tudo está claro. Caso a migração falhe, tudo pode ser revertido. O Liquibase possui uma ferramenta para reverter alterações, mas os scripts de reversão também são escritos pelo desenvolvedor, e estes podem ter problemas com a mesma probabilidade que os scripts do conjunto de alterações principal. Isso significa que é sempre útil contar com backups.
5. Utilize backups de banco de dados verificados no desenvolvimento, se possível
Se isso não contrariar contratos e privacidade, se o banco não contém dados pessoais e não é tão pesado quanto dois sóis — antes de aplicar migrações em servidores ativos, é possível verificar como funcionará na máquina do desenvolvedor e identificar quase 100% dos problemas potenciais na migração.
6. Comunique-se com outros desenvolvedores da equipe
Em um processo de desenvolvimento bem organizado, todos na equipe sabem quem está fazendo o quê. Na realidade, muitas vezes isso não acontece, portanto, se você estiver preparando alterações na estrutura do banco de dados para sua tarefa, é aconselhável informar toda a equipe sobre isso. Se alguém estiver fazendo alterações paralelamente, você deve se organizar cuidadosamente. Vale a pena manter a comunicação com os colegas também após a conclusão do trabalho, não apenas no início. Muitos problemas potenciais com conjuntos de alterações podem ser resolvidos na fase de revisão de código.
7. Pense no que você está fazendo!
À primeira vista, é um conselho óbvio, aplicável a qualquer situação. No entanto, muitos problemas poderiam ser evitados se o desenvolvedor analisasse novamente o que está fazendo e como isso pode impactar. Trabalhar com migrações sempre exige atenção e cuidado adicionais.
Armadilhas
Agora, vamos considerar as armadilhas típicas nas quais se pode cair se não seguir as dicas acima, e o que, na verdade, fazer?
Situação 1. Dois desenvolvedores tentam adicionar novos conjuntos de alterações ao mesmo tempo
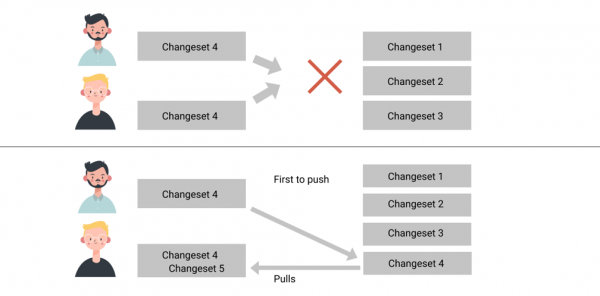
Váfya e Petya querem criar o conjunto de alterações da versão 4, sem saber um do outro. Eles fizeram alterações na estrutura do banco de dados e submeteram pull requests com arquivos de conjuntos de alterações diferentes. Em seguida, é proposto o seguinte mecanismo de ações:
Como resolver
- De alguma forma, os colegas devem concordar sobre a ordem em que seus conjuntos de alterações devem ser aplicados, digamos, o de Petya deve ser aplicado primeiro.
- Alguém deve adicionar o segundo a si mesmo e marcar o changset do Vasya com a versão 5. Isso pode ser feito através de Cherry Pick ou um merge cuidadoso.
- Após as alterações, é essencial verificar a validade das ações realizadas.
Na verdade, os mecanismos do Liquibase permitem ter dois changsets na versão 4 no repositório, portanto, você pode deixar tudo como está. Ou seja, você terá duas alterações na versão 4 com nomes diferentes. Com essa abordagem, torna-se muito difícil navegar posteriormente pelas versões do banco de dados.
Além disso, o Liquibase, como a casa dos hobbits, guarda muitos segredos. Um deles é a chave validCheckSum, que surgiu na versão 1.7 e permite definir um valor de hash válido para um changset específico, independentemente do que está armazenado no banco de dados. Documentação diz o seguinte:
Adicione um checksum que é considerado válido para este changeSet, independentemente do que está armazenado no banco de dados. Usado principalmente quando você precisa alterar um changeSet e não quer que erros ocorram em bancos de dados nos quais já foi executado (não é um procedimento recomendado)
Sim, esse procedimento não é recomendado. Mas às vezes, um poderoso mago claro domina também as técnicas obscuras.
Situação 2. Migração que depende de dados
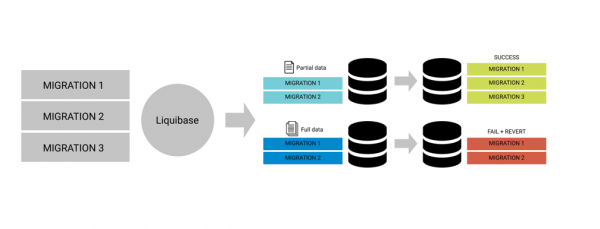
Suponha que você não tenha a possibilidade de usar backups de bancos de dados de servidores ativos. O Petya criou um changset, testou localmente e, com total certeza sobre sua correção, fez um pull request no desenvolvedor. O líder do projeto, por precaução, esclareceu se Petya havia verificado, e então ele foi mesclado. Mas o deployment no servidor de desenvolvimento falhou.
Na verdade, isso é possível, e ninguém está imune a isso. Isso acontece quando as modificações na estrutura das tabelas de alguma forma estão ligadas a dados específicos no banco de dados. É óbvio que, se o banco do Petya estiver preenchido apenas com dados de teste, ele pode não cobrir todos os casos problemáticos. Por exemplo, ao excluir uma tabela, descobre-se que há registros em outras tabelas com Foreign Key, relacionados aos registros na tabela excluída. Ou ao alterar o tipo de coluna, descobre-se que nem 100% dos dados podem ser convertidos para o novo tipo.
Como resolver
- Escrever scripts especiais que serão aplicados uma única vez junto com a migração e formatar os dados adequadamente. Esta é uma solução geral para o problema de transferência de dados para novas estruturas após a aplicação das migrações, mas algo semelhante pode ser aplicado também antes, em casos específicos. Este caminho, é claro, nem sempre está disponível, pois editar dados em servidores ao vivo pode ser perigoso e até catastrófico.
- Outro caminho complexo é editar o changset existente. A dificuldade reside no fato de que todos os bancos de dados onde ele já foi aplicado na forma atual terão que ser restaurados. É bem possível que toda a equipe de backend tenha que implementar localmente o banco de dados a partir do zero.
- E o caminho mais universal é transferir o problema de dados para o ambiente do desenvolvedor, recriando a mesma situação e adicionando um novo changset, antes do que foi quebrado, que permitirá contornar o problema.

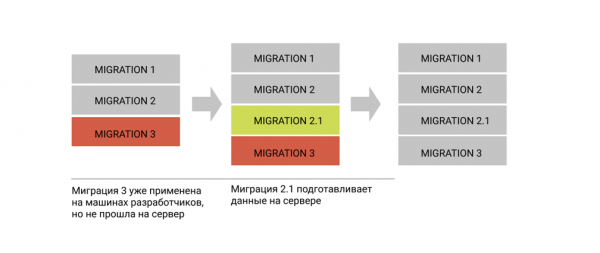
De modo geral, quanto mais a base de dados se assemelhar à base do servidor de produção, menores serão as chances de que os problemas com as migrações se estendam. E, claro, antes de enviar o changset para o repositório, vale a pena pensar várias vezes se não quebrará algo.
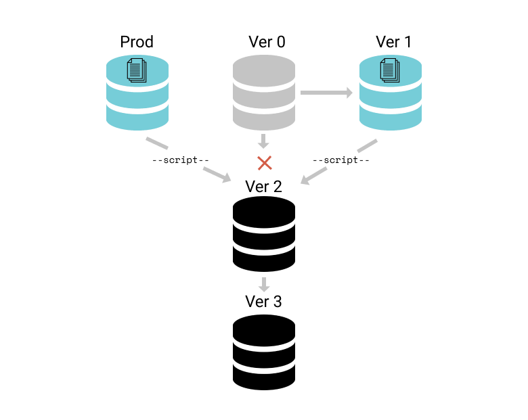
Situação 3. O Liquibase começa a ser aplicado já após o lançamento em produção.
Suponha que o líder de equipe pediu ao Petya para integrar o Liquibase no projeto, no entanto, o projeto já está em produção e existe uma estrutura de banco já estabelecida.
Portanto, o problema é garantir que em quaisquer novos servidores ou máquinas de desenvolvedores, os dados dessas tabelas devem ser recriados do zero, enquanto o ambiente existente deve permanecer em um estado consistente, pronto para receber novos changsets.
Como resolver
Aqui também existem algumas opções:
- A primeira e mais óbvia é ter um script separado que deve ser aplicado manualmente durante a inicialização de um novo ambiente.
- A segunda — menos óbvia, é ter uma migração do Liquibase que reside em outro Contexto do Liquibase e aplicá-la. Mais sobre o Contexto do Liquibase pode ser lido aqui: . No geral, é um mecanismo interessante que pode ser usado com sucesso, por exemplo, para testes.
- O terceiro caminho consiste em vários passos. Primeiro, deve-se criar uma migração para as tabelas que já existem. Em seguida, ela deve ser aplicada em algum ambiente, e assim será obtido seu hash. O próximo passo é inicializar nossas tabelas Liquibase vazias no servidor que não está vazio, e na tabela de histórico de aplicação dos changelogs, pode-se manualmente adicionar um registro de um changelog "aplicado" com as alterações já existentes na base. Assim, no servidor já existente, a contagem do histórico começará a partir da versão 2, e todos os novos ambientes se comportarão de maneira idêntica.

Situação 4. As migrações se tornam enormes e não conseguem ser executadas a tempo.
No início do desenvolvimento do serviço, geralmente, o Liquibase é usado como uma dependência externa, e todas as migrações são processadas ao iniciar o aplicativo. No entanto, com o tempo, você pode se deparar com os seguintes casos:
- As migrações se tornam enormes e levam muito tempo para serem executadas.
- Surge a necessidade de migrações em ambientes distribuídos, digamos, em várias instâncias de servidores de banco de dados ao mesmo tempo.
Nesse caso, a aplicação excessivamente longa das migrações resultará em um timeout ao iniciar o aplicativo. Além disso, aplicar migrações para cada instância do aplicativo separadamente pode levar a estados desincronizados entre diferentes servidores.
Como resolver
Nesses casos, seu projeto já é grande, possivelmente até maduro, e o Liquibase começa a atuar como uma ferramenta externa separada. A questão é que o Liquibase, como biblioteca, é empacotado em um arquivo jar e pode operar tanto como uma dependência dentro do projeto como de forma autônoma.
No modo autônomo, você pode deixar a aplicação das migrações sob a responsabilidade do seu ambiente CI/CD ou nas mãos de bons especialistas em administração de sistemas e implantação. Para isso, será necessária a linha de comando do Liquibase. . Nesse modo, há a possibilidade de iniciar o aplicativo somente após todas as migrações necessárias terem sido realizadas.
Saída
Na verdade, as armadilhas ao trabalhar com migrações de BD podem ser muito mais numerosas, e muitas delas exigem uma abordagem criativa. É importante entender que, se a ferramenta for utilizada corretamente, a maioria dessas armadilhas pode ser evitada. Especificamente, eu enfrentei todos os problemas listados em várias formas, e alguns deles foram resultado de meus erros. Normalmente isso acontece, claro, por falta de atenção, mas às vezes – por causa da falta de habilidade em utilizar a ferramenta.
Fonte: habr.com
