

Quando o seu trabalho é criar algo bonito, não é preciso dizer muito sobre isso, pois o resultado está diante dos olhos de todos. Mas se você remove inscrições de cercas, ninguém percebe seu trabalho até que as cercas estejam apresentáveis ou até você apagar algo inapropriado.
Qualquer serviço onde se pode deixar um comentário, avaliação, enviar mensagem ou carregar imagens enfrenta, cedo ou tarde, o problema de spam, fraudes e conteúdo ofensivo. Isso é inevitável, mas é preciso combater.
Meu nome é Mikhail, eu trabalho na equipe Antispam, que protege os usuários dos serviços do Yandex contra esses problemas. Nosso trabalho raramente é percebido (e isso é bom!), então hoje vou contar mais sobre ele. Você vai descobrir em quais casos a moderação é inútil e por que a precisão não é o único indicador de sua eficácia. E também vamos falar sobre palavrões usando gatos e cachorros como exemplo, e por que às vezes é útil 'pensar como um xingador'.
No Yandex, está surgindo cada vez mais serviços onde os usuários publicam seu conteúdo. Você pode fazer uma pergunta ou escrever uma resposta no Yandex.Q, discutir notícias do seu bairro no Yandex.District, compartilhar condições de tráfego em conversas no Yandex.Maps. Mas quando a audiência do serviço cresce, ele se torna atraente para golpistas e spammers. Eles aparecem e preenchem os comentários: oferecem ganhos fáceis, promovem remédios milagrosos e prometem pagamentos sociais. Por causa dos spammers, alguns usuários perdem dinheiro, e outros perdem o desejo de passar tempo em um serviço descuidado e cheio de spam.
E esse não é o único problema. Nós nos esforçamos não apenas para proteger os usuários contra golpistas, mas também para criar um ambiente confortável para a comunicação. Se as pessoas nos comentários se deparam com ofensas e palavrões, é muito provável que elas se afastem e nunca mais voltem. Portanto, também precisamos saber como lidar com isso.
Web Limpo
Como costumamos fazer, as primeiras iniciativas surgiram na Pesquisa, na parte que combate o spam nos resultados. Há cerca de dez anos, surgiu a necessidade de filtrar conteúdo adulto para buscas familiares e para consultas que não exigem respostas da categoria 18+. Assim, foram criados os primeiros dicionários de pornografia e de palavrões, elaborados manualmente por analistas. O principal objetivo era classificar as consultas em aquelas onde era aceitável mostrar conteúdo adulto e aquelas onde não era. Para isso, coletávamos marcações, construíamos heurísticas e treinávamos modelos. Assim surgiram as primeiras iniciativas para filtrar conteúdo indesejado.
Com o tempo, o Yandex começou a apresentar UGC (conteúdo gerado pelo usuário) — mensagens escritas pelos próprios usuários, enquanto o Yandex apenas publicava. Pelas razões descritas anteriormente, muitas mensagens não podiam ser publicadas sem revisão — era necessária moderação. Então, decidiram criar um serviço que forneceria proteção contra spam e agentes mal-intencionados para todos os produtos UGC do Yandex e utilizaria as iniciativas de filtragem de conteúdo indesejado na Pesquisa. O serviço foi chamado de "Web Limpa".
Novas tarefas e ajuda dos colaboradores
No início, apenas uma automatização simples funcionava: os serviços nos enviavam textos, e nós os enviávamos por dicionários de palavrões, dicionários de pornografia e expressões regulares — os analistas faziam tudo manualmente. Mas, com o tempo, o serviço começou a ser aplicado em um número crescente de produtos do Yandex, e tivemos que aprender a lidar com novos problemas.
Frequentemente, em vez de uma avaliação, os usuários publicam uma combinação sem sentido de letras, tentando ganhar realizações, às vezes promovem sua empresa em avaliações de empresas concorrentes, e outras vezes simplesmente confundem organizações e escrevem, na avaliação de uma loja de animais: "Peixe perfeitamente preparado!". Talvez, algum dia, a inteligência artificial aprenda a capturar perfeitamente o sentido de qualquer texto, mas, atualmente, a automação às vezes se sai pior que um ser humano.
Ficou claro que não poderíamos evitar a marcação manual, e adicionamos uma segunda etapa ao nosso fluxo — o envio para verificação manual por um ser humano. Textos publicados que o classificador não detectou problemas estavam sujeitos a isso. Você pode facilmente imaginar a magnitude dessa tarefa, portanto, não apenas contamos com os avaliadores, mas também utilizamos a "sabedoria da multidão", ou seja, pedimos ajuda aos trabalhadores de micro-tarefas. Eles nos ajudam a identificar o que a máquina perdeu, e, assim, ensinam-na.
Cache inteligente e hashing sensível à localidade
Outro problema com o qual nos deparamos ao lidar com comentários foi o spam, mais precisamente, seus volumes e a velocidade de propagação. Quando a audiência do Yandex.District começou a crescer rapidamente, os spammers apareceram. Eles aprenderam a contornar as expressões regulares, alterando ligeiramente o texto. O spam, claro, ainda era detectado e removido, mas em uma escala como a do Yandex, uma mensagem inaceitável, mesmo que exibida por apenas 5 minutos, poderia ser vista por centenas de pessoas.
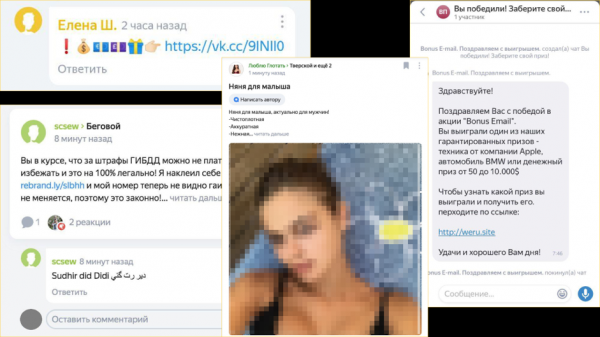
Isso, naturalmente, não nos agradava, e fizemos um cache inteligente dos textos com base em LSH (). Funciona assim: normalizamos o texto, removemos links e o dividimos em n-gramas (sequências de n letras). Em seguida, calculamos hashes dos n-gramas e, com base neles, construímos o vetor LSH do documento. A ideia é que textos semelhantes, mesmo que um pouco alterados, se transformem em vetores semelhantes.
Essa solução permitiu reaproveitar os veredictos dos classificadores e trabalhadores de micro-tarefas para textos semelhantes. Em caso de ataque de spam, assim que a primeira mensagem passava pela verificação e era armazenada em cache com o veredicto "spam", todas as novas mensagens semelhantes, mesmo que modificadas, recebiam o mesmo veredicto e eram removidas automaticamente. Mais tarde, aprendemos a treinar e re-treinar automaticamente os classificadores de spam, mas esse "cache inteligente" permaneceu conosco e ainda frequentemente nos ajuda.
Classificador de textos bons
Sem tempo para respirar após a luta contra o spam, percebemos que 95% do nosso conteúdo é moderado manualmente: os classificadores reagem apenas a violações, enquanto a maioria dos textos é boa. Estamos contratando classificados que, em 95 casos de 100, dão a avaliação "Tudo OK". Tivemos que nos envolver em um trabalho pouco familiar — criar classificadores de bom conteúdo, sendo que já acumulamos uma quantidade suficiente de marcações nesse tempo.
O primeiro classificador funcionava assim: fazemos a lematização do texto (trazemos as palavras para a forma base), descartamos todas as partes do discurso funcionais e aplicamos um "dicionário de boas lemas" que já tínhamos preparado. Se todas as palavras no texto são "boas", então o texto inteiro não contém violações. Esse método imediatamente trouxe entre 25 a 35% de automação na marcação manual em diferentes serviços. Claro, esse método não é ideal: é fácil combinar algumas palavras inocentes e obter uma declaração muito ofensiva, mas permitiu que rapidamente alcançássemos um bom nível de automação e nos deu tempo para treinar modelos mais complexos.
As versões seguintes dos classificadores de textos bons já incluíam modelos lineares, árvores de decisão e suas combinações. Para a marcação de grosseirias e ofensas, por exemplo, estamos tentando usar a rede neural BERT. Aqui, é importante captar o significado da palavra no contexto e a conexão de palavras em diferentes frases, o que o BERT faz razoavelmente bem. (A propósito, recentemente os colegas das Notícias , como aplicam a tecnologia a uma tarefa fora do padrão — a busca por erros em títulos.) No final, conseguimos automatizar até 90% do fluxo dependendo do serviço.
Precisão, abrangência e velocidade
Para evoluir, é necessário entender que benefícios trazem os diversos classificadores automáticos, as mudanças neles e se a qualidade das verificações manuais não está se degradando. Para isso, aplicamos indicadores de precisão e abrangência.
A precisão é a proporção de veredictos corretos entre todos os veredictos sobre conteúdo inadequado. Quanto maior a precisão, menor o número de falsos positivos. Se não monitorarmos a precisão, poderíamos teoricamente remover todo o spam e palavras de baixo calão, juntamente com metade das boas mensagens. Por outro lado, se nos basearmos apenas na precisão, a melhor tecnologia será aquela que não detecta ninguém. Portanto, há também a métrica de completude: a proporção de conteúdo ruim identificado entre todo o volume de conteúdo ruim. Essas duas métricas se equilibram.
Para a medição, amostramos todo o fluxo de entrada de cada serviço e enviamos as amostras de conteúdo para avaliadores para uma avaliação especializada e comparação com as decisões da máquina.
Mas há outra métrica importante.
Como mencionei anteriormente, uma mensagem inaceitável pode ser vista por centenas de pessoas em apenas 5 minutos. Portanto, contabilizamos quantas vezes conseguimos mostrar conteúdo ruim às pessoas antes de ocultá-lo. Isso é importante, pois não basta trabalhar de forma qualificada — é preciso trabalhar rapidamente também. E quando construímos a proteção contra palavras de baixo calão, isso se tornou bastante evidente.
Antigíria através de gatinhos e cães
Um pequeno desvio lírico. Alguém pode argumentar que linguagem ofensiva e insultos não são tão perigosos quanto links maliciosos e não são tão irritantes quanto spam. Mas buscamos manter condições confortáveis de comunicação para milhões de usuários, e as pessoas não gostam de voltar a lugares onde são ofendidas. Não é à toa que a proibição de palavrões e insultos está escrita nas regras de muitas comunidades, incluindo o Habr. Mas voltando ao assunto.
Os dicionários de palavrões não conseguem abranger toda a riqueza da língua russa. Apesar de haver apenas quatro raízes principais de palavrões, é possível formar um número incalculável de palavras que não podem ser capturadas por expressões regulares. Além disso, é possível escrever parcialmente a palavra em transliteração, substituir letras por combinações semelhantes, rearranjar letras, adicionar asteriscos, etc. Às vezes, sem contexto, é impossível identificar qual palavra ofensiva o usuário tinha em mente. Respeitamos as regras do Habr, então vamos demonstrar isso não com exemplos reais, mas com gatinhos e cães.
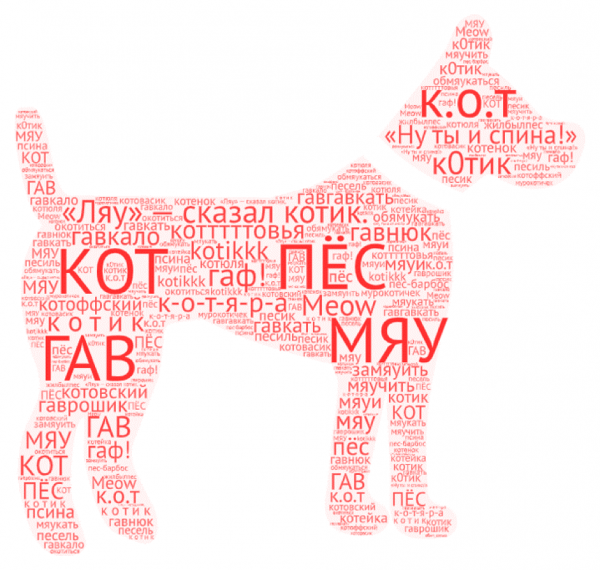
"Miau", disse o gatinho. Mas entendemos que o gatinho disse outra palavra...
Começamos a pensar sobre os algoritmos de "matching difuso" do nosso vocabulário e sobre um pré-processamento mais inteligente: convertíamos para transliteração, uníamos espaços e pontuação, buscávamos padrões e escrevíamos expressões regulares para eles. Essa abordagem trouxe resultados, mas muitas vezes reduzia a precisão, não oferecendo a completude desejada.
Então, decidimos "pensar como os palavrões". Começamos a inserir ruído nos dados: rearranjávamos letras, gerávamos erros de digitação, substituíamos letras por semelhantes na escrita e assim por diante. A marcação inicial para isso era feita aplicando dicionários de palavrões a grandes corporações de textos. Se pegarmos uma frase e distorcê-la de várias maneiras, já obtemos muitas frases. Assim, podemos aumentar o conjunto de treinamento em dezenas de vezes. Restava apenas treinar algum modelo mais ou menos inteligente que levasse em conta o contexto.
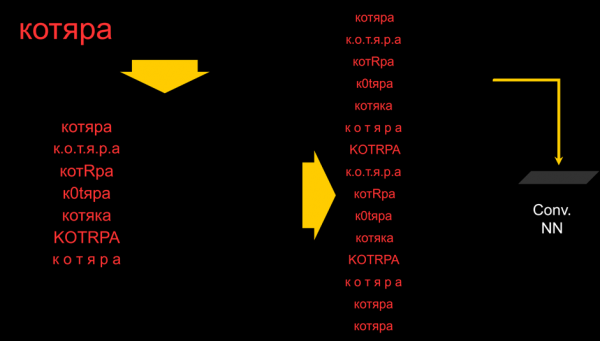
Ainda é cedo para falar sobre a solução final. Continuamos experimentando abordagens para este problema, mas já vemos que uma rede convolucional simples de caracteres com várias camadas supera significativamente os dicionários e expressões regulares: conseguimos aumentar tanto a precisão quanto a completude.
Claro, entendemos que sempre haverá maneiras de contornar até mesmo a automação mais avançada, especialmente quando se trata de algo tão empolgante: escrever de maneira que uma máquina boba não entenda. Aqui, assim como na luta contra spam, não temos como objetivo erradicar a possibilidade de escrever algo vulgar; nossa tarefa é garantir que o jogo não valha a pena.
Abrir espaço para compartilhar opiniões, comunicar-se e comentar é fácil. O mais difícil é alcançar condições seguras e confortáveis e promover o respeito pelas pessoas. E sem isso, não haverá desenvolvimento de qualquer comunidade.
Fonte: habr.com
