

Olá, Habr! Eu sou Artem Karamyshev, líder da equipe de administração de sistemas . No último ano, tivemos muitos lançamentos de novos produtos. Queríamos garantir que os serviços de API fossem facilmente escaláveis, resilientes e preparados para um rápido crescimento da carga de usuários. Nossa plataforma é baseada no OpenStack, e quero compartilhar quais problemas de resiliência dos componentes tivemos que resolver para obter um sistema resiliente. Acredito que isso será interessante para aqueles que também desenvolvem produtos no OpenStack.
A resiliência geral da plataforma é composta pela resiliência de seus componentes. Assim, vamos passar gradualmente por todos os níveis onde identificamos riscos e os resolvemos.
Você pode assistir à versão em vídeo desta história, que teve como origem uma apresentação na conferência Uptime day 4, organizada por , no .
Resiliência da arquitetura física
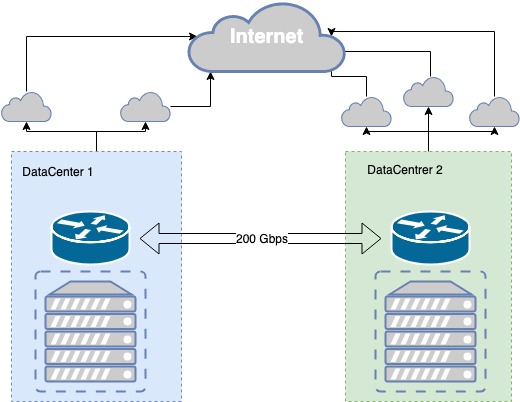
A parte pública da nuvem MCS atualmente está baseada em dois data centers de nível Tier III, entre os quais existe fibra escura própria, reservada em nível físico por diferentes rotas, com capacidade de 200 Gbit/s. O nível Tier III fornece o nível necessário de resiliência da infraestrutura física.
A fibra escura é reservada tanto em nível físico quanto lógico. O processo de reserva de canais foi iterativo, surgiram problemas e estamos constantemente aprimorando a conexão entre os data centers.
Por exemplo, não faz muito tempo, durante trabalhos em uma vala perto de um dos data centers, um escavador perfurou um tubo onde estava tanto o cabo óptico principal quanto o de reserva. Nossa conexão resiliente com o data center ficou vulnerável em um ponto, na vala. Consequentemente, perdemos parte da infraestrutura. Tiramos conclusões, tomamos uma série de ações, incluindo a instalação de fibra óptica adicional na vala vizinha.
Nos data centers, existem pontos de presença de provedores de conectividade, aos quais transmitimos nossos prefixos via BGP. Para cada direção de rede, escolhemos a melhor métrica, o que permite oferecer aos diferentes clientes a melhor qualidade de conexão. Se a conexão por um provedor falhar, reconfiguramos nosso roteamento através dos provedores disponíveis.
No caso de falha de um provedor, mudamos automaticamente para o próximo. Se um dos data centers falhar, temos uma cópia espelho de nossos serviços no segundo data center, que assume toda a carga.
Resiliência da infraestrutura física
O que usamos para resiliência no nível de aplicações
Nosso serviço é baseado em uma série de componentes open source.
ExaBGP — um serviço que implementa várias funções utilizando o protocolo de roteamento dinâmico baseado em BGP. Usamos isso ativamente para anunciar nossos endereços IP públicos, pelos quais os usuários acessam a API.
HAProxy — um balanceador de carga de alto desempenho que permite configurar regras de balanceamento de tráfego muito flexíveis em diferentes níveis do modelo OSI. Usamos isso para balancear em frente a todos os serviços: bancos de dados, corretores de mensagens, serviços de API, serviços web, nossos projetos internos — tudo está por trás do HAProxy.
Aplicativo da API — um aplicativo web escrito em python, com o qual o usuário gerencia sua infraestrutura, seu serviço.
Aplicativo Worker (doravante apenas worker) — nos serviços OpenStack, este é um daemon de infraestrutura que permite transmitir comandos da API para a infraestrutura. Por exemplo, a criação de um disco ocorre exatamente no worker, enquanto a solicitação de criação é feita no aplicativo da API.
Arquitetura padrão do OpenStack Application
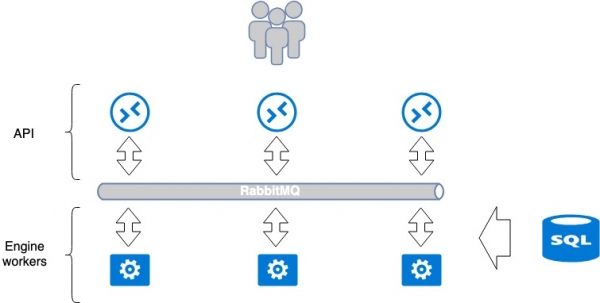
A maioria dos serviços desenvolvidos para OpenStack tenta seguir uma única paradigmática. O serviço geralmente consiste em 2 partes: a API e os workers (executores de backend). Normalmente, a API é um aplicativo WSGI em Python, que é executado como um processo autônomo (daemon) ou com um servidor web já pronto como Nginx ou Apache. A API processa as solicitações do usuário e passa instruções adicionais para o aplicativo worker. A comunicação ocorre através de um corretor de mensagens, geralmente RabbitMQ, enquanto os outros têm suporte limitado. Quando as mensagens chegam ao corretor, os workers as processam e, se necessário, retornam uma resposta.
Este paradigma implica pontos de falha isolados: RabbitMQ e o banco de dados. No entanto, o RabbitMQ é isolado dentro de um único serviço e, em teoria, pode ser dedicado a cada serviço. Assim, na MCS, dividimos esses serviços ao máximo, criando um banco de dados separado e um RabbitMQ separado para cada projeto. Essa abordagem é boa, pois, em caso de falha em alguns pontos vulneráveis, não todo o serviço quebra, apenas uma parte dele.
O número de aplicativos worker não é limitado, portanto, a API pode ser facilmente escalonada horizontalmente através de balanceadores de carga para aumentar o desempenho e a resiliência.
Em alguns serviços, a coordenação interna é necessária — quando ocorrem operações sequenciais complexas entre a API e os workers. Nesse caso, utiliza-se um único centro de coordenação, um sistema de cluster como Redis, Memcache, etcd, que permite que um worker informe a outro que essa tarefa está atribuída a ele ("você, por favor, não a aceite"). Nós usamos etcd. Geralmente, os workers se comunicam ativamente com o banco de dados, lendo e escrevendo informações a partir dele. Como banco de dados, usamos MariaDB, que está em um cluster multimestre.
Um serviço único clássico é organizado de uma maneira amplamente aceita para OpenStack. Pode ser visto como um sistema fechado, para o qual as maneiras de escalonamento e resiliência são bastante óbvias. Por exemplo, para resiliência, basta colocar um balanceador de carga à frente da API. O escalonamento dos workers é alcançado pelo aumento de sua quantidade.
O ponto fraco de todo o sistema são o RabbitMQ e o MariaDB. Sua arquitetura merece um artigo à parte. Neste artigo, quero focar na resistência a falhas da API.
Arquitetura da Aplicação Openstack. Balanceamento e resistência a falhas da plataforma em nuvem
Tornando o balanceador HAProxy resistente a falhas com o ExaBGP
Para que nossas APIs sejam escaláveis, rápidas e resistentes a falhas, colocamos um balanceador na frente delas. Escolhemos o HAProxy. Em minha opinião, ele possui todas as características necessárias para nossa tarefa: balanceamento em vários níveis do OSI, interface de gerenciamento, flexibilidade e escalabilidade, um grande número de métodos de balanceamento e suporte a tabelas de sessão.
O primeiro problema que precisávamos resolver era a resistência a falhas do próprio balanceador. Apenas instalar o balanceador também cria um ponto de falha: se o balanceador falha, o serviço cai. Para evitar isso, utilizamos o HAProxy em conjunto com o ExaBGP.
O ExaBGP permite implementar um mecanismo de verificação do estado do serviço. Utilizamos esse mecanismo para verificar a funcionalidade do HAProxy e, em caso de problemas, desativar o serviço HAProxy do BGP.
Diagrama ExaBGP+HAProxy
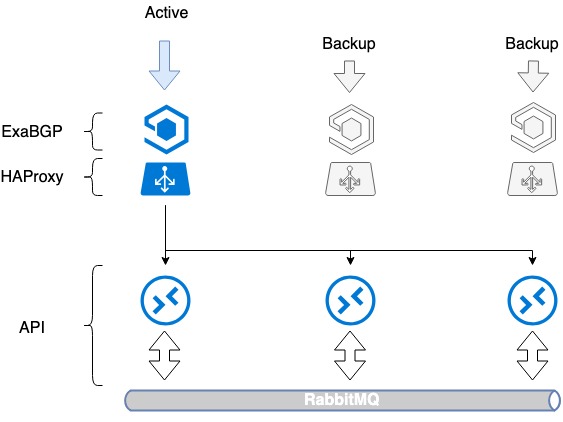
- Instalamos o software necessário, ExaBGP e HAProxy, em três servidores.
- Em cada um dos servidores, criamos uma interface loopback.
- Em todos os três servidores, configuramos essa interface com o mesmo endereço IP público.
- O endereço IP público é anunciado na internet através do ExaBGP.
A resistência a falhas é alcançada ao anunciar o mesmo endereço IP de todos os três servidores. Do ponto de vista da rede, o mesmo endereço está disponível a partir de três diferentes next hops. O roteador vê três rotas idênticas, escolhe a de maior prioridade com base em sua própria métrica (geralmente a mesma opção) e o tráfego vai apenas para um dos servidores.
Em caso de problemas com o HAProxy ou se um servidor falhar, o ExaBGP para de anunciar a rota e o tráfego muda suavemente para o outro servidor.
Assim, alcançamos a resistência a falhas do balanceador.
Resistência a falhas dos balanceadores HAProxy
O esquema resultou não sendo ideal: conseguimos fazer backup do HAProxy, mas não aprendemos a distribuir a carga dentro dos serviços. Então, expandimos um pouco esse esquema: mudamos para balanceamento entre vários endereços IP públicos.
Balanceamento baseado em DNS mais BGP
Ainda não resolvemos a questão do balanceamento de carga diante de nossos HAProxy. No entanto, isso pode ser resolvido de maneira bastante simples, assim como fizemos em nossa própria configuração.
Para balancear três servidores, serão necessários 3 endereços IP brancos e o antigo e bom DNS. Cada um desses endereços é definido na interface loopback de cada HAProxy e é anunciado na internet.
No OpenStack, um catálogo de serviços é utilizado para gerenciar recursos, onde é definido o endpoint API de cada serviço. Neste catálogo, registramos o nome de domínio — public.infra.mail.ru, que é resolvido através do DNS por três endereços IP diferentes. Como resultado, obtemos uma distribuição de carga entre os três endereços por meio do DNS.
No entanto, como ao anunciar os endereços IP brancos não gerenciamos as prioridades de escolha do servidor, isso ainda não é balanceamento. Geralmente, apenas um servidor será escolhido com base na ordem de senioridade do endereço IP, enquanto os outros dois estarão ociosos, pois nenhuma métrica foi especificada no BGP.
Começamos a anunciar rotas através do ExaBGP com métricas diferentes. Cada balanceador anuncia os três endereços IP brancos, mas um deles, o principal para esse balanceador, é anunciado com a menor métrica. Assim, enquanto os três balanceadores estiverem ativos, as solicitações para o primeiro endereço IP chegarão ao primeiro balanceador, as solicitações para o segundo chegarão ao segundo, e as do terceiro ao terceiro.
O que acontece no momento em que um dos balanceadores falha? Quando qualquer balanceador falha, seu endereço principal ainda é anunciado pelos outros dois, e o tráfego entre eles é redistribuído. Assim, fornecemos ao usuário através do DNS vários endereços IP. Através do balanceamento por DNS e métricas diferentes, conseguimos uma distribuição uniforme da carga em todos os três balanceadores, sem perder a redundância.
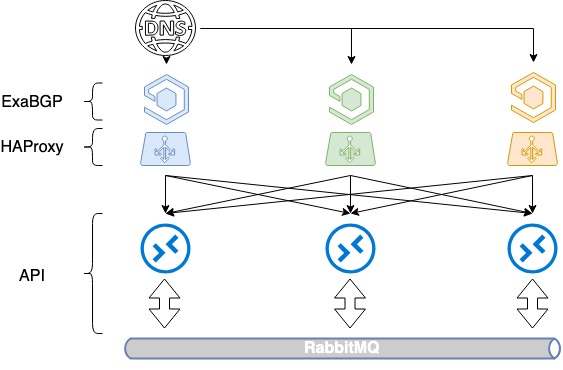
Balanceamento HAProxy baseado em DNS + BGP
Interação entre ExaBGP e HAProxy
Assim, implementamos a redundância para o caso de um servidor sair do ar, com base na interrupção do anúncio das rotas. Mas o HAProxy pode falhar por outras razões além da falha do servidor: erros de administração, falhas internas do serviço. Queremos remover o balanceador quebrado da carga nesses casos, e é necessário um mecanismo diferente.
Portanto, ao expandir o esquema anterior, implementamos um heartbeat entre ExaBGP e HAProxy. Esta é uma implementação de software da interação entre ExaBGP e HAProxy, onde o ExaBGP utiliza scripts personalizados para verificar o status das aplicações.
Para isso, é necessário configurar um verificador de saúde no config do ExaBGP, que possa monitorar o status do HAProxy. No nosso caso, configuramos um backend de saúde no HAProxy, e do lado do ExaBGP verificamos com uma simples requisição GET. Se o anúncio deixar de ocorrer, o HAProxy provavelmente não está funcionando, e não deve ser anunciado.
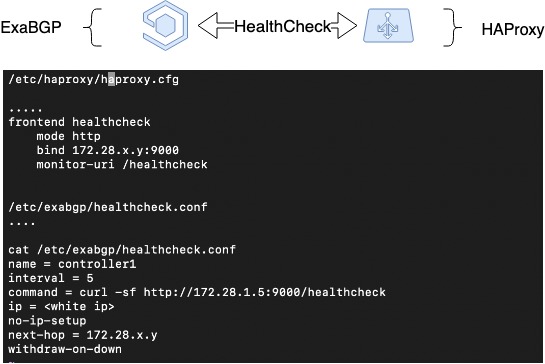
Verificação de Saúde do HAProxy
Peers do HAProxy: sincronização de sessões
A próxima coisa a ser feita foi sincronizar as sessões. Ao operar através de balanceadores distribuídos, é difícil organizar a preservação das informações sobre as sessões dos clientes. Mas o HAProxy é um dos poucos balanceadores que consegue fazer isso graças à funcionalidade de Peers — a capacidade de transferir entre diferentes processos do HAProxy tabelas de sessões.
Existem diferentes métodos de balanceamento: simples, como , e avançados, onde a sessão do cliente é registrada, fazendo com que ele sempre vá para o mesmo servidor que antes. Nós queríamos implementar a segunda opção.
No HAProxy, o mecanismo usado para preservar as sessões do cliente é o stick-tables. Eles armazenam o endereço IP original do cliente, o endereço de destino escolhido (backend) e algumas informações auxiliares. Normalmente, as stick-tables são usadas para armazenar o par source-IP + destination-IP, o que é especialmente útil para aplicações que não conseguem transmitir o contexto da sessão do usuário ao mudar para outro balanceador, por exemplo — no modo de balanceamento RoundRobin.
Se a stick-table puder ser ensinada a se mover entre diferentes processos do HAProxy (entre os quais ocorre o balanceamento), nossos balanceadores poderão operar com um único pool de stick-tables. Isso permitirá uma troca sem interrupção da rede do cliente no caso de falha de um dos balanceadores, e o trabalho com as sessões dos clientes continuará nos mesmos backends que foram escolhidos anteriormente.
Para o funcionamento correto, deve ser resolvido o problema do endereço IP source do balanceador, a partir do qual a sessão foi estabelecida. No nosso caso, trata-se de um endereço dinâmico na interface loopback.
O funcionamento adequado dos peers é alcançado apenas em determinadas condições. Ou seja, os timeouts TCP devem ser suficientemente longos ou a comutação deve ser suficientemente rápida para que a sessão TCP não se desconecte. No entanto, isso permite uma comutação sem interrupções.
Nós temos um serviço em IaaS que é construído com a mesma tecnologia. Este é , chamado Octavia. Ele é baseado em duas instâncias do HAProxy, com suporte nativo para peers. Neste serviço, eles se mostraram extremamente eficazes.
A imagem ilustra esquematicamente a movimentação das tabelas de peers entre três instâncias do HAProxy, com uma configuração sugerida de como isso pode ser configurado:
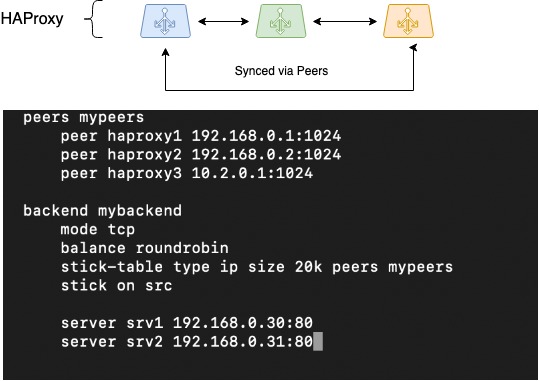
HAProxy Peers (sincronização de sessões)
Se você for implementar um esquema semelhante, é crucial testar seu funcionamento cuidadosamente. Não há garantia de que isso funcionará da mesma forma em 100% dos casos. Mas, pelo menos, você não perderá as stick-tables quando for necessário lembrar o IP de origem do cliente.
Limitação do número de solicitações simultâneas de um mesmo cliente
Qualquer serviço exposto ao público, incluindo nossas APIs, pode estar sujeito a avalanches de solicitações. As razões podem ser variadas, desde erros de usuários até ataques direcionados. Somos periodicamente alvo de DDoS por endereços IP. Clientes frequentemente cometem erros em seus scripts, resultando em mini-DDoS.
Seja como for, é necessário prever uma proteção adicional. Uma solução evidente é limitar o número de solicitações à API e não desperdiçar tempo de CPU processando solicitações maliciosas.
Para implementar tais limitações, usamos limites de taxa, organizados com base no HAProxy, utilizando as mesmas stick-tables. Os limites são configurados de forma bastante simples e permitem restringir o usuário quanto ao número de solicitações à API. O algoritmo registra o IP de origem das solicitações e limita o número de solicitações simultâneas de um único usuário. Naturalmente, calculamos o perfil médio de carga na API de cada serviço e estabelecemos um limite aproximadamente 10 vezes maior que esse valor. Continuamos a monitorar a situação atentamente e mantemos o dedo no pulso.
Como isso se apresenta na prática? Temos clientes que utilizam constantemente nossas APIs para escalonamento automático. Eles criam cerca de duzentas a trezentas máquinas virtuais mais perto da manhã e as eliminam mais perto da noite. Para OpenStack, criar uma máquina virtual, ainda mais com serviços PaaS, requer pelo menos 1000 chamadas de API, uma vez que a interação entre os serviços também ocorre através de APIs.
Esses deslocamentos de tarefas geram uma carga considerável. Avaliamos essa carga, coletamos os picos diários, multiplicamos por dez e isso se tornou nosso limite de taxa. Mantemos um olho atento. Frequentemente vemos bots e scanners que estão tentando observar se temos algum script CGA que possa ser acionado, e nós os bloqueamos ativamente.
Como atualizar a base de código sem que os usuários percebam
Implemetamos a tolerância a falhas também no nível dos processos de deploy de código. Durante as implementações, podem ocorrer falhas, mas seu impacto na disponibilidade dos serviços pode ser minimizado.
Estamos constantemente atualizando nossos serviços e devemos garantir o processo de atualização da base de código sem efeito para os usuários. Conseguimos resolver essa tarefa utilizando as capacidades de gerenciamento do HAProxy e implementando o Graceful Shutdown em nossos serviços.
Para resolver essa tarefa, foi necessário garantir o gerenciamento do balanceador e o desligamento 'correto' dos serviços:
- No caso do HAProxy, o gerenciamento é feito através do arquivo de stats, que na essência é um socket e é definido na configuração do HAProxy. Podemos enviar comandos a ele através do stdio. Mas nossa principal ferramenta para controle de configurações é o ansible, portanto, ele possui um módulo embutido para gerenciamento do HAProxy, que utilizamos ativamente.
- A maior parte de nossos serviços API e Engine suportam tecnologias de graceful shutdown: ao serem desligados, eles aguardam a conclusão total da tarefa atual, seja uma solicitação http ou uma tarefa auxiliar. O mesmo acontece com o worker. Ele conhece todas as tarefas que está realizando e é encerrado quando tudo está finalizado com sucesso.
Graças a esses dois pontos, o algoritmo seguro do nosso deploy se apresenta da seguinte forma.
- O desenvolvedor compila um novo pacote de código (que em nosso caso é RPM), testa no ambiente de desenvolvimento, testa no stage e o deixa no repositório de stage.
- O desenvolvedor coloca a tarefa de deploy com a descrição mais detalhada dos "artefatos": versão do novo pacote, descrição da nova funcionalidade e outros detalhes sobre o deploy caso necessário.
- O administrador do sistema inicia a atualização. Ele executa o playbook Ansible, que por sua vez faz o seguinte:
- Ele obtém o pacote do repositório de stage e atualiza a versão do pacote no repositório de produção.
- Elabora uma lista de backends do serviço sendo atualizado.
- Desliga o primeiro serviço a ser atualizado no HAProxy e aguarda a conclusão dos seus processos. Graças ao graceful shutdown, temos certeza de que todos os pedidos atuais dos clientes serão concluídos com sucesso.
- Após a interrupção total da API, dos workers e do desligamento do HAProxy, ocorre a atualização do código.
- O Ansible inicia os serviços.
- Para cada serviço, ele ativa certas "alavancas" que realizam testes unitários de acordo com uma série de testes chave pré-definidos. Uma verificação básica do novo código é feita.
- Se não forem encontrados erros na etapa anterior, o backend é ativado.
- Passamos para o próximo backend.
- Após a atualização de todos os backends, testes funcionais são executados. Se forem insuficientes, o desenvolvedor verifica qualquer nova funcionalidade que tenha implementado.
Nesse ponto, o deploy está concluído.
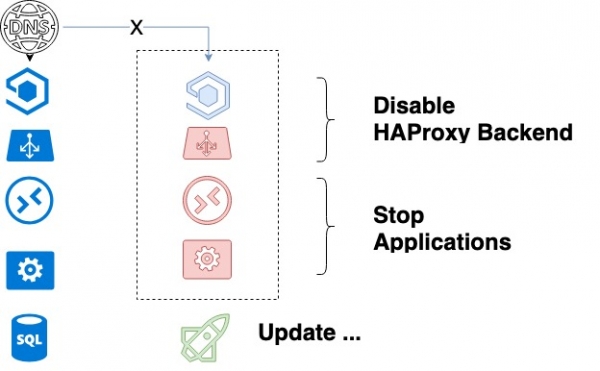
Ciclo de atualização do serviço
Este esquema não funcionaria se não tivéssemos uma regra. Mantemos simultaneamente a versão antiga e a nova em produção. Desde a fase de desenvolvimento do software, é considerado que mesmo que haja mudanças no banco de dados do serviço, elas não quebrarão o código anterior. Como resultado, ocorre uma atualização gradual da base de código.
Conclusão
Compartilhando meus próprios pensamentos sobre arquitetura WEB resiliente, quero mais uma vez destacar seus pontos-chave:
- resiliência física;
- resiliência de rede (balanceadores, BGP);
- resiliência do software utilizado e desenvolvido.
A todos, um uptime estável!
Fonte: habr.com
