

Este artigo reúne alguns modelos comuns que ajudam os engenheiros a trabalhar com serviços em larga escala que recebem milhões de solicitações.
De acordo com a experiência do autor, esta não é uma lista exaustiva, mas realmente eficazes dicas. Então, vamos começar.
Traduzido com o apoio de .
Nível inicial
As medidas listadas abaixo são relativamente simples de implementar, mas oferecem um alto retorno. Se você nunca as adotou antes, ficará surpreso com as melhorias significativas.
Infraestrutura como código
A primeira parte das dicas consiste em implementar infraestrutura como código. Isso significa que você deve ter uma maneira programática de implantar toda a infraestrutura. Parece complicado, mas, na verdade, estamos falando do seguinte código:
Implantação de 100 máquinas virtuais
- com Ubuntu
- 2 GB de RAM em cada uma
- elas terão o seguinte código
- com essas configurações
Você pode rastrear alterações na infraestrutura e retornar rapidamente a elas com um sistema de controle de versões.
O modernista que existe em mim diz que podemos usar Kubernetes/Docker para fazer tudo isso, e ele está certo.
Além disso, a automação pode ser alcançada com Chef, Puppet ou Terraform.
Integração e entrega contínuas
Para criar um serviço escalável, é importante ter um pipeline de construção e teste para cada pull request. Mesmo que o teste seja o mais simples, ele garante pelo menos que o código que você está implantando compile.
A cada vez, nesta etapa, você responde à pergunta: minha construção compilará e passará os testes, é válida? Isso pode parecer um padrão baixo, mas resolve muitos problemas.
Não há nada mais bonito do que ver essas marcações
Para esta tecnologia, você pode avaliar Github, CircleCI ou Jenkins.
Balanceadores de carga
Então, queremos executar um balanceador de carga para redirecionar o tráfego e garantir uma carga equilibrada em todos os nós ou o funcionamento do serviço em caso de falha:
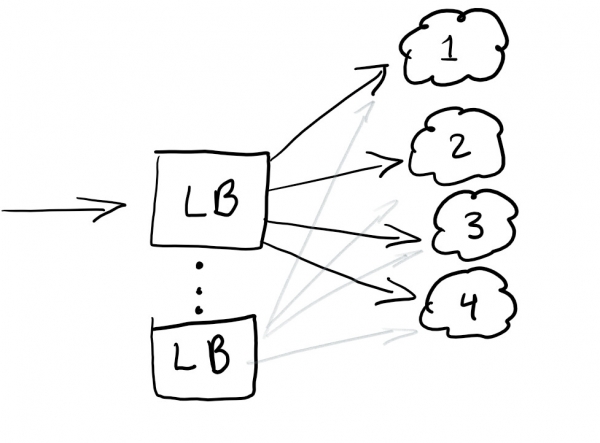
O balanceador de carga geralmente ajuda bem a distribuir o tráfego. A melhor prática é a balanceamento redundante para que você não tenha um único ponto de falha.
Normalmente, os balanceadores de carga são configurados na nuvem que você utiliza.
RayID, ID de correlação ou UUID para solicitações
Você já encontrou um erro em um aplicativo com uma mensagem como esta: “Algo deu errado. Salve este id e envie-o para o nosso suporte técnico”?
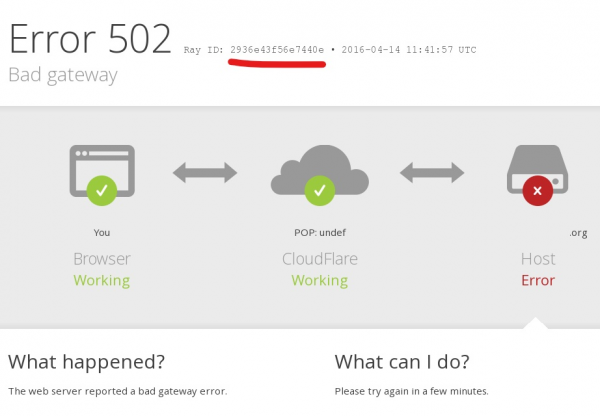
Um identificador exclusivo, correlation ID, RayID ou qualquer uma das variantes, é um identificador que permite rastrear a solicitação durante seu ciclo de vida. Isso permite rastrear todo o percurso da solicitação nos logs.
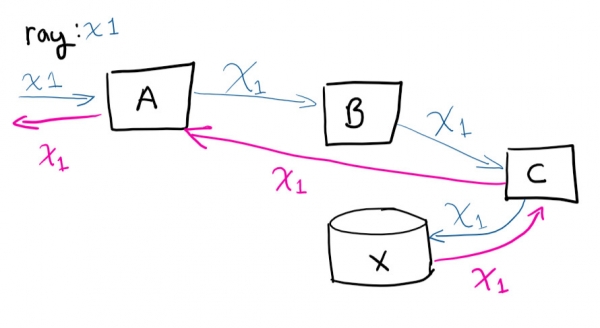
O usuário faz uma solicitação ao sistema A, depois A se conecta a B, que se conecta a C, salva em X e então a solicitação retorna a A
Se você se conectasse remotamente às máquinas virtuais e tentasse rastrear o percurso da solicitação (e manualmente correlacionar quais chamadas estão sendo feitas), você ficaria louco. Ter um identificador exclusivo torna a vida muito mais fácil. É uma das coisas mais simples que você pode fazer para economizar tempo à medida que o serviço cresce.
Nível médio
Aqui, os conselhos são mais complicados do que os anteriores, mas as ferramentas adequadas tornam a tarefa mais fácil, garantindo o retorno sobre o investimento mesmo para pequenas e médias empresas.
Registro centralizado
Parabéns! Você implantou 100 máquinas virtuais. No dia seguinte, o CEO vem e reclama sobre um erro que recebeu durante os testes do serviço. Ele informa o identificador relevante, sobre o qual falamos anteriormente, mas você terá que revisar os logs de 100 máquinas para encontrar aquela que falhou. E você precisa encontrá-la antes da apresentação de amanhã.
Embora isso soe como uma divertida aventura, é melhor garantir que você tenha a capacidade de pesquisar todos os logs de um só lugar. Eu resolvi a tarefa de centralização dos logs usando a funcionalidade integrada do stack ELK: aqui é suportada a coleta de logs com capacidade de busca. Isso realmente ajudará a resolver o problema de encontrar um log específico. Como um bônus, você pode criar gráficos e outras coisas divertidas.
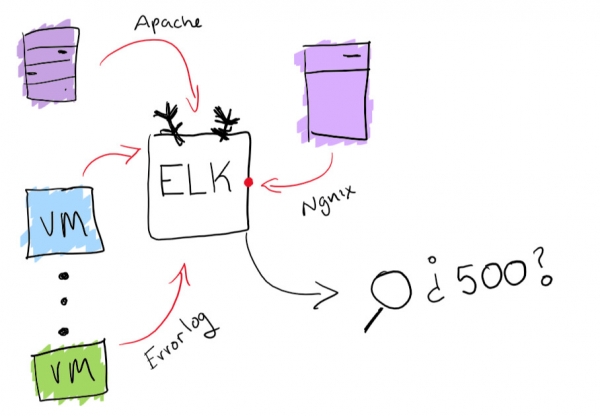
Funcionalidade do stack ELK
Agentes de monitoramento
Agora que seu serviço está em operação, você precisa garantir que ele funcione sem falhas. A melhor maneira de fazer isso é rodar vários agentes, que funcionam em paralelo e verificam se ele está funcionando e se as operações básicas estão sendo realizadas.
Neste estágio, você verifica se a compilação em execução está se saindo bem e funcionando normalmente.
Para projetos pequenos e médios, recomendo o Postman para monitorar e documentar APIs. Mas, no geral, é importante ter uma maneira de saber quando ocorreu uma falha e receber um alerta oportuno.
Autoescalonamento com base na carga
É muito simples. Se você tem uma máquina virtual atendendo solicitações e ela está se aproximando de 80% de uso da memória, você pode aumentar seus recursos ou adicionar mais máquinas virtuais ao cluster. A execução automática dessas operações é excelente para ajustar a capacidade com base na carga. Mas você sempre deve ter cuidado com quanto dinheiro está gastando e estabelecer limites razoáveis.
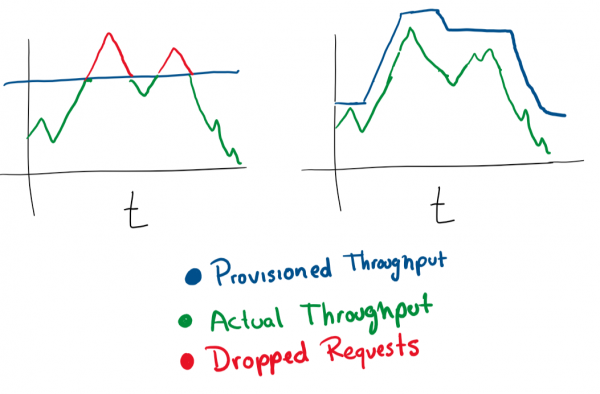
Na maioria dos serviços de nuvem, você pode configurar o escalonamento automático usando mais servidores ou servidores mais poderosos.
Sistema de experimentos
Uma boa maneira de implantar atualizações de forma segura é permitir testes para 1% dos usuários durante uma hora. Você, é claro, já viu esses mecanismos em ação. Por exemplo, o Facebook mostra para partes da audiência uma cor diferente ou muda o tamanho da fonte para observar como os usuários percebem as alterações. Isso é chamado de teste A/B.
Até mesmo o lançamento de um novo recurso pode ser iniciado como um experimento, e depois você pode decidir como lançá-lo. Além disso, você tem a capacidade de "retornar" ou alterar a configuração em tempo real, considerando a funcionalidade que está degradando seu serviço.
Nível avançado
Aqui estão dicas que são bastante difíceis de implementar. Provavelmente, você precisará de um pouco mais de recursos, então será difícil para uma pequena ou média empresa lidar com isso.
Implantações blue-green
Isso é o que eu chamo de uma maneira "erlangiana" de implantar. O Erlang se tornou amplamente utilizado quando as companhias telefônicas surgiram. Para rotear chamadas telefônicas, foram utilizados comutadores de software. A principal tarefa do software desses comutadores era não interromper as chamadas durante a atualização do sistema. O Erlang tem uma ótima maneira de carregar um novo módulo sem derrubar o anterior.
Esta etapa depende da disponibilidade de um balanceador de carga. Suponha que você tenha a versão N do seu software e agora queira implantar a versão N+1.
Você poderia simplesmente parar o serviço e implantar a próxima versão no momento que considerar conveniente para os seus usuários, resultando em algum tempo de inatividade. Mas suponha que você tenha realmente condições rigorosas de SLA. Assim, um SLA de 99,99% significa que você pode ficar offline apenas por 52 minutos ao ano.
Se você realmente deseja alcançar esses números, são necessárias duas implantações simultaneamente:
- a que está agora (N);
- a próxima versão (N+1).
Você indica ao balanceador de carga para redirecionar uma porcentagem do tráfego para a nova versão (N+1), enquanto você monitora ativamente as regressões.
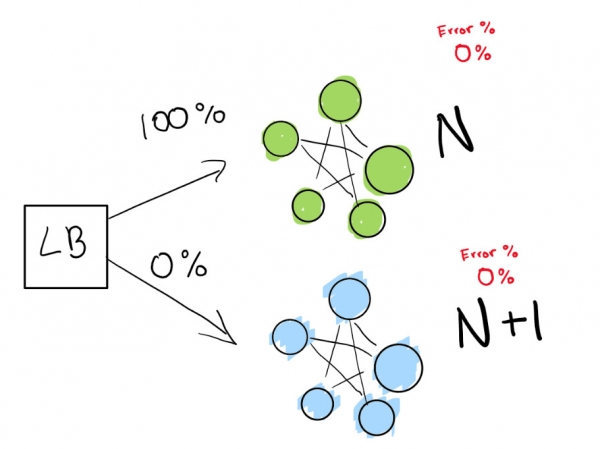
Aqui temos a implantação verde N, que está funcionando normalmente. Estamos tentando migrar para a próxima versão dessa implantação
Primeiro, enviamos um teste realmente pequeno para ver se nossa implantação N+1 funciona com um pouco de tráfego:
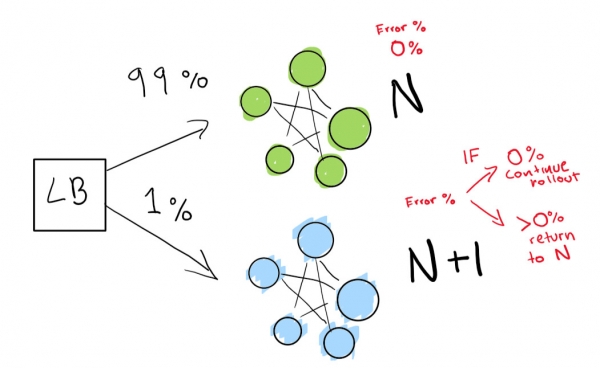
Por fim, temos um conjunto de verificações automáticas, que acabamos executando até que nossa implantação esteja completa. Se você for realmente, realmente cauteloso, também pode manter sua implantação N por tempo indeterminado para um rápido retrocesso em caso de uma regressão ruim:
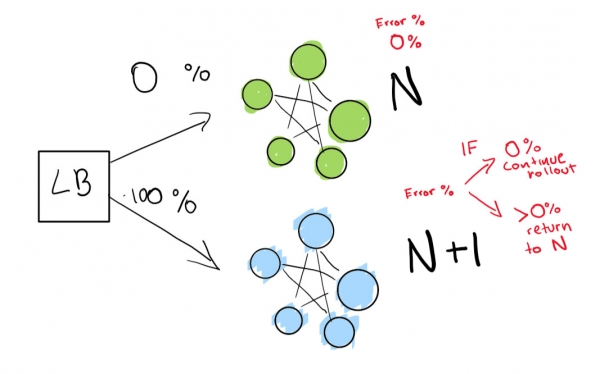
Se deseja levar isso a um nível ainda mais avançado, que tudo na implantação azul-verde seja automatizado.
Detecção de anomalias e mitigação automática
Considerando que você possui um registro de logs centralizado e uma boa coleta de logs, já pode estabelecer metas mais altas. Por exemplo, prever falhas proativamente. Em monitores e logs, funções são monitoradas e são construídos vários gráficos - e é possível prever com antecedência o que pode dar errado:
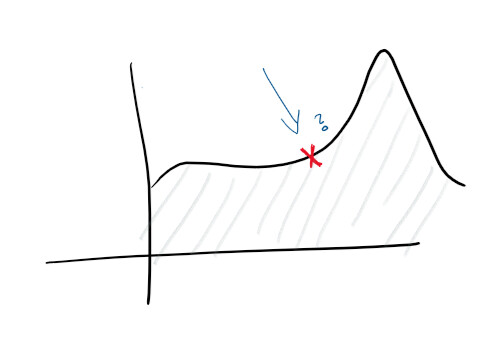
Com a detecção de anomalias, você começa a analisar algumas pistas que o serviço fornece. Por exemplo, um pico de carga na CPU pode indicar que o disco rígido está falhando, e um aumento nas solicitações significa que é necessário escalar. Esse tipo de dado estatístico permite que o serviço seja proativo.
Ao obter esses dados analíticos, você pode escalar em qualquer dimensão, alterando proativa e reativamente as características de máquinas, bancos de dados, conexões e outros recursos.
Isso é tudo!
Essa lista de prioridades irá te livrar de muitos problemas ao escalar um serviço em nuvem.
O autor do artigo original convida os leitores a deixar seus comentários e propor alterações. O artigo é distribuído como fonte aberta, e o autor aceita pull requests no Github. .
O que mais ler sobre o tema:
Fonte: habr.com
