

As imagens no formato JPEG estão em toda parte em nossas vidas digitais, mas por trás dessa camada de conscientização existem algoritmos que eliminam detalhes invisíveis ao olho humano. O resultado é a mais alta qualidade visual com o menor tamanho de arquivo possível – mas como exatamente isso funciona? Vamos explorar o que nossos olhos não podem ver!
É fácil considerar como algo normal a capacidade de enviar uma foto a um amigo sem se preocupar com qual dispositivo, navegador ou sistema operacional ele está usando – no entanto, isso nem sempre foi assim. No início dos anos 1980, os computadores podiam armazenar e exibir imagens digitais, mas havia muitas ideias concorrentes sobre a melhor forma de fazer isso. Não era simplesmente possível enviar uma imagem de um computador para outro e esperar que tudo funcionasse.
Para resolver esse problema, em 1986, um comitê de especialistas de todo o mundo foi formado, denominado "" (Joint Photographic Experts Group, JPEG), estabelecido por meio da colaboração da Organização Internacional de Normalização (ISO) e da Comissão Eletrotécnica Internacional (IEC) – duas organizações de normalização internacionais com sede em Genebra, Suíça.
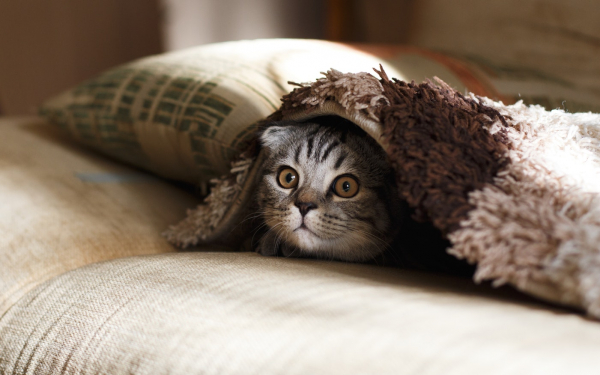
Um grupo de pessoas chamado JPEG criou o padrão de compressão de imagens digitais JPEG em 1992. Qualquer pessoa que tenha usado a internet provavelmente já se deparou com imagens codificadas em JPEG. Este é o método mais comum de codificação, envio e armazenamento de imagens. De páginas da web a e-mails e redes sociais, o JPEG é utilizado bilhões de vezes por dia – praticamente toda vez que olhamos uma imagem online ou a enviamos. Sem o JPEG, a web seria menos vibrante, mais lenta e, provavelmente, teria menos fotos de gatinhos!
Este artigo é sobre como decodificar uma imagem JPEG. Em outras palavras, trata-se do que é necessário para transformar dados comprimidos, armazenados no computador, em uma imagem que aparece na tela. Isso é importante não apenas para entender a tecnologia que usamos diariamente, mas também porque, ao revelar os níveis de compressão, aprendemos mais sobre percepção e visão, além de quais detalhes nossos olhos percebem melhor.
Além disso, brincar com imagens dessa maneira é muito interessante.
Examinando o interior do JPEG
No computador, tudo é armazenado como uma sequência de números binários. Normalmente, esses bits, zeros e uns, são agrupados em conjuntos de oito, formando bytes. Quando você abre uma imagem JPEG no computador, algo (navegador, sistema operacional, ou outro) precisa decodificar os bytes, restaurando a imagem original como uma lista de cores que podem ser exibidas.
Se você baixar esta adorável e abri-la em um editor de texto, verá um monte de símbolos sem conexão.
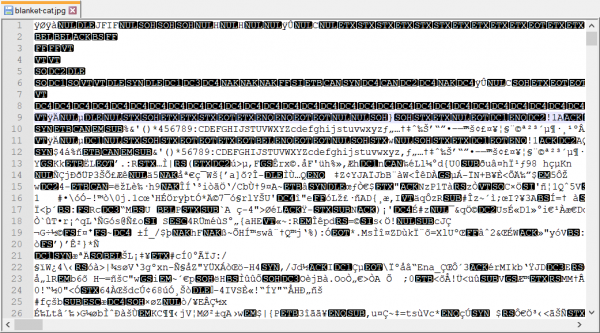
Aqui estou usando o Notepad++ para examinar o conteúdo do arquivo, pois editores de texto comuns, como o Notepad do Windows, corrompem o arquivo binário após salvar, e ele deixa de atender ao formato JPEG.
Abrindo a imagem em um editor de texto, você confunde o computador, assim como confunde seu cérebro ao esfregar os olhos e começar a ver manchas coloridas!
Essas manchas que você vê são conhecidas como , e não são resultado da exposição a um estímulo luminoso ou alucinações geradas pela mente. Elas ocorrem porque seu cérebro presume que quaisquer sinais elétricos nos nervos oculares transmitem informações sobre a luz. O cérebro precisa fazer essas suposições, uma vez que não há como saber se o sinal é som, visão ou algo mais. Todos os nervos do corpo transmitem impulsos elétricos absolutamente iguais. Ao pressionar os olhos, você está enviando sinais que não são visuais, mas ativam os receptores dos olhos, que seu cérebro interpreta – neste caso, de forma incorreta – como algo visual. Você é literalmente capaz de ver a pressão!
É curioso pensar em como os computadores se assemelham ao cérebro, mas isso também é uma analogia útil que ilustra o quão fortemente o significado dos dados — transmitidos pelo corpo por nervos ou armazenados em um computador — depende de sua interpretação. Todos os dados binários são compostos de zeros e uns, componentes básicos capazes de transmitir informações de qualquer tipo. Seu computador muitas vezes deduz como interpretá-los com pistas, como extensões de arquivos. E agora estamos fazendo com que ele os interprete como texto, pois é isso que um editor de texto espera.
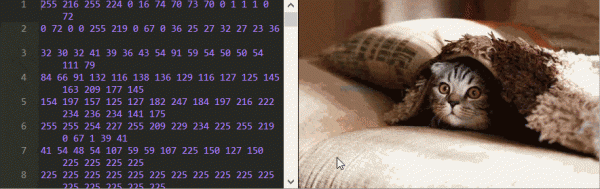
Para entender como decodificar JPEG, precisamos ver os próprios sinais originais — os dados binários. Isso pode ser feito através de um editor hexadecimal, ou diretamente na ! Há uma imagem, ao lado da qual no campo de texto estão todos os seus bytes (exceto o cabeçalho) apresentados em formato decimal. Você pode alterá-los, e o script irá recodificar e gerar uma nova imagem em tempo real.
É possível aprender muito apenas brincando com esse editor. Por exemplo, você consegue dizer em que ordem os pixels estão armazenados?
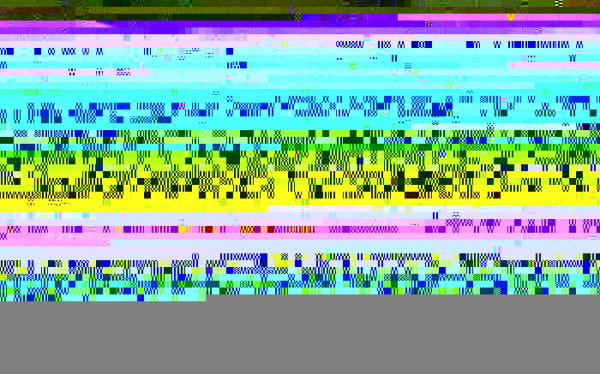
Neste exemplo, o estranhamento é que alterar alguns números não afeta a imagem, mas, por exemplo, se você substituir o número 17 por 0 na primeira linha, a foto será completamente danificada!
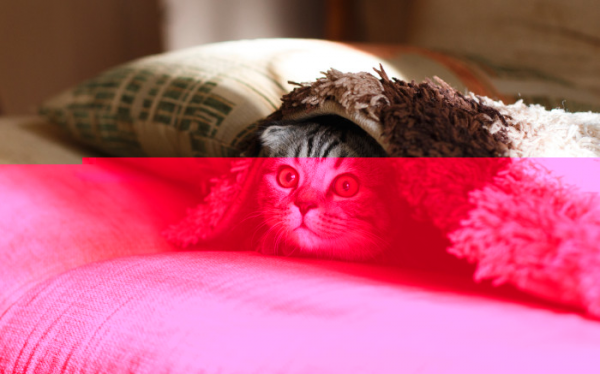
Outras alterações, como substituir 7 na linha 1988 por 254, mudam a cor, mas apenas dos pixels subsequentes.
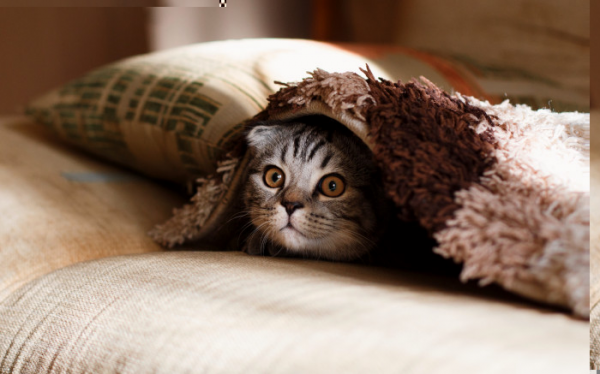
Pode ser mais estranho que alguns números mudam não apenas a cor, mas também a forma da imagem. Mude 70 na linha 12 para 2 e observe a linha superior da imagem para ver o que quero dizer.
E independentemente de qual imagem JPEG você esteja usando, você sempre encontrará essas enigmáticas sequências em xadrez ao editar bytes.
Brincando com o editor, é difícil entender como a foto é recriada a partir desses bytes, já que a compressão JPEG consiste em três tecnologias diferentes que são aplicadas sequencialmente em níveis. Vamos estudar cada uma delas separadamente para desvendar o comportamento enigmático que observamos.
Três níveis de compressão JPEG:
- .
- .
- , e
Para que você possa ter uma ideia da escala da compressão, note que a imagem acima representa 79.819 números, ou seja, cerca de 79 KB. Se a armazenássemos sem compressão, precisaríamos de três números para cada pixel – para os componentes vermelho, verde e azul. Isso totalizaria 917.700 números, ou aproximadamente 917 KB. Como resultado da compressão JPEG, o arquivo final foi reduzido em mais de 10 vezes!
Na verdade, esta imagem pode ser comprimida ainda mais. Abaixo estão duas imagens lado a lado – a foto à direita foi comprimida para 16 KB, ou seja, 57 vezes menor que a versão sem compressão!
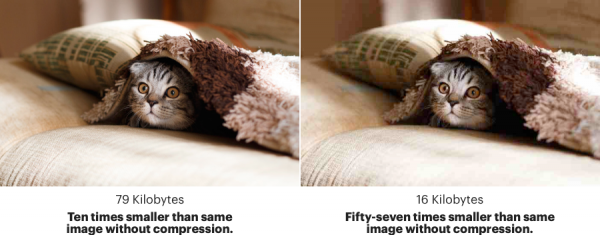
Se você olhar de perto, verá que essas imagens não são idênticas. Ambas são imagens com compressão JPEG, mas a da direita é muito menor em tamanho. Ela também parece um pouco pior (observe os quadrados das cores de fundo). Por isso, o JPEG também é chamado de compressão com perdas; durante o processo de compressão, a imagem muda e perde alguns detalhes.
1. Subamostragem de cor
Aqui está a imagem usando apenas o primeiro nível de compressão.
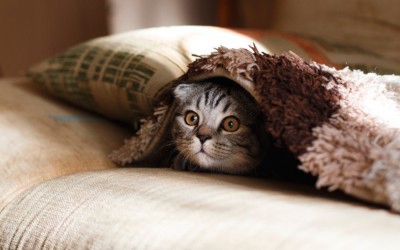
(Versão interativa – no artigo). A remoção de um número destrói todas as cores. No entanto, se removermos exatamente seis números, isso praticamente não afeta a imagem.
Agora os números são um pouco mais fáceis de decifrar. É quase uma lista simples de cores, onde cada byte altera exatamente um pixel, mas já é duas vezes menor que a imagem sem compressão (que ocuparia cerca de 300 KB nesse tamanho reduzido). Você consegue adivinhar por quê?
Pode-se ver que esses números não representam os componentes vermelho, verde e azul padrão, pois se substituir todos os números por zeros, obteremos uma imagem verde (e não branca).

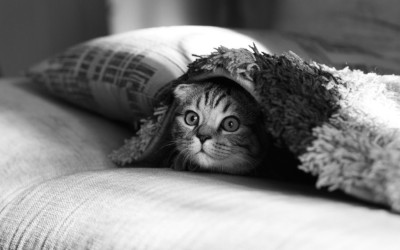
Isso acontece porque esses bytes representam Y (brilho),
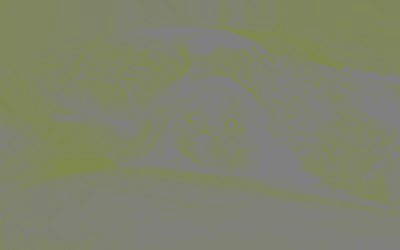
Cb (o azul relativo),
e Cr (o vermelho relativo) da imagem.
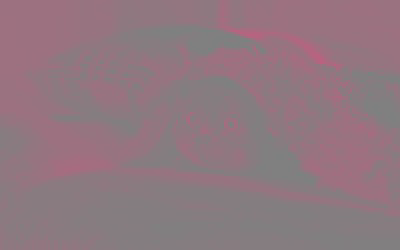
Por que não usar RGB? Afinal, é assim que a maioria dos monitores modernos opera. Seu monitor pode exibir qualquer cor, incluindo vermelho, verde e azul, com diferentes intensidades para cada pixel. O branco é obtido com a ativação total das três, e o preto – com a desativação delas.
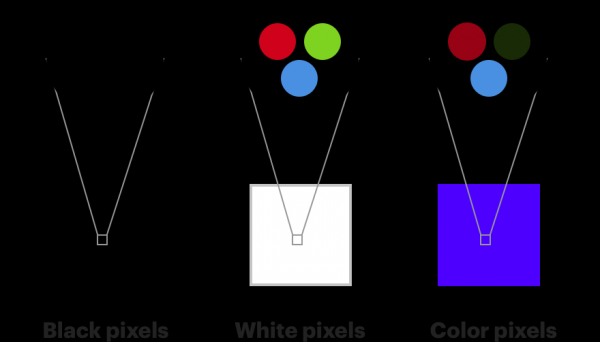
Isso também é muito parecido com o funcionamento do olho humano. Os receptores de cor em nossos olhos são chamados de "«e estão divididos em três tipos, cada um dos quais é mais sensível ao vermelho, ao verde ou ao azul [os cones do tipo S são sensíveis ao azul-violeta (S de Short — espectro de onda curta), os do tipo M ao verde-amarelo (M de Medium — onda média), e os do tipo L ao amarelo-vermelho (L de Long — onda longa) no espectro. A presença dessas três tipos de cones (e bastonetes, sensíveis na parte verde-esmeralda do espectro) dá ao ser humano a visão colorida. / nota do tradutor]. , outro tipo de fotorreceptores em nossos olhos, é capaz de detectar mudanças na luminosidade, mas é muito mais sensível à cor. Temos cerca de 120 milhões de bastonetes e apenas 6 milhões de cones em nossos olhos.
Portanto, nossos olhos notam muito melhor as mudanças na luminosidade do que as mudanças na cor. Se separarmos a cor da luminosidade, podemos remover um pouco de cor, e ninguém perceberá nada. A sub- discretização de cores é o processo de representar os componentes de cor da imagem em uma resolução menor em comparação com os componentes de luminosidade. No exemplo acima, cada pixel tem exatamente um componente Y, enquanto cada grupo separado de quatro pixels tem exatamente um componente Cb e um Cr. Assim, a imagem contém quatro vezes menos informações de cor do que o original.
O espaço de cores YCbCr é utilizado não apenas no JPEG. Foi inicialmente criado em 1938 para transmissões de televisão. Nem todos possuem um televisor colorido, portanto, a separação entre cor e luminosidade permitiu que todos recebessem o mesmo sinal, e os televisores sem cor simplesmente usavam apenas o componente de luminosidade.
Portanto, a remoção de um número no editor desestabiliza completamente todas as cores. Os componentes são armazenados como Y Y Y Y Cb Cr (na verdade, não necessariamente nesta ordem — a ordem de armazenamento é definida no cabeçalho do arquivo). A remoção do primeiro número fará com que o primeiro valor Cb seja percebido como Y, Cr como Cb, resultando em um efeito dominó que altera todas as cores da imagem.
A especificação JPEG não obriga você a usar YCbCr. Mas na maioria dos arquivos, ela é usada, pois oferece imagens de melhor qualidade após a subamostragem em comparação com RGB. Mas você não precisa me acreditar. Veja por si mesmo na tabela abaixo como será a subamostragem de cada componente individual, tanto em RGB quanto em YCbCr.
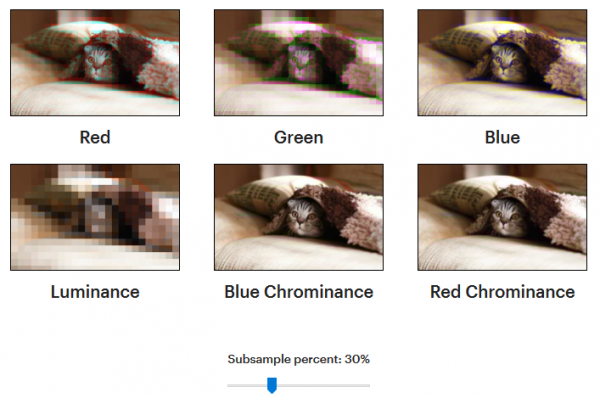
(Versão interativa – no artigos).
A remoção do azul não é tão perceptível quanto a do vermelho ou do verde. Isso porque, dos seis milhões de cones nos seus olhos, cerca de 64% são sensíveis ao vermelho, 32% ao verde e 2% ao azul.
A subamostragem do componente Y (à esquerda embaixo) é a mais visível. Até mesmo uma pequena alteração é perceptível.
A conversão da imagem de RGB para YCbCr não reduz o tamanho do arquivo, mas facilita a busca por detalhes menos perceptíveis que podem ser removidos. A compressão com perdas ocorre na segunda etapa. Sua base é a ideia de representar os dados de uma forma mais compacta.
2. Transformada discreta do cosseno e subamostragem
Esse nível de compressão em grande parte define a essência do JPEG. Após a conversão das cores em YCbCr, os componentes são comprimidos separadamente, então podemos nos concentrar apenas no componente Y. E aqui estão os bytes do componente Y após a aplicação desse nível.
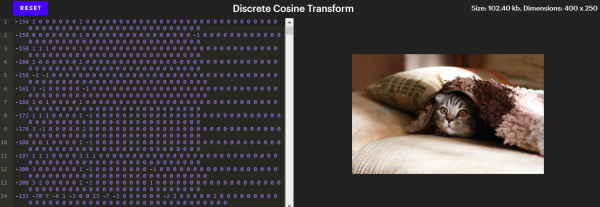
(Versão interativa – no artigos). Na versão interativa, clicar em um pixel rola o editor para a linha que ele representa. Tente remover números do final ou adicionar alguns zeros a um número específico.
À primeira vista, parece uma compressão muito ruim. Em uma imagem com 100.000 pixels, são necessários 102.400 números para representar seu brilho (componentes Y) — isso é pior do que não comprimir nada!
No entanto, note que a maioria desses números é igual a zero. Além disso, todos esses zeros no final das linhas podem ser removidos sem mudar a imagem. Sobram cerca de 26.000 números, o que já é quase quatro vezes menos!
Neste nível está o segredo dos padrões de xadrez. Ao contrário de outros efeitos que vimos, o aparecimento desses padrões não é um bug. Eles são os blocos de construção de toda a imagem. Em cada linha do editor, há exatamente 64 números, os coeficientes da transformada discreta do cosseno (DCT), correspondentes às intensidades de 64 padrões únicos.
Esses padrões são formados com base no gráfico do cosseno. Aqui estão alguns deles:
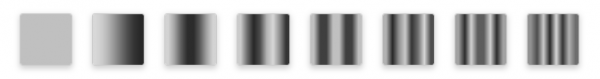
8 dos 64 coeficientes
Abaixo está uma imagem que demonstra todos os 64 padrões.
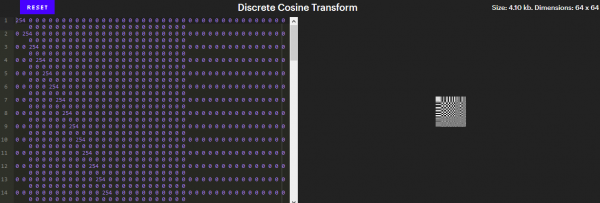
(Versão interativa – no artigos).
Esses padrões têm um significado especial, pois formam a base de imagens de tamanho 8x8. Se você não está familiarizado com álgebra linear, isso significa que qualquer imagem de tamanho 8x8 pode ser obtida a partir desses 64 padrões. DCT é o processo de dividir imagens em blocos de 8x8 e transformar cada bloco em uma combinação desses 64 coeficientes.
O fato de que qualquer imagem pode ser composta por 64 padrões específicos parece mágica. No entanto, é o mesmo que dizer que qualquer lugar na Terra pode ser descrito por dois números - latitude e longitude [especificando os hemisférios / nota do tradutor]. Frequentemente, consideramos a superfície da Terra como bidimensional, portanto, precisamos apenas de dois números. A imagem 8x8 tem 64 dimensões, portanto, precisamos de 64 números.
Ainda não está claro como isso nos ajuda em termos de compressão. Se precisamos de 64 números para representar uma imagem de 8x8, por que esse método seria melhor do que apenas armazenar 64 componentes de brilho? Fazemos isso pela mesma razão pela qual transformamos três números RGB em três números YCbCr: isso nos permite eliminar detalhes imperceptíveis.
É difícil ver quais detalhes estão sendo removidos nesse estágio, uma vez que o JPEG aplica DCT a blocos de 8x8. No entanto, ninguém nos impede de aplicá-lo a uma imagem inteira. Aqui está como o DCT se aplica ao componente Y de uma imagem inteira:
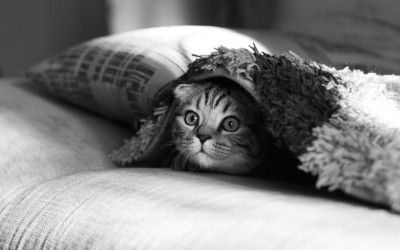
Do final, é possível remover mais de 60.000 números praticamente sem mudanças perceptíveis na foto.
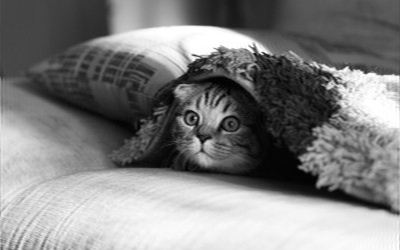
No entanto, observe que se zerarmos os primeiros cinco números, a diferença será óbvia.
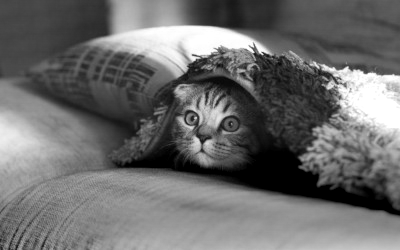
Os números no início representam mudanças de baixa frequência na imagem, e nossos olhos as captam melhor. Os números mais próximos do final representam mudanças de alta frequência, que são mais difíceis de notar. Para 'ver o que não é visível a olho nu', podemos isolar esses detalhes de alta frequência, zerando os primeiros 5000 números.
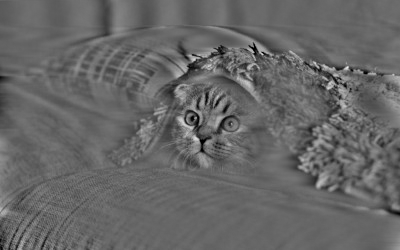
Vemos todas as áreas da imagem onde ocorre a maior mudança de pixel para pixel. Destacam-se os olhos do gato, seus bigodes, o cobertor felpudo e as sombras no canto inferior esquerdo. Podemos ir ainda mais longe, zerando os primeiros 10.000 números:
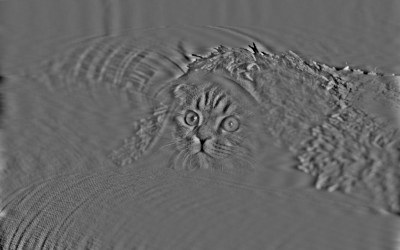
20 000:
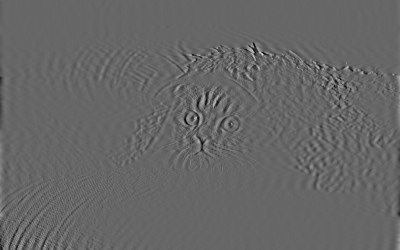
40 000:
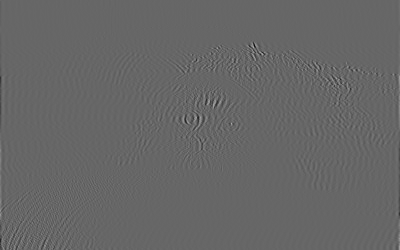
60 000:
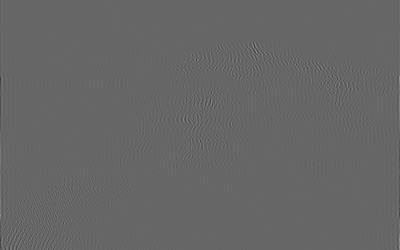
Esses detalhes de alta frequência do JPEG são removidos na fase de compressão. A conversão de cores em coeficientes DCT não é uma perda. As perdas ocorrem na etapa de amostragem, onde valores de alta frequência ou próximos de zero são removidos. Ao diminuir a qualidade da preservação do JPEG, o programa aumenta o limite da quantidade de valores removidos, resultando na redução do tamanho do arquivo, mas tornando a imagem mais pixelizada. Portanto, a imagem na primeira seção, que era 57 vezes menor, parecia assim. Cada bloco de 8x8 era representado por um número muito menor de coeficientes DCT em comparação com uma versão de maior qualidade.
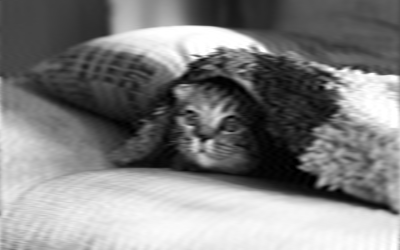
Um efeito muito legal que se pode obter é a transmissão gradual de imagens. É possível exibir uma imagem desfocada que se torna cada vez mais detalhada à medida que mais coeficientes são baixados.
Aqui, apenas por curiosidade, o que resulta na utilização de apenas 24.000 números:
Ou apenas 5.000:
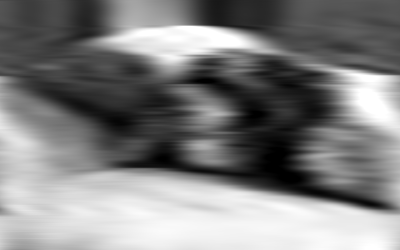
Muito borrado, mas de certa forma reconhecível!
3. Codificação de run-length, delta e Huffman
Até agora, todas as etapas de compressão foram com perda. A última etapa, por outro lado, é sem perda. Ela não remove informações, mas reduz significativamente o tamanho do arquivo.
Como é possível comprimir algo sem descartar informações? Imagine como descreveríamos um simples retângulo preto de 700 x 437.
O JPEG utiliza 5.000 números para isso, mas é possível alcançar um resultado muito melhor. Você consegue imaginar um esquema de codificação que descrevesse uma imagem assim com o menor número possível de bytes?
O esquema mínimo que consegui conceber usa quatro: três para indicar a cor e o quarto – quantos pixels têm essa cor. A ideia de representar valores repetidos dessa maneira compacta é chamada de codificação de run-length. Ela não tem perdas, já que podemos restaurar os dados codificados em sua forma original.
O tamanho do arquivo JPEG com um retângulo preto é muito maior que 4 bytes – lembre-se de que, no nível DCT, a compressão é aplicada a blocos de 8x8 pixels. Portanto, pelo menos precisamos de um coeficiente DCT para cada 64 pixels. Precisamos de um porque, ao invés de armazenar um coeficiente DCT seguido por 63 zeros, a codificação de comprimento de série nos permite armazenar um único número e indicar que 'todos os outros são zeros'.
A codificação delta é uma técnica na qual cada byte contém a diferença em relação a um determinado valor, e não o valor absoluto. Portanto, editar bytes específicos altera a cor de todos os outros pixels. Por exemplo, ao invés de armazenar
12 13 14 14 14 13 13 14
Poderíamos começar com 12 e depois simplesmente indicar quanto deve ser adicionado ou subtraído para obter o próximo número. E essa sequência na codificação delta assume a forma:
12 1 1 0 0 -1 0 1
Os dados transformados não se tornam menores do que os originais, mas já é mais fácil comprimí-los. A aplicação de codificação delta antes da codificação de comprimento de série pode ajudar bastante, mantendo-se como uma compressão sem perdas.
A codificação delta é uma das poucas técnicas aplicadas fora dos blocos de 8x8. Dos 64 coeficientes DCT, um é simplesmente uma função de onda constante (cor sólida). Ele representa a média de brilho de cada bloco para componentes de brilho, ou a média de azul para componentes Cb, e assim por diante. O primeiro valor de cada bloco DCT é chamado de valor DC, e cada valor DC passa pela codificação delta em relação aos anteriores. Portanto, mudar o brilho do primeiro bloco afetará todos os blocos.
Resta o último mistério: como a alteração de um único número pode estragar completamente toda a imagem? Até agora, essas propriedades não existiram nos níveis de compressão. A resposta está no cabeçalho JPEG. Os primeiros 500 bytes contêm metadados sobre a imagem – largura, altura, etc., e enquanto não trabalharmos com eles.
Sem o cabeçalho, é praticamente impossível (ou muito difícil) decodificar um JPEG. Isso pareceria como se eu estivesse tentando descrever uma pintura para você e começasse a inventar palavras para transmitir minha impressão. A descrição provavelmente seria bastante condensada, já que eu poderia inventar palavras exatamente com o significado que quero transmitir, no entanto, para todos os outros, elas não fariam sentido.
Pode parecer ridículo, mas é exatamente assim que acontece. Cada imagem JPEG é compactada com códigos específicos apenas para ela. O dicionário de códigos é armazenado no cabeçalho. Essa técnica é chamada de "código de Huffman", e o dicionário – de tabela de Huffman. No cabeçalho, a tabela é sinalizada por dois bytes – 255 e depois 196. Cada componente de cor pode ter sua própria tabela.
Mudanças nas tabelas afetarão radicalmente qualquer imagem. Um bom exemplo é trocar o 1 na linha 15 por 12.
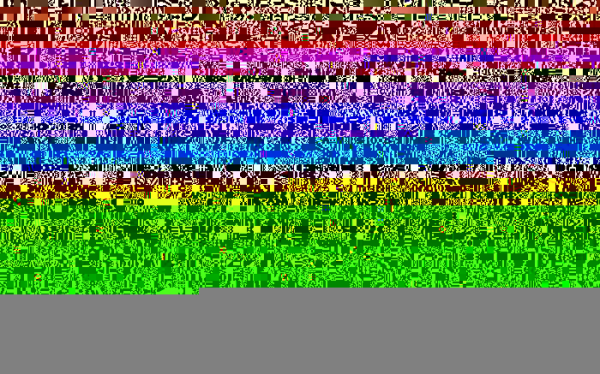
Isso ocorre porque as tabelas indicam como ler os bits individuais. Até agora, trabalhamos apenas com números binários na forma decimal. Mas isso oculta de nós o fato de que, se você quiser armazenar o número 1 em um byte, ele será representado como 00000001, uma vez que em cada byte deve haver exatamente oito bits, mesmo que apenas um deles seja necessário.
Potencialmente, isso é um grande desperdício de espaço, se você tiver muitos números pequenos. O código de Huffman é uma técnica que nos permite relaxar esse requisito de que cada número deve ocupar oito bits. Isso significa que, se você vê dois bytes:
234 115
Então, dependendo da tabela de Huffman, isso pode representar três números. Para extrair esses números, você deve primeiro dividi-los em bits individuais:
11101010 01110011
Em seguida, consultamos a tabela para entender como agrupá-los. Por exemplo, isso pode ser os primeiros seis bits, (111010), ou 58 no sistema decimal, seguidos por cinco bits (10011), ou 19, e finalmente os últimos quatro bits (0011), ou 3.
Portanto, é muito difícil desvendar os bytes neste estágio de compressão. Os bytes não representam o que parecem. Não vou entrar em detalhes sobre o funcionamento da tabela neste artigo, mas sobre este assunto na internet .
Um dos truques interessantes que você pode fazer, sabendo disso, é separar o cabeçalho do JPEG e armazená-lo separadamente. Na prática, isso fará com que apenas você possa ler o arquivo. O Facebook faz isso para reduzir ainda mais o tamanho dos arquivos.
Outra coisa que pode ser feita é mudar um pouco a tabela de Huffman. Para os outros, isso parecerá uma imagem corrompida. E somente você saberá a versão mágica para corrigi-la.
Em resumo: o que é necessário para decodificar um JPEG? É preciso:
- Extrair a(s) tabela(s) de Huffman do cabeçalho e decodificar os bits.
- Extrair os coeficientes da transformação discreta do cosseno para cada componente de cor e brilho para cada bloco de 8x8, realizando as transformações inversas da codificação de comprimento de série e deltas.
- Combinar os cossenos com base nos coeficientes para obter os valores dos pixels para cada bloco de 8x8.
- Escalar os componentes de cor, se a subamostragem foi realizada (essa informação está no cabeçalho).
- Converter os valores YCbCr obtidos para cada pixel em RGB.
- Exibir a imagem na tela!
Uma tarefa séria para simplesmente visualizar uma foto de um gato! No entanto, o que eu aprecio nisso é que mostra o quanto a tecnologia JPEG é centrada no ser humano. Baseia-se nas características da nossa percepção, permitindo alcançar uma compressão muito melhor do que as tecnologias convencionais. E agora, entendendo como o JPEG funciona, podemos imaginar como essas tecnologias podem ser aplicadas em outras áreas. Por exemplo, a codificação delta em vídeo pode resultar em uma redução significativa no tamanho do arquivo, pois frequentemente há áreas inteiras que não mudam de quadro para quadro (como o fundo).
, é aberto e contém instruções sobre como substituir imagens por suas próprias.
Fonte: habr.com
