

Introdução
Chegou a hora de comprar um armazenamento. Qual escolher, a quem ouvir? O fornecedor A fala sobre o fornecedor B, e ainda há o integrador C, que diz o oposto e recomenda o fornecedor D. Nessa situação, até um arquiteto experiente em sistemas de armazenamento pode ficar confuso, especialmente com todos os novos fornecedores e as modas de hoje, como SDS e hipercaracterísticas.
Então, como entender tudo isso e não sair perdendo? Nós ( Anton Zhbankov e Evgeny Elizarov) vamos tentar explicar isso em uma linguagem clara.
Este artigo se cruza em muitos aspectos e é, de fato, uma extensão do “” em termos de escolha de sistemas de armazenamento e revisão das tecnologias de armazenamento. Vamos abordar rapidamente a teoria geral, mas recomendamos a leitura do artigo mencionado.
Por que
É comum observar a situação em que uma nova pessoa chega a um fórum ou a um chat especializado, como o Storage Discussions, e faz a pergunta: “me oferecem duas opções de armazenamento — ABC SuperStorage S600 e XYZ HyperOcean 666v4, o que você recomenda?”
E começa a discussão sobre quais são as características de implementação dessas funções complicadas e confusas, que para uma pessoa não preparada são completamente incompreensíveis.
Assim, a primeira e principal pergunta que precisamos nos fazer muito antes de comparar as especificações nas propostas comerciais é — POR QUÊ? Por que precisamos desse armazenamento?
A resposta será surpreendente e muito no estilo de Tony Robbins — para armazenar dados. Obrigado, capitão! No entanto, às vezes nos aprofundamos tanto na comparação de detalhes que esquecemos por que estamos fazendo tudo isso.
Assim, a função do sistema de armazenamento de dados é armazenar e fornecer acesso aos DADOS com a performance estipulada. É com esses dados que vamos começar.
Dados
Tipo de dado
Quais dados planejamos armazenar? É uma questão muito importante que pode eliminar muitas soluções de armazenamento do exame. Por exemplo, a intenção é armazenar vídeos e fotos. Isso já pode descartar sistemas projetados para acesso aleatório de pequenos blocos ou sistemas com recursos exclusivos de compressão / deduplicação. Podem ser sistemas excelentes, não queremos dizer nada de ruim. Mas, neste caso, seus pontos fortes podem se tornar fracos (vídeos e fotos não são comprimidos) ou simplesmente aumentar significativamente o custo do sistema.
E, ao contrário, se o uso pretendido é um SGBD transacional pesado, então sistemas de streaming excelentes para multimídia, capazes de fornecer gigabytes por segundo, serão uma má escolha.
Volume de dados
Quantos dados planejamos armazenar? A quantidade sempre se transforma em qualidade, e isso nunca deve ser esquecido, especialmente em nosso tempo de crescimento exponencial do volume de dados. Sistemas de classe petabyte já não são raridade, mas quanto maior o volume de petabytes, mais específica se torna a configuração, e menos funcionalidades habituais de sistemas de acesso aleatório de pequeno e médio volume estarão disponíveis. Isso se deve simplesmente ao fato de que apenas as tabelas de estatísticas de acesso por blocos se tornam maiores do que a memória RAM disponível nos controladores. Sem mencionar a compressão / tireagem. Suponha que queremos mudar o algoritmo de compressão para um mais potente e comprimir 20 petabytes de dados. Quanto tempo isso levará: seis meses, um ano?
Por outro lado, por que complicar as coisas se precisamos armazenar e processar apenas 500 GB de dados? Apenas 500. SSDs domésticos (com baixo DWPD) desse volume custam muito pouco. Por que construir uma fábrica de Fiber Channel e comprar um sistema de armazenamento externo de alto nível que custaria uma fortuna?
Qual é a porcentagem do total de dados quentes? Quão desigual é a carga por volume de dados? É aqui que a tecnologia de armazenamento em múltiplos níveis ou Flash Cache pode ser muito útil se o volume de dados quentes for ínfimo em comparação com o total. Por outro lado, em cargas homogêneas em todo o volume, frequentemente observadas em sistemas de streaming (videovigilância, alguns sistemas de analytics), essas tecnologias não trarão vantagens e apenas aumentarão o custo / a complexidade do sistema.
SI
O lado inverso dos dados é o sistema de informação que utiliza esses dados. O SI possui um conjunto de requisitos que são herdados dos dados. Para mais detalhes sobre o SI, veja em “Desenho do Data Center Virtualizado”.
Requisitos de robustez / disponibilidade
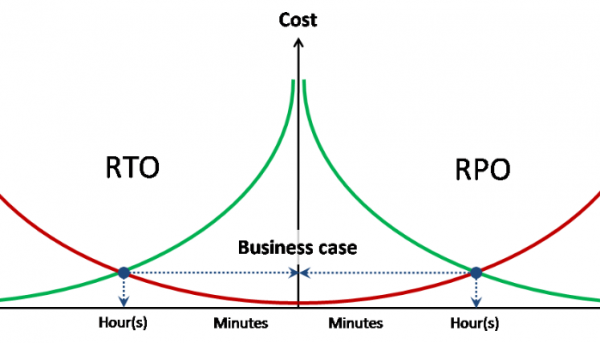
Os requisitos de robustez / disponibilidade dos dados são herdados do SI que os utiliza e são expressos em três números — RPO, RTO, disponibilidade.
Acessibilidade — a fração de tempo em que os dados estão disponíveis para uso. Normalmente é expressa em termos de número 9. Por exemplo, duas noves em um ano significa que a disponibilidade é de 99%, ou seja, permitem-se 95 horas de indisponibilidade por ano. Três noves — 9,5 horas por ano.
RPO / RTO — são indicadores não cumulativos, mas por incidente (falha), ao contrário da disponibilidade.
RPO — o volume de dados perdidos em caso de falha (em horas). Por exemplo, se o backup é realizado uma vez por dia, então o RPO = 24 horas. Ou seja, em caso de falha e perda total do sistema de armazenamento, dados de até 24 horas (a partir do último backup) podem ser perdidos. Com base no RPO definido para o SI, pode-se estabelecer o regulamento de backup. Além disso, com base no RPO, é possível entender a necessidade de replicação de dados síncrona / assíncrona.
RTO — o tempo de recuperação do serviço (acesso aos dados) após uma falha. Com base no valor de RTO definido, podemos entender se é necessário um metrocluster ou se uma replicação unidirecional é suficiente. Também é necessário determinar se um sistema de armazenamento de classe hi-end com múltiplos controladores é necessário.
Requisitos de desempenho
Apesar de ser uma questão bastante óbvia, é aqui que surgem a maioria das dificuldades. Dependendo de se você já possui alguma infraestrutura ou não, os caminhos para coleta das estatísticas necessárias serão construídos.
Você já possui um armazenamento em unidade (SXD) e está procurando uma substituição ou deseja adquirir mais uma para expansão. Aqui é tudo simples. Você entende quais serviços você já tem e quais planeja implementar em breve. Com base nos serviços atuais, você pode coletar estatísticas de desempenho. Avalie o número atual de IOPS e as latências atuais — quais são esses indicadores e são suficientes para suas necessidades? Isso pode ser feito tanto no próprio sistema de armazenamento quanto do lado dos hosts conectados a ele.
E é importante analisar não apenas a carga atual, mas durante um período (preferencialmente um mês). Verifique quais são os picos máximos durante o dia, que tipo de carga é gerada por backups etc. Se o seu SXD ou o software relacionado não fornece um conjunto completo dessas informações, você pode usar o RRDtool gratuito, que funciona com a maioria dos SXD e switches populares e conseguirá fornecer estatísticas detalhadas de desempenho. Também é importante monitorar a carga nos hosts que trabalham com esse SXD, em máquinas virtuais específicas ou o que exatamente está funcionando nesse host.
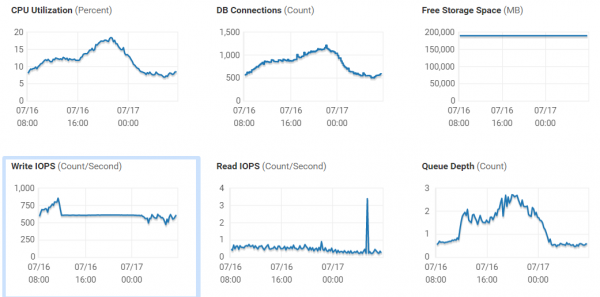
É importante ressaltar que, se as latências no volume e no datastore, que se encontra nesse volume, diferirem bastante, é necessário prestar atenção à sua rede SAN. Há uma alta probabilidade de que existam problemas com ela e, antes de adquirir um novo sistema, você deve resolver essa questão, pois há uma grande chance de que a performance do sistema atual melhore.
Você está construindo uma infraestrutura do zero ou adquirindo um sistema para um novo serviço, cuja carga você não tem conhecimento. Existem algumas opções: conversar com colegas em recursos especializados para tentar descobrir e prever a carga, contatar um integrador com experiência na implementação de serviços semelhantes que possa calcular a carga por você. E a terceira opção (geralmente a mais complexa, especialmente quando se trata de aplicações personalizadas ou raras) é tentar esclarecer os requisitos de desempenho com os desenvolvedores do sistema.
E, atenção, a opção mais correta do ponto de vista prático é um piloto no equipamento atual ou no equipamento fornecido para teste pelo vendedor / integrador.
Requisitos especiais
Requisitos especiais — tudo aquilo que não se enquadra nas exigências de desempenho, robustez e funcionalidade para o processamento e fornecimento imediato de dados.
Um dos requisitos especiais mais simples para um sistema de armazenamento de dados pode ser chamado de “suporte de mídia removível”. E logo fica claro que este sistema de armazenamento de dados deve incluir uma biblioteca de fitas ou simplesmente um gravador, onde uma cópia de segurança é armazenada. Após isso, uma pessoa especialmente treinada assina a fita e a leva orgulhosamente para um cofre especial.
Outro exemplo de requisito especial — construção protegida contra impactos.
Onde
O segundo componente principal na escolha de um determinado sistema de armazenamento é a informação sobre ONDE este sistema de armazenamento ficará. Começando pela geografia ou condições climáticas e terminando com a equipe.
Cliente
Para quem este sistema de armazenamento está sendo planejado? A questão tem os seguintes fundamentos:
Cliente público / comercial.
O cliente comercial não possui nenhuma restrição e não é obrigado a realizar licitações, exceto de acordo com seus próprios regulamentos internos.
O cliente público — é uma situação diferente. A Lei 44-FZ e outras complexidades relacionadas a licitações e especificações, que podem ser contestadas.
Cliente sob sanções
Aqui a questão é muito simples — a escolha é limitada apenas às ofertas disponíveis para este cliente.
Regulamentos internos / fornecedores autorizados para aquisição / modelos
A questão também é extremamente simples, mas deve ser lembrada.
Onde fisicamente
Nesta parte, abordamos todas as questões relacionadas à geografia, canais de comunicação e microclima no local de instalação.
Equipe
Quem irá trabalhar com este sistema de armazenamento? Isso é tão importante quanto o que o sistema de armazenamento realmente pode fazer.
Por mais promissora, incrível e maravilhosa que seja a solução de armazenamento do fornecedor A, não faz sentido implementá-la se a equipe só sabe trabalhar com o fornecedor B e não há planos para futuras aquisições ou cooperação constante com A.
E, claro, o lado oposto da questão é quão disponível é o pessoal qualificado nesta localização geográfica, tanto na empresa quanto potencialmente no mercado de trabalho. Para as regiões, pode ter um significado significativo a escolha de sistemas de armazenamento com interfaces simples ou a capacidade de gerenciamento centralizado remoto. Caso contrário, em algum momento, isso pode se tornar extremamente doloroso. A internet está cheia de histórias sobre como um novo funcionário, um ex-aluno, configurou algo que derrubou toda a empresa.
Ambiente
E, naturalmente, uma questão igualmente importante é em que ambiente esse sistema de armazenamento funcionará.
- Como está a alimentação/reesfriamento?
- Qual é a conexão
- Onde ele será instalado
- E assim por diante.
Frequentemente, essas questões são consideradas óbvias e não são analisadas em detalhes, mas às vezes elas podem inverter totalmente a situação.
O quê
Fornecedor
Atualmente (meados de 2019), o mercado russo de sistemas de armazenamento pode ser dividido em cinco categorias distintas:
- Primeira divisão — empresas respeitáveis com uma ampla gama que vai desde as prateleiras de disco mais simples até as de ponta (HPE, DellEMC, Hitachi, NetApp, IBM/Lenovo)
- Segunda divisão — empresas com uma linha limitada, jogadores de nicho, fornecedores sérios de SDS ou novos entrantes em ascensão (Fujitsu, Datacore, Infinidat, Huawei, Pure, etc.)
- Terceira divisão — soluções de nicho consideradas de baixo custo, SDS barato, produtos caseiros e soluções em ceph e outros projetos abertos (Infortrend, Starwind, etc.)
- Segmento SOHO — sistemas de armazenamento pequenos e muito pequenos ao nível de casa/escritório pequeno (Synology, QNAP, etc.)
- Sistemas de armazenamento de importação substituída — incluem hardware da primeira divisão com etiquetas trocadas, bem como representantes raros da segunda (RAIDIX, daremos a eles um avanço) que, na maioria, pertencem à terceira divisão (Aerodisk, Baum, Depo, etc.)
A divisão é bastante condicional e de forma alguma implica que a terceira ou o segmento SOHO seja ruim e que não podem ser utilizados. Em projetos específicos com um conjunto bem definido de dados e perfil de carga, eles podem funcionar muito bem, superando a primeira divisão em termos de relação custo/benefício. É importante primeiro definir as tarefas, perspectivas de crescimento, funcionalidade necessária — e então a Synology servirá a você com lealdade, e seus cabelos se tornarão macios e sedosos.
Um dos fatores importantes na escolha de um fornecedor é o ambiente atual. Quantas e quais matrizes de armazenamento você já possui, com quais matrizes os engenheiros estão familiarizados. Você precisa de mais um fornecedor, mais um ponto de contato, vai migrar gradualmente toda a carga do fornecedor A para o fornecedor B?
Não devemos criar entidades além do necessário.
iSCSI / FC / Arquivo
Não existe um consenso sobre os protocolos de acesso entre os engenheiros, e as disputas mais se assemelham a discussões teológicas do que a questões de engenharia. Mas, de forma geral, podemos destacar os seguintes pontos:
FCoE está mais morto do que vivo.
FC vs iSCSI. Uma das principais vantagens do FC em 2019 em relação às matrizes de armazenamento IP, a fábrica dedicada para acesso a dados, é neutralizada por uma rede IP dedicada. Não existem vantagens globais do FC sobre as redes IP, e as matrizes de armazenamento IP podem ser construídas para qualquer nível de carga, até mesmo para sistemas de bancos de dados pesados para grandes bancos. Por outro lado, a morte do FC vem sendo profetizada há vários anos, mas algo sempre impede isso. Hoje, por exemplo, alguns atores no mercado de armazenamento estão desenvolvendo ativamente o padrão NVMeoF. Se isso vai dividir o destino do FCoE — só o tempo dirá.
Acesso a arquivos também não é algo que deva ser ignorado. NFS / CIFS se mostram excelentes em ambientes produtivos e, com o projeto correto, têm tantas queixas quanto os protocolos de bloco.
Híbridos / All Flash Array
As matrizes de armazenamento clássicas são de 2 tipos:
- AFA (All Flash Array) — sistemas otimizados para uso de SSD.
- Híbridos — que permitem o uso tanto de HDD quanto de SSD ou uma combinação deles.
A principal diferença entre eles é as tecnologias suportadas para eficiência de armazenamento e o nível máximo de desempenho (altos índices de IOPS e baixa latência). Ambos os sistemas (na maioria de seus modelos, exceto o segmento low-end) podem funcionar como dispositivos de bloco ou de arquivo. O nível do sistema determina também o funcionalidade suportado, que nos modelos mais simples é geralmente reduzido ao nível mínimo. Isso deve ser levado em consideração ao estudar as características de um modelo específico, e não apenas as capacidades da linha como um todo. Além disso, é claro, o nível do sistema afeta suas especificações técnicas, como processador, volume de memória, cache, número e tipos de portas, etc. Em termos de gerenciamento de software, AFA e sistemas híbridos (baseados em disco) diferem apenas nas implementações dos mecanismos de interação com SSDs, e mesmo se você usar SSD em um sistema híbrido, isso não significa que você consiga obter um desempenho equivalente ao de um sistema AFA. Na maioria dos casos, os mecanismos inline de armazenamento eficaz em sistemas híbridos estão desativados, e ativá-los resulta em perda de desempenho.
Armazenamentos especiais
Além dos armazenamentos de propósito geral, voltados principalmente para o processamento operacional de dados, existem armazenamentos especiais com princípios fundamentais que diferem radicalmente dos habituais (baixa latência, muitas IOPS):
Mídia.
Esses sistemas são projetados para o armazenamento e processamento de arquivos de mídia, que se distinguem por seu grande tamanho. Assim, a latência se torna praticamente irrelevante, enquanto a capacidade de enviar e receber dados em uma ampla largura de banda em múltiplos fluxos paralelos se torna a prioridade.
Armazenamentos deduplicadores para backups.
Uma vez que os backups costumam ter uma semelhança rarefeita entre si (um backup médio difere do de ontem em 1-2%), esta classe de sistemas empacota os dados gravados de forma extremamente eficiente em um número bastante reduzido de suportes físicos. Por exemplo, em casos isolados, os coeficientes de compressão de dados podem atingir 200 para 1.
Armazenamentos baseados em objetos.
Nesses sistemas de armazenamento, não há volumes com acesso em bloco e compartilhamentos de arquivos, mas eles se assemelham mais a um grande banco de dados. O acesso ao objeto armazenado em um sistema desse tipo é feito por meio de um identificador único ou por metadados (por exemplo, todos os objetos no formato JPEG, com data de criação entre XX-XX-XXXX e YY-YY-YYYY).
Sistemas de conformidade.
Ainda não são tão comuns na Rússia hoje em dia, mas merecem menção. O propósito desses sistemas de armazenamento é garantir a preservação de dados para conformidade com políticas de segurança ou requisitos regulatórios. Em alguns sistemas (como o EMC Centera), foi implementada a função de proibição da exclusão de dados — assim que a chave é girada e o sistema entra neste modo, nem o administrador nem qualquer outra pessoa pode fisicamente excluir dados já gravados.
Tecnologias de marca
Cache de Flash
Cache de Flash é um nome genérico para todas as tecnologias proprietárias que utilizam memória flash como cache de segundo nível. Ao utilizar o cache de flash, o sistema de armazenamento geralmente é projetado para lidar com a carga estabelecida de discos magnéticos, enquanto a carga de pico é atendida pelo cache.
É necessário entender o perfil da carga e o grau de localização dos acessos aos blocos dos volumes de armazenamento. O Flash Cache é uma tecnologia para cargas com alta localização de solicitações e é praticamente inaplicável a volumes com carga uniforme (como em sistemas de análise).
No mercado, existem duas implementações de cache de flash disponíveis:
- Somente leitura. Nesse caso, apenas os dados de leitura são armazenados em cache, enquanto a gravação ocorre diretamente nos discos. Alguns fabricantes, como a NetApp, acreditam que a gravação em seus sistemas de armazenamento já ocorre de forma otimizada e que o cache não ajuda em nada.
- Leitura/Gravação. Tanto os dados de leitura quanto os de gravação são armazenados em cache, o que permite bufferizar o fluxo e reduzir o impacto da penalização RAID, resultando em um aumento geral no desempenho para sistemas de armazenamento com mecanismo de gravação não tão otimizado.
Tiers
O armazenamento em múltiplos níveis (tiering) é uma tecnologia que combina em um único pool de disco níveis de desempenho variados, como SSD e HDD. Em caso de uma disparidade acentuada nas solicitações para blocos de dados, o sistema pode automaticamente equilibrar os blocos de dados, movendo os sobrecarregados para um nível de alto desempenho e os menos utilizados, para um nível mais lento.
Os sistemas híbridos de baixo e médio custo usam armazenamento em múltiplos níveis com movimentação de dados entre níveis em agenda. Neste caso, o tamanho do bloco de armazenamento em múltiplos níveis nos melhores modelos é de 256 MB. Essas características não permitem considerar a tecnologia de armazenamento em múltiplos níveis como uma tecnologia de aumento de desempenho, como muitas vezes é erroneamente considerada. O armazenamento em múltiplos níveis em sistemas de baixo e médio custo é uma tecnologia de otimização de custo de armazenamento para sistemas com carga desigual.
Snapshot
Não importa o quanto falamos sobre a confiabilidade dos sistemas de armazenamento, existem muitas maneiras de perder dados que não estão relacionadas a problemas de hardware. Isso pode incluir vírus, hackers ou qualquer outra exclusão/container de dados não intencional. Por essa razão, o backup de dados produtivos é uma parte essencial do trabalho de um engenheiro.
Um snapshot é uma captura de um volume em um determinado momento. Ao trabalhar com a maioria dos sistemas, como virtualização, bancos de dados etc., precisamos tirar essa captura, da qual copiaremos dados para o backup, enquanto nossos sistemas de informação podem continuar trabalhando normalmente com esse volume. Mas é importante lembrar — nem todos os snapshots são igualmente úteis. Diferentes fornecedores têm abordagens diferentes para a criação de snapshots, dependendo de sua arquitetura.
CoW (Copy-On-Write). Ao tentar gravar um bloco de dados, seu conteúdo original é copiado para uma área especial, após o que a gravação ocorre normalmente. Isso evita a corrupção de dados dentro do snapshot. Naturalmente, todas essas manipulações 'parasitárias' com os dados geram uma carga adicional no sistema de armazenamento e, por essa razão, os fornecedores com essa implementação não recomendam o uso de mais de dez snapshots, e em volumes de alta carga, não usá-los de jeito nenhum.
RoW (Redirect-on-Write). Nesse caso, o volume original é naturalmente congelado, e ao tentar gravar um bloco de dados, o sistema de armazenamento escreve os dados em uma área especial no espaço livre, alterando a localização desse bloco na tabela de metadados. Isso reduz o número de operações de regravação, o que, em última análise, mitiga a queda de desempenho e remove as limitações sobre os snapshots e sua quantidade.
Os snapshots também podem ser de dois tipos em relação às aplicações:
Application consistent. No momento da criação do snapshot, o sistema de armazenamento aciona um agente no sistema operacional do cliente, que força a limpeza dos caches em disco da memória para o disco e faz com que isso aconteça no aplicativo. Nesse caso, ao restaurar a partir do snapshot, os dados serão consistentes.
Crash consistentNeste caso, nada semelhante acontece e o snapshot é criado como está. Ao restaurar a partir de um snapshot assim, a situação é idêntica àquela em que a energia é subitamente cortada e pode haver alguma perda de dados que ficaram no cache e não chegaram ao disco. Esses snapshots são mais simples de implementar e não causam degradação de desempenho nas aplicações, mas são menos confiáveis.
Por que os snapshots são necessários em sistemas de armazenamento de dados?
- Backup sem agente diretamente do SAN
- Criação de ambientes de teste baseados em dados reais
- No caso de SANs de arquivos, pode ser usada para criar ambientes VDI através do uso de snapshots do SAN em vez do hipervisor
- Garantir RPO baixos criando snapshots programados com frequência significativamente superior à frequência de backup
Clonagem
A clonagem de volumes funciona de maneira semelhante aos snapshots, mas serve não apenas para leitura de dados, mas para trabalhar plenamente com eles. Temos a possibilidade de obter uma cópia exata do nosso volume, com todos os dados nele, sem fazer uma cópia física, o que economiza espaço. Normalmente, a clonagem de volumes é utilizada em Test&Dev ou se você deseja testar a viabilidade de certas atualizações em seu sistema de informação. A clonagem permitirá que isso seja feito da forma mais rápida e econômica em termos de recursos de disco, pois apenas os blocos de dados modificados serão gravados.
Replicação / Journalização
Replicação é o mecanismo de criação de uma cópia de dados em outro SAN físico. Normalmente, existe uma tecnologia proprietária para cada fornecedor, operando apenas dentro de sua própria linha de produtos. Mas também há soluções de terceiros, inclusive operando no nível do hipervisor, como o VMware vSphere Replication.
A funcionalidade das tecnologias proprietárias e a conveniência de seu uso geralmente superam as universais, mas são inaplicáveis quando, por exemplo, é necessário fazer uma réplica de um NetApp para um HP MSA.
A replicação é dividida em dois subtipos:
Síncrona. No caso da replicação síncrona, a operação de gravação é imediatamente enviada para a segunda unidade de armazenamento e não é confirmada até que a unidade remota confirme. Isso aumenta a latência de acesso, mas nos dá uma cópia espelhada exata dos dados. Ou seja, RPO = 0 em caso de perda da unidade principal.
Síncrona. As operações de gravação são executadas somente na unidade principal e são confirmadas imediatamente, enquanto são armazenadas em buffer para transmissão em lote para a unidade remota. Esse tipo de replicação é relevante para dados menos valiosos, ou para canais de baixa largura de banda, ou aqueles com alta latência (característico para distâncias acima de 100 km). Portanto, RPO = frequência de envio em lote.
Frequentemente, junto com a replicação, existe um mecanismo de registro das operações de disco. Nesse caso, uma área especial é designada para registro e as operações de gravação são mantidas por um determinado período de tempo, ou limitadas ao volume do log. Para tecnologias proprietárias específicas, como o EMC RecoverPoint, existe uma integração com o software do sistema, permitindo vincular marcadores específicos a uma gravação específica no log. Isso possibilita reverter o estado do volume (ou criar um clone) não apenas para 23 de abril às 11 horas 59 minutos e 13 milissegundos, mas para um momento que precedeu o “DROP ALL TABLES; COMMIT”.
Metro cluster
Metro cluster — uma tecnologia que permite criar replicação síncrona bidirecional entre duas unidades de armazenamento de tal forma que essa dupla aparece como uma única unidade. É usada para criar clusters com braços geograficamente dispersos em distâncias metropolitanas (menos de 100 km).
Usando como exemplo o ambiente de virtualização, o metro cluster permite criar um datastore com máquinas virtuais, acessível para gravação de ambos os data centers. Nesse caso, um cluster é criado no nível dos hiperdispositivos, consistindo em hosts em diferentes data centers físicos, conectado a esse datastore. Isso permite as seguintes ações:
- Automação completa do processo de recuperação após a falência de um dos data centers. Sem qualquer ferramenta adicional, todas as VMs que estavam operando no data center falido serão automaticamente reiniciadas no restante. RTO = tempo limite do cluster de alta disponibilidade (15 segundos para VMware) + tempo de inicialização do sistema operacional e início dos serviços.
- Evitação de desastres ou, em outras palavras, prevenção de catástrofes. Se forem realizados trabalhos na alimentação elétrica do data center 1, teremos a oportunidade de migrar toda a carga crítica para o data center 2 ininterruptamente antes do início dos trabalhos.
Virtualização
Virtualização de armazenamento é, tecnicamente, o uso de volumes de outro armazenamento como discos. O virtualizador de armazenamento pode simplesmente apresentar um volume externo ao consumidor como se fosse seu, enquanto o espelha em um outro armazenamento, ou até criar um RAID a partir de volumes externos.
Os representantes clássicos na classe de virtualização de armazenamento são EMC VPLEX e IBM SVC. E, é claro, storages com função de virtualização – NetApp, Hitachi, IBM / Lenovo Storwize.
Para que isso pode ser necessário?
- Mirroring em nível de armazenamento. Um espelho é criado entre os volumes, sendo que uma metade pode estar em HP 3Par e a outra em NetApp. E o virtualizador da EMC.
- Migração de dados com mínimo de inatividade entre storages de diferentes fabricantes. Suponha que os dados precisam ser migrados de um antigo 3Par, que será descartado, para um novo Dell. Nesse caso, os consumidores são desconectados do 3Par, os volumes são conectados ao VPLEX e apresentados novamente aos consumidores. Como nada foi alterado no volume, o trabalho continua. Ao fundo, o processo de espelhamento do volume para o novo Dell é iniciado, e ao final, o espelho é encerrado e o 3Par desligado.
- Organização de metroclusters.
Compressão / deduplicação
Compressão e deduplicação são aquelas tecnologias que permitem economizar espaço em disco no seu armazenamento. É importante mencionar que nem todos os dados podem ser comprimidos e/ou deduplicados, enquanto alguns tipos de dados são melhor comprimidos e deduplicados, enquanto outros não.
Compressão e deduplicação têm 2 tipos:
Inline A compressão e deduplicação dos blocos de dados ocorrem antes da gravação desses dados no disco. Assim, o sistema apenas calcula o hash do bloco e o compara em uma tabela com os já existentes. Em primeiro lugar, isso é executado mais rapidamente do que uma simples gravação no disco; em segundo lugar, não desperdiçamos espaço em disco desnecessário.
Post Quando essas operações são realizadas em dados já gravados que estão nos discos. Portanto, os dados são inicialmente gravados no disco, e somente depois é que o hash é calculado e acontece a remoção de blocos desnecessários, liberando recursos de disco.
Vale ressaltar que a maioria dos fornecedores utiliza ambos os tipos, o que permite otimizar esses processos e, consequentemente, aumentar sua eficiência. A maioria dos fornecedores de armazenamento possui utilitários que permitem analisar seus conjuntos de dados. Esses utilitários funcionam com a mesma lógica que está implementada no armazenamento, portanto, o nível estimado de eficiência será compatível. Além disso, muitos fornecedores têm programas de garantia de eficiência que prometem um nível não inferior ao declarado para determinados (ou todos) tipos de dados. Não devemos negligenciar esse programa, pois ao projetar o sistema para suas necessidades, levando em conta o coeficiente de eficiência do sistema específico, você pode economizar em volume. Também é importante considerar que esses programas são projetados para sistemas AFA, mas, devido à compra de um menor volume de SSD em comparação com HDD em sistemas clássicos, isso permitirá reduzir seus custos, e se não igualar ao custo do sistema de disco, se aproximará bastante dele.
Modelo
E aqui chegamos à pergunta que foi feita corretamente.
"Me oferecem duas opções de armazenamento — ABC SuperStorage S600 e XYZ HyperOcean 666v4, o que você aconselha?"
Transforma-se em "Me oferecem duas opções de armazenamento — ABC SuperStorage S600 e XYZ HyperOcean 666v4, o que você aconselha?"
Carga de trabalho alvo: máquinas virtuais VMware mistas com contornos de produção/teste/desenvolvimento. Teste = produção. 150 TB para cada com pico de desempenho de 80.000 IOPS em blocos de 8kb com 50% de acesso aleatório, 80/20 leitura/gravação. 300 TB para desenvolvimento, onde 50.000 IOPS são suficientes, 80% aleatório, 80% gravação.
Produção, presumivelmente em metrocluster, RPO = 15 minutos, RTO = 1 hora, desenvolvimento em replicação assíncrona, RPO = 3 horas, teste em um único local.
Terá 50TB de SGBD, seria bom para eles ter registro.
Temos servidores Dell por toda parte, com arrays de armazenamento Hitachi antigos, que mal estão aguentando. Planejamos um aumento de 50% na carga em volume e desempenho.
Como se costuma dizer, em uma pergunta bem formulada está 80% da resposta.
Informações adicionais
O que mais vale a pena revisar, na opinião dos autores.
Livros
- Oliifer e Oliifer 'Redes de Computadores'. Este livro ajudará a sistematizar e possivelmente entender melhor como funciona o ambiente de transmissão de dados para sistemas de armazenamento IP / Ethernet.
- 'EMC Information Storage and Management'. Um excelente livro sobre os fundamentos de armazenamento, explicando o porquê, o como e o para quê.
Fóruns e Chats
Recomendações gerais
Preços
Agora, quanto aos preços — geralmente, os preços de arrays de armazenamento geralmente aparecem como List price, do qual cada cliente recebe um desconto individual. O tamanho do desconto depende de muitos parâmetros, então prever qual preço final sua empresa receberá sem um pedido ao distribuidor é simplesmente impossível. Porém, ultimamente, modelos de entrada têm aparecido em lojas de informática comuns, como por exemplo, ou . Nelas, você pode adquirir imediatamente o sistema que deseja por um preço fixo, como qualquer componente de computador.
Mas é importante notar logo que a comparação direta em TB/$ não é correta. Se encararmos sob essa perspectiva, a solução mais barata seria um simples JBOD + servidor, o que não oferece a flexibilidade ou a confiabilidade de um array de armazenamento completo e de dois controladores. Isso não significa que o JBOD é uma solução ruim, mas é preciso entender claramente como e para quais finalidades você usará essa solução. Muitas vezes se ouve que o JBOD não tem partes móveis, pois possui apenas um backplane. No entanto, os backplanes também podem falhar. Tudo quebra cedo ou tarde.
Total
É necessário comparar os sistemas não apenas pelo preço, ou não apenas pelo desempenho, mas pela soma de todos os indicadores.
Compre HDD apenas se tiver certeza de que precisa deles. Para cargas leves e tipos de dados não comprimíveis, é melhor considerar programas de garantia de eficiência de armazenamento em SSD, que agora a maioria dos fornecedores oferece (e eles realmente funcionam, mesmo na Rússia), mas isso depende das aplicações e dos dados que estarão armazenados nesse sistema de armazenamento.
Não se deixe levar pela busca pela barateza. Às vezes, isso esconde muitos problemas desagradáveis, um dos quais Evgeny Elizarov descreveu em seus artigos sobre . E que, no final, essa barateza pode acabar custando caro. Não se esqueça — "quem é pão duro paga duas vezes".
Fonte: habr.com
