

Olá, pessoal do Habr. Hoje começam as aulas do primeiro grupo do curso . Com isso, queremos contar a vocês como foi o webinar aberto sobre este curso.
Em falamos sobre os desafios enfrentados pelos bancos de dados SQL na era das nuvens e Kubernetes. Além disso, discutimos como os bancos de dados SQL se adaptam e mutam sob a influência desses desafios.
O webinar foi conduzido , Gerente de Entrega da Prática do Google Cloud na EPAM Systems.
Quando as árvores eram pequenas...
Para começar, vamos lembrar como ocorreu a escolha dos SGBDs no final do século passado. Contudo, não será difícil, pois a escolha dos SGBDs naquela época começava e terminava Oracle.
No final dos anos 90 e início dos anos 2000, não havia muitas opções, se falarmos sobre bancos de dados escaláveis industriais. Sim, existiam IBM DB2, Sybase e alguns outros bancos de dados que apareciam e desapareciam, mas no geral, eles não eram tão visíveis em comparação com a Oracle. Consequentemente, as habilidades dos engenheiros da época estavam, de uma maneira ou de outra, ligadas àquela única escolha que existia.
Um DBA Oracle deveria saber:
- instalar o Oracle Server a partir do distribuidor;
- configurar o Oracle Server:
- init.ora;
- listener.ora;
— criar:
- tablespaces;
- esquemas;
- usuários;
— realizar backup e recuperação;
— monitorar;
— combater consultas não otimizadas.
Ao mesmo tempo, não era exigido do DBA Oracle:
- saber escolher o SGBD ou outra tecnologia de armazenamento e processamento de dados;
- garantir alta disponibilidade e escalabilidade horizontal (isso nem sempre era uma preocupação do DBA);
- ter bom conhecimento da área de aplicação, infraestrutura, arquitetura de aplicativo e sistemas operacionais;
- realizar cargas e descargas de dados, migração de dados entre diferentes SGBDs.
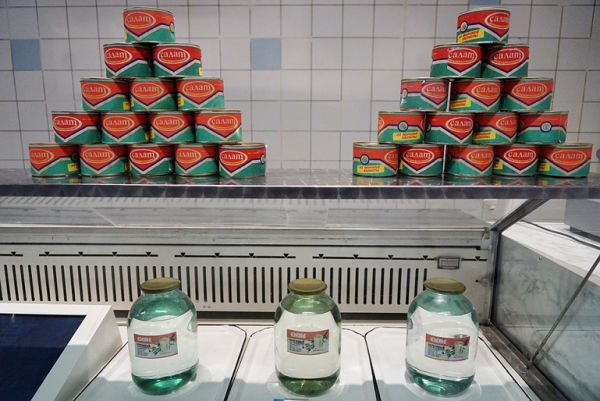
Em geral, se falarmos sobre as escolhas da época, elas lembram a escolha em uma loja soviética no final dos anos 80:
Nosso tempo
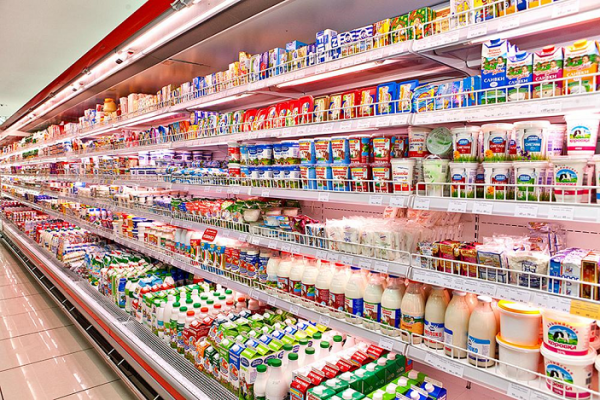
Desde então, claro, as árvores cresceram, o mundo mudou, e ficou assim:
O mercado dos SGBDs também mudou, o que é claramente demonstrado pelo recente relatório da empresa Gartner:
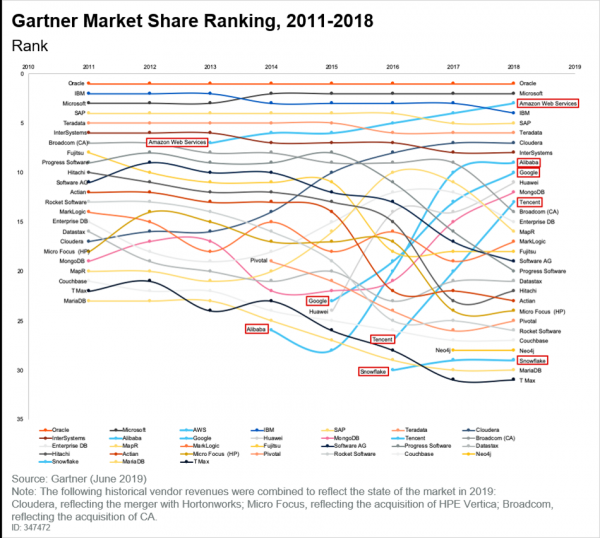
E aqui não podemos deixar de notar que as nuvens encontraram seu espaço, cuja popularidade está crescendo. Se lermos o mesmo relatório da Gartner, veremos as seguintes conclusões:
- Muitos clientes estão no caminho de migrar aplicativos para a nuvem.
- Novas tecnologias aparecem primeiro na nuvem e não há garantia de que algum dia elas se mudarão para uma infraestrutura não baseada em nuvem.
- O modelo de precificação baseado no princípio pay-as-you-go se tornou comum. Todos desejam pagar apenas pelo que utilizam, e isso já não é mais uma tendência, mas uma constatação.
E agora?
Hoje todos nós estamos na nuvem. E as questões que surgem são questões de escolha. E essa escolha é vasta, mesmo se falarmos apenas sobre a seleção de tecnologias de SGBD em formato On-premises. Além disso, temos serviços gerenciados e SaaS. Assim, a escolha só se torna mais complexa a cada ano.
Junto com as questões de escolha, existem também fatores limitantes:
- o preço. Muitas tecnologias ainda custam dinheiro;
- habilidades. Se falarmos sobre software livre, surge a questão das habilidades, pois o software gratuito exige de quem o implanta e opera uma competência suficiente;
- funcionalidade. Nem todos os serviços disponíveis na nuvem e construídos, digamos, até mesmo sobre a mesma base do Postgres, possuem as mesmas funcionalidades que o Postgres On-premises. Este é um fator significativo que deve ser conhecido e compreendido. Além disso, esse fator adquire importância ainda maior do que o conhecimento de quaisquer recursos ocultos de um SGBD específico.
O que se espera atualmente de DA/DE:
- um bom entendimento da área de conhecimento e da arquitetura aplicada;
- a habilidade de escolher corretamente a tecnologia de SGBD considerando a tarefa proposta;
- a habilidade de selecionar o método ideal para implementar a tecnologia escolhida no contexto das restrições existentes;
- a habilidade de realizar a transferência e migração de dados;
- capacidade de implementar e operar as soluções escolhidas.
O exemplo a seguir baseado no GCP demonstra como a escolha de uma tecnologia de trabalho com dados é determinada pela sua estrutura:
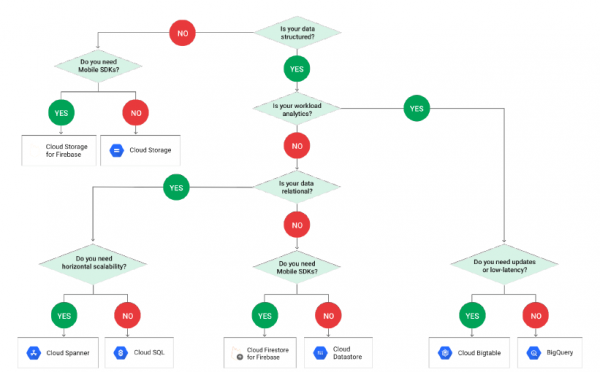
Observe que o PostgreSQL está ausente no esquema, e isso ocorre porque ele está escondido sob a terminologia Cloud SQL. E quando estamos na Cloud SQL, precisamos novamente fazer uma escolha:
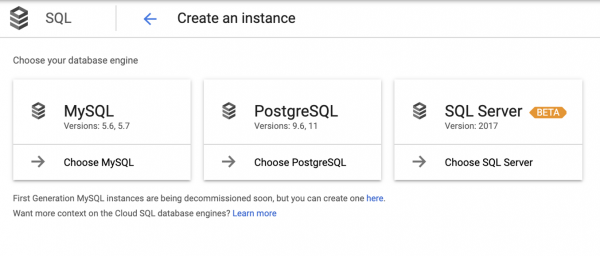
Vale ressaltar que essa escolha nem sempre é clara, portanto, os desenvolvedores de aplicativos muitas vezes se guiam pela intuição.
No total:
- Quanto mais se avança, mais relevante se torna a questão da escolha. E mesmo ao olhar apenas para o GCP, serviços gerenciados e SaaS, alguma menção ao SGBD aparece apenas no 4º passo (e lá está o Spanner ao lado). Além disso, a escolha do PostgreSQL só aparece no 5º passo, com MySQL e SQL Server ao lado, ou seja, há muitas opções, e é preciso escolher.
- Não podemos esquecer das limitações diante das tentações. No geral, todos querem o Spanner, mas ele é caro. No final, a solicitação típica se parece mais ou menos com isso: «Por favor, façam para nós um Spanner, mas pelo preço do Cloud SQL, vocês são profissionais!»
E agora, o que fazer?
Sem pretender ter a verdade absoluta, podemos dizer o seguinte:
É preciso mudar a abordagem de ensino:
- ensinar como se fazia antes com DBA não faz sentido;
- o conhecimento sobre um único produto já não é suficiente;
- e conhecer dezenas de produtos no mesmo nível é impossível.
É necessário saber não apenas o produto, mas:
- o caso de uso de sua aplicação;
- os diferentes métodos de implementação;
- as vantagens e desvantagens de cada método;
- produtos semelhantes e alternativos, para tomar decisões conscientes e otimais, e nem sempre a favor do produto que já se conhece.
E também é preciso saber migrar dados e entender os princípios básicos de integração com ETL.
Um caso real
Recentemente, tive que desenvolver o backend para um aplicativo móvel. No momento em que comecei a trabalhar nele, o backend já tinha sido desenvolvido e estava pronto para ser implementado, e a equipe de desenvolvedores havia trabalhado neste projeto por cerca de dois anos. As seguintes tarefas foram definidas:
- construir CI/CD;
- fazer a revisão da arquitetura;
- colocar tudo isso em operação.
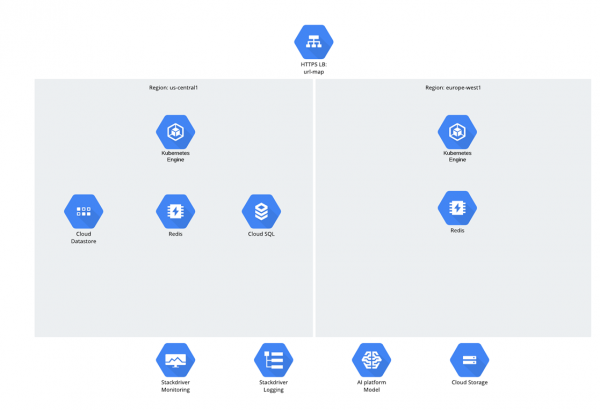
O próprio aplicativo era microserviços, e o código em Python/Django foi desenvolvido do zero e diretamente no GCP. Quanto ao público-alvo, considerou-se que haveria duas regiões — US e EU, e o tráfego foi distribuído através do Load Balancer Global. Todas as cargas de trabalho e a carga computacional funcionaram no Google Kubernetes Engine.
Quanto aos dados, havia 3 estruturas:
- Cloud Storage;
- Datastore;
- Cloud SQL (PostgreSQL).
Pode surgir a pergunta por que o Cloud SQL foi escolhido? Para ser sincero, tal pergunta nos últimos anos gera uma certa pausa constrangedora — parece que as pessoas começaram a se envergonhar de bancos de dados relacionais, mas, no entanto, continuam a usá-los ativamente ;-).
Quanto ao nosso caso, o Cloud SQL foi escolhido pelas seguintes razões:
- Como mencionado, o aplicativo foi desenvolvido com Django, e nele há um modelo para exibir dados persistentes do banco de dados SQL em objetos Python (Django ORM).
- O próprio framework suportava uma lista consideravelmente limitada de SGBDs:
- PostgreSQL;
- MariaDB;
- MySQL;
- Oracle;
- SQLite.
Portanto, o PostgreSQL foi escolhido dessa lista de forma mais intuitiva (realmente, não vamos escolher o Oracle).
O que estava faltando:
- o aplicativo foi implantado apenas em 2 regiões, e agora havia planos para uma 3ª (Ásia);
- O banco de dados estava na região da América do Norte (Iowa);
- havia preocupações do cliente sobre possíveis atrasos de acesso da Europa e da Ásia e interrupções no serviço em caso de inatividade do SGBD.
Embora o próprio Django possa trabalhar com vários bancos de dados simultaneamente e dividi-los entre leitura e escrita, as gravações no aplicativo não eram muitas (mais de 90% — leitura). No geral, se fosse possível fazer uma replica de leitura do banco principal na Europa e na Ásia, isso seria uma opção de comprometimento. Mas o que há de tão difícil nisso?
A dificuldade estava no fato de que o cliente não queria abrir mão do uso de serviços gerenciados e Cloud SQL. E as capacidades do Cloud SQL, neste momento, são limitadas. O Cloud SQL suporta alta disponibilidade (HA) e réplica de leitura (RR), mas a mesma RR é suportada apenas em uma região. Ao criar um banco de dados na região americana, não é possível fazer uma réplica de leitura na região europeia utilizando os recursos do Cloud SQL, embora o próprio PostgreSQL não impeça isso. A correspondência com os funcionários do Google não levou a nada e terminou com promessas no estilo "sabemos do problema e estamos trabalhando nele, em algum momento a questão será resolvida."
Se enumerarmos as capacidades do Cloud SQL em formato de tópicos, ficaria aproximadamente assim:
1. Alta disponibilidade (HA):
- dentro de uma única região;
- por meio de replicação de disco;
- não são utilizados mecanismos do PostgreSQL;
- pode haver gerenciamento automático e manual — failover/failback;
- durante a troca, o SGBD não está disponível por alguns minutos.
2. Réplica de leitura (RR):
- dentro de uma única região;
- standby quente;
- replicação em streaming do PostgreSQL.
Além disso, como é comum, ao escolher a tecnologia você sempre se depara com alguma limitação;:
- o cliente não queria criar entidades e usar IaaS, exceto através do GKE;
- o cliente não gostaria de implantar PostgreSQL/MySQL self service;
- Aliás, o Google Spanner seria uma boa opção, se não fosse pelo seu preço. No entanto, ele não é compatível com o Django ORM, mas é uma boa solução.
Diante da situação, o cliente lançou uma pergunta desafiadora: «Vocês podem fazer algo semelhante ao Google Spanner, mas que funcione também com o Django ORM?»
Opção de solução nº 0
A primeira ideia que veio à mente foi:
- permanecer dentro do CloudSQL;
- não haverá replicação integrada entre regiões de forma alguma;
- tentar conectar uma réplica ao Cloud SQL existente by PostgreSQL;
- iniciar uma instância PostgreSQL de alguma forma, mas não tocar no master.
Infelizmente, descobriu-se que isso não era possível, pois não há acesso ao host (que está em outro projeto) — pg_hba e assim por diante, e também não há acesso como superusuário.
Opção de solução nº 1
Após mais reflexões e considerando as circunstâncias anteriores, a linha de pensamento mudou um pouco:
- continuamos tentando permanecer dentro do CloudSQL, mas mudamos para MySQL, pois o Cloud SQL by MySQL possui um master externo que:
— é um proxy para o MySQL externo;
— se parece com uma instância MySQL;
— foi criado para migração de dados de outras nuvens ou localmente.
Visto que a configuração de replicação MySQL não requer acesso ao host, tudo funcionou, mas de maneira muito instável e desconfortável. E quando avançamos, ficou ainda mais assustador, pois estávamos implantando toda a estrutura com terraform e, de repente, descobrimos que o master externo não era suportado pelo terraform. Sim, o Google tem uma CLI, mas inexplicavelmente, aqui também, tudo funcionava de vez em quando — às vezes criava, às vezes não. Possivelmente, porque a CLI foi desenvolvida para migração de dados de fora, e não para réplicas.
De fato, ficou claro que o Cloud SQL não era adequado de maneira alguma. Como dizem, fizemos tudo o que pudemos.
Opção de solução nº 2
Como não foi possível permanecer no Cloud SQL, tentamos formular as exigências para uma solução de compromisso. As exigências foram as seguintes:
- funcionamento em Kubernetes, maximum utilização de recursos e capacidades do Kubernetes (DCS, …) e GCP (LB, …);
- ausência de excessos de uma pilha de coisas desnecessárias na nuvem, como HA proxy;
- capacidade de executar HA PostgreSQL ou MySQL na região principal; nas outras regiões — HA do RR da região principal mais sua cópia (para maior confiabilidade);
- multi master (não era desejável se conectar a ela, mas isso não era muito crítico)
.
Como resultado dessas exigências, finalmente, uma solução começou a surgir no horizonte.opções adequadas de SGBD e bibliotecas:
- MySQL Galera;
- CockroachDB;
- ferramentas PostgreSQL
:
— pgpool-II;
— Patroni.
MySQL Galera
A tecnologia MySQL Galera foi desenvolvida pela Codership e é um plugin para InnoDB. Características:
- multi mestre;
- replicação síncrona;
- leitura de qualquer nó;
- gravação em qualquer nó;
- mecanismo HA embutido;
- existe um Helm chart da Bitnami.
CockroachDB
Pela descrição, é um projeto incrível e representa um projeto open source escrito em Go. O principal participante é a Cockroach Labs (fundada por ex-membros do Google). Este SGBD relacional foi criado para ser distribuído (com escalabilidade horizontal "out of the box") e tolerante a falhas. Seus autores declararam o objetivo de "combinar a riqueza de funcionalidade do SQL com a disponibilidade horizontal, comum em soluções NoSQL."
Como bônus agradável — suporte ao protocolo de conexão PostgreSQL.
Pgpool
É uma camada sobre o PostgreSQL, na verdade, uma nova entidade que assume todas as conexões e as processa. Tem seu próprio balanceador de carga e parser, e é licenciada sob a licença BSD. Oferece amplas possibilidades, mas parece um pouco assustadora, pois a presença de uma nova entidade poderia ser a fonte de algumas aventuras adicionais.
Patroni
Esta foi a última opção considerada, e, como se viu, não foi em vão. Patroni é uma ferramenta open source que, na prática, é um daemon em Python, permitindo gerenciar automaticamente clusters PostgreSQL com diferentes tipos de replicação e com troca automática de papéis. A solução foi bastante interessante, pois se integra bem com Kubernetes e não traz novas entidades.
O que foi escolhido no final
A escolha não foi fácil:
- CockroachDB — excelente, mas arriscado;
- MySQL Galera — também não é ruim, bastante utilizado, mas MySQL;
- Pgpool — muitas entidades desnecessárias, integração fraca com a nuvem e K8s;
- Patroni — ótima integração com K8s, sem entidades desnecessárias, bem integrada com GCP LB.
Dessa forma, a escolha recaiu sobre o Patroni.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
Chegou a hora de fazer um breve resumo. Sim, o mundo da infraestrutura de TI mudou significativamente, e isso é apenas o começo. Se antes as nuvens eram apenas um tipo diferente de infraestrutura, agora tudo é diferente. Além disso, inovações nas nuvens estão surgindo constantemente, continuarão a aparecer e, possivelmente, só aparecerão nas nuvens e, mais tarde, através de startups, serão transferidas para on-premises.
No que diz respeito ao SQL, o SQL continuará a existir. Isso significa que é necessário conhecer PostgreSQL e MySQL e saber como trabalhar com eles, mas é ainda mais importante saber aplicá-los corretamente.
Fonte: habr.com
