

Dizem que na vida tudo vale a pena ser experimentado pelo menos uma vez. E se você está acostumado a trabalhar com bancos de dados relacionais, conhecer na prática o NoSQL vale a pena, principalmente para o desenvolvimento pessoal. Atualmente, devido ao rápido desenvolvimento dessa tecnologia, há muitas opiniões contraditórias e acalorados debates sobre o tema, o que alimenta ainda mais o interesse.
Se mergulharmos na essência de todas essas disputas, podemos perceber que elas surgem devido a uma abordagem equivocada. Aqueles que utilizam bancos de dados NoSQL onde realmente são necessários estão satisfeitos e colhem todos os benefícios dessa solução. Já os experimentadores, que depositam esperanças nessa tecnologia como uma panaceia em situações onde ela não se aplica, acabam se decepcionando, perdendo os pontos fortes dos bancos relacionais sem adquirir benefícios significativos.
Vou compartilhar nossa experiência com a implementação de uma solução baseada no banco de dados Cassandra: quais desafios enfrentamos, como saímos de situações difíceis, se conseguimos obter ganhos com o uso de NoSQL e onde tivemos que investir esforços / recursos adicionais.
A tarefa inicial era construir um sistema que registrasse chamadas em um determinado armazenamento.
O princípio de funcionamento do sistema é o seguinte. Arquivos com uma estrutura definida, descrevendo os detalhes da chamada, são recebidos na entrada. O aplicativo, então, assegura a manutenção dessa estrutura nas colunas correspondentes. Posteriormente, as chamadas armazenadas são utilizadas para exibir informações sobre o consumo de tráfego dos assinantes (faturamento, chamadas, histórico de saldo).
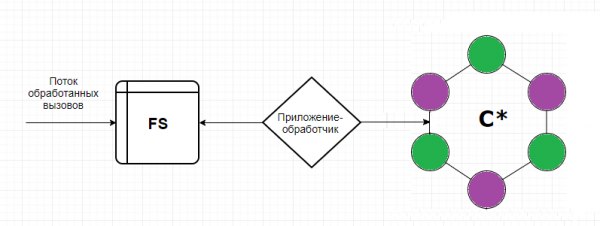
A escolha pela Cassandra é bastante clara — ela grava como uma metralhadora, é facilmente escalável e à prova de falhas.
Então, aqui está o que aprendemos com essa experiência.
Sim, um nó fora do ar não é uma tragédia. Essa é a essência da resiliência da Cassandra. Mas um nó pode estar ativo e ainda assim começar a apresentar uma queda de desempenho.. Como se viu, isso se reflete imediatamente no desempenho de todo o cluster.
A Cassandra não irá oferecer garantias onde o Oracle salvava com suas restrições.. E se o autor do aplicativo não percebeu isso com antecedência, um duplicado que chega para a Cassandra não é pior que o original. Se chegou, então vamos inserir.
A Cassandra gratuita "de fábrica" rapidamente não agradou à segurança da informação: não há registro das ações dos usuários, nem restrições de direitos.. As informações sobre chamadas referem-se a dados pessoais, o que significa que todas as tentativas de solicitá-los ou alterá-los devem ser registradas com a possibilidade de auditoria futura. Também é necessário ter consciência da necessidade de separar os direitos em diferentes níveis para diferentes usuários. Um engenheiro de operações comum e um superadministrador, que pode excluir livremente todo o keyspace – são papéis diferentes, com responsabilidades e competências distintas. Sem essa clara distinção de direitos de acesso, o valor e a integridade dos dados serão colocados em dúvida mais rapidamente do que em um nível de consistência ANY.
Não consideramos que as chamadas requerem tanto análises sérias quanto amostragens periódicas sob várias condições. Como os registros selecionados devem ser excluídos e sobrescritos (no âmbito da tarefa, precisamos manter o processo de atualização de dados quando os dados que nos chegaram inicialmente não estavam corretos), o Cassandra não é nosso amigo aqui. Cassandra, como um cofre – é conveniente para armazenar, mas não se consegue contar nela.
Enfrentamos o problema de transferir dados para zonas de teste. (5 nós no teste contra 20 na produção). Em tal caso, não será possível usar o dump.
O problema das atualizações do esquema de dados do aplicativo que grava no Cassandra. Um rollback gerará uma grande quantidade de tombstones, o que pode de forma imprevisível afetar nosso desempenho.. Cassandra é otimizada para escrita, e antes de gravar, não pensa muito. Qualquer operação com dados existentes nela – também é uma gravação. Ou seja, ao eliminar dados desnecessários, estaremos apenas gerando mais registros, e apenas uma parte deles será marcada como tombstones.
Timeouts durante a inserção. Cassandra é excelente para gravações, mas às vezes o fluxo de entrada pode deixá-la bastante confusa.. Isso acontece quando o aplicativo começa a tentar inserir repetidamente alguns registros que não podem ser inseridos por algum motivo. E precisaremos de um verdadeiro DBA para acompanhar o gc.log, os logs system e debug em busca de slow queries e métricas sobre compaction pending.
Vários data centers no cluster. De onde ler e para onde escrever?
É possível separar entre leitura e gravação? E se sim, o DC deve estar mais próximo da aplicação para gravação ou para leitura? E não teremos um verdadeiro split brain se escolhermos incorretamente o nível de consistência? Há muitas perguntas, muitas configurações inexploradas, possibilidades que gostaríamos de experimentar.
Como resolvemos
Para que o nó não regrida, desativamos o SWAP. E agora, quando a memória acaba, o nó deve cair, em vez de gerar grandes pausas de gc.
Portanto, não contamos mais com a lógica no banco de dados. Os desenvolvedores do aplicativo estão se adaptando e começam a se precaver ativamente em seu próprio código. Uma divisão perfeita e clara entre armazenamento e processamento de dados.
Compramos suporte da DataStax. A Cassandra em caixa já não está mais sendo desenvolvida (o último commit foi em fevereiro de 2018). Ao mesmo tempo, a Datastax oferece um excelente serviço e uma grande quantidade de soluções desenvolvidas e adaptadas para sistemas existentes.
Quero também destacar que a Cassandra não é muito conveniente para consultas de seleção. Claro, o CQL é um grande avanço para os usuários (comparado ao Thrift). Mas se você tem departamentos inteiros acostumados a joins tão convenientes, filtragens livres por qualquer campo e possibilidades de otimização de consultas, e esses departamentos estão trabalhando para resolver reclamações e incidentes, a solução com Cassandra parece a eles uma escolha hostil e sem sentido. E começamos a resolver como nossos colegas poderiam realizar as seleções.
Consideramos duas opções. Na primeira, escrevemos as chamadas não apenas no C*, mas também no banco de dados Oracle arquivístico. No entanto, ao contrário do C*, neste banco de dados são armazenadas apenas as chamadas do mês atual (profundidade de armazenamento suficiente para casos de reapreciação). Aqui já se via o seguinte problema: se escrevemos de forma síncrona, perdemos todas as vantagens do C*, relacionadas à inserção rápida; se o fizermos de forma assíncrona, não há garantia de que todas as chamadas necessárias realmente cheguem ao Oracle. Havia uma vantagem, mas significativa: para exploração, continua sendo o mesmo PL/SQL Developer familiar, ou seja, praticamente implementamos o padrão “Fachada”. Opção alternativa. Implementamos um mecanismo que extrai chamadas do C*, busca alguns dados para enriquecimento das tabelas correspondentes no Oracle, junta os conjuntos obtidos e nos fornece o resultado que depois usamos de alguma forma (rollback, repetição, análise, admiração). Desvantagens: o processo acaba sendo bastante complexo, além disso, falta uma interface para os funcionários de operação.
No final, decidimos pela segunda opção. Para as extrações de diferentes bancos, utilizamos o Apache Spark. A essência do mecanismo se resumiu a um código Java que, com base nas chaves especificadas (assinante, horário da chamada – chaves da seção), extrai os dados do C* e também os dados necessários para enriquecimento de qualquer outro banco de dados. Em seguida, junta-os em sua memória e produz o resultado em uma tabela resultante. Acima do Spark, desenhamos uma interface web e isso se tornou bastante utilizável.
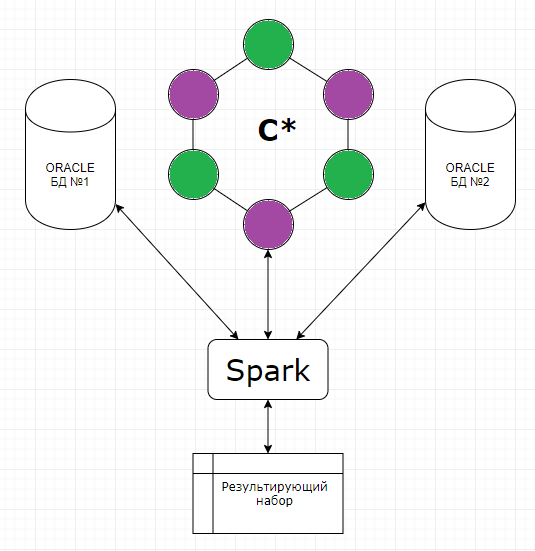
Ao abordar a tarefa de atualização dos dados, o teste de produção novamente considerou várias formas de solução. Tanto a transferência via Sstloader quanto a opção de dividir o cluster na zona de teste em duas partes, cada uma das quais alternadamente acessa um cluster de produção, alimentando-se assim dele. Na atualização do teste, estava planejado alternar suas posições: a parte que funcionou no teste seria limpa e introduzida na produção, enquanto a outra começaria a trabalhar com os dados separadamente. No entanto, refletindo mais uma vez, avaliamos de forma mais racional quais dados valem a pena transferir e percebemos que as chamadas em si são uma entidade inconsistente para os testes, geradas rapidamente quando necessário, e exatamente o conjunto de dados de produção não tem valor para transferência para o teste. Existem vários objetos acumuladores que realmente valem a pena transferir, mas são literalmente algumas tabelas, que não são muito pesadas. Portanto, nós como solução, novamente contámos com a ajuda do Spark, com o qual escrevemos e começamos a usar ativamente um script para transferência de dados entre as tabelas de produção e teste.
Nossa política atual de deployment nos permite operar sem rollbacks. Antes da produção, há uma obrigatória aplicação no teste, onde o erro não é tão caro. Em caso de falha, sempre é possível descartar o keyspace e aplicar todo o esquema desde o início.
Para garantir a disponibilidade contínua do Cassandra, é necessário ter um DBA e não apenas ele. Todos que trabalham com a aplicação devem entender onde e como monitorar a situação atual e como diagnosticar problemas pontualmente. Para isso, usamos ativamente o DataStax OpsCenter (administração e monitoramento de cargas de trabalho), as métricas do sistema Cassandra Driver (número de timeouts em gravação no C*, número de timeouts em leitura do C*, latência máxima, etc.), monitoramos o desempenho da própria aplicação que interage com o Cassandra.
Ao refletirmos sobre a questão anterior, percebemos onde pode estar o principal risco. Trata-se das formas de exibição de dados que extraem informações de várias consultas independentes ao armazenamento. Assim, podemos obter informações bastante inconsistentes. Mas esse problema também seria relevante se estivéssemos trabalhando apenas com um único datacenter. Portanto, a solução mais sensata aqui é, sem dúvida, criar uma função de leitura em lote em um aplicativo externo, que garantirá a coleta de dados em um único período de tempo. Quanto à separação entre operações de leitura e gravação em termos de desempenho, fomos paralisados pelo risco de que, em caso de alguma perda de conexão entre os datacenters, poderíamos obter dois clusters completamente incongruentes.
No final, atualmente ficamos com o nível de consistência para gravação EACH_QUORUM e para leitura – LOCAL_QUORUM
Impressões e Conclusões Resumidas
Para avaliar a solução resultante do ponto de vista do suporte operacional e das perspectivas de desenvolvimento futuro, decidimos considerar onde mais essa abordagem pode ser aplicada.
Se pensarmos rapidamente, o escore de dados para programas como 'Pague quando puder' (carregamos informações em C*, cálculo realizado em scripts Spark), gestão de reclamações com agregação por categorias, armazenamento de papéis e cálculo da matriz de direitos de acesso dos usuários.
Como podemos ver, o repertório é amplo e diversificado. E se tivermos que escolher um lado entre os apoiadores e opositores do NoSQL, nos uniremos aos apoiadores, pois obtivemos benefícios, especialmente nas áreas que esperávamos.
Até mesmo a versão do Cassandra out-of-the-box permite escalonamento horizontal em tempo real, resolvendo de forma absolutamente indolor a questão do aumento de dados no sistema. Conseguimos separar em um contorno um mecanismo altamente carregado para calcular agregados de chamadas, além de dividir o esquema e a lógica do aplicativo, livrando-nos da prática viciosa de escrever jobs e objetos personalizados diretamente no banco de dados. Obtivemos a capacidade de escolher e ajustar, para acelerar, em quais datacenters realizaremos o cálculo e em quais gravaremos dados, protegendo-nos contra quedas, tanto de nós individuais quanto do datacenter como um todo.
Ao aplicar nossa arquitetura a novos projetos, e já tendo alguma experiência, seria interessante levar em consideração as nuances descritas acima desde o início, evitando certas falhas e suavizando alguns pontos críticos que não conseguimos evitar no início.
Por exemplo, monitorar atualizações da própria Cassandra em tempo hábil, pois muitos dos problemas que encontramos já eram conhecidos e corrigidos.
Não instalar tanto o banco de dados quanto o Spark nos mesmos nós ou estritamente dividir de acordo com a quantidade de recursos permitida, já que o Spark pode consumir mais memória do que o permitido, e rapidamente enfrentaremos o problema número 1 da nossa lista.
Desenvolver o monitoramento e a competência na operação já na fase de testes do projeto. Considerar ao máximo todos os potenciais consumidores da nossa solução desde o início, pois é isso que, no final, determinará a estrutura do banco de dados.
Rodar algumas vezes o esquema resultante para identificar possíveis otimizações. Determinar quais campos podem ser serializados. Compreender quais tabelas adicionais precisamos criar para considerar da maneira mais precisa e otimizada as informações e, posteriormente, fornecer as informações solicitadas (por exemplo, considerando que os mesmos dados podem ser armazenados em tabelas diferentes, levando em conta diferentes critérios, podemos economizar consideravelmente o tempo do processador durante as leituras).
Seria bom prever imediatamente a adição de TTL e a limpeza de dados obsoletos.
Ao extrair dados da Cassandra a lógica do aplicativo deve operar de acordo com o princípio FETCH, para que não todas as linhas sejam carregadas na memória de uma só vez, mas selecionadas em lotes.
É desejável verificar a resistência a falhas do sistema antes de migrar o projeto para a solução descrita realizando uma série de testes de falhas, como perda de dados em um datacenter, recuperação de dados corrompidos após um determinado período, quedas de rede entre datacenters. Esses testes não apenas permitirão avaliar os prós e contras da arquitetura proposta, mas também fornecerão uma boa prática para os engenheiros que os realizam, e a habilidade adquirida será muito útil se as falhas do sistema ocorrerem em produção.
Se estamos lidando com informações críticas (como dados para faturamento, cálculo de débitos de clientes), é importante também prestar atenção aos instrumentos que possam reduzir os riscos associados às especificidades do SGBD. Por exemplo, usar a ferramenta nodesync (Datastax), desenvolvendo uma estratégia otimizada para seu uso, para não gerar carga excessiva no Cassandra em prol da consistência. e utilizá-la apenas para tabelas específicas em períodos determinados.
Então, após seis meses de uso do Cassandra? Em geral, não há problemas pendentes. Não tivemos quedas sérias ou perda de dados. Sim, precisamos pensar na compensação de alguns problemas que não haviam surgido antes, mas, no final, isso não prejudicou significativamente nossa solução arquitetônica. Se você está disposto a tentar algo novo e não tem medo de possíveis decepções, prepare-se para entender que nada é gratuito. Você terá que se aprofundar na documentação e lidar com suas próprias dificuldades mais do que em uma solução legada antiga, e nenhuma teoria irá antecipar quais desafios específicos você irá enfrentar.
Fonte: habr.com
