

Olá, Habr! Hoje eu gostaria de falar sobre como proteger processos contra as investidas de invasores no macOS. Por exemplo, isso é útil para antivírus ou sistemas de backup, especialmente considerando que existem várias maneiras de 'matar' um processo no macOS. Sobre isso e os métodos de proteção, leia mais abaixo.
Método clássico para 'matar' um processo
Um método bem conhecido para 'matar' um processo é enviar um sinal SIGKILL ao processo. Através do bash, você pode usar o comando padrão 'kill -SIGKILL PID' ou 'pkill -9 NAME' para realizar a ação. O comando 'kill' é conhecido desde os tempos do UNIX e está disponível não apenas no macOS, mas também em outros sistemas semelhantes ao UNIX.
Assim como nos sistemas semelhantes ao UNIX, o macOS permite interceptar qualquer sinal para um processo, exceto dois: SIGKILL e SIGSTOP. Este artigo se concentrará principalmente no sinal SIGKILL, que é o sinal que provoca a morte do processo.
Particularidades do macOS
No macOS, a chamada de sistema kill no núcleo XNU chama a função psignal(SIGKILL,…). Vamos tentar ver quais outras ações do usuário no espaço de usuários podem chamar a função psignal. Vamos filtrar as chamadas da função psignal nos mecanismos internos do núcleo (embora possam ser não triviais, vamos deixá-las para outro artigo 🙂 — como verificação de assinatura, erros de memória, tratamento de saída/terminação, violação de proteção de arquivos, etc.).
Começaremos a análise com a função e a respectiva chamada de sistema . É visível que, além da chamada clássica kill, existe uma abordagem alternativa que é específica para o sistema operacional macOS e não é encontrada no BSD. Os princípios de funcionamento de ambas as chamadas de sistema também são semelhantes. Elas consistem em chamadas diretas à função do núcleo psignal. Também devemos observar que, antes de matar um processo, é feita a verificação 'cansignal' – se o processo pode enviar um sinal para outro processo, o sistema não permite que qualquer aplicativo mate processos do sistema, por exemplo.
static int
terminate_with_payload_internal(struct proc *cur_proc, int target_pid, uint32_t reason_namespace,
				uint64_t reason_code, user_addr_t payload, uint32_t payload_size,
				user_addr_t reason_string, uint64_t reason_flags)
{
...
	target_proc = proc_find(target_pid);
...
	if (!cansignal(cur_proc, cur_cred, target_proc, SIGKILL)) {
		proc_rele(target_proc);
		return EPERM;
	}
...
	if (target_pid == cur_proc->p_pid) {
		/*
		 * psignal_thread_with_reason() irá pendurar um SIGKILL no thread especificado ou
		 * retornar se o thread e/ou tarefa já estiverem terminando. De qualquer forma, o
		 * thread atual não retornará ao espaço do usuário.
		 * /
		psignal_thread_with_reason(target_proc, current_thread(), SIGKILL, signal_reason);
	} else {
		psignal_with_reason(target_proc, SIGKILL, signal_reason);
	}
...
}
launchd
O método padrão para criar démonios durante a inicialização do sistema e controlar seu tempo de vida é o launchd. Vale destacar que os códigos fonte apresentados são da versão antiga do launchctl antes do macOS 10.10, os exemplos de código são meramente ilustrativos. O launchctl moderno envia sinais ao launchd através do XPC, e a lógica do launchctl foi transferida para lá.
Vamos considerar como a interrupção de aplicativos é realizada. Antes de enviar o sinal SIGTERM, o aplicativo é tentado ser interrompido usando a chamada de sistema "proc_terminate".
...
	error = proc_terminate(j->p, &sig);
	if (error) {
		job_log(j, LOG_ERR | LOG_CONSOLE, "Não foi possível encerrar o trabalho: %d: %s", error, strerror(error));
		job_log(j, LOG_NOTICE | LOG_CONSOLE, "Usando a opção de fallback para encerrar o trabalho...");
		error = kill2(j->p, SIGTERM);
		if (error) {
			job_log(j, LOG_ERR, "Não foi possível sinalizar o trabalho: %d: %s", error, strerror(error));
		}
...
Sob o capô, a proc_terminate, apesar do seu nome, pode enviar não apenas psignal com SIGTERM, mas também SIGKILL.
Morte indireta - restrição de recursos
Um caso mais interessante pode ser visto em outra chamada de sistema . O uso padrão dessa chamada de sistema é a restrição de recursos dos aplicativos, por exemplo, para um indexador, limitar a cota de tempo de CPU e memória, para que o sistema não desacelere significativamente devido às ações de cache do arquivo. Se o aplicativo alcançar o limite de recursos, como pode ser visto na função proc_apply_resource_actions, um sinal SIGKILL é enviado ao processo.
Apesar do fato de que essa chamada de sistema pode potencialmente executar a morte do processo, o sistema não verificou adequadamente os direitos do processo que está chamando a chamada de sistema. Na verdade, a verificação , mas é suficiente usar a flag alternativa PROC_POLICY_ACTION_SET para contornar essa condição.
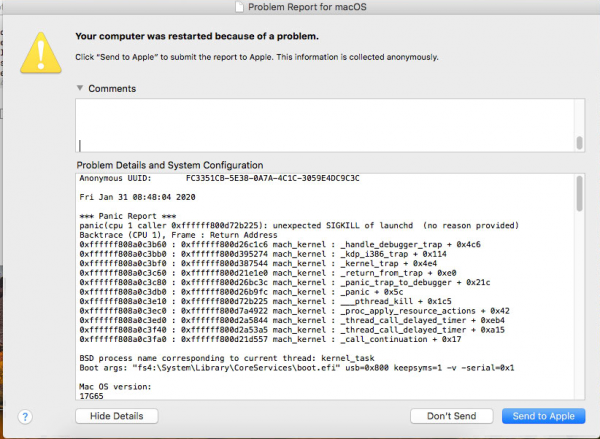
A partir daqui, se você "limitar" a cota de uso de CPU de um aplicativo (por exemplo, permitindo a execução de apenas 1 ns), é possível matar qualquer processo no sistema. Assim, um malware pode encerrar qualquer processo no sistema, incluindo o processo do antivírus. Também é interessante o efeito que ocorre ao matar o processo com pid 1 (launchctl) — um kernel panic ao tentar processar o sinal SIGKILL 🙂
Como resolver o problema?
A maneira mais direta de proibir o encerramento de um processo é substituir o ponteiro da função na tabela de chamadas do sistema. Infelizmente, esse método não é trivial por várias razões.
Primeiro, o símbolo que representa a posição do sysent na memória não só é um símbolo privado do núcleo XNU, como também não pode ser encontrado nos símbolos do núcleo. Será necessário usar métodos heurísticos de busca, como a desassemblagem dinâmica da função e a busca do ponteiro nela.
Em segundo lugar, a estrutura dos registros na tabela depende das flags com as quais o núcleo foi compilado. Se a flag CONFIG_REQUIRES_U32_MUNGING estiver declarada, o tamanho da estrutura será alterado — um campo adicional será adicionado. . É necessário realizar uma verificação adicional sobre qual flag foi usada na compilação do núcleo, como uma opção de comparar ponteiros para funções conhecidas.
struct sysent {
        /* Tabela de chamadas do sistema */
        sy_call_t       *sy_call;       /* função de implementação */
#if CONFIG_REQUIRES_U32_MUNGING || (__arm__ && (__BIGGEST_ALIGNMENT__ > 4))
        sy_munge_t      *sy_arg_munge32; /* munger de argumentos de chamada do sistema para processos de 32 bits */
#endif
        int32_t         sy_return_type; /* tipos de retorno de chamadas do sistema */
        int16_t         sy_narg;        /* número de argumentos */
        uint16_t        sy_arg_bytes;   /* Tamanho total dos argumentos em bytes para
                                         * chamadas de sistema de 32 bits */
};
Felizmente, nas versões modernas do macOS, a Apple fornece uma nova API para trabalhar com processos. A Endpoint Security API permite que os clientes autorizem muitas solicitações a outros processos. Assim, é possível bloquear qualquer sinal para processos, incluindo o sinal SIGKILL, através da API mencionada.
#include <bsm/libbsm.h>
#include <EndpointSecurity/EndpointSecurity.h>
#include <unistd.h>

int main(int argc, const char * argv[]) {
    es_client_t* cli = nullptr;
    {
        auto res = es_new_client(&cli, ^(es_client_t * client, const es_message_t * message) {
            switch (message->event_type) {
                case ES_EVENT_TYPE_AUTH_SIGNAL:
                {
                    auto& msg = message->event.signal;
                    auto target = msg.target;
                    auto& token = target->audit_token;
                    auto pid = audit_token_to_pid(token);
                    printf("signal '%d' sent to pid '%d'n", msg.sig, pid);
                    es_respond_auth_result(client, message, pid == getpid() ? ES_AUTH_RESULT_DENY : ES_AUTH_RESULT_ALLOW, false);
                }
                    break;
                default:
                    break;
            }
        });
    }

    {
        es_event_type_t evs[] = { ES_EVENT_TYPE_AUTH_SIGNAL };
        es_subscribe(cli, evs, sizeof(evs) / sizeof(*evs));
    }

    printf("%dn", getpid());
    sleep(60); // could be replaced with other waiting primitive

    es_unsubscribe_all(cli);
    es_delete_client(cli);

    return 0;
}
Da mesma forma, no núcleo, é possível registrar uma Política MAC, que fornece um método de proteção contra sinais (policy proc_check_signal), embora a API não seja oficialmente suportada.
Proteção da extensão do núcleo
Além da proteção dos processos no sistema, é essencial proteger a própria extensão do kernel (kext). O macOS oferece aos desenvolvedores um framework para o desenvolvimento conveniente de drivers de dispositivos, o IOKit. Além de fornecer ferramentas para interagir com dispositivos, o IOKit oferece métodos para empilhamento de drivers (driver stacking) por meio de instâncias de classes em C++. Um aplicativo em userspace pode "encontrar" uma instância de classe registrada para estabelecer uma conexão entre kernel e userspace.
Para detectar o número de instâncias de classes no sistema, existe a utilidade ioclasscount.
my_kext_ioservice = 1
my_kext_iouserclient = 1
Qualquer extensão do kernel que deseje registrar-se na pilha de drivers deve declarar uma classe herdada de IOService, por exemplo, my_kext_ioservice neste caso. A conexão de aplicativos personalizados provoca a criação de uma nova instância de classe, que herda de IOUserClient, no exemplo my_kext_iouserclient.
Ao tentar descarregar o driver do sistema (comando kextunload), a função virtual "bool terminate(IOOptionBits options)" é chamada. É suficiente retornar false na chamada da função terminate ao tentar descarregar para proibir o kextunload.
bool Kext::terminate(IOOptionBits options)
{

  if (!IsUnloadAllowed)
  {
    // Descarregamento não permitido, retornando false
    return false;
  }

  return super::terminate(options);
}
A flag IsUnloadAllowed pode ser definida pelo IOUserClient durante o carregamento. Com a restrição de descarregamento, o comando kextunload retornará a seguinte saída:
admin@admins-Mac drivermanager % sudo kextunload ./test.kext
Senha:
(kernel) Não é possível remover o kext my.kext.test; serviços falharam ao terminar - 0xe00002c7.
Falha ao descarregar my.kext.test - (iokit/common) função não suportada.
Uma proteção semelhante deve ser realizada para o IOUserClient. Instâncias de classes podem ser descarregadas por meio da função IOKitLib em userspace "IOCatalogueTerminate(mach_port_t, uint32_t flag, io_name_t description);". É possível retornar false na chamada do comando "terminate" até que o aplicativo em userspace "morra", ou seja, até que a função "clientDied" seja chamada.
Proteção de arquivos
Para proteger arquivos, basta usar a API Kauth, que permite restringir o acesso a arquivos. A Apple fornece aos desenvolvedores notificações sobre diversos eventos em escopo, sendo importantes para nós as operações KAUTH_VNODE_DELETE, KAUTH_VNODE_WRITE_DATA e KAUTH_VNODE_DELETE_CHILD. Restringir o acesso aos arquivos é mais fácil pelo caminho — usamos a API 'vn_getpath' para obter o caminho do arquivo e realizamos a comparação do prefixo do caminho. Vale notar que, para otimizar a renomeação de caminhos de pastas com arquivos, o sistema não autoriza o acesso a cada arquivo, mas apenas à própria pasta que foi renomeada. É necessário realizar a comparação do caminho pai e restringir o KAUTH_VNODE_DELETE para ele.
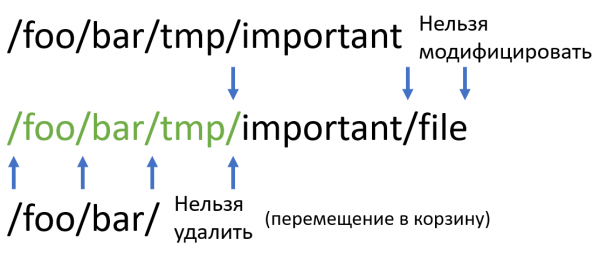
Uma desvantagem dessa abordagem pode ser a baixa performance com o aumento do número de prefixos. Para que a comparação não seja igual a O(prefix*length), onde prefix é o número de prefixos e length é o tamanho da string, pode-se usar um autômato finito determinístico (AFD) construído a partir dos prefixos.
Vamos considerar a forma de construir um AFD para este conjunto de prefixos. Inicializamos os cursores no início de cada prefixo. Se todos os cursos apontam para o mesmo símbolo, então aumentamos cada cursor em um símbolo e lembramos que o comprimento da string igual aumentou em uma unidade. Se existem dois cursores com símbolos diferentes, dividimos os cursores em grupos de acordo com o símbolo que estão apontando e repetimos o algoritmo para cada grupo.
No primeiro caso (todos os símbolos sob os cursores são iguais), obtemos um estado do AFD que tem apenas uma transição pela string igual. No segundo caso, obtemos uma tabela de transições com tamanho 256 (número de símbolos e a quantidade máxima de grupos) para os estados subsequentes, obtidos ao chamar a função recursivamente.
Consideremos um exemplo. Para o conjunto de prefixos ('/foo/bar/tmp/', '/var/db/foo/', '/foo/bar/aba/', 'foo/bar/aac/') podemos obter o seguinte AFD. Na ilustração, estão indicadas apenas as transições que levam a outros estados; as outras transições não serão finais.
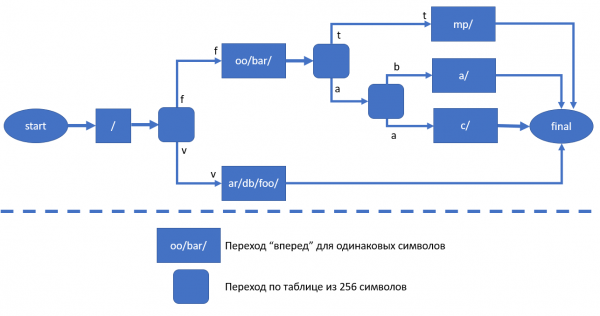
Ao percorrer os estados do AFD, podem existir 3 casos.
- Um estado final foi alcançado — o caminho é protegido, restringindo as operações KAUTH_VNODE_DELETE, KAUTH_VNODE_WRITE_DATA e KAUTH_VNODE_DELETE_CHILD.
- Não foi alcançado um estado final, mas o caminho "terminou" (um zero-terminador foi alcançado) — o caminho é pai, é necessário limitar KAUTH_VNODE_DELETE. Vale notar que se o vnode for uma pasta, deve-se adicionar um ‘/’ no final; caso contrário, pode-se tentar restringir ao arquivo "/foor/bar/t", o que é incorreto.
- Não foi alcançado um estado final, o caminho não terminou. Nenhum dos prefixos corresponde a este, não aplicamos restrições.
Conclusão
O objetivo das soluções de segurança desenvolvidas é aumentar o nível de segurança do usuário e de seus dados. Por um lado, esse objetivo é alcançado através do desenvolvimento do produto Acronis, que fecha as vulnerabilidades onde o próprio sistema operacional está "fraco". Por outro lado, não se deve negligenciar o fortalecimento daqueles aspectos de segurança que podem ser aprimorados no lado do SO, especialmente porque fechar tais vulnerabilidades aumenta nossa própria resiliência como produto. A vulnerabilidade foi relatada pela Apple Product Security Team e foi corrigida no macOS 10.14.5 (https://support.apple.com/en-gb/HT210119).
Tudo isso só pode ser feito se sua ferramenta estiver oficialmente instalada no núcleo. Ou seja, não há brechas para software externo e indesejado. No entanto, como você pode ver, até para proteger programas legítimos, como antivírus e sistemas de backup, é preciso trabalhar duro. Mas agora os novos produtos Acronis para macOS terão proteção adicional contra descarregamento do sistema.
Fonte: habr.com
