

O rastreamento de conexões (“conntrack”) é uma função central da pilha de rede do núcleo Linux. Ele permite que o núcleo monitore todas as conexões ou fluxos de rede lógicos, identificando assim todos os pacotes que compondo cada fluxo, para que possam ser processados sequencialmente em conjunto.
Conntrack é uma função importante do núcleo, utilizada em alguns casos principais:
- NAT depende das informações do conntrack, permitindo que ele processe uniformemente todos os pacotes de um único fluxo. Por exemplo, quando um pod acessa um serviço Kubernetes, o balanceador de carga kube-proxy utiliza o NAT para direcionar o tráfego para um pod específico dentro do cluster. O conntrack registra que, para uma determinada conexão, todos os pacotes enviados para o IP do serviço devem ir para o mesmo pod, e que os pacotes retornados pelo pod de backend devem ser direcionados pelo NAT de volta para o pod de onde a solicitação veio.
- Firewalls com rastreamento de estado, como o Calico, dependem das informações do conntrack para adicionar o tráfego “de resposta” à lista de permissões. Isso permite que você escreva uma política de rede que diga: "permita que meu pod se conecte a qualquer IP remoto", sem a necessidade de escrever uma política para permitir explicitamente o tráfego de resposta. (Sem isso, você teria que adicionar uma regra muito menos segura: "permitir pacotes em meu pod de qualquer IP").
Além disso, o conntrack geralmente melhora o desempenho do sistema (reduzindo o consumo de CPU e o tempo de latência dos pacotes), já que apenas o primeiro pacote em um fluxo
precisa passar por todo o processamento da pilha de rede para determinar o que fazer com ele. Veja o post “” para ver um exemplo de como isso funciona.
No entanto, o conntrack tem suas limitações...
Então, onde tudo deu errado?
A tabela do conntrack tem um tamanho máximo configurável, e se ela se encher, as conexões geralmente começam a ser rejeitadas ou interrompidas. Para processar o tráfego da maioria das aplicações, a tabela geralmente tem espaço livre suficiente, e isso nunca se tornará um problema. No entanto, há alguns cenários onde vale a pena considerar o uso da tabela do conntrack:
- O caso mais óbvio é quando seu servidor processa um número extremamente grande de conexões ativas simultaneamente. Por exemplo, se sua tabela conntrack está configurada para 128 mil registros, mas você tem > 128 mil conexões simultâneas, você certamente enfrentará um problema!
- Um caso um pouco menos óbvio é quando seu servidor processa um grande número de conexões por segundo. Mesmo que as conexões sejam breves, elas continuam sendo rastreadas pelo Linux por um determinado período (por padrão, 120s). Por exemplo, se sua tabela conntrack está configurada para 128 mil registros e você está tentando processar 1100 conexões por segundo, isso irá exceder o tamanho da tabela conntrack, mesmo que as conexões sejam muito efêmeras (128k / 120s = 1092 conexões / s).
Existem alguns tipos de aplicações de nicho que se enquadram nessas categorias. Além disso, se você tiver muitos adversários, o preenchimento da tabela conntrack do seu servidor com várias conexões semi-abertas pode ser utilizado em um ataque de negação de serviço (DoS). Em ambos os casos, o conntrack pode se tornar um gargalo em seu sistema. Em algumas situações, ajustar as configurações da tabela conntrack pode ser suficiente para atender às suas necessidades - aumentando o tamanho ou reduzindo os timeouts do conntrack (mas, se você fizer isso de maneira inadequada, enfrentará grandes dificuldades). Para outros casos, será necessário contornar o conntrack para tráfego agressivo.
Um exemplo real
Vamos citar um exemplo específico: um grande provedor de SaaS com o qual trabalhamos tinha uma série de servidores memcached em hosts (não máquinas virtuais), cada um dos quais processava mais de 50 mil conexões breves por segundo.
Eles experimentaram com a configuração do conntrack, aumentaram os tamanhos das tabelas e reduziram o tempo de rastreamento, mas a configuração era instável, o consumo de RAM aumentou significativamente, o que foi um problema (na ordem de gigabytes!), e as conexões eram tão curtas que o conntrack não criou o seu ganho habitual em desempenho (redução do uso de CPU ou latência de pacotes).
Como alternativa, eles recorreram ao Calico. As políticas de rede do Calico permitem não usar o conntrack para um tipo específico de tráfego (usando a opção doNotTrack nas políticas). Isso lhes proporcionou o nível necessário de desempenho, além de um nível adicional de segurança fornecido pelo Calico.
O que será necessário fazer para contornar o conntrack?
- As políticas de rede do-not-track geralmente devem ser simétricas. No caso de um provedor de SaaS: seus aplicativos funcionavam dentro de uma zona protegida e, portanto, por meio da política de rede, eles podiam incluir em uma lista branca o tráfego de outros aplicativos específicos que tinham autorização de acesso ao memcached.
- A política do-not-track não considera a direção da conexão. Assim, em caso de uma violação do servidor memcached, teoricamente é possível tentar conectar-se a qualquer um dos clientes memcached, se ele usar a porta de origem correta. No entanto, se você definiu corretamente a política de rede para seus clientes memcached, essas tentativas de conexão ainda serão rejeitadas do lado do cliente.
- A política do-not-track se aplica a cada pacote, ao contrário das políticas comuns, que se aplicam apenas ao primeiro pacote de um fluxo. Isso pode aumentar o uso de recursos da CPU por pacote, uma vez que a política precisa ser aplicada a cada pacote. Mas para conexões de curto prazo, esse gasto é equilibrado pela redução do consumo de recursos no processamento do conntrack. Por exemplo, no caso de um provedor de SaaS, o número de pacotes para cada conexão era muito pequeno, então o gasto adicional de recursos da CPU ao aplicar políticas a cada pacote foi justificado.
Vamos começar os testes.
Realizamos um teste em um pod com um servidor memcached e diversos pods de clientes memcached, executados em nós remotos, de modo que pudéssemos realizar um grande número de conexões por segundo. O servidor com o pod de servidor memcached tinha 8 núcleos e 512k registros na tabela conntrack (tamanho padrão configurado para o host).
Medimos a diferença de desempenho entre: sem política de rede; com política Calico comum; e com política Calico do-not-track.
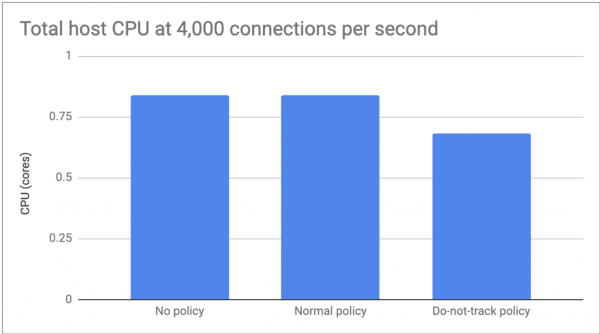
Para o primeiro teste, definimos o número de conexões em até 4.000 por segundo, permitindo-nos focar na diferença no consumo de CPU. Não houve diferenças significativas entre a ausência de políticas e a política padrão, mas a política do tipo do-not-track aumentou o consumo de CPU em cerca de 20%.
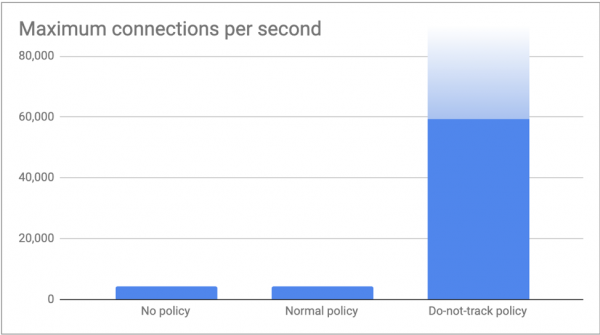
No segundo teste, geramos o máximo de conexões que nossos clientes conseguiram e medimos o número máximo de conexões por segundo que nosso servidor memcached poderia processar. Como esperado, tanto na situação sem políticas quanto na política padrão, ambos atingiram o limite de conntrack em mais de 4.000 conexões por segundo (512k / 120s = 4.369 conexões/s). Com a política do tipo do-not-track, nossos clientes enviaram 60.000 conexões por segundo sem quaisquer problemas. Estamos confiantes de que poderíamos aumentar esse número conectando mais clientes, mas sentimos que esses números já são suficientes para ilustrar a mensagem deste artigo!
Conclusão
Conntrack é uma função importante do kernel. Ele faz seu trabalho de forma excelente. Muitas vezes, é utilizado por componentes chave do sistema. No entanto, em alguns cenários específicos, a sobrecarga causada pelo conntrack supera as vantagens normais que ele oferece. Nesse cenário, as políticas de rede do Calico podem ser utilizadas para desabilitar seletivamente o uso do conntrack, aumentando assim o nível de segurança da rede. Para todo o tráfego restante, o conntrack continua sendo seu aliado!
Leia também outros artigos em nosso blog:
Fonte: habr.com
