

E mais uma vez olá! O título do artigo fala por si. Às vésperas do início do curso vamos explorar quem são realmente os engenheiros de dados. O artigo contém muitos links úteis. Boa leitura.
Um guia simples sobre como surfar na onda da Engenharia de Dados e não ser arrastado para o fundo.
A impressão que se tem é que hoje em dia todos querem se tornar cientistas de dados (Data Scientists). Mas e quanto à Engenharia de Dados? Em essência, é uma espécie de hibridização entre analistas de dados e cientistas de dados; o engenheiro de dados geralmente é responsável por gerenciar fluxos de trabalho, pipelines de processamento e processos ETL.Devido à importância dessas funções, atualmente esse é mais um jargão profissional popular que continua a ganhar destaque.
Altos salários e enorme demanda são apenas uma parte do que torna esse trabalho extremamente atraente! Se você quer se juntar aos heróis, nunca é tarde para começar a aprender. Neste post, reuni todas as informações necessárias para ajudá-lo a dar os primeiros passos.
Então, vamos começar!
O que é Engenharia de Dados?
Para ser sincero, não há explicação melhor do que esta:
"Um cientista pode descobrir uma nova estrela, mas não pode criá-la. Ele terá que pedir a um engenheiro para fazer isso por ele."
– Gordon Lindsay Glegg
Assim, o papel do engenheiro de dados é bastante significativo.
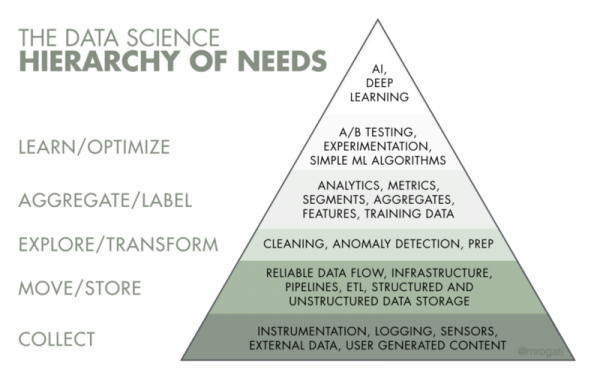
Como o nome sugere, a engenharia de dados está relacionada a dados, especificamente à sua entrega, armazenamento e processamento. Consequentemente, a principal tarefa dos engenheiros é garantir uma infraestrutura confiável para os dados. Se olharmos para a hierarquia de necessidades da IA, a engenharia de dados ocupa os primeiros 2-3 estágios: coleta, movimentação e armazenamento, preparação de dados.
O que faz um engenheiro de dados?
Com o surgimento de grandes dados, a área de responsabilidade mudou drasticamente. Se antes esses especialistas escreviam grandes consultas SQL e transferiam dados usando ferramentas como Informatica ETL, Pentaho ETL, Talend, agora as exigências para engenheiros de dados aumentaram.
A maioria das empresas com vagas abertas para a posição de engenheiro de dados exige os seguintes requisitos:
- Excelente conhecimento de SQL e Python.
- Experiência com plataformas de nuvem, especialmente Amazon Web Services.
- Conhecimento preferencial de Java/Scala.
- Uma boa compreensão de bancos de dados SQL e NoSQL (modelagem de dados, armazenamento de dados).
Tenha em mente que isso é apenas o essencial. A partir desta lista, pode-se inferir que os engenheiros de dados são especialistas em desenvolvimento de software e backend.
Por exemplo, se uma empresa começa a gerar um grande volume de dados de diferentes fontes, sua tarefa como engenheiro de dados é organizar a coleta de informações, seu processamento e armazenamento.
A lista de ferramentas usadas nesse caso pode variar; tudo depende do volume desses dados, da velocidade de sua entrada e da heterogeneidade. A maioria das empresas, na verdade, não lida com big data, portanto, como um repositório centralizado, o chamado data warehouse pode usar um banco de dados SQL (PostgreSQL, MySQL, etc.) com um pequeno conjunto de scripts que direcionam os dados para o armazenamento.
Gigantes de TI como Google, Amazon, Facebook ou Dropbox têm requisitos mais elevados: conhecimento em Python, Java ou Scala.
- Experiência com big data: Hadoop, Spark, Kafka.
- Conhecimento de algoritmos e estruturas de dados.
- Compreensão dos fundamentos de sistemas distribuídos.
- Experiência com ferramentas de visualização de dados, como Tableau ou ElasticSearch, será um grande diferencial.
Ou seja, há um claro desvio em direção ao big data, especialmente em seu processamento sob alta carga. Essas empresas têm requisitos elevados para a resiliência do sistema.
Engenheiros de dados vs. cientistas de dados
Ok, essa foi uma comparação simples e divertida (nada pessoal), mas na verdade tudo é muito mais complexo.
Primeiro, você deve saber que existe uma quantidade significativa de incerteza na definição dos papéis e habilidades de um cientista de dados e de um engenheiro de dados. Ou seja, você pode ficar facilmente confuso sobre quais habilidades são realmente necessárias para um engenheiro de dados bem-sucedido. Claro, há certas habilidades que se sobrepõem a ambos os papéis. Mas também existe uma série de habilidades diametralmente opostas.
A ciência de dados é um assunto sério, mas estamos caminhando para um mundo de ciência de dados funcional, onde os praticantes são capazes de fazer sua própria análise. Para envolver pipelines de dados e estruturas de dados integradas, você precisa de engenheiros de dados, não de cientistas.
Um engenheiro de dados é mais procurado do que um cientista de dados?
— Sim, porque antes de você poder fazer um bolo de cenoura, você precisa primeiro coletar, limpar e estocar as cenouras!
Um engenheiro de dados entende de programação melhor do que qualquer cientista de dados, mas quando se trata de estatísticas, é exatamente o oposto.
Mas aqui está a vantagem do engenheiro de dados:
sem ele/ela, o valor de um modelo-protótipo, que frequentemente consiste em um fragmento de código de péssima qualidade em um arquivo Python, fornecido por um cientista de dados e que de alguma forma gera resultados, tende a se aproximar de zero.
Sem um engenheiro de dados, esse código nunca se tornará um projeto, e nenhum problema de negócios será resolvido de forma eficaz. O engenheiro de dados tenta transformar tudo isso em um produto.
Conceitos básicos que um engenheiro de dados deve saber
Então, se este trabalho desperta sua luz e você está cheio de entusiasmo — você é capaz de aprender isso, pode dominar todas as habilidades necessárias e se tornar uma verdadeira estrela do rock na área de desenvolvimento de dados. E sim, você pode fazer isso mesmo sem habilidades de programação ou outros conhecimentos técnicos. É difícil, mas possível!
Quais são os primeiros passos?
Você deve ter uma visão geral de como as coisas funcionam.
Em primeiro lugar, Engenharia de Dados refere-se à Ciência da Computação. Especificamente — você precisa entender algoritmos eficientes e estruturas de dados. Em segundo lugar, já que os engenheiros de dados trabalham com dados, é necessário entender os princípios de funcionamento de bancos de dados e as estruturas subjacentes.
Por exemplo, bancos de dados SQL comuns baseados em B-tree têm como base a estrutura de dados B-Tree, assim como, em repositórios distribuídos modernos, LSM-Tree e outras modificações de tabelas hash.
* Esses passos são baseados em um artigo incrível . Portanto, se você fala russo, apoie este autor e leia .
1. Algoritmos e estruturas de dados
Usar a estrutura de dados correta pode melhorar significativamente o desempenho do algoritmo. Idealmente, todos nós deveríamos estudar estruturas de dados e algoritmos em nossas escolas, mas isso raramente é abordado. De qualquer forma, nunca é tarde para se familiarizar.
Então, aqui estão meus cursos gratuitos favoritos para aprender estruturas de dados e algoritmos:
Além disso, não se esqueça do trabalho clássico sobre algoritmos de Thomas Cormen — . É o guia perfeito quando você precisa refrescar sua memória.
- Para aprimorar suas habilidades, utilize .
Você também pode mergulhar no mundo de bancos de dados com vídeos incríveis da Universidade Carnegie Mellon no Youtube:
- .
- .
2. Aprendendo SQL
Toda a nossa vida são dados. E para extrair esses dados de um banco de dados, você precisa 'conversar' com eles em uma mesma língua.
SQL (Structured Query Language — Linguagem de Consulta Estruturada) é a linguagem de comunicação na área de dados. Não importa o que alguém diga, SQL nasceu, vive e viverá por muito tempo.
Se você está há muito tempo na área de desenvolvimento, provavelmente percebeu que rumores sobre a morte iminente do SQL aparecem periodicamente. A linguagem foi desenvolvida no início dos anos 70 e ainda é extremamente popular entre analistas, desenvolvedores e apenas entusiastas.
Sem conhecimento de SQL na engenharia de dados, você não fará nada, pois inevitavelmente terá que criar consultas para extrair dados. Todos os modernos repositórios de grandes dados suportam SQL:
- Amazon Redshift
- HP Vertica
- Oracle
- SQL Server
… e muitos outros.
Para analisar grandes volumes de dados armazenados em sistemas distribuídos, como o HDFS, foram inventados mecanismos SQL: Apache Hive, Impala, etc. Veja, ele não vai a lugar algum.
Como aprender SQL? Simples, pratique.
Para isso, eu recomendaria o excelente guia, que por sinal é gratuito, de .
Um diferencial desses cursos é a presença de um ambiente interativo, onde você pode escrever e executar consultas SQL diretamente no navegador. O recurso não será demais. E você pode aplicar esses conhecimentos em na seção de Bancos de Dados.
3. Programação em Python e Java/Scala
Por que estudar a linguagem de programação Python, já escrevi no artigo . Quanto a Java e Scala, a maioria das ferramentas para armazenamento e processamento de grandes volumes de dados é escrita nessas linguagens. Por exemplo:
- Apache Kafka (Scala)
- Hadoop, HDFS (Java)
- Apache Spark (Scala)
- Apache Cassandra (Java)
- HBase (Java)
- Apache Hive (Java)
Para entender como essas ferramentas funcionam, você precisa conhecer as linguagens nas quais foram escritas. A abordagem funcional do Scala permite resolver de maneira eficaz tarefas de processamento paralelo de dados. Python, infelizmente, não pode se gabar de velocidade e processamento paralelo. De modo geral, o conhecimento de várias linguagens e paradigmas de programação influencia positivamente a amplitude de abordagens para resolver problemas.
Para se aprofundar na linguagem Scala, você pode ler do autor da linguagem. Além disso, a empresa Twitter publicou um bom guia introdutório — .
No que diz respeito ao Python, eu considero o melhor livro de nível intermediário.
4. Ferramentas para trabalhar com grandes dados
Aqui está uma lista das ferramentas mais populares no mundo dos grandes dados:
- Apache Spark
- Apache Kafka
- Apache Hadoop (HDFS, HBase, Hive)
- Apache Cassandra
Mais informações sobre a construção de grandes blocos de dados podem ser encontradas neste incrível . As ferramentas mais populares são Spark e Kafka. Definitivamente vale a pena estudá-las, e é recomendável entender como funcionam internamente. Jay Kreps (co-autor do Kafka) publicou em 2013 uma obra monumental , a propósito, as ideias principais deste Talmud foram usadas para criar o Apache Kafka.
- Uma introdução ao Hadoop pode ser .
- O guia mais completo sobre Apache Spark para mim é — .
5. Plataformas de nuvem
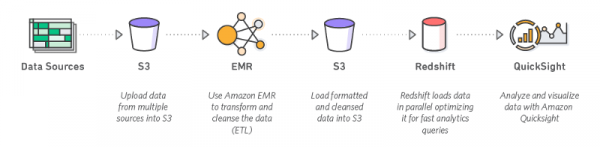
O conhecimento de pelo menos uma plataforma de nuvem está na lista de requisitos básicos para candidatos a engenheiro de dados. Os empregadores preferem o Amazon Web Services, em segundo lugar está a plataforma de nuvem do Google, e em terceiro lugar, o Microsoft Azure.
Você deve ter uma boa familiaridade com Amazon EC2, AWS Lambda, Amazon S3, DynamoDB.
6. Sistemas distribuídos
Trabalhar com grandes dados implica a existência de clusters de computadores que operam de forma independente, com comunicação entre eles sendo feita através de rede. Quanto maior o cluster, maior a probabilidade de falha de seus nós membros. Para se tornar um especialista em dados, é necessário entender os problemas e as soluções existentes para sistemas distribuídos. Esta área é antiga e complexa.
Andrew Tanenbaum é considerado um pioneiro nesta área. Para aqueles que não têm medo da teoria, recomendo seu livro , para iniciantes pode parecer difícil, mas realmente ajudará a aprimorar suas habilidades.
Eu considero o melhor livro introdutório. Aliás, Martin tem um ótimo . Seu trabalho ajudará a sistematizar o conhecimento sobre como construir a infraestrutura moderna para armazenamento e processamento de grandes volumes de dados.
Para aqueles que gostam de assistir a vídeos, há um curso no Youtube .
7. Pipelines de Dados
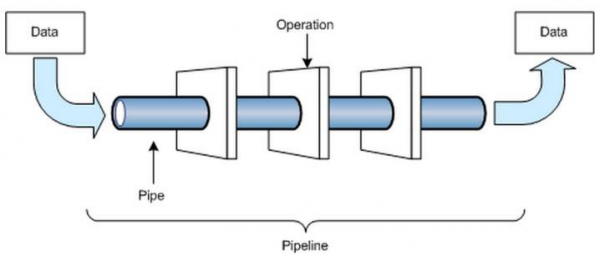
Pipelines de dados são algo sem o qual você não pode viver como engenheiro de dados.
A maior parte do tempo, o engenheiro de dados constrói o chamado pipeline de dados, ou seja, cria um processo para transportar dados de um lugar para outro. Isso pode envolver cenários de usuários que vão para APIs de serviços externos ou fazem consultas SQL, complementam os dados e os colocam em um armazém centralizado (data warehouse) ou em um repositório de dados não estruturados (data lake).
Em resumo: a lista de verificação principal para um engenheiro de dados
Para resumir, é necessário ter uma boa compreensão do seguinte:
- Sistemas de Informação;
- Desenvolvimento de Software (Agile, DevOps, Técnicas de Design, SOA);
- Sistemas Distribuídos e Programação Paralela;
- Fundamentos de Bancos de Dados — planejamento, design, operação e solução de problemas;
- Projeto de Experimentos — testes A/B para validação de conceitos, determinação da confiabilidade, desempenho dos sistemas, além de desenvolver caminhos robustos para fornecer boas soluções oportunamente.
Esses são apenas alguns requisitos para se tornar um engenheiro de dados, então estude e familiarize-se com sistemas de dados, sistemas de informação, entrega contínua/implementação/integração, linguagens de programação e outros tópicos de ciência da computação (nem em todas as áreas de assunto).
E, por fim, algo muito importante que eu quero dizer.
O caminho para se tornar um Engenheiro de Dados não é tão simples quanto parece. Ele não perdoa, frustra e você deve estar preparado para isso. Alguns momentos nesta jornada podem fazer você querer desistir. Mas é um verdadeiro esforço e um processo de aprendizado.
Apenas não o embeleze desde o início. O essencial da jornada é aprender o máximo possível e estar preparado para novos desafios.
Aqui está uma ótima imagem que encontrei, que ilustra bem esse ponto:
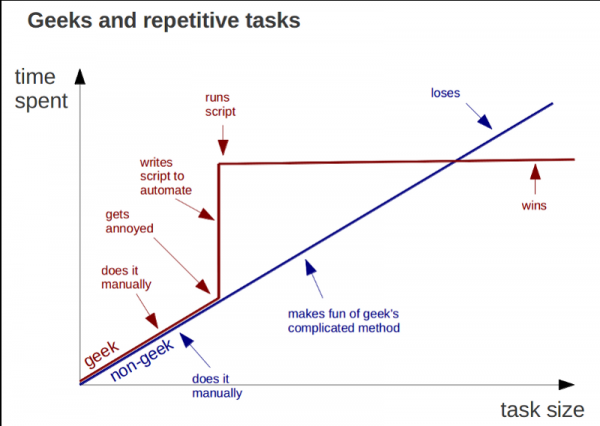
E sim, não se esqueça de evitar o burnout e descansar. Isso também é muito importante. Boa sorte!
O que você achou do artigo, amigos? Convidamos você para um , que acontecerá ainda hoje às 20h. Durante o webinar, discutiremos como construir um sistema de processamento de dados eficaz e escalável para uma pequena empresa ou startup com o mínimo de gastos. Como prática, conheceremos as ferramentas de processamento de dados do Google Cloud. Até lá!
Fonte: habr.com
